はじめに
AI モデルは文章で回答できますが、アプリケーションが有用な処理を行うには、構造化された情報が必要になる場合があります。ツール呼び出し(tool calling)を使うと、アプリケーションは「カタログ項目を 1 件検索する」といった操作をモデルに提示し、モデルにツール名と引数を提案させることができます。ただし、モデルに任意のコードを実行する権限が与えられるわけではありません。モデルが生成するのはデータであり、Worker はそれを信頼できない入力として扱う必要があります。
この実験では、POST /catalog-help を構築します。Cloudflare でホストされている Llama モデルに「SKU KB-101 は在庫がありますか?」のような短い質問を送り、読み取り専用ツール lookup_catalog_item を提案させます。Worker は既知のツールを 1 つだけ受け付け、正確な { sku } 引数オブジェクトを検証してから、小規模な合成カタログを読み取ります。未知のツール、不足または余分なフィールド、不正な SKU、複数の呼び出しが実行処理に到達することはありません。
この実験では traditional function calling を使用し、セキュリティ境界を明確にします。推論は提案し、検証が判断し、アプリケーションコードが実行します。返される結果は、公開されているいくつかのフィクスチャフィールドに限定されます。この演習で書き込み権限が付与されることはなく、外部サービスも呼び出さず、モデルが実行可能なコードを選択することもありません。
これはコースの 5 つ目の実験です。直接この実験を開始した場合は、まず LabEx を Cloudflare アカウントに接続するを完了してください。VM のターミナル、Wrangler の認証、学習アカウントの確認、アカウント ID の設定方法を学べます。
選択した @cf/meta/llama-3.3-70b-instruct-fp8-fast モデルは function calling をサポートしており、標準の Workers AI 割り当てで利用できます。Workers Free には現在、1 日あたり 10,000 Neurons が含まれています。この実験では、ローカルで 1 回、デプロイ後に 1 回だけ短いライブリクエストを送信するため、無料枠が残っている限り Workers Paid は必要ありません。ローカル推論も Cloudflare に接続してアカウントの使用量を消費します。モデルまたは割り当てが利用できない場合は、繰り返し再試行せず停止してください。
セットアップでは、Node.js 22.22.0 とプロジェクトローカルの Wrangler 4.132.0 を /home/labex/project/tool-call-guard にインストールします。また、決定論的なモデルフィクスチャと独立したチェックも用意します。セットアップでは Wrangler の認証、Worker ソースの作成、モデルの呼び出し、デプロイ、クラウドリソースの作成は行いません。
VM を認証し、Tool-Call Worker を設定する
このステップでは、新しい VM を認証し、使い捨ての Worker を 1 つ設定します。ブラウザーではすでに Cloudflare Dashboard にサインインしている場合がありますが、新しい VM 内の Wrangler には独自の限定的な認証が必要です。
用意されたプロジェクトに移動し、固定された CLI バージョンを確認します。
cd /home/labex/project/tool-call-guard
npx wrangler --version
4.132.0 と表示されることを確認します。AI を利用する Worker に必要な権限だけを要求します。Wrangler 4.132.0 は削除時に KV の依存関係も確認するため、この実験では KV データを作成しませんが、クリーンアップには KV 権限が必要です。
npx wrangler login --device --browser=false --scopes account:read user:read workers_scripts:write workers_kv:write ai:write
表示されたリンクを開き、現在のコードを入力して、アカウントと権限を確認し、学習用アカウントを認証します。コード、パスワード、トークンを他人に送らないでください。その後、構造化された ID 情報を確認します。
npx wrangler whoami --json
loggedIn: true を確認します。次に、一意の名前を生成して、この実験の Worker だけをクリーンアップ対象にします。
RUN="labex-c07-a05-$(openssl rand -hex 6)"
printf '%s\n' "$RUN"
以下のヒアドキュメントで通常の JSON 設定を書き込みます。YOUR_ACCOUNT_ID を、使用する学習用アカウントの実際の ID に置き換えてください。
cat > wrangler.jsonc <<JSON
{
  "\$schema": "./node_modules/wrangler/config-schema.json",
  "name": "$RUN",
  "account_id": "YOUR_ACCOUNT_ID",
  "main": "src/index.js",
  "compatibility_date": "2026-09-16",
  "workers_dev": true,
  "preview_urls": false,
  "observability": { "enabled": true, "head_sampling_rate": 1 },
  "ai": { "binding": "AI", "remote": true }
}
JSON
AI binding によって、ソースコードにモデル API キーを記述せずに、安全な env.AI ハンドルをコードから利用できます。remote: true を指定すると、ローカル開発時もオフラインの推論シミュレーションではなく、アカウントに接続されたモデルが呼び出されます。
ツール境界を理解する
このステップでは、プラットフォームの binding を、アプリケーションが適用すべき境界に接続します。
wrangler.jsonc から環境の型を生成し、生成されたインターフェイスを確認します。
npx wrangler types
grep -A4 'interface __BaseEnv_Env' worker-configuration.d.ts
AI: Ai を探してください。ツールの説明は、モデルに送信する構造化データです。名前、平易な言葉で書かれた目的、指定可能な引数のスキーマで構成されます。これはモデルが呼び出しを提案するための情報ですが、認可ではなく、実行可能なコードでもありません。
この実験で許可する読み取り専用ツールは lookup_catalog_item です。引数は、{ "sku": "KB-101" } のように 1 つだけ指定します。推論後、アプリケーションは提案された呼び出しが 1 件だけであることと、許可された名前と完全に一致することを確認します。次に、arguments が sku だけを含むオブジェクトであること、実験で定めた短い公開 SKU 形式に一致することを検証し、検証済みの値だけをアプリケーション固定の読み取り専用関数に渡します。
用意されている拒否用フィクスチャを確認します。
grep -nE 'unknown tools|missing, extra|zero or multiple' test/worker.test.mjs
これらのフィクスチャは、意図的に用意した偽のモデル応答です。ライブモデルが不正な呼び出しを生成することを期待したり、Neurons を消費したりせずに、セキュリティ境界を検証できます。
検証済みのカタログツールを構築する
このステップでは、モデルにツールを説明し、モデルの提案を検証して、アプリケーションの読み取り専用カタログ関数だけを実行します。
Worker のエントリーポイントを作成します。
cat > src/index.js <<'JS'
const MODEL = "@cf/meta/llama-3.3-70b-instruct-fp8-fast";
const TOOL_NAME = "lookup_catalog_item";
const MAX_QUESTION = 240;
const SKU_PATTERN = /^[A-Z]{2}-[0-9]{3}$/;
const CATALOG = [
  { sku: "KB-101", name: "Compact Keyboard", priceUsd: 49, inStock: true },
  { sku: "MS-205", name: "Wireless Mouse", priceUsd: 29, inStock: false }
];

const TOOLS = [{
  name: TOOL_NAME,
  description: "Read one public catalog item by the exact SKU stated in the user's question.",
  parameters: {
    type: "object",
    properties: { sku: { type: "string", description: "An exact catalog SKU such as KB-101" } },
    required: ["sku"]
  }
}];

function json(data, status = 200) { return Response.json(data, { status }); }

async function readQuestion(request) {
  if (!(request.headers.get("content-type") || "").toLowerCase().includes("application/json")) {
    return { error: json({ error: "json_required" }, 415) };
  }
  let body;
  try { body = await request.json(); } catch { return { error: json({ error: "invalid_json" }, 400) }; }
  const question = typeof body?.question === "string" ? body.question.trim() : "";
  if (!question) return { error: json({ error: "invalid_question" }, 400) };
  if (question.length > MAX_QUESTION) return { error: json({ error: "question_too_large" }, 413) };
  return { question };
}

export function validateToolSelection(toolCalls) {
  if (!Array.isArray(toolCalls) || toolCalls.length !== 1) throw new Error("exactly one tool call is required");
  const call = toolCalls[0];
  if (!call || call.name !== TOOL_NAME) throw new Error("unknown tool");
  const args = call.arguments;
  if (!args || typeof args !== "object" || Array.isArray(args)) throw new Error("arguments must be an object");
  if (Object.keys(args).length !== 1 || !Object.hasOwn(args, "sku")) throw new Error("unexpected arguments");
  if (typeof args.sku !== "string" || !SKU_PATTERN.test(args.sku)) throw new Error("invalid sku");
  return { name: TOOL_NAME, arguments: { sku: args.sku } };
}

export function executeCatalogTool(argumentsValue) {
  const item = CATALOG.find((candidate) => candidate.sku === argumentsValue.sku);
  return item ? { ...item, found: true } : { sku: argumentsValue.sku, found: false };
}

export async function handleCatalogHelp(request, env, execute = executeCatalogTool) {
  const parsed = await readQuestion(request);
  if (parsed.error) return parsed.error;
  const requestId = crypto.randomUUID();
  let inference;
  try {
    inference = await env.AI.run(MODEL, {
      messages: [
        { role: "system", content: "Use exactly one provided read-only tool. Copy only the exact SKU from the user. Do not answer from memory." },
        { role: "user", content: parsed.question }
      ],
      tools: TOOLS,
      max_tokens: 128,
      temperature: 0
    });
  } catch {
    console.error(JSON.stringify({ event: "tool_inference_failed", requestId, model: MODEL }));
    return json({ error: "model_unavailable", requestId }, 502);
  }
  let selected;
  try { selected = validateToolSelection(inference?.tool_calls); }
  catch {
    console.error(JSON.stringify({ event: "tool_call_rejected", requestId, model: MODEL }));
    return json({ error: "invalid_tool_call", requestId }, 502);
  }
  const result = execute(selected.arguments);
  console.log(JSON.stringify({ event: "tool_call_executed", requestId, model: MODEL, tool: selected.name, found: result.found }));
  return json({ model: MODEL, tool: selected.name, arguments: selected.arguments, result, requestId });
}

export default { async fetch(request, env) {
  const url = new URL(request.url);
  if (request.method === "GET" && url.pathname === "/health") return json({ status: "ok" });
  if (request.method === "POST" && url.pathname === "/catalog-help") return handleCatalogHelp(request, env);
  return json({ error: "not_found" }, 404);
} };
JS
処理の順序に注目してください。env.AI.run() がデータを返し、validateToolSelection() がそれを許可された 1 つの形式に絞り込み、その後で初めて executeCatalogTool() が実行されます。モデルが JavaScript を提供したり、URL を選択したり、書き込み操作にアクセスしたりすることはありません。ログにはライフサイクルのメタデータだけを記録し、ユーザーの質問とカタログ結果は記録しません。
5 つの決定論的テストを実行し、デプロイせずに Wrangler でバンドルできることを確認します。
node --test test/worker.test.mjs
npx wrangler deploy --dry-run
テストで 5 件すべて成功することを確認します。ドライランの結果に env.AI が AI binding として表示されるはずです。これにより、ライブモデルの呼び出しで使用量を消費する前に、検証コードと Worker 設定が適合していることを確認できます。
ライブでツール選択を 1 回実行する
このステップでは、AI binding が実際のリモート推論を 1 回実行する状態で、Worker をローカルで起動します。ローカルで実行されるのはカタログ検索だけです。モデルは引き続き Cloudflare 上で実行されます。
Wrangler をバックグラウンドで起動し、AI を使わないヘルスチェック用ルートが応答するまで待ちます。& はバックグラウンドジョブを作成し、$! はそのプロセス ID を表します。次のループは /health が成功した時点で待機を終了します。
npx wrangler dev --port 8787 > .labex/dev.log 2>&1 &
echo $! > .labex/dev.pid
for attempt in $(seq 1 30); do
  if curl --silent --fail http://127.0.0.1:8787/health; then break; fi
  sleep 1
done
合成 SKU を 1 つだけ含む短い質問を送信します。
curl --silent --show-error http://127.0.0.1:8787/catalog-help \
  --header 'Content-Type: application/json' \
  --data '{"question":"Is SKU KB-101 in stock and what does it cost?"}'
正確な Llama モデル、tool: "lookup_catalog_item"、KB-101 だけを含む引数、そして範囲を限定した Compact Keyboard フィクスチャが返ることを確認します。アプリケーションは自由形式の文章ではなく、構造化されたツール提案を使用するため、生成された文章の内容は評価対象ではありません。
推論を実行する前に、空の質問が拒否されることを確認します。
curl --silent --show-error --write-out '\nHTTP %{http_code}\n' http://127.0.0.1:8787/catalog-help \
  --header 'Content-Type: application/json' --data '{"question":""}'
{"error":"invalid_question"} と HTTP 400 が返ることを確認します。これにより、通常のリクエスト検証がモデルの使用前に行われることが分かります。
デプロイしてツールの実行記録を確認する
このステップでは、同じエンドポイントをデプロイし、その実行時の動作を Cloudflare で確認できる情報と結び付けます。
保存しておいた開発プロセスだけを停止し、終了するまで待ってからデプロイします。
kill "$(cat .labex/dev.pid)"
wait "$(cat .labex/dev.pid)" 2>/dev/null || true
npx wrangler deploy
Wrangler が表示した正確な URL を保存し、公開エンドポイントに質問を 1 件送信します。
WORKER_URL="https://YOUR_WORKER_URL"
curl --silent --show-error "$WORKER_URL/catalog-help" \
  --header 'Content-Type: application/json' \
  --data '{"question":"Is SKU KB-101 in stock and what does it cost?"}'
公開結果で、正確なモデルと許可されたツールが使用されていること、検証済みの SKU 引数だけが返されること、同じ範囲限定の読み取り専用フィクスチャフィールドが含まれることを確認します。
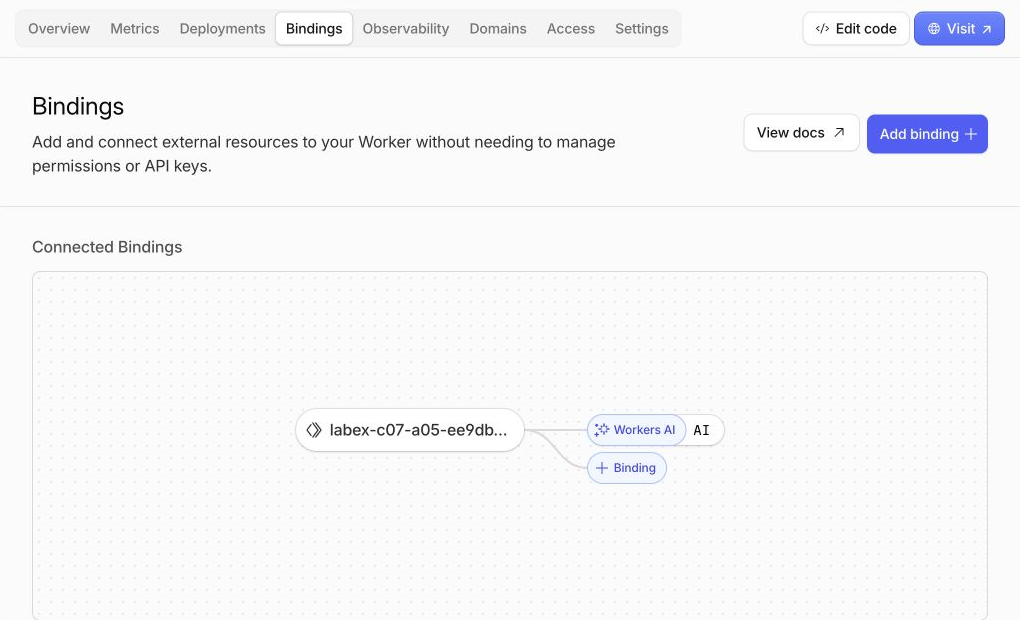
Workers & Pages → labex-c07-a05-... Worker → Bindings を開きます。binding は、Cloudflare サービスを Worker コードから利用できるようにする名前付き接続です。名前が AI の Workers AI 接続が 1 つあることを確認します。この名前があるため、プログラムは env.AI.run(...) を呼び出せます。
次に Observability を開きます。このページには、呼び出し記録とアプリケーションログが表示されます。以下の例では、公開リクエストと独立したチェックの後に、成功イベントが 4 件、エラーが 0 件表示されています。各リクエストが呼び出し記録とアプリケーションイベントの両方に寄与する場合があり、Dashboard への配信が遅れることもあるため、実際の件数は異なる場合があります。
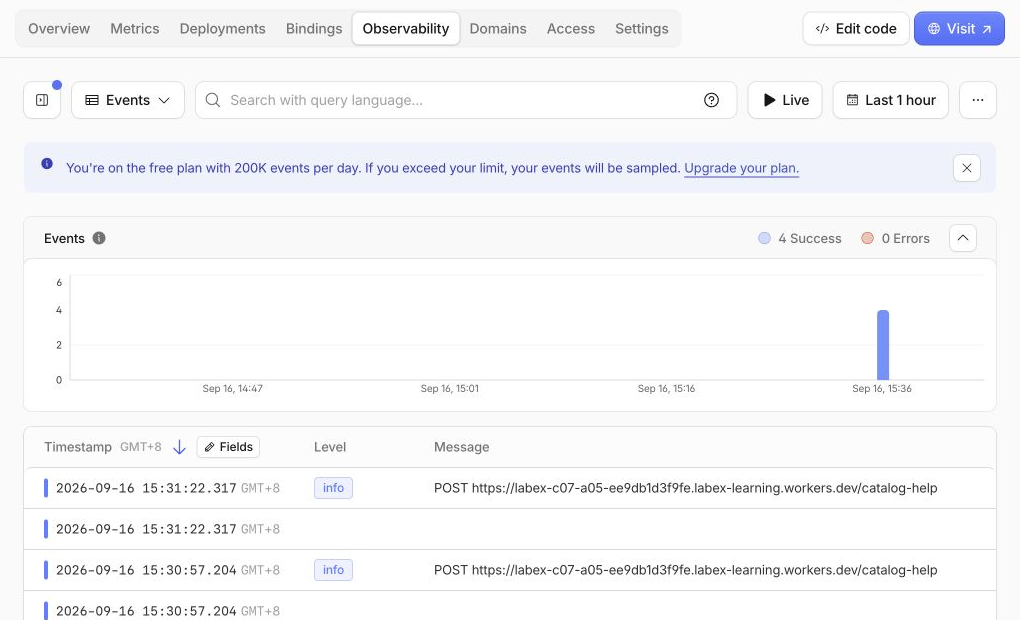
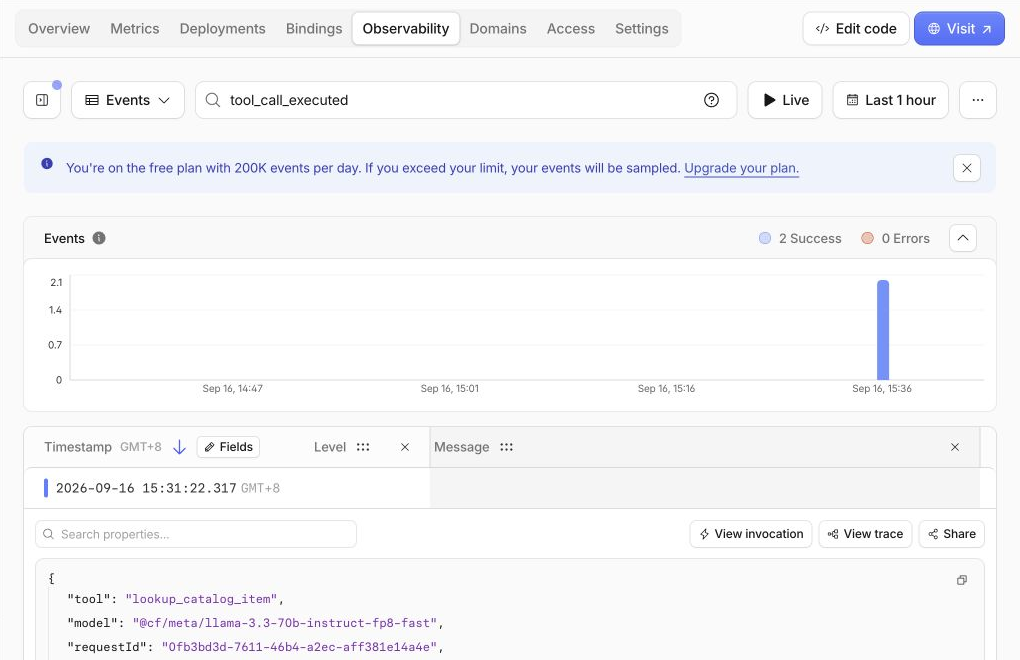
このページに表示される青い Free プランの通知は、AI 推論ではなく Workers Logs のイベント許容量を示しています。検索フィールドに tool_call_executed と入力し、一致する行を 1 つ展開します。以下の例では、成功した一致が 2 件表示され、イベントの先頭に、lookup_catalog_item、正確な Llama モデル、リクエスト ID という限定されたフィールドが表示されています。イベント全体には event: "tool_call_executed" と found: true も含まれますが、ユーザーの質問、モデルの生の応答、返されたカタログレコードは記録されません。
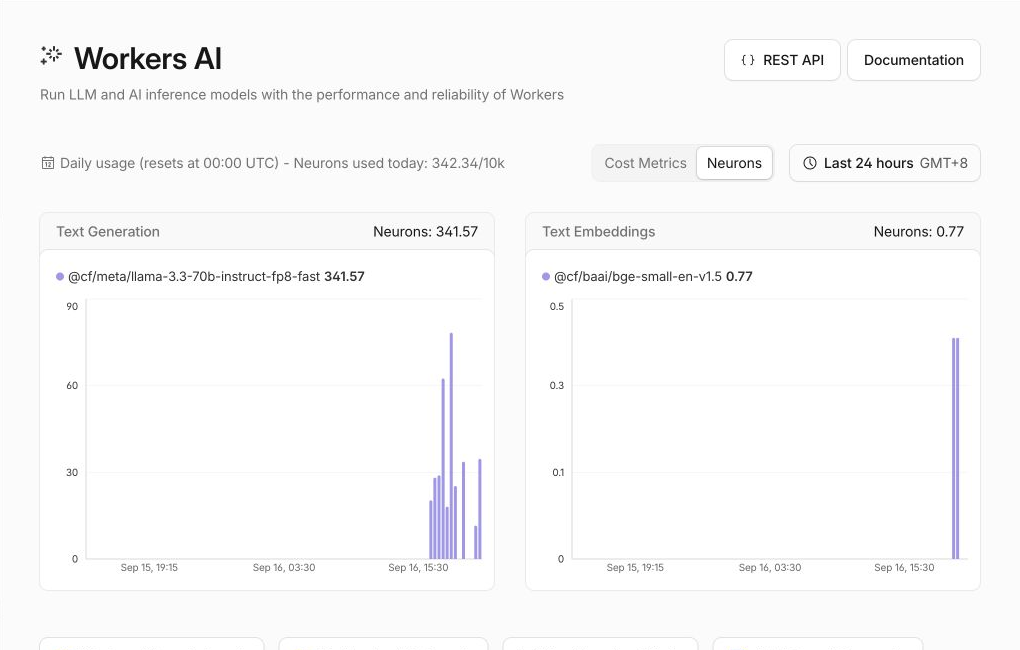
最後に AI → Workers AI を開き、Neurons タブを選択した状態にします。Neuron は、Workers AI の計算量を表す Cloudflare の単位です。例として使用したアカウントでは、その日の使用量が 342.34/10k Neurons でした。Llama の行は 341.57 を示し、以前の embedding 演習は別に表示されています。これらは共有アカウントでの例であり、1 回のリクエストにかかる費用を保証するものではありません。自分のアカウントで正確な Llama の行を探し、その日の合計が 10k の Workers Free 割り当て以内に収まっていることを確認します。
Dashboard のページを使うと、設定、トラフィック、使用量をコマンドラインの結果と関連付けて確認できます。グラフを更新するためだけに推論を繰り返さないでください。グラフとログの表示には遅延があるため、JSON 応答と独立した検証結果を正しい情報として扱います。
Worker を削除してログアウトする
このステップでは、使い捨ての公開エンドポイントを削除し、その後でこの VM の認証を解除します。Workers AI の使用量はアカウント履歴として残ります。Worker を削除しても使用記録は消えません。
wrangler.jsonc に記載された正確な Worker を削除します。
npx wrangler delete
Wrangler にこの実験で生成した一意の labex-c07-a05-... の名前だけが表示されていることを確認してから削除を承認します。Successfully deleted が表示されることを確認し、認証が有効な間に独立したクラウド上の不存在チェックを実行します。
python3 .labex/verify.py deleted
PASS: deleted と表示された後で、ログアウトして構造化された状態を確認します。
npx wrangler logout
npx wrangler whoami --json
loggedIn: false を確認します。ブラウザーのタブを閉じたり、ローカルのソースを削除したりするだけでは、公開 Worker が削除されたことを証明できません。
まとめ
モデルによる選択と、アプリケーションの権限を分離しました。Workers AI は構造化されたカタログ検索を 1 件提案し、Worker は正確なツール名と引数オブジェクトを検証してから、固定された読み取り専用コードを実行しました。決定論的なフィクスチャによって、未知のツール、不正な引数、複数の呼び出しが実行されないことを確認し、ライブ推論によって実際のモデル連携も確認しました。また、プライバシーを限定した実行記録を確認し、使い捨ての Worker と VM の認証を削除しました。