はじめに
AI エンドポイントは、JavaScript だけに依存しているわけではありません。学習者が不正な入力を送信する場合、選択したモデルがリクエストを拒否する場合、アカウントがクォータやレート制限に達する場合、容量が一時的に利用できない場合、またはアプリケーション自身のコードが失敗する場合があります。これらの状況には、それぞれ異なる対応が必要です。すべてを「AI が失敗した」として扱うと、アプリケーションの運用が難しくなり、無駄なリトライを招く可能性があります。
この実験では、POST /draft-reply を構築します。Cloudflare がホストする Llama モデルを使って、短いサポート返信を 1 件作成します。Worker は推論を開始する前に不正な入力を拒否し、文書化されたモデルエラーと制限エラーを識別し、一時的な障害を最大 1 回だけリトライし、モデルのレスポンスを検証し、アプリケーションの不具合を別のエラーとして報告します。制限付きリトライ(bounded retry)とは、追加試行の最大回数を事前に固定することです。アカウントの無料割り当てを使い果たすまでループすることはありません。
ほとんどの障害経路は、決定論的なフィクスチャで確認します。フィクスチャとは、指定した結果やエラーを返す制御された代替物です。これにより、意図的にクォータを消費したり、実際の障害を発生させたりせずに、クォータ超過やサービス停止の動作をテストできます。実際のモデルを使うのは、短いローカルリクエスト 1 回とデプロイ後のリクエスト 1 回だけです。
これはコースの 6 番目のガイド付き実験です。直接この実験を開始した場合は、まず LabEx を Cloudflare アカウントに接続する を完了してください。VM のターミナルの使い方、Wrangler の認証、学習用アカウントの確認、アカウント ID の設定方法を学べます。
選択した @cf/meta/llama-3.3-70b-instruct-fp8-fast モデルは、標準の Workers AI 割り当てで利用できます。現在、Workers Free には 1 日あたり 10,000 Neurons が含まれています。無料割り当てが残っている限り、この実験で Workers Paid は必要ありません。画面上の演習と独立チェックでは、ローカルとデプロイ後にそれぞれ短い正常リクエストを 1 回ずつ送信します。ローカル推論でも Cloudflare に接続し、アカウントの使用量を消費します。そのため、実際の障害に対してライブリクエストを繰り返しリトライしないでください。
セットアップでは、Node.js 22.22.0 とプロジェクトローカルの Wrangler 4.132.0 を /home/labex/project/resilient-ai-reply にインストールします。また、決定論的なフィクスチャと独立チェックも用意します。セットアップでは、Wrangler の認証、Worker ソースの作成、モデルの呼び出し、デプロイ、クラウドリソースの作成は行いません。
VM を認証して Resilient Worker を設定する
このステップでは、新しい VM を認証し、使い捨ての Worker を 1 つ設定します。Cloudflare へのブラウザログインだけでは、新しい LabEx VM 内の Wrangler は自動的に認証されません。
用意されたプロジェクトに移動し、固定された CLI バージョンを確認します。
cd /home/labex/project/resilient-ai-reply
npx wrangler --version
デバイス認証フローを実行します。
npx wrangler login --device --browser=false --scopes \
  account:read user:read workers_scripts:write workers_kv:write ai:write
表示された認証 URL をブラウザで開き、使用する学習用アカウントを確認して、表示されたアクセス権を承認します。この Wrangler バージョンでは、Worker の削除時に KV 互換性スコープが必要です。この実験では KV データを作成または変更しません。
構造化出力で認証を確認します。
npx wrangler whoami --json
"loggedIn": true であることを確認し、アカウント名を確認します。そのアカウントの実際の ID をコピーして、次の設定に貼り付けます。固有の名前を生成し、wrangler.jsonc を作成します。
RUN="labex-c07-a06-$(openssl rand -hex 6)"
printf 'Worker name: %s\n' "$RUN"
cat > wrangler.jsonc <<EOF
{
  "name": "$RUN",
  "main": "src/index.js",
  "compatibility_date": "2026-09-16",
  "account_id": "PASTE_YOUR_ACCOUNT_ID_HERE",
  "workers_dev": true,
  "preview_urls": false,
  "observability": {
    "enabled": true,
    "head_sampling_rate": 1
  },
  "ai": {
    "binding": "AI",
    "remote": true
  }
}
EOF
AI バインディングによって、Worker のコードからアカウントに紐づいた env.AI インターフェイスを利用できるようになります。remote: true を指定すると、ローカルの Wrangler リクエストも実際の Workers AI サービスを使用し、共有割り当ての使用量として計上されます。
障害の種類を分ける
このステップでは、リカバリコードを書く前に、いくつかの異なる障害原因を小さな公開コントラクトに整理します。
HTTP ステータスは、発生した結果の種類をクライアントに伝えます。プロバイダーの生のメッセージ、アカウントの詳細、スタックトレースを公開してはいけません。この実験では、次の 5 つの境界を使用します。
400 invalid_request:学習者の入力が欠落しているか、許可されたサイズを超えています。そのため、推論は開始されません。502 model_incompatibleまたはincompatible_model_response:選択したモデルまたは返されたデータ形式が、アプリケーションのコントラクトと一致しません。同じリクエストを繰り返しても互換性は修復できません。503 model_quota_exhaustedまたはmodel_rate_limited:アカウントまたはモデルの制限により、処理を停止する必要があります。すぐに自動リトライすると、別のリクエストを消費し、負荷を増やします。503 model_temporarily_unavailable:タイムアウトまたは一時的な容量不足が 2 回発生しました。レスポンスにはRetry-Afterが含まれるため、クライアントは次のリクエストまで待機できます。500 application_failure:モデル推論は利用可能なデータを返しましたが、アプリケーション自身のフォーマット処理に失敗しました。
Cloudflare では、1 日あたりの無料割り当てを使い切った場合の内部コードとして 3036、一時的な容量不足として 3040、タイムアウトとして 3007、Workers Paid が必要なモデルとして 5035 を文書化しています。アプリケーションは既知のシグナルを安定した公開エラーに変換し、カテゴリ、試行回数、トレース ID だけをログに記録します。
TypeScript の宣言を生成し、AI バインディングを確認します。
npx wrangler types
grep -nE 'interface Env|AI: Ai' worker-configuration.d.ts
生成された宣言によって、env.AI が Worker で利用できることを確認できます。ただし、モデル呼び出しが成功することまでは証明しません。認証、クォータ、モデルの互換性、サービスの稼働状態は、実行時の条件です。
制限付きリカバリを構築する
このステップでは、分類処理、1 回のリトライ制限、モデルレスポンスとアプリケーションの境界分離を実装します。
Worker のエントリーポイントを作成します。
cat > src/index.js <<'WORKER'
const MODEL = "@cf/meta/llama-3.3-70b-instruct-fp8-fast";
const MAX_MESSAGE = 500;
const RETRY_DELAY_MS = 25;
const RETRY_AFTER_SECONDS = 30;

function json(data, status = 200, headers = {}) {
  return Response.json(data, { status, headers });
}

async function readMessage(request) {
  if (request.method !== "POST") return { error: json({ error: "method_not_allowed" }, 405) };
  let body;
  try { body = await request.json(); }
  catch { return { error: json({ error: "invalid_request" }, 400) }; }
  if (typeof body?.message !== "string") return { error: json({ error: "invalid_request" }, 400) };
  const message = body.message.trim();
  if (!message || message.length > MAX_MESSAGE) return { error: json({ error: "invalid_request" }, 400) };
  return { message };
}

function numeric(value) {
  const number = Number(value);
  return Number.isFinite(number) ? number : undefined;
}

export function classifyModelError(error) {
  const code = numeric(error?.code ?? error?.cause?.code);
  const status = numeric(error?.status ?? error?.cause?.status);
  if ([5004, 5005, 5007, 5016, 5018, 5035, 3042].includes(code) ||
      [400, 403, 404, 405, 413].includes(status)) {
    return { kind: "model_incompatible", status: 502, retryable: false };
  }
  if (code === 3036) return { kind: "model_quota_exhausted", status: 503, retryable: false };
  if (code === 3040 || code === 3007 || status >= 500) {
    return { kind: "model_temporarily_unavailable", status: 503, retryable: true };
  }
  if (status === 429) return { kind: "model_rate_limited", status: 503, retryable: false };
  return { kind: "model_unavailable", status: 503, retryable: false };
}

export async function runWithBoundedRecovery(run, input, traceId, sleep) {
  for (let attempt = 1; attempt <= 2; attempt += 1) {
    try {
      return { result: await run(input), attempts: attempt };
    } catch (error) {
      const failure = classifyModelError(error);
      if (failure.retryable && attempt === 1) {
        console.log(JSON.stringify({
          event: "model_retry_scheduled",
          kind: failure.kind,
          attempt,
          traceId
        }));
        await sleep(RETRY_DELAY_MS);
        continue;
      }
      return { failure, attempts: attempt };
    }
  }
}

function formatReply(reply) {
  return reply.trim();
}

export async function handleDraftReply(request, env, options = {}) {
  const parsed = await readMessage(request);
  if (parsed.error) return parsed.error;

  const traceId = crypto.randomUUID();
  const run = options.run ?? (input => env.AI.run(MODEL, input));
  const sleep = options.sleep ?? (ms => new Promise(resolve => setTimeout(resolve, ms)));
  const outcome = await runWithBoundedRecovery(run, {
    messages: [
      { role: "system", content: "Draft one concise support reply under 80 words. Do not invent account actions." },
      { role: "user", content: parsed.message }
    ],
    max_tokens: 120
  }, traceId, sleep);

  if (outcome.failure) {
    console.log(JSON.stringify({
      event: "model_request_failed",
      kind: outcome.failure.kind,
      attempts: outcome.attempts,
      retryable: outcome.failure.retryable,
      traceId
    }));
    const headers = outcome.failure.retryable ? { "retry-after": String(RETRY_AFTER_SECONDS) } : {};
    return json({ error: outcome.failure.kind, retryable: outcome.failure.retryable },
      outcome.failure.status, headers);
  }

  if (typeof outcome.result?.response !== "string" ||
      !outcome.result.response.trim() ||
      outcome.result.response.length > 1200) {
    console.log(JSON.stringify({
      event: "model_response_rejected",
      attempts: outcome.attempts,
      traceId
    }));
    return json({ error: "incompatible_model_response", retryable: false }, 502);
  }

  let reply;
  try {
    reply = (options.format ?? formatReply)(outcome.result.response);
  } catch {
    console.log(JSON.stringify({ event: "application_failure", traceId }));
    return json({ error: "application_failure", retryable: false }, 500);
  }

  console.log(JSON.stringify({
    event: "reply_generated",
    model: MODEL,
    attempts: outcome.attempts,
    traceId
  }));
  return json({ model: MODEL, reply, attempts: outcome.attempts, traceId });
}

export default {
  async fetch(request, env) {
    const url = new URL(request.url);
    if (url.pathname === "/health") return json({ ok: true });
    if (url.pathname === "/draft-reply") return handleDraftReply(request, env);
    return json({ error: "not_found" }, 404);
  }
};
WORKER
このリトライループでは、合計 2 回まで試行できます。最初の呼び出しに加えて、既知の一時的なカテゴリの場合だけ、追加の呼び出しを 1 回行います。クォータ超過、レート制限、互換性エラーは直ちに停止します。また、モデル呼び出し、レスポンス検証、アプリケーションのフォーマット処理が分離されている点にも注目してください。これにより、プロバイダーの問題とアプリケーションの不具合を区別できます。
公開レスポンスに生の例外を含めることはありません。ログにはサポートメッセージや生成された返信を記録せず、障害カテゴリを調査するために必要なライフサイクルメタデータだけを残します。
クォータを消費せずに障害マトリックスを確認する
このステップでは、実際のモデルリクエストを行う前に、制御されたフィクスチャを使ってすべての障害カテゴリを確認します。
決定論的なテストスイートを実行します。
node --test test/worker.test.mjs
9 つのケースでは、ライブ推論ではなくフィクスチャを使用します。不正な入力ではモデル呼び出しが 0 回、クォータエラーとレート制限エラーでは 1 回、一時的な容量不足では最大 2 回になることを確認します。また、不正な形式の出力が互換性エラーになり、フォーマット処理の不具合がアプリケーションエラーになることも確認してください。
次に、正確な Worker をバンドルします。
npx wrangler deploy --dry-run --outdir /tmp/a06-dry-run
ドライランでは、Wrangler がモジュールをバンドルできることを確認し、AI バインディングが表示されます。デプロイやモデル呼び出しは行いません。
正常な推論を実行して証拠を確認する
このステップでは、ローカルとデプロイ後に正常なリクエストを 1 回ずつ送信し、その結果を Cloudflare Dashboard の読み取り専用の証拠と関連付けます。
ローカルの Wrangler をバックグラウンドで起動し、AI を使わないヘルスルートが利用可能になるまで待ちます。次の制限付きループにより、無限に待機することを防ぎます。
npx wrangler dev --port 8787 > .labex/dev.log 2>&1 &
echo $! > .labex/dev.pid
for attempt in $(seq 1 30); do
  curl --silent --fail http://127.0.0.1:8787/health >/dev/null && break
  sleep 1
done
curl --silent --show-error http://127.0.0.1:8787/draft-reply \
  -H 'content-type: application/json' \
  --data '{"message":"My keyboard stopped working after the latest update."}'
通常の正常ケースでは、レスポンスに空でない reply、正確なモデル名、トレース ID、attempts が 1 であることが含まれます。値が 2 の場合は、一時的な障害を制限内で 1 回のリトライによって復旧できたことを示します。
独立したローカルチェックを実行し、保存したプロセスを停止してからデプロイします。
./.labex/verify.py local
kill "$(cat .labex/dev.pid)"
wait "$(cat .labex/dev.pid)" 2>/dev/null || true
npx wrangler deploy
デプロイ出力から正確な workers.dev URL をコピーし、公開エンドポイントをテストします。
WORKER_URL="https://YOUR_WORKER_URL"
curl --silent --show-error "$WORKER_URL/draft-reply" \
  -H 'content-type: application/json' \
  --data '{"message":"My keyboard stopped working after the latest update."}'
curl --silent --show-error --include "$WORKER_URL/draft-reply" \
  -H 'content-type: application/json' \
  --data '{"message":""}'
./.labex/verify.py deployed
空のメッセージには、推論を開始する前に HTTP 400 が返るはずです。これにより、別のモデルリクエストを消費せずに入力保護が機能することを確認できます。
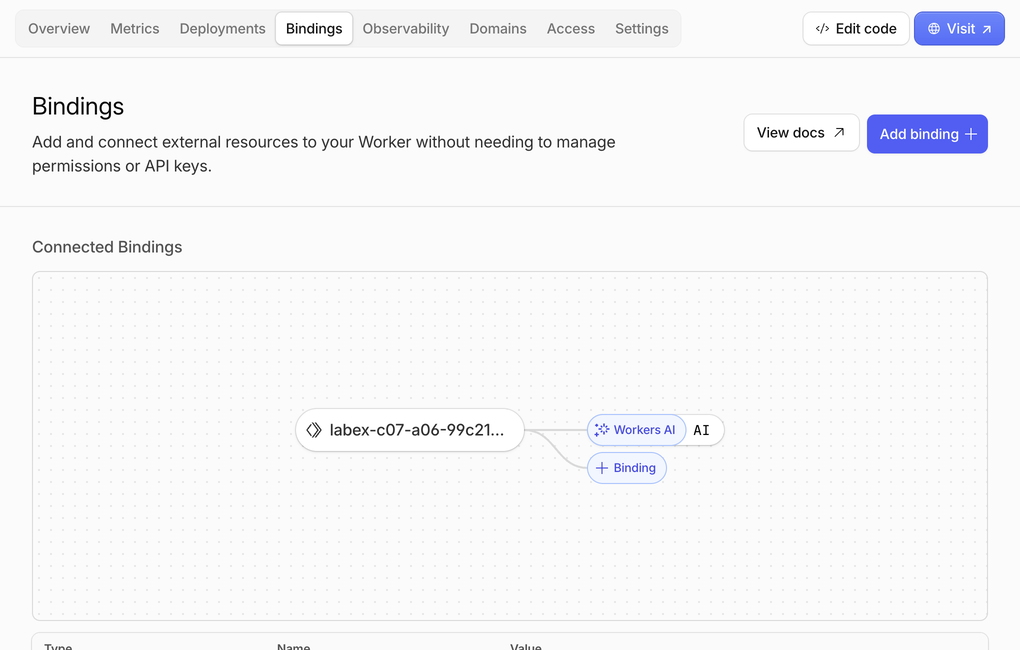
Workers & Pages を開き、対象の Worker 名を選択して Bindings を確認します。バインディングとは、API キーを保存せずに Worker のコードから別の Cloudflare サービスへ接続するための名前付き接続です。AI という名前の Workers AI 接続が 1 つあることを確認してください。下の例に表示されている Worker 名はテスト実行時の名前です。実際の名前には別のランダムなサフィックスが含まれます。
次に Observability を開きます。例の実行では、成功イベントが 6 件、エラーが 0 件発生しました。1 つのリクエストが呼び出しレコードとアプリケーションログの両方を作成する場合があり、保存されたログがレスポンス後に到着する場合もあるため、件数は異なることがあります。
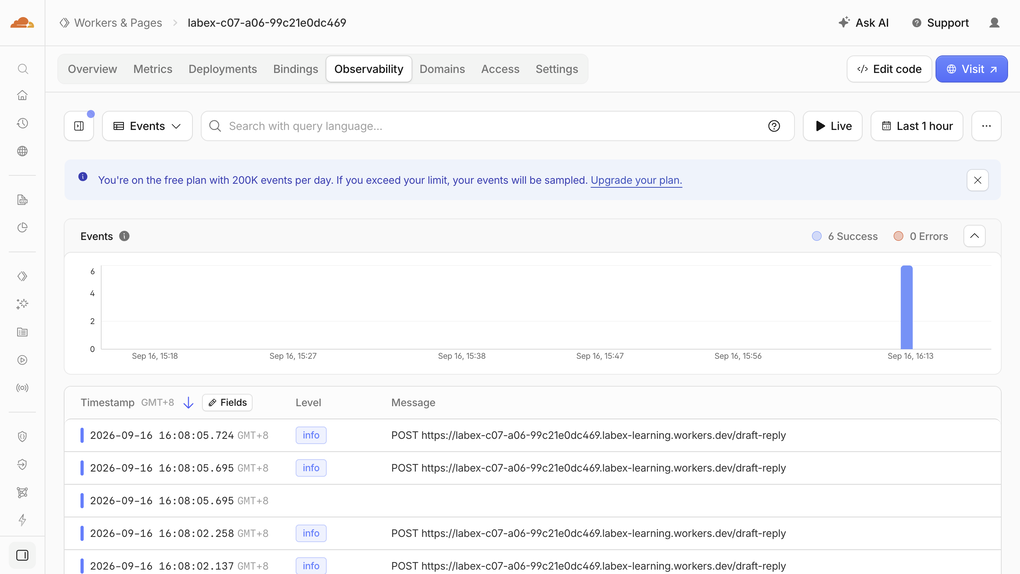
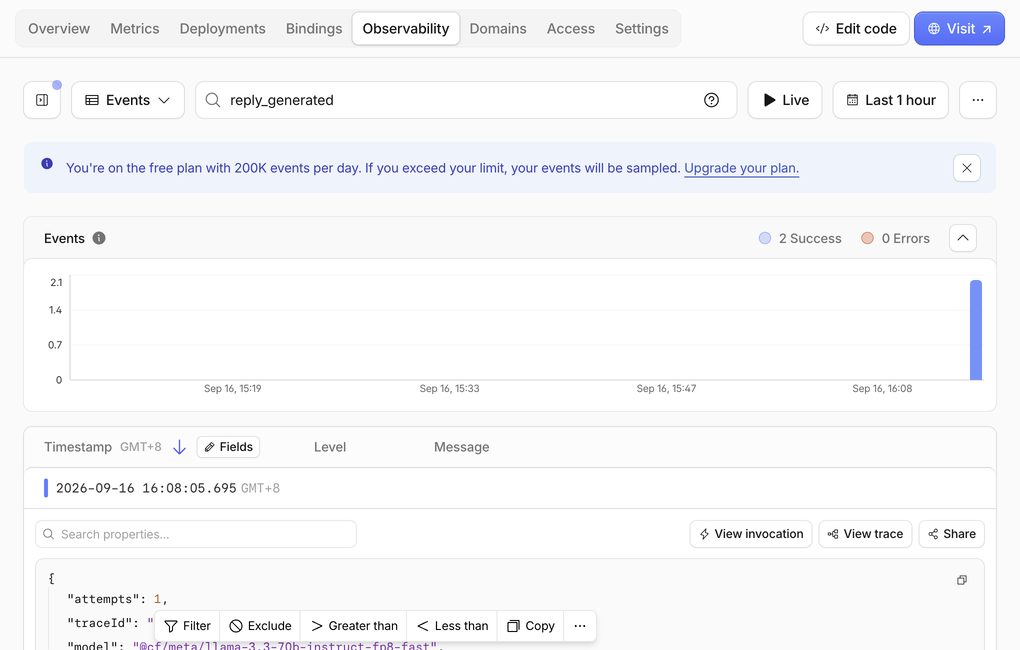
ここに表示される青い Free プランの通知は、AI 推論の使用量ではなく、Workers Logs のイベント割り当てについて説明するものです。reply_generated を検索して、結果を 1 件展開します。対象の例では、成功した一致が 2 件表示され、アプリケーションが意図的に制限したフィールド、つまり 1 回の試行、トレース ID、正確なモデル名を確認できます。完全なイベントには event: "reply_generated" も含まれますが、アプリケーションはサポートメッセージ、生成された返信、生のプロバイダーエラーをログに記録しません。
最後に AI > Workers AI を開き、Neurons タブを選択した状態にします。Neuron は、AI の計算量を表す Cloudflare の単位です。共有サンプルアカウントでは、その日の使用量が 428.59/10k Neurons で、その内訳は Llama モデルが 427.82、以前の埋め込み実験が 0.77 でした。これらの合計にはコース内の他の演習も含まれており、遅れて更新されることがあります。1 回のリクエストのコストではありません。
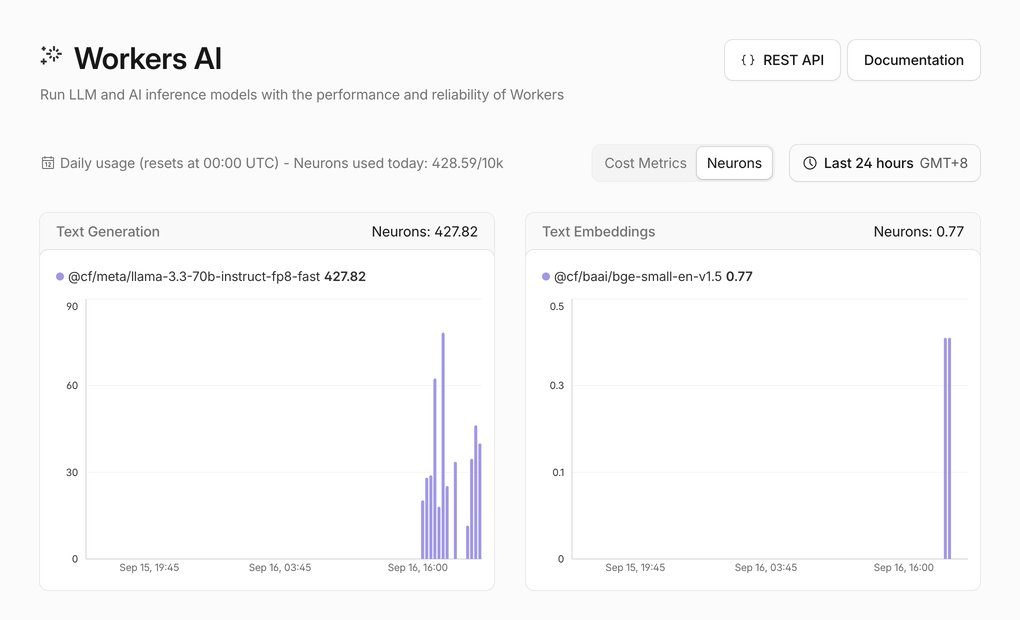
使用量が利用可能な 1 日の割り当て内に収まっていることだけを確認してください。Dashboard の表示は、設定、トラフィック、使用量をコマンドラインの結果と関連付けるのに役立ちます。ただし、実行時のレスポンスと独立チェックが最終的な判定基準です。グラフを動かすためだけに推論を繰り返さないでください。
Worker を削除してログアウトする
このステップでは、認証が有効なうちに使い捨てのエンドポイントを削除し、その後 VM から認証情報を削除します。
wrangler.jsonc に記録されている使い捨て Worker だけを削除します。
npx wrangler delete --force
Wrangler の認証がまだ有効な状態で、認証済みの削除結果を確認します。
./.labex/verify.py deleted
次に、この VM に保存されている認証情報を削除します。
npx wrangler logout
npx wrangler whoami --json
"loggedIn": false であることを確認してから、最後のチェックを実行します。
./.labex/verify.py logout
Worker を削除するとクラウドリソースが削除され、ログアウトするとこの VM から認証情報が削除されます。これらは別々のクリーンアップ処理です。
まとめ
Workers AI エンドポイントを構築し、次のことを実現しました。
- 推論の前に不正な入力を拒否する。
- 互換性、クォータ、レート制限、一時的な障害、アプリケーションエラーを明確に区別する。
- 既知の一時的な障害を最大 1 回だけリトライする。
- アプリケーションでフォーマットする前にモデル出力を検証する。
- プロバイダーの生の詳細を漏らさず、安定した公開エラーを返す。
- プライバシーを考慮して制限したライフサイクルメタデータを記録する。
- クォータを無駄にせず、決定論的なフィクスチャで障害動作を確認する。
- Workers Free 上で、ローカルとデプロイ後の正常な推論を確認する。
- 使い捨ての Worker を削除し、VM からログアウトする。
重要な運用上の習慣は、「AI のエラーをすべてリトライする」ことではありません。どの境界で問題が起きたかを特定し、本当に一時的な状態だけを固定された回数の範囲内でリトライし、クライアントに次の行動が分かるレスポンスを返すことです。