はじめに
キーワード検索は、同じ単語を探します。一方、セマンティック検索は、同じ意味を持つテキストを探します。たとえば、「I cannot sign in」という文は、すべての単語が一致していなくても、パスワードのリセット方法を説明する記事に近い結果になるはずです。
Embedding モデルは、テキストをベクトルに変換します。ベクトルとは、モデルが言語から学習した特徴を表す、順序付けられた数値のリストです。意味が近いテキストは、通常、似た方向を指します。この実験では、コサイン類似度を使ってその方向を比較します。コサイン類似度は、ベクトルの向きが近いほど大きなスコアを返す計算です。ただし、このスコアは同じモデル、同じ次元数、同じ Pooling 方式で生成されたベクトルを比較する場合にのみ有効です。普遍的な真実の割合を表すものではありません。
POST /searchを構築します。Worker は、Cloudflare がホストする@cf/baai/bge-small-en-v1.5を使い、1 つのクエリと 3 つの短いヘルプ記事をまとめて Embedding に変換します。このモデルは、テキストごとに 384 個の数値を生成します。アプリケーションは比較する前にすべてのベクトルを検証し、互換性のない値や有限でない値を拒否します。その後、ベクトル自体は公開せず、記事 ID を順位付けして返します。
これはコースの 4 番目の実験です。直接この実験を開始した場合は、まずLabEx を Cloudflare アカウントに接続するを完了してください。VM のターミナルの使い方、Wrangler の認証、学習アカウントの確認、アカウント ID の設定方法を学べます。
Workers Free アカウントには、現在、共有の日次割り当てとして 10,000 Neurons が付与されます。このモデルの料金は入力トークン 100 万個あたり約 1,841 Neurons です。この実験では短い合成文を少数だけ使うため、無料枠が残っている限り Workers Paid は必要ありません。ローカル推論でも Cloudflare に接続し、アカウントの使用量を消費します。モデルまたは割り当てを利用できない場合は、何度も再試行せず停止してください。
セットアップでは、Node.js 22.22.0 とプロジェクトローカルの Wrangler 4.132.0 を/home/labex/project/search-embeddingsにインストールします。また、決定的なテストと独立した検証チェックも用意します。セットアップでは、Wrangler の認証、モデルの呼び出し、Worker のデプロイ、クラウドリソースの作成は行いません。
VM を認証して Embedding Worker を設定する
このステップでは、新しい VM を認証し、使い捨ての Worker を 1 つ設定します。Dashboard へのログインはブラウザに対するものです。一方、この VM 内の Wrangler には、別途、必要最小限の権限での認証が必要です。
用意されたプロジェクトに移動し、固定された CLI バージョンを確認します。
cd /home/labex/project/search-embeddings
npx wrangler --version
4.132.0と表示されることを確認します。これまでの Workers AI 実験で使った、必要最小限の権限を要求します。KV 権限は、Wrangler 4.132.0 のクリーンアップ依存関係チェックをサポートするためのものです。この実験では KV データを作成しません。
npx wrangler login --device --browser=false --scopes account:read user:read workers_scripts:write workers_kv:write ai:write
表示されたリンクを開き、現在のコードを入力して、アカウントと権限を確認します。その後、学習アカウントを認証してください。次に、構造化された認証情報を確認します。
npx wrangler whoami --json
loggedIn: trueであることを確認し、一意な Worker 名を生成します。
RUN="labex-c07-a04-$(openssl rand -hex 6)"
printf '%s\n' "$RUN"
YOUR_ACCOUNT_IDを、使用するアカウントの実際の ID に置き換えます。
cat > wrangler.jsonc <<JSON
{
  "\$schema": "./node_modules/wrangler/config-schema.json",
  "name": "$RUN",
  "account_id": "YOUR_ACCOUNT_ID",
  "main": "src/index.js",
  "compatibility_date": "2026-09-16",
  "workers_dev": true,
  "preview_urls": false,
  "observability": { "enabled": true, "head_sampling_rate": 1 },
  "ai": { "binding": "AI", "remote": true }
}
JSON
env.AIはプロセス内の Binding であり、ソースコードに記述するモデル API キーではありません。remote: trueにより、ローカル開発中もアカウントに紐付いたモデルが呼び出されます。
ベクトルの契約を理解する
このステップでは、モデル設定と、アプリケーションが検証すべき数値を対応付けます。
環境用の型を生成し、プラットフォーム Binding を確認します。
npx wrangler types
grep -A4 'interface __BaseEnv_Env' worker-configuration.d.ts
AI: Aiを探してください。選択した BGE Small モデルは、入力テキストごとに 384 次元のベクトルを 1 つ返します。次元数とは、ベクトル内の位置の数です。したがって、4 つのテキストをまとめて処理した場合の形状は[4, 384]になります。すべての位置は有限な数値でなければなりません。つまり、NaN、正の無限大、負の無限大であってはいけません。
この実験では、clsの Pooling 方式を明示的に指定します。Pooling とは、トークン単位の情報を 1 つのベクトルに集約する方法です。clsとmeanで作成されたベクトルは、どちらも 384 個の位置を持っていても互換性がありません。そのため、アプリケーションではモデルと次元数とともに Pooling 方式も記録します。
用意されている決定的なフィクスチャを確認します。
grep -nE 'incompatible|non-finite|cosine similarity' test/worker.test.mjs
これらのフィクスチャにより、Neurons を消費せずに失敗時のテストを繰り返し実行できます。また、モデルの動作によって変化する可能性があるため、実際の類似度スコアが特定の値になることは検証しません。
検証済み類似度エンドポイントを構築する
このステップでは、Embedding リクエスト、ベクトル検証、ローカルでのコサイン比較を実装します。Worker は、4 つのベクトルに含まれる 1,536 個の生の数値ではなく、ドキュメント ID とスコアを返します。
エントリポイントを作成します。
cat > src/index.js <<'JS'
const MODEL = "@cf/baai/bge-small-en-v1.5";
const DIMENSIONS = 384;
const POOLING = "cls";
const MAX_QUERY = 300;
const DOCUMENTS = [
  { id: "password-reset", text: "Reset a forgotten password and regain account access." },
  { id: "upload-pdf", text: "Troubleshoot a PDF document that will not upload." },
  { id: "billing-receipt", text: "Download a receipt for a completed payment." }
];

export function validateEmbeddingBatch(result, expectedCount) {
  if (!Array.isArray(result?.shape) || result.shape[0] !== expectedCount || result.shape[1] !== DIMENSIONS) {
    throw new Error("incompatible embedding shape");
  }
  if (!Array.isArray(result.data) || result.data.length !== expectedCount) {
    throw new Error("incompatible embedding count");
  }
  for (const vector of result.data) {
    if (!Array.isArray(vector) || vector.length !== DIMENSIONS || !vector.every(Number.isFinite)) {
      throw new Error("invalid embedding vector");
    }
  }
  return result.data;
}

export function cosineSimilarity(left, right) {
  if (left.length !== right.length || left.length === 0) throw new Error("incompatible vectors");
  let dot = 0, leftNorm = 0, rightNorm = 0;
  for (let index = 0; index < left.length; index += 1) {
    dot += left[index] * right[index];
    leftNorm += left[index] ** 2;
    rightNorm += right[index] ** 2;
  }
  if (leftNorm === 0 || rightNorm === 0) throw new Error("zero-length direction");
  return dot / (Math.sqrt(leftNorm) * Math.sqrt(rightNorm));
}

function json(data, status = 200) { return Response.json(data, { status }); }

async function readQuery(request) {
  if (!(request.headers.get("content-type") || "").toLowerCase().includes("application/json")) {
    return { error: json({ error: "json_required" }, 415) };
  }
  let body;
  try { body = await request.json(); } catch { return { error: json({ error: "invalid_json" }, 400) }; }
  const query = typeof body?.query === "string" ? body.query.trim() : "";
  if (!query) return { error: json({ error: "invalid_query" }, 400) };
  if (query.length > MAX_QUERY) return { error: json({ error: "query_too_large" }, 413) };
  return { query };
}

async function search(request, env) {
  const parsed = await readQuery(request);
  if (parsed.error) return parsed.error;
  const requestId = crypto.randomUUID();
  let result;
  try {
    result = await env.AI.run(MODEL, { text: [parsed.query, ...DOCUMENTS.map((item) => item.text)], pooling: POOLING });
  } catch {
    console.error(JSON.stringify({ event: "embedding_failed", requestId, model: MODEL }));
    return json({ error: "model_unavailable", requestId }, 502);
  }
  let vectors;
  try { vectors = validateEmbeddingBatch(result, DOCUMENTS.length + 1); }
  catch {
    console.error(JSON.stringify({ event: "embedding_rejected", requestId, model: MODEL }));
    return json({ error: "invalid_embeddings", requestId }, 502);
  }
  const [queryVector, ...documentVectors] = vectors;
  const matches = DOCUMENTS.map((document, index) => ({ id: document.id, score: cosineSimilarity(queryVector, documentVectors[index]) }))
    .sort((left, right) => right.score - left.score);
  console.log(JSON.stringify({ event: "embedding_compared", requestId, model: MODEL, dimensions: DIMENSIONS, count: vectors.length, pooling: POOLING }));
  return json({ model: MODEL, dimensions: DIMENSIONS, pooling: POOLING, matches, requestId });
}

export default { async fetch(request, env) {
  const url = new URL(request.url);
  if (request.method === "GET" && url.pathname === "/health") return json({ status: "ok" });
  if (request.method === "POST" && url.pathname === "/search") return search(request, env);
  return json({ error: "not_found" }, 404);
} };
JS
検証は類似度の計算より先に実行されます。これにより、データの暗黙的な切り詰め、意味のない異なる次元間の比較、NaNスコアの発生を防ぎます。ログにはライフサイクルに関するメタデータだけを残し、クエリ、記事本文、ベクトルは記録しません。
5 つの決定的なテストを実行し、デプロイせずに Bundle を作成します。
node --test test/worker.test.mjs
npx wrangler deploy --dry-run
テストでは、ローカルの計算と拒否処理が正しく動作することを確認します。Dry run では、Worker と Binding の設定をまとめて Bundle できることを確認します。
実際の Embedding バッチを 1 回実行する
このステップでは、AI Binding が実際のリモート Embedding リクエストを 1 回実行する間、ハンドラーをローカルで動かします。
Wrangler をバックグラウンドで起動し、AI を使わないヘルスチェック用ルートが応答するまで待ちます。
npx wrangler dev --port 8787 > .labex/dev.log 2>&1 &
echo $! > .labex/dev.pid
for attempt in $(seq 1 30); do
  if curl --silent --fail http://127.0.0.1:8787/health; then break; fi
  sleep 1
done
短い合成クエリを送信します。
curl --silent --show-error http://127.0.0.1:8787/search \
  --header 'Content-Type: application/json' \
  --data '{"query":"I cannot sign in because I forgot my password"}'
model、dimensions: 384、pooling: "cls"、3 つの順位付き ID、有限のスコアが返ることを確認します。スコアが完全に一致することは要求しません。このクエリに対する順位は、今回の結果を示すものであり、モデルが常に保証するものではありません。
推論を実行する前に、空のクエリが拒否されることを確認します。
curl --silent --show-error --write-out '\nHTTP %{http_code}\n' http://127.0.0.1:8787/search \
  --header 'Content-Type: application/json' --data '{"query":""}'
{"error":"invalid_query"}と HTTP 400が返ることを確認します。
デプロイして Embedding の実行情報を確認する
このステップでは、同じエンドポイントをデプロイし、実行時の情報を Cloudflare Dashboard で確認します。
保存してある開発プロセスだけを停止してから、デプロイします。
kill "$(cat .labex/dev.pid)"
wait "$(cat .labex/dev.pid)" 2>/dev/null || true
npx wrangler deploy
Wrangler が表示した正確な URL を保存し、公開エンドポイントにクエリを 1 回送信します。
WORKER_URL="https://YOUR_WORKER_URL"
curl --silent --show-error "$WORKER_URL/search" \
  --header 'Content-Type: application/json' \
  --data '{"query":"I cannot sign in because I forgot my password"}'
レスポンスにモデル、384 次元、clsPooling が記録され、用意された 3 つの ID がすべて有限のスコア付きで順位付けされていることを確認します。
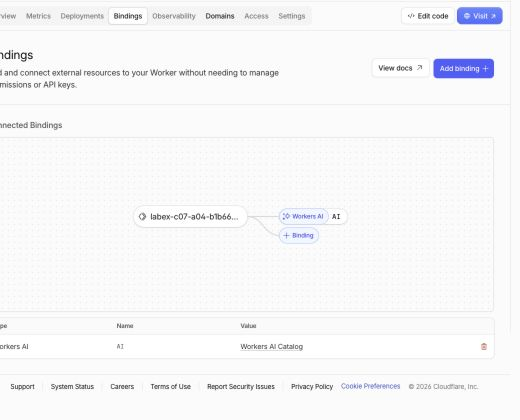
Workers & Pages → Overview → labex-c07-a04-... Workerを開きます。BindingsでAI Binding を確認します。Observability → Logsでembedding_comparedを検索し、イベントを展開します。正確なモデル、dimensions: 384、count: 4、pooling: cls、リクエスト ID が記録されていることを確認します。クエリ、ドキュメント、ベクトルは含まれていなければなりません。
Bindingsページでは接続状態を確認できます。Worker には、AIという名前の Workers AI Binding が 1 つあります。Binding は、コードがenv.AIとして使う安全なハンドルです。ソースファイルに API キーを貼り付ける必要はありません。
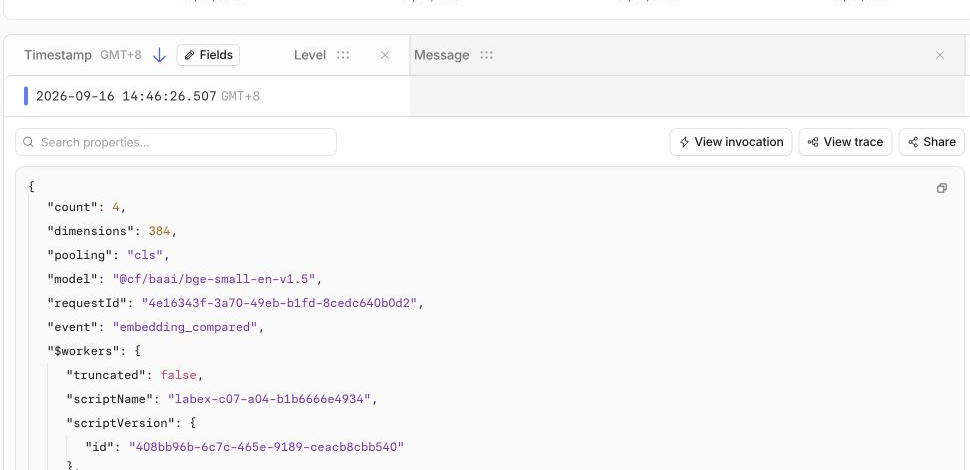
Observabilityの概要には、この使い捨て実行で成功した/searchリクエストとエラーがないことが表示されます。すべてのテストリクエストがイベントになるため、正確な合計値は異なる場合があります。
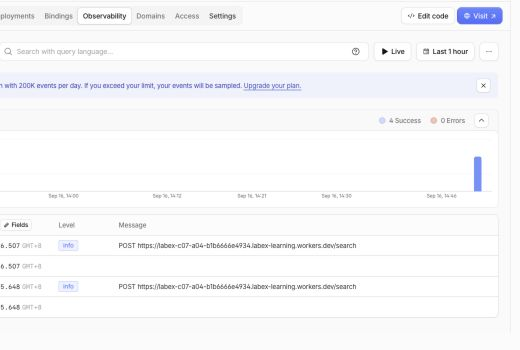
embedding_comparedイベントを 1 つ展開します。この例では、運用上必要な情報だけを記録しています。4 つのテキストを比較したこと、各ベクトルが 384 次元であること、clsPooling を使ったこと、モデルが@cf/baai/bge-small-en-v1.5であることが分かります。学習者のクエリ、ドキュメント本文、数百個のベクトル値は意図的にログへ記録していません。
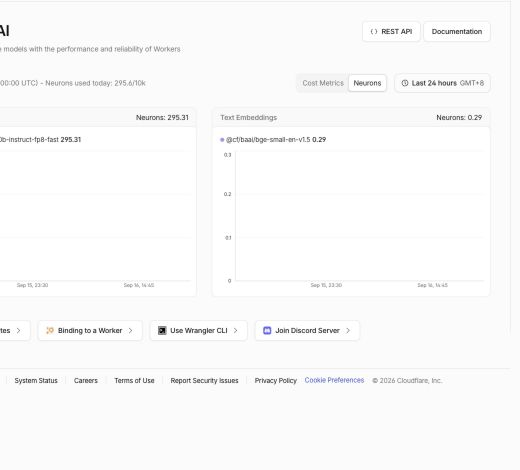
次にWorkers AIを開きます。当日の使用量で BGE Small モデルを見つけ、制限された実行が共有の 10,000-Neuron Free 割り当て内に収まっていることを確認します。Dashboard への反映には遅延がある場合があります。グラフを更新するために推論を繰り返すのではなく、しばらく待ってください。
テストした Free アカウントでは、Embedding モデルの使用量は0.29 Neurons で、合計使用量は295.6 / 10kでした。この大きな合計値には、同じ日にコースの他のテストで使用した量も含まれています。そのため、これらの数値は例として扱い、必須の結果とは考えないでください。重要な確認点は、BGE Small の行が表示され、1 日の合計使用量が Free 割り当てを下回っていることです。
Dashboard のグラフは視覚的な確認に役立ちます。ただし、デプロイされた Worker が正しく動作することを示す正式な根拠は、JSON レスポンスと独立した検証スクリプトです。
Worker を削除してログアウトする
このステップでは、使い捨てのエンドポイントを削除し、その後、この VM の認証を解除します。Workers AI の使用量はアカウント履歴として残るため、Worker を削除しても使用記録は消えません。
wrangler.jsoncに記載された正確な Worker を削除します。
npx wrangler delete
Wrangler にこの実験で生成した一意のlabex-c07-a04-...という名前が表示された場合にのみ、確認してください。Successfully deletedと表示されることを確認し、認証が有効な状態で独立したクラウド上の不存在チェックを実行します。
python3 .labex/verify.py deleted
PASS: deletedと表示された後でのみログアウトし、構造化された状態を確認します。
npx wrangler logout
npx wrangler whoami --json
loggedIn: falseであることを確認します。ブラウザのタブを閉じたり、ローカルファイルがなくなったりしても、クラウド上のクリーンアップが完了した証拠にはなりません。
まとめ
Cloudflare がホストするモデルで 384 次元の Embedding を生成し、互換性に関する設定を記録して、すべてのベクトルを検証しました。また、コサイン類似度で意味的な方向を比較し、順位付けの前に互換性のないデータを拒否しました。さらに、実際の Binding とプライバシーに配慮したログを確認し、使い捨ての Worker と VM の認証を削除しました。