はじめに
通常、アプリケーションはコードに直接記述されたルールに従って動作します。人工知能(AI)推論を使うと、別の種類の処理を追加できます。アプリケーションが学習済みの モデル に入力を送り、モデルが結果を生成します。モデルに送る指示とコンテキストを プロンプト と呼びます。生成される文章はリクエストごとに変わる可能性があるため、信頼性の高いアプリケーションでは、常に同じ文が返ることを期待するのではなく、入力を制御して結果を検証します。
Cloudflare Workers AI を使うと、Cloudflare のプラットフォーム上で Worker から対応する AI モデルを実行できます。Worker は、Cloudflare のネットワーク上でリクエストに応答するアプリケーションコードです。AI バインディングは、Workers AI をコードから env.AI として利用できるようにする設定済みの接続です。プロジェクトに別のプロバイダー用 API キーを保存する必要はありません。
この実験では、サポートアプリケーションに、担当者がチケットの詳細を開く前に短い要約が必要だと想定します。AI バインディングを設定し、POST /summaries エンドポイントを実装します。また、推論を実行する前に不適切な入力を拒否し、同じ Worker をローカルでテストしてからデプロイし、Cloudflare Dashboard で実際の Worker と AI の動作を確認します。この実験では、標準の Workers AI 無料割り当てで利用できる Cloudflare ホストモデル @cf/meta/llama-3.3-70b-instruct-fp8-fast を使用します。レスポンスの文言は採点対象ではありません。採点対象はアプリケーションの契約です。
このコースを始める前に、LabEx を Cloudflare アカウントに接続するを完了してください。 この実験では、LabEx VM のターミナル、デバイス認証、アカウント確認、実際のアカウント ID の保存方法を学びます。また、小さな JavaScript Worker が HTTP リクエストを処理する仕組みを理解しておいてください。機械学習の知識は必要ありません。
Workers AI では現在、Workers Free アカウントに対して、Cloudflare がモデルの計算量を表す単位である Neurons を共有のデイリー割り当てとして 10,000 まで提供しています。この実験ではプロンプトと出力を小さく保つため、有料プランは必要ありません。ただし、同じアカウントで行う他の処理もこの割り当てを共有します。開始前に、現在の Llama 3.3 モデルページ と Workers AI の料金を確認してください。デイリー割り当てをすでに使い切っている場合、上限がリセットされるまで推論は失敗します。回避するためにリクエストを繰り返し送らないでください。ローカルの Workers AI 開発でもクラウドモデルを使用するため、割り当てを消費します。オフラインのシミュレーションではありません。
セットアップでは、Node.js 22.22.0 とプロジェクトローカルの Wrangler 4.132.0 を /home/labex/project/ticket-summary にインストールします。また、モデルを呼び出さずに AI のレスポンスを再現する決定論的なテストも用意されています。セットアップではログイン、プラン変更、デプロイ、推論の実行は行いません。使い捨ての Worker を削除し、ログアウトを確認するまで、この VM を開いたままにしてください。
VM を認証してアカウントを選択する
このステップでは、新しい LabEx VM を Cloudflare の学習用アカウントに接続し、一意の Worker 設定を作成します。Dashboard のブラウザーセッションでは、VM 内のターミナルコマンドは自動的に認証されません。
用意されたプロジェクトに移動し、固定された Wrangler のバージョンを確認します。
cd /home/labex/project/ticket-summary
npx wrangler --version
4.132.0 と表示されることを確認します。この実験に必要な権限だけを使ってデバイス認証を開始します。workers_scripts:write には、使い捨て Worker のデプロイ、読み取り、削除が含まれます。ai:write では、Worker から Workers AI を呼び出せます。Wrangler 4.132.0 は Worker の削除時に KV バインディングの参照も確認するため、workers_kv:write を指定すると、そのクリーンアップ確認を完了できます。この実験では KV namespace は作成しません。アカウントとユーザーの読み取り権限を使うと、対象のアカウントを確認できます。
npx wrangler login --device --browser=false --scopes account:read user:read workers_scripts:write workers_kv:write ai:write
表示されたリンクをブラウザーで開き、現在のデバイスコードを入力して、権限を確認し、学習用アカウントを選択します。ブラウザーでの処理が終わった後も Wrangler が動作し続ける必要があるため、Background Access が表示されることもあります。アカウントと権限一覧がこの実験の内容と一致していることを確認してから認証し、ターミナルに戻って成功メッセージが表示されるまで待ちます。
npx wrangler whoami --json
loggedIn: true を確認し、使用するアカウントの name と id を読み取ります。アカウントが 1 つしか表示されない場合も確認してください。名前は誤ったアカウントの使用を防ぐのに役立ち、ID は Wrangler が設定に保存する安定した値です。
一意の Worker 名を生成します。openssl rand -hex 6 は 12 文字のランダムな 16 進数を生成し、$(...) はその値をシェル変数に挿入します。
RUN="labex-c07-a01-$(openssl rand -hex 6)"
printf '%s\n' "$RUN"
選択したアカウント ID を、次の設定内の YOUR_ACCOUNT_ID と置き換えて入力します。ヒアドキュメントは、2 つの JSON マーカーの間にある行を wrangler.jsonc に書き込みます。マーカーを引用符で囲んでいないため $RUN は展開され、バックスラッシュによって $schema キーはそのままの文字列になります。
cat > wrangler.jsonc <<JSON
{
  "\$schema": "./node_modules/wrangler/config-schema.json",
  "name": "$RUN",
  "account_id": "YOUR_ACCOUNT_ID",
  "main": "src/index.js",
  "compatibility_date": "2026-09-16",
  "compatibility_flags": ["nodejs_compat"],
  "workers_dev": true,
  "preview_urls": false,
  "observability": {
    "enabled": true,
    "head_sampling_rate": 1
  },
  "ai": {
    "binding": "AI",
    "remote": true
  }
}
JSON
compatibility_date は、この実験でテストするランタイムの動作を固定します。observability は、後の Dashboard 確認で使う呼び出しログとアプリケーションログを保持します。このファイルを書き込んでも、Worker はデプロイされず、モデルも呼び出されません。
Workers AI バインディングを確認する
このステップでは、設定を Worker の環境の型定義に変換し、バインディング名を次に作成するコードへ接続します。
バインディングは、Workers ランタイムが提供する名前付きの機能です。wrangler.jsonc の AI という名前により、Worker は env.AI を使ってモデルを実行します。ソースコードに API トークンはありません。Cloudflare がデプロイ済み Worker を選択したアカウントに接続します。remote: true は wrangler dev の実行時に重要です。リクエストハンドラー自体はこの VM 上で実行されますが、モデル推論は常に Cloudflare 上で行われます。
プロジェクト設定から環境の型定義を生成します。
npx wrangler types
Wrangler は worker-configuration.d.ts を作成します。ファイル全体を読むのではなく、生成された Env エントリを検索します。
grep -A4 'interface __BaseEnv_Env' worker-configuration.d.ts
次のような AI バインディングが出力に含まれます。
interface __BaseEnv_Env {
    AI: Ai;
}
Wrangler は生成したバインディングをベースインターフェースに配置し、その後 Env を拡張します。AI: Ai の行は一貫性を確認するために役立ちます。設定でバインディング名を変更したのにコードの更新を忘れると、デプロイは成功しても実行時に失敗する可能性があります。バインディングを変更した場合は、必ず型定義を再生成してください。後で行う完全なデプロイのドライランでは、この設定と Worker のバンドルをまとめて検証できます。
入力範囲を制限した要約エンドポイントを構築する
このステップでは、リクエストの境界処理とモデル呼び出しを実装します。言語モデルは簡潔な説明を生成するのが得意ですが、任意のリクエストを安全に処理できるかどうかを判断させるべきではありません。通常のアプリケーションコードで、推論を実行する前に、誤ったコンテンツタイプ、不正な JSON、詳細の欠落、サイズ超過の入力を拒否する必要があります。
このエンドポイントは、モデルに 2 つのメッセージを送ります。system メッセージはモデルの役割とレスポンスの制約を定義します。user メッセージには合成チケットを含めます。モデルは、単語、単語の一部、句読点などの小さなテキスト単位である トークンを読み取り、生成します。max_tokens は生成する出力を制限し、アプリケーションは受信する文字数を別途制限します。この 2 つは異なる制御です。一方は送信する内容を制限し、もう一方はモデルが生成できる内容を制限します。temperature はモデルが使用できる表現のばらつきを制御します。ここでは低い値を指定して安定した要約を促しますが、完全に同じ文になることを保証するものではありません。
Worker のエントリポイントを作成します。
cat > src/index.js <<'JS'
const MODEL = "@cf/meta/llama-3.3-70b-instruct-fp8-fast";
const MAX_DETAILS = 2000;

function json(data, status = 200) {
  return Response.json(data, { status });
}

async function readTicket(request) {
  const contentType = request.headers.get("content-type") || "";
  if (!contentType.toLowerCase().includes("application/json")) {
    return { error: json({ error: "json_required" }, 415) };
  }

  const raw = await request.text();
  if (raw.length > 4096) {
    return { error: json({ error: "ticket_too_large" }, 413) };
  }

  let body;
  try {
    body = JSON.parse(raw);
  } catch {
    return { error: json({ error: "invalid_json" }, 400) };
  }

  const subject = typeof body?.subject === "string" ? body.subject.trim() : "";
  const details = typeof body?.details === "string" ? body.details.trim() : "";
  if (!details) {
    return { error: json({ error: "invalid_ticket" }, 400) };
  }
  if (subject.length > 120 || details.length > MAX_DETAILS) {
    return { error: json({ error: "ticket_too_large" }, 413) };
  }
  return { ticket: { subject, details } };
}

async function summarize(request, env) {
  const requestId = crypto.randomUUID();
  const parsed = await readTicket(request);
  if (parsed.error) return parsed.error;

  try {
    const result = await env.AI.run(MODEL, {
      messages: [
        {
          role: "system",
          content: "Summarize this support ticket in one plain sentence. Do not invent facts."
        },
        {
          role: "user",
          content: `Subject: ${parsed.ticket.subject || "(none)"}\nDetails: ${parsed.ticket.details}`
        }
      ],
      max_tokens: 120,
      temperature: 0.2
    });

    const summary = result.response?.trim();
    if (!summary) throw new Error("empty model response");

    console.log(JSON.stringify({
      event: "ticket_summarized",
      requestId,
      model: MODEL,
      inputCharacters: parsed.ticket.details.length,
      totalTokens: result.usage?.total_tokens ?? null
    }));

    return json({ summary, model: MODEL, requestId });
  } catch (error) {
    console.error(JSON.stringify({
      event: "ticket_summary_failed",
      requestId,
      model: MODEL,
      reason: error instanceof Error ? error.message : "unknown"
    }));
    return json({ error: "model_unavailable", requestId }, 502);
  }
}

export default {
  async fetch(request, env) {
    const url = new URL(request.url);
    if (request.method === "GET" && url.pathname === "/health") {
      return json({ status: "ok" });
    }
    if (request.method === "POST" && url.pathname === "/summaries") {
      return summarize(request, env);
    }
    return json({ error: "not_found" }, 404);
  }
};
JS
各リクエストにはランダムな リクエスト IDが割り当てられます。この ID はレスポンスとログの両方に含まれるため、チケットの内容をログに記録せずに、特定のリクエストを追跡できます。コードは ID、モデルの選択、各種カウントをログに記録しますが、チケット本文は記録しません。これにより、後で オブザーバビリティ(Worker の動作を理解するための記録)を利用する際に、顧客の内容を監視データへコピーせずに済みます。また、すべての Workers AI モデルが同じオブジェクトを返すと仮定せず、このモデルが返す response 文字列を検証します。
用意された決定論的なテストを実行します。テストでは env.AI を小さなフィクスチャに置き換えるため、モデルの使用量は消費しません。
node --test test/worker.test.mjs
4 つのテストがすべて成功することを確認します。次に、デプロイせずに Worker をビルドするよう Wrangler に指示します。
npx wrangler deploy --dry-run
テストでは、制御されたモデルデータを使って入力と出力の契約を検証します。ドライランでは、Wrangler が実際の Worker をバンドルできることを検証します。ただし、どちらもモデルが現在利用可能であることや、このアカウントにデイリー無料割り当てが残っていることまでは証明しません。次のステップで、実際のリクエストを 1 回送って確認します。
ローカルで 1 回推論を実行する
このステップでは、VM からリクエストハンドラーを実行し、AI バインディングから実際の Cloudflare ホストモデルを呼び出します。これは ローカル開発と呼ばれますが、ローカルなのは Worker プロセスだけです。推論はリモートで実行され、使用量として計上されます。
Wrangler をポート 8787 でバックグラウンド起動します。> はログをファイルに保存し、2>&1 はエラーを同じファイルへ送信し、& はサーバーを実行したままターミナルプロンプトを返します。$! を保存すると、後でクリーンアップするプロセス ID を記録できます。
npx wrangler dev --port 8787 > .labex/dev.log 2>&1 &
echo $! > .labex/dev.pid
ヘルスルートが応答するまで待ちます。
for attempt in $(seq 1 30); do
  if curl --silent --fail http://127.0.0.1:8787/health; then
    break
  fi
  sleep 1
done
ヘルスレスポンスが {"status":"ok"} になることを確認します。このリクエストではモデルを呼び出しません。次に、小さな合成チケットを 1 件送信します。--data により POST リクエストになり、ヘッダーにより Worker は JSON として解析します。
curl --silent --show-error http://127.0.0.1:8787/summaries \
  --header 'Content-Type: application/json' \
  --data '{"subject":"Invoice upload fails","details":"After signing in, the customer selects a PDF invoice. The upload stops before completion and no confirmation appears."}' | jq
空ではない summary、正確なモデル ID、実行ごとに異なる requestId が返ることを確認します。文章は次の例と異なっていても構いません。
{
  "summary": "The customer cannot complete a PDF invoice upload after signing in.",
  "model": "@cf/meta/llama-3.3-70b-instruct-fp8-fast",
  "requestId": "..."
}
不正な入力が、推論の前に通常のアプリケーションコードで拒否されることを確認します。
curl --silent --show-error --write-out '\nHTTP %{http_code}\n' \
  http://127.0.0.1:8787/summaries \
  --header 'Content-Type: application/json' \
  --data '{"details":""}'
{"error":"invalid_ticket"} と HTTP 400 が返ることを確認します。このリクエストはモデルに送信されません。有効なリクエストで model_unavailable が返った場合は、.labex/dev.log を確認してください。無料割り当ての枯渇、モデルの容量不足、認証エラーは、エンドポイントの契約が正しく動作した証拠ではありません。
Worker をデプロイして AI の動作を確認する
このステップでは、ローカルプロセスを停止し、同じコードを Cloudflare にデプロイして、コマンドラインの結果と Dashboard に表示される状態を結び付けます。
保存した開発プロセスだけを停止し、終了するまで待ちます。
kill "$(cat .labex/dev.pid)"
wait "$(cat .labex/dev.pid)" 2>/dev/null || true
Worker をデプロイします。
npx wrangler deploy
Wrangler に公開 workers.dev URL が表示されます。その URL を正確に保存し、下の例の値を置き換えます。
WORKER_URL="https://YOUR_WORKER_URL"
デプロイ済みエンドポイントに、新しい合成チケットを送信します。
curl --silent --show-error "$WORKER_URL/summaries" \
  --header 'Content-Type: application/json' \
  --data '{"subject":"Password reset loop","details":"The customer opens the reset email, chooses a new password, and returns to the sign-in page, but the old password remains active."}' | jq
生成される文は異なっていても構いません。ただし、model には Llama 3.3 が示され、requestId が存在する必要があります。これにより、公開 Worker が設定済みの AI バインディングに到達したことを確認できます。
Cloudflare Dashboard を開き、Workers & Pages → Overview → labex-c07-a01-... という名前の Worker → Settings → Bindings の順に移動します。AI Workers AI バインディングを探します。これは、wrangler.jsonc の設定とコード内の env.AI を結び付ける、目で確認できる接続です。
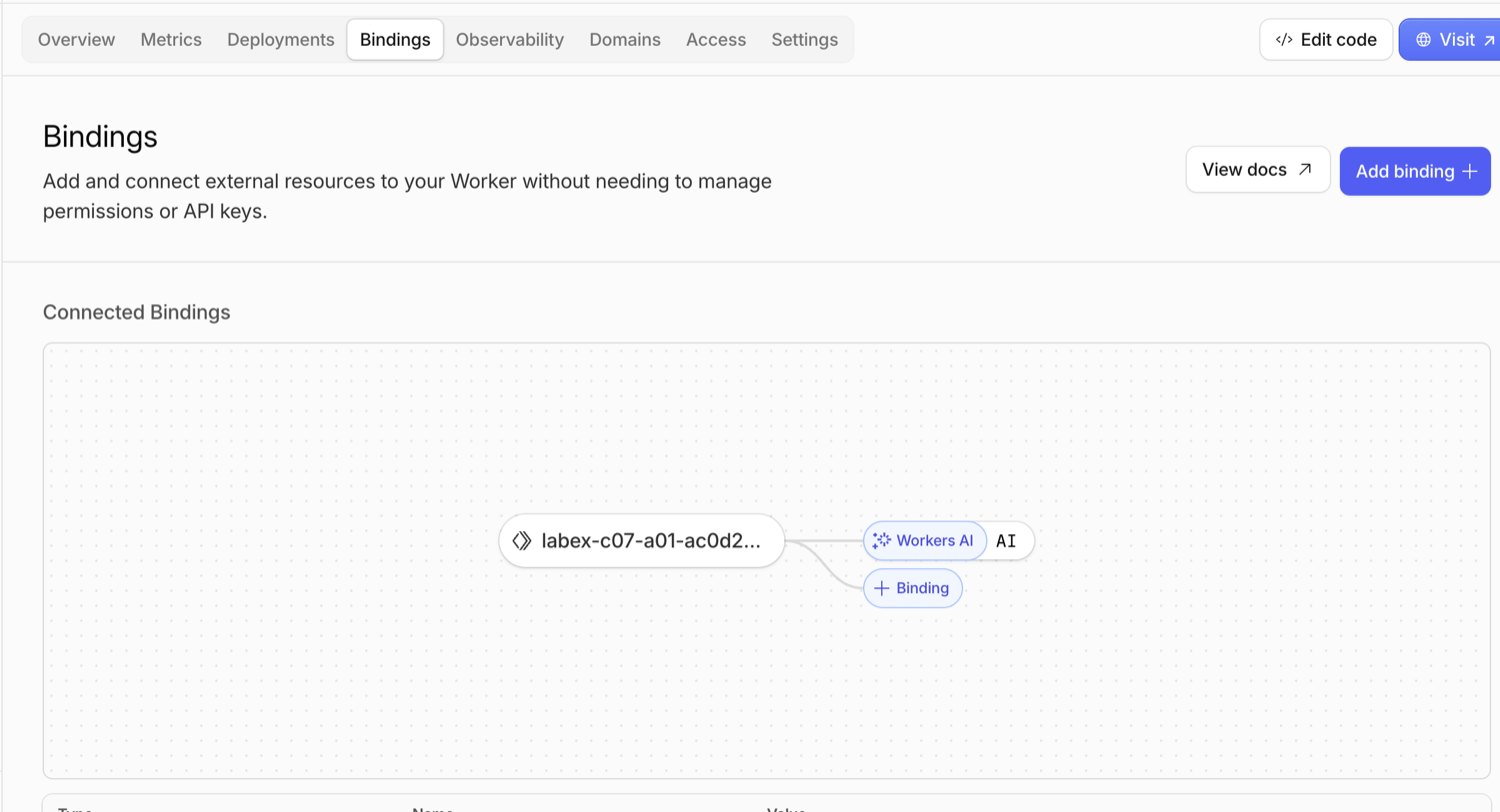
この例では、env.AI で使用した名前と一致する AI というバインディング名が表示されています。使い捨て Worker の名前は異なります。
次に、同じ Worker の Observability → Logs を開きます。最近成功した呼び出しを探し、構造化された ticket_summarized ログを展開します。ログのリクエスト ID と、デプロイ後のレスポンスのリクエスト ID が一致することを確認します。ログにはモデルと各種カウントが表示されますが、チケット本文は表示されません。保存済みログがまだ届いていない場合は、Real-time logs を使用し、小さな合成リクエストをもう 1 件送って、その呼び出しを確認します。
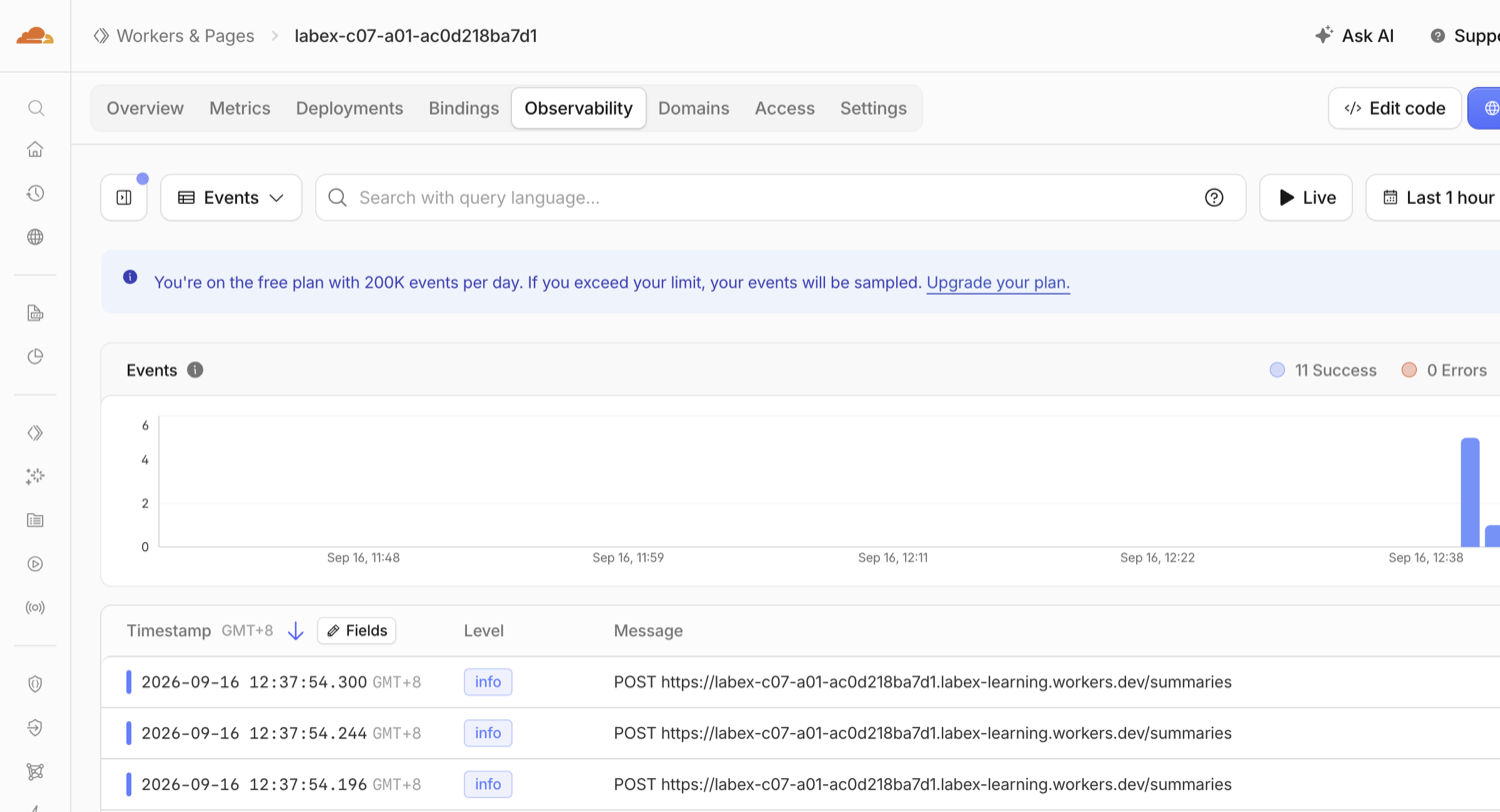
概要画面では、まずリクエストがエラーなく Worker に到達したことを確認できます。リクエストを 1 件開くと、構造化されたアプリケーションイベントが表示されます。
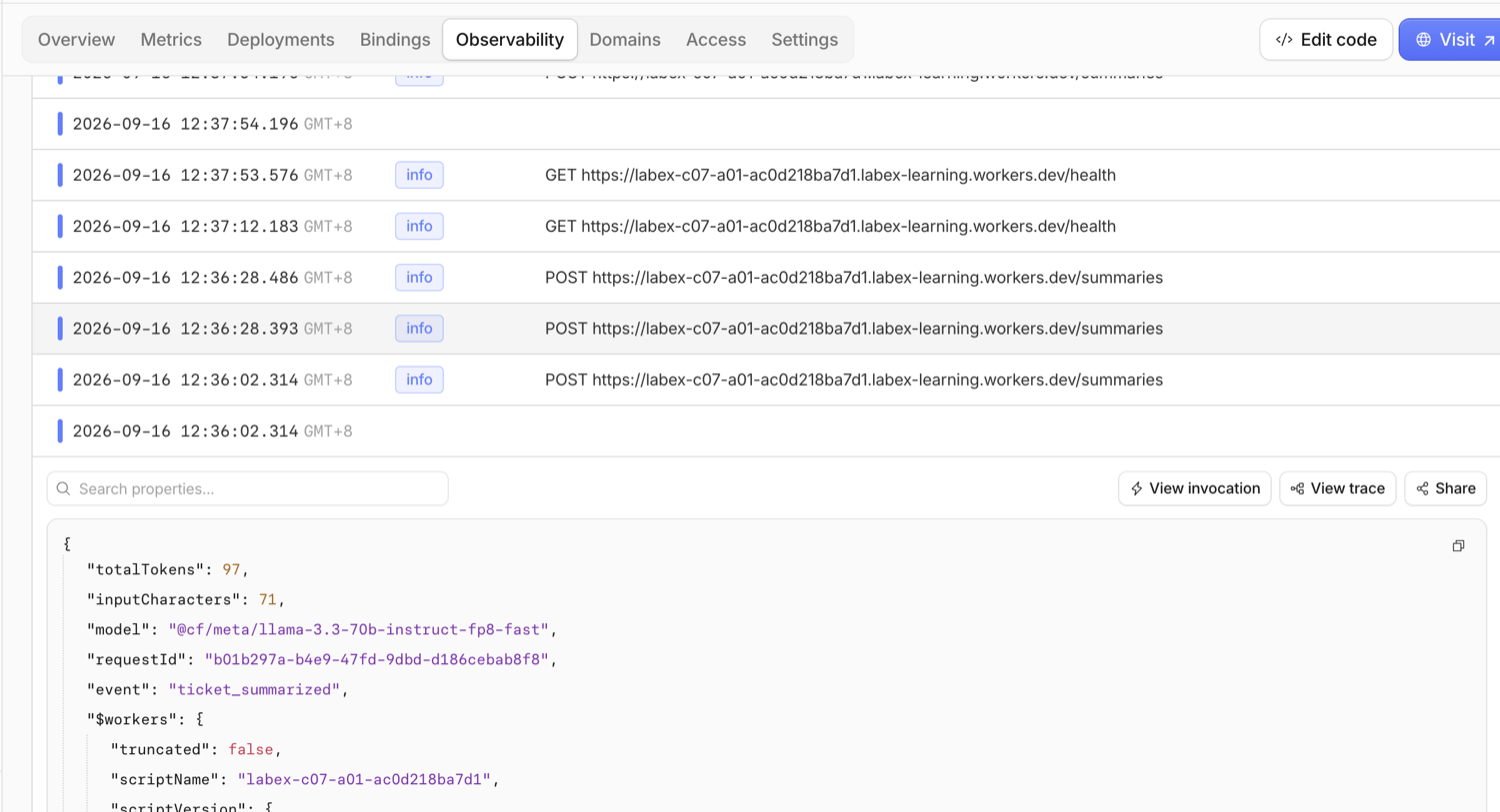
ログにはモデル、トークン数、リクエスト ID などの運用上の情報が含まれますが、サポートチケットの subject や details は含まれていません。これは、作成したログコードによって実現したプライバシー境界です。
最後に、Developer Platform のナビゲーションから Workers AI を開き、使用量画面を確認します。この範囲を制限したテストに関連する、最近のモデルアクティビティまたは Neuron 使用量を探します。使用量データはリクエストより遅れて表示されることがあります。直後にグラフが空でも判断材料にはならないため、推論リクエストを繰り返して「修正」しようとしないでください。
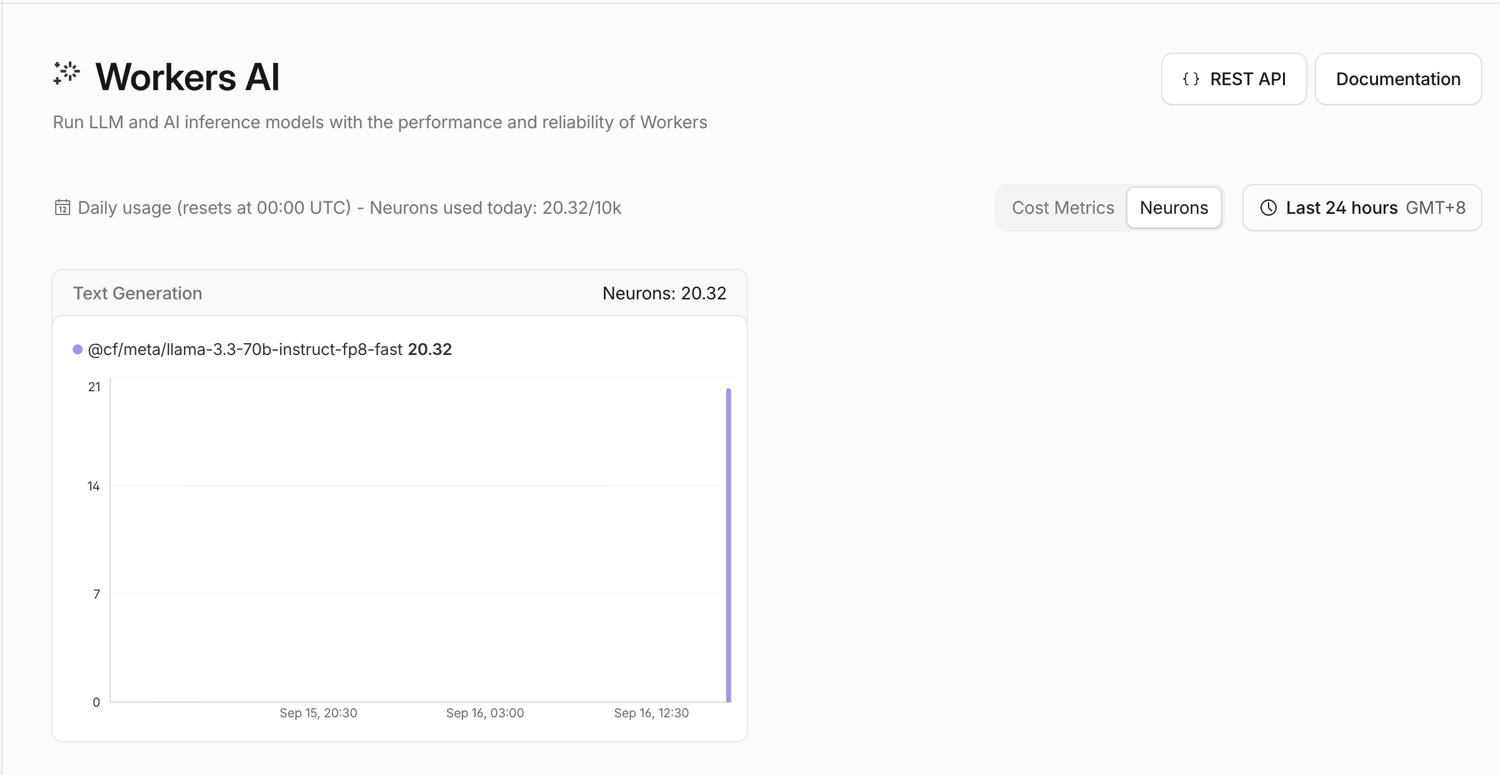
ここで 20.32/10k は、この受け入れテストでアカウントのデイリー Free 割り当てのごく一部だけを消費したことを意味します。合計値には学習用アカウントで行った他の Workers AI アクティビティも含まれるため、スクリーンショットと一致しません。
この実験の Dashboard スクリーンショットには、1 回の使い捨て受け入れテストで得られた例の値が表示されています。Worker 名、リクエスト ID、タイムスタンプ、トークン数、使用量の合計は異なります。
Worker を削除してログアウトする
このステップでは、使い捨てのクラウドアプリケーションを削除してから、この VM の Wrangler セッションを無効化します。Worker を削除すると公開エンドポイントは停止しますが、Workers のプランやアカウントレベルの使用量記録は変更されません。
wrangler.jsonc に記載された Worker を削除します。
npx wrangler delete
Wrangler にこの実験用の一意の名前が表示されたら、削除を確認します。他のアプリケーションは削除しないでください。Dashboard で Workers & Pages → Overview に戻り、正確な名前が labex-c07-a01-... で始まる Worker が存在しないことを確認します。スクリプトを削除した後も、過去のログや使用量が残ることがあります。
Wrangler は、削除を完了する前に、別の Worker がこの Worker に依存していないかを確認します。そのため、アプリケーションで KV を使用していなくても、先ほどのログインで KV のクリーンアップ権限を指定しました。削除が成功すると、認証エラーなしでプロンプトに戻ります。
VM がまだ認証済みの状態で、削除確認を実行します。
python3 .labex/verify.py deleted
PASS: deleted と表示されたことを確認してから、保存された認証情報を削除します。
npx wrangler logout
npx wrangler whoami --json
最後の出力で loggedIn: false と表示される必要があります。ネットワークエラーはログアウトの証明にはなりません。
まとめ
AI バインディングを使って Worker を Cloudflare ホストモデルに接続し、入力と生成出力の範囲を制限しました。また、モデル使用量を消費する前に決定論的な動作をテストし、ローカル環境とデプロイ後の環境で実際の推論を実行しました。さらに、レスポンスを Dashboard のバインディング、ログ、使用量の情報と結び付けて確認しました。最後に、使い捨て Worker を削除し、新しい VM から安全にログアウトしました。