はじめに
AI モデルが長い回答を生成するとき、結果全体を待つとアプリケーションが固まったように感じられることがあります。ストリーミングを使うと、準備できた小さなデータ片をすぐにアプリケーションへ渡せます。送信者が入力している途中でメッセージを読む場合に似ています。完全な回答を生成するための処理量はおおむね同じですが、役立つテキストをより早く表示できます。
この実験では、1 つの HTTP レスポンスで一連のイベントを送信するテキスト形式、Server-Sent Events(SSE)を使用します。Workers AI の各イベントは data: で始まります。テキストイベントには生成された回答の一部が含まれ、最後の data: [DONE] イベントはストリームが正常に完了したことを示します。イベント間に一時停止があっても、モデルが処理中である可能性があります。完了シグナルがなければ、アプリケーションは遅いレスポンスと、永遠に完了しない接続を区別できません。
この実験では POST /help を作成し、Cloudflare 上の Llama のレスポンスを指定したコマンドラインクライアントへストリーミングします。また、正常完了と、最初の有効なデータ片を受け取った直後に意図的にキャンセルする 2 つの終了方法を確認します。キャンセルとは、クライアントが残りの回答を必要としなくなったため、未使用の接続を開いたままにせず処理を終了することです。さらに、決定論的なテストを使って、モデルの起動失敗が一定時間内にエラーとなること、および中断されたストリームがハングせず終了することを検証します。
これはコースの 2 番目の実験です。Cloudflare Worker が Cloudflare のネットワーク上で実行されるアプリケーションコードであり、AI バインディングによって Workers AI が env.AI として公開されることを前提としています。コースに直接アクセスした場合は、まず LabEx を Cloudflare アカウントに接続する を完了してください。VM のターミナルの使い方、Wrangler の認証、学習用アカウントの確認、アカウント ID の保存方法を学べます。
この実験では @cf/meta/llama-3.3-70b-instruct-fp8-fast と小さな合成質問を使用します。Workers Free アカウントには現在、共有の 1 日あたり 10,000 Neurons の割り当てがあります。ローカル推論も Cloudflare に接続し、この割り当てを消費します。割り当てを使い切った場合やモデルに容量がない場合は、リクエストを繰り返し送信せず停止してください。アプリケーションはハングするのではなく、終了エラーを報告する必要があります。
セットアップでは、Node.js 22.22.0 とプロジェクトローカルの Wrangler 4.132.0 を /home/labex/project/help-stream にインストールします。SSE クライアント、決定論的なフィクスチャ、独立したチェックも用意されます。セットアップによってログイン、モデルの呼び出し、Worker のデプロイ、クラウドリソースの作成は行われません。使い捨ての Worker を削除し、ログアウトを確認するまで、この VM を開いたままにしてください。
VM を認証し、ストリーミング Worker を設定する
このステップでは、新しい VM を認証し、使い捨てのストリーミング Worker を設定します。Dashboard にログインしていても、ターミナルのコマンドに学習用アカウントを管理する権限が自動的に付与されるわけではありません。
用意されたプロジェクトへ移動し、固定された Wrangler のバージョンを確認します。
cd /home/labex/project/help-stream
npx wrangler --version
4.132.0 と表示されることを確認します。ここで必要な権限だけを要求します。Workers Scripts の書き込み権限は使い捨ての Worker を管理するために必要です。Workers AI の書き込み権限は、そのバインディングからモデルを呼び出すために必要です。2 つの読み取り権限は、選択したアカウントを識別するために使います。Wrangler 4.132.0 は Worker の削除時に KV バインディングの依存関係も確認するため、この実験では KV データを作成しませんが、狭い範囲の KV 書き込み権限によってクリーンアップコマンドを完了できます。
npx wrangler login --device --browser=false --scopes account:read user:read workers_scripts:write workers_kv:write ai:write
表示されたリンクを開き、現在のデバイスコードを入力して、アカウントと権限を確認し、学習用アカウントを認証します。ブラウザを閉じた後も Wrangler が処理を続けるため、Background Access が表示されることもあります。ターミナルに戻り、成功メッセージが表示されるまで待ってから、構造化された ID 情報を確認します。
npx wrangler whoami --json
loggedIn: true を確認し、対象アカウントの name と id を読み取ります。使い捨て Worker に使用する一意の名前を生成します。
RUN="labex-c07-a02-$(openssl rand -hex 6)"
printf '%s\n' "$RUN"
下の YOUR_ACCOUNT_ID を、そのアカウントの実際の ID に置き換えます。
cat > wrangler.jsonc <<JSON
{
  "\$schema": "./node_modules/wrangler/config-schema.json",
  "name": "$RUN",
  "account_id": "YOUR_ACCOUNT_ID",
  "main": "src/index.js",
  "compatibility_date": "2026-09-16",
  "compatibility_flags": ["enable_request_signal"],
  "workers_dev": true,
  "preview_urls": false,
  "observability": {
    "enabled": true,
    "head_sampling_rate": 1
  },
  "ai": {
    "binding": "AI",
    "remote": true
  }
}
JSON
AI バインディングは env.AI として使用できるようになります。remote: true により、ローカル開発中も実際のクラウドモデルが使われます。enable_request_signal はクライアントが切断したときに request.signal で通知できるようにし、Worker がキャンセルシグナルを記録して処理できるようにします。Observability を有効にすると、後で確認するライフサイクルイベントが保存されます。この時点では Worker はデプロイされておらず、推論も実行されていません。
AI バインディングと SSE クライアントを確認する
このステップでは、Worker を作成する前に AI バインディングを用意された SSE クライアントへ接続します。モデルがデータの生成元、Worker がバイト列の転送役、client.mjs がデータの受信側です。これらの役割を分けると、どのコンポーネントが処理を終了すべきかが明確になります。
Worker の環境型を生成します。
npx wrangler types
grep -A4 'interface __BaseEnv_Env' worker-configuration.d.ts
AI: Ai を探します。これは、設定したバインディングをハンドラーから env.AI として利用できることを意味します。ソースコードに保存した API キーではありません。
次に、用意されたクライアントが示す終了状態を確認します。
grep -nE 'chunk:|complete chunks=|cancelled after|stream_error:' client.mjs
クライアントはレスポンスを少しずつ読み取ります。chunk: の行には、新しく生成されたテキストが表示されます。complete は data: [DONE] を受信した後にだけ表示されます。キャンセルモードでは、最初の空でないデータ片を受信した後にリーダーを閉じます。stream_error は 45 秒のタイムアウトを含む終了エラーです。このタイムアウトは安全のための上限であり、すべてのモデルレスポンスに 45 秒かかるという予測ではありません。
SSE イベントは、空行で区切られたプレーンテキストです。一般的な成功ストリームは次のようになります。
data: {"response":"First piece"}

data: {"response":" and another piece."}

data: [DONE]
チャンクの境界は転送上の詳細です。1 つのイベントに単語、句読点、またはより長い断片が含まれることがあります。アプリケーションロジックでは、チャンク数やサイズを固定とみなさず、response の文字列を結合して [DONE] を待ちます。
監視機能付きのストリーミングエンドポイントを作成する
このステップでは、ストリーミングエンドポイントと、そのライフサイクル監視機能を作成します。Worker は stream: true を指定してモデルにストリームを要求し、同じ SSE プロトコルをクライアントへ公開します。回答全体を先にメモリへ読み込むことはありません。小さなラッパーがストリームのライフサイクルを監視します。完了時は正常に閉じ、キャンセル時は上流のリーダーをキャンセルし、ストリームエラー時はレスポンスを終了します。
Worker のエントリーポイントを作成します。
cat > src/index.js <<'JS'
const MODEL = "@cf/meta/llama-3.3-70b-instruct-fp8-fast";
const MAX_QUESTION = 800;

function json(data, status = 200) {
  return Response.json(data, { status });
}

async function readQuestion(request) {
  const contentType = request.headers.get("content-type") || "";
  if (!contentType.toLowerCase().includes("application/json")) {
    return { error: json({ error: "json_required" }, 415) };
  }

  const raw = await request.text();
  if (raw.length > 2048) {
    return { error: json({ error: "question_too_large" }, 413) };
  }

  let body;
  try {
    body = JSON.parse(raw);
  } catch {
    return { error: json({ error: "invalid_json" }, 400) };
  }

  const question = typeof body?.question === "string" ? body.question.trim() : "";
  if (!question) {
    return { error: json({ error: "invalid_question" }, 400) };
  }
  if (question.length > MAX_QUESTION) {
    return { error: json({ error: "question_too_large" }, 413) };
  }
  return { question };
}

function monitor(upstream, details) {
  const reader = upstream.getReader();
  let terminal = false;

  return new ReadableStream({
    async pull(controller) {
      try {
        const { done, value } = await reader.read();
        if (done) {
          terminal = true;
          console.log(JSON.stringify({ event: "help_stream_completed", ...details }));
          controller.close();
          return;
        }
        controller.enqueue(value);
      } catch {
        terminal = true;
        console.error(JSON.stringify({ event: "help_stream_failed", ...details }));
        controller.error(new Error("model stream interrupted"));
      }
    },
    async cancel(reason) {
      if (!terminal) {
        terminal = true;
        console.log(JSON.stringify({ event: "help_stream_cancelled", ...details }));
      }
      await reader.cancel(reason);
    }
  });
}

async function streamHelp(request, env) {
  const parsed = await readQuestion(request);
  if (parsed.error) return parsed.error;

  const requestId = crypto.randomUUID();
  const details = { requestId, model: MODEL };
  request.signal.addEventListener("abort", () => {
    console.log(JSON.stringify({ event: "help_client_disconnected", ...details }));
  }, { once: true });

  try {
    const upstream = await env.AI.run(MODEL, {
      messages: [
        {
          role: "system",
          content: "Answer the support question in at most four short sentences. Give safe, practical steps and do not invent account details."
        },
        { role: "user", content: parsed.question }
      ],
      stream: true,
      max_tokens: 160,
      temperature: 0.2
    });

    if (!(upstream instanceof ReadableStream)) {
      throw new Error("stream unavailable");
    }

    console.log(JSON.stringify({ event: "help_stream_started", ...details }));
    return new Response(monitor(upstream, details), {
      headers: {
        "content-type": "text/event-stream; charset=utf-8",
        "cache-control": "no-store",
        "x-request-id": requestId
      }
    });
  } catch {
    console.error(JSON.stringify({ event: "help_stream_start_failed", ...details }));
    return json({ error: "model_unavailable", requestId }, 502);
  }
}

export default {
  async fetch(request, env) {
    const url = new URL(request.url);
    if (request.method === "GET" && url.pathname === "/health") {
      return json({ status: "ok" });
    }
    if (request.method === "POST" && url.pathname === "/help") {
      return streamHelp(request, env);
    }
    return json({ error: "not_found" }, 404);
  }
};
JS
このコードはリクエスト ID とライフサイクルイベントを記録しますが、質問や生成された回答は記録しません。リクエスト IDは、サポート内容を Observability データへコピーせずに、1 つのクライアントレスポンスと 1 つのログエントリを関連付けます。エラーレスポンスでは内部プロバイダーの詳細も隠します。運用担当者はライフサイクルログを利用し、クライアントには安定した model_unavailable の契約を返せます。
決定論的なテストを実行します。テスト用の AI バインディングは、制御されたイベントを生成し、ストリーミング前に失敗し、キャンセルに対応し、Neurons を消費せずに 1 つのストリームを中断します。
node --test test/worker.test.mjs
6 個のテストが成功することを確認します。次に、デプロイせずに実際の Worker をバンドルします。
npx wrangler deploy --dry-run
テストでは、制御されたタイミングでのアプリケーションの動作を検証します。dry run では、ソースコードと設定をまとめてバンドルできることを検証します。どちらも、クラウドモデルが現在利用可能であることまでは検証しません。次のステップでは、実際のストリームを 1 つ使用します。
実際のローカルストリームを確認する
このステップでは、VM 上で実行する Worker プロセスを通して、実際のストリームを 1 つ確認します。「ローカル」とはリクエストハンドラーがローカルで動作することを指します。モデル推論は選択したアカウントで実行され、1 日あたりの割り当てを消費します。
Wrangler をバックグラウンドで起動し、プロセス ID を保存します。
npx wrangler dev --port 8787 > .labex/dev.log 2>&1 &
echo $! > .labex/dev.pid
AI を使用しないヘルスチェック用ルートが応答するまで待ちます。
for attempt in $(seq 1 30); do
  if curl --silent --fail http://127.0.0.1:8787/health; then
    break
  fi
  sleep 1
done
次に、用意されたクライアントで小さな合成質問を 1 つ送信します。
node client.mjs http://127.0.0.1:8787 \
  "How can I safely retry an invoice upload without creating a duplicate ticket?"
1 行以上の chunk: に続いて、次のような終了行が表示されます。
complete chunks=18 chars=238
テキスト、チャンク数、文字数は異なります。重要なのは、空でない増分コンテンツの後に [DONE] が送信され、それをクライアントが complete に変換していることです。stream_error が表示された場合は .labex/dev.log を確認します。クォータ、認証、容量に関するエラーは推論の失敗です。永遠に待つ理由にはなりません。
最後に、推論の前にアプリケーションの入力検証が行われることを確認します。
curl --silent --show-error --write-out '\nHTTP %{http_code}\n' \
  http://127.0.0.1:8787/help \
  --header 'Content-Type: application/json' \
  --data '{"question":""}'
{"error":"invalid_question"} と HTTP 400 が表示されることを確認します。ストリームは、通常のリクエストが境界チェックを通過した後にだけ役立ちます。
Worker をデプロイし、ストリームを完了・キャンセルする
このステップでは、Worker をデプロイし、1 つのストリームを完了させ、別のストリームを最初の有効なデータ片の後にキャンセルします。まず、保存した開発プロセスだけを停止し、終了するまで待ちます。
kill "$(cat .labex/dev.pid)"
wait "$(cat .labex/dev.pid)" 2>/dev/null || true
同じ Worker コードをデプロイします。
npx wrangler deploy
Wrangler が表示した正確な workers.dev URL を保存します。
WORKER_URL="https://YOUR_WORKER_URL"
まず、正常に完了するストリームを確認します。
node client.mjs "$WORKER_URL" \
  "How can I safely retry an invoice upload without creating a duplicate ticket?"
最後の complete 行は、モデルが [DONE] を送信したことを意味します。最初のデータ片を受信しただけでは、レスポンス全体が完了したことは確認できません。
次に、2 つ目のストリームを開始し、最初の空でないデータ片を受信した直後に意図的に停止します。
node client.mjs "$WORKER_URL" \
  "Explain four checks to make before retrying a failed file upload." \
  --cancel-after-first
chunk: が 1 行表示された後、cancelled after 1 chunk が表示されます。キャンセルはモデルエラーではありません。クライアントが残りの回答を必要としないと意図的に判断したためです。リーダーを閉じると上流のストリームへキャンセルが伝わり、受信リクエストのシグナルによって Worker は切断を記録できます。
Cloudflare Dashboard を開き、Workers & Pages → Overview → labex-c07-a02-... Worker → Observability → Logs の順に移動します。最近のリクエストを探します。以下の概要は、使い捨ての受け入れテスト 1 回分です。14 Success と 0 Errors は、Worker がヘルスチェック、完了したストリーム、意図的な切断を、失敗した呼び出しなしで処理したことを示します。合計値とタイムスタンプは異なります。
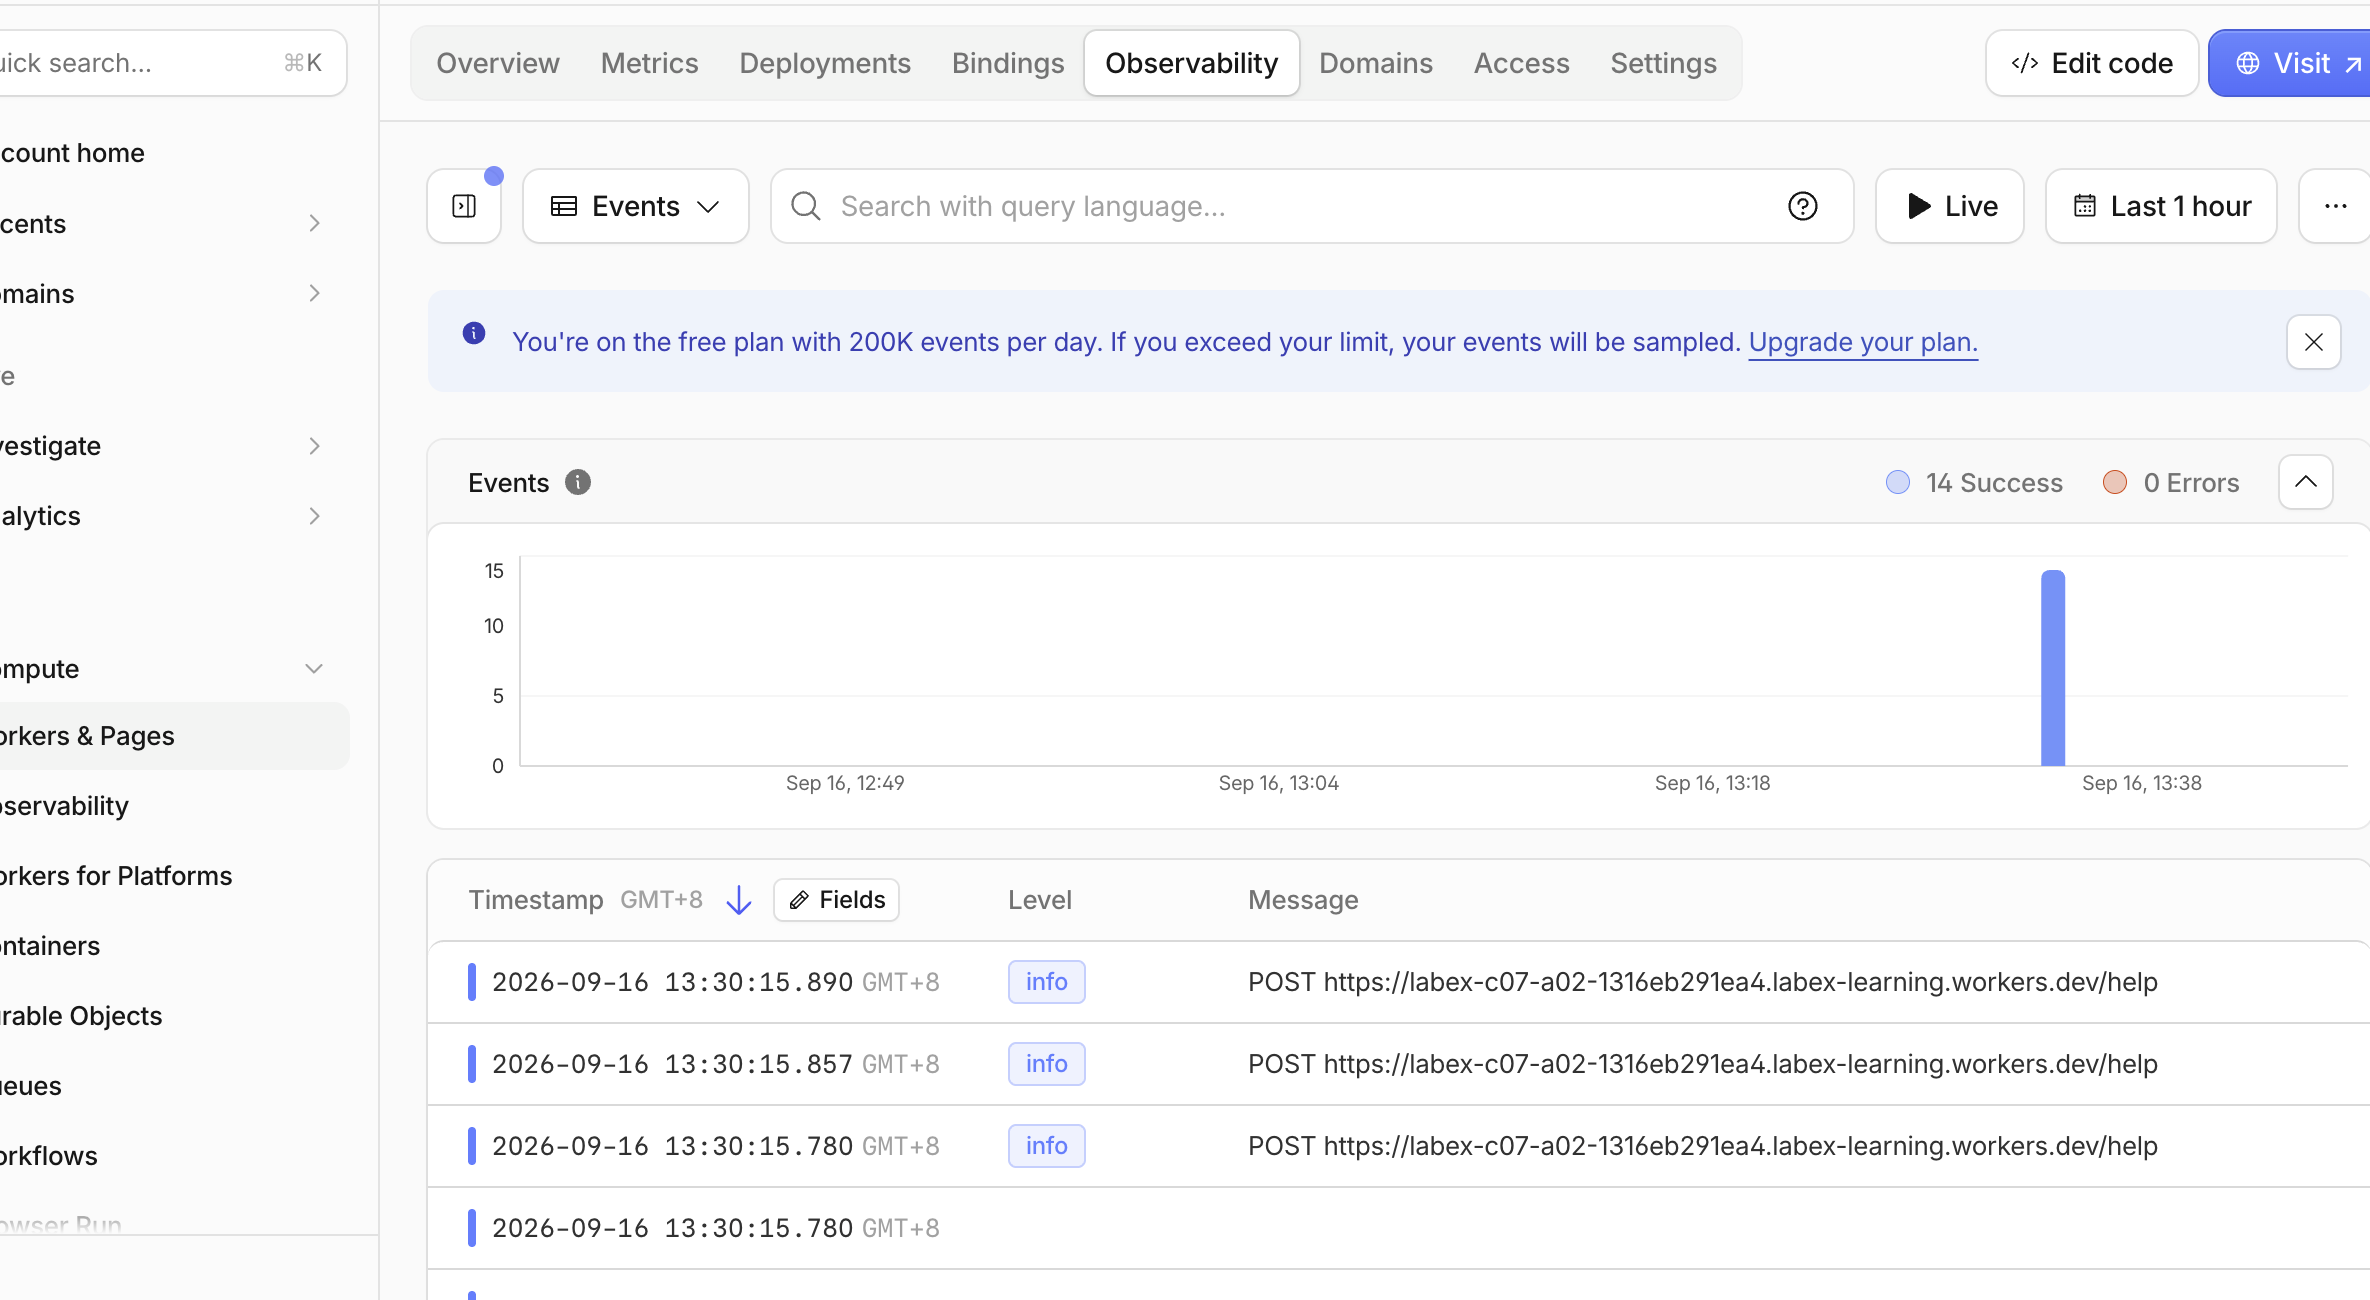
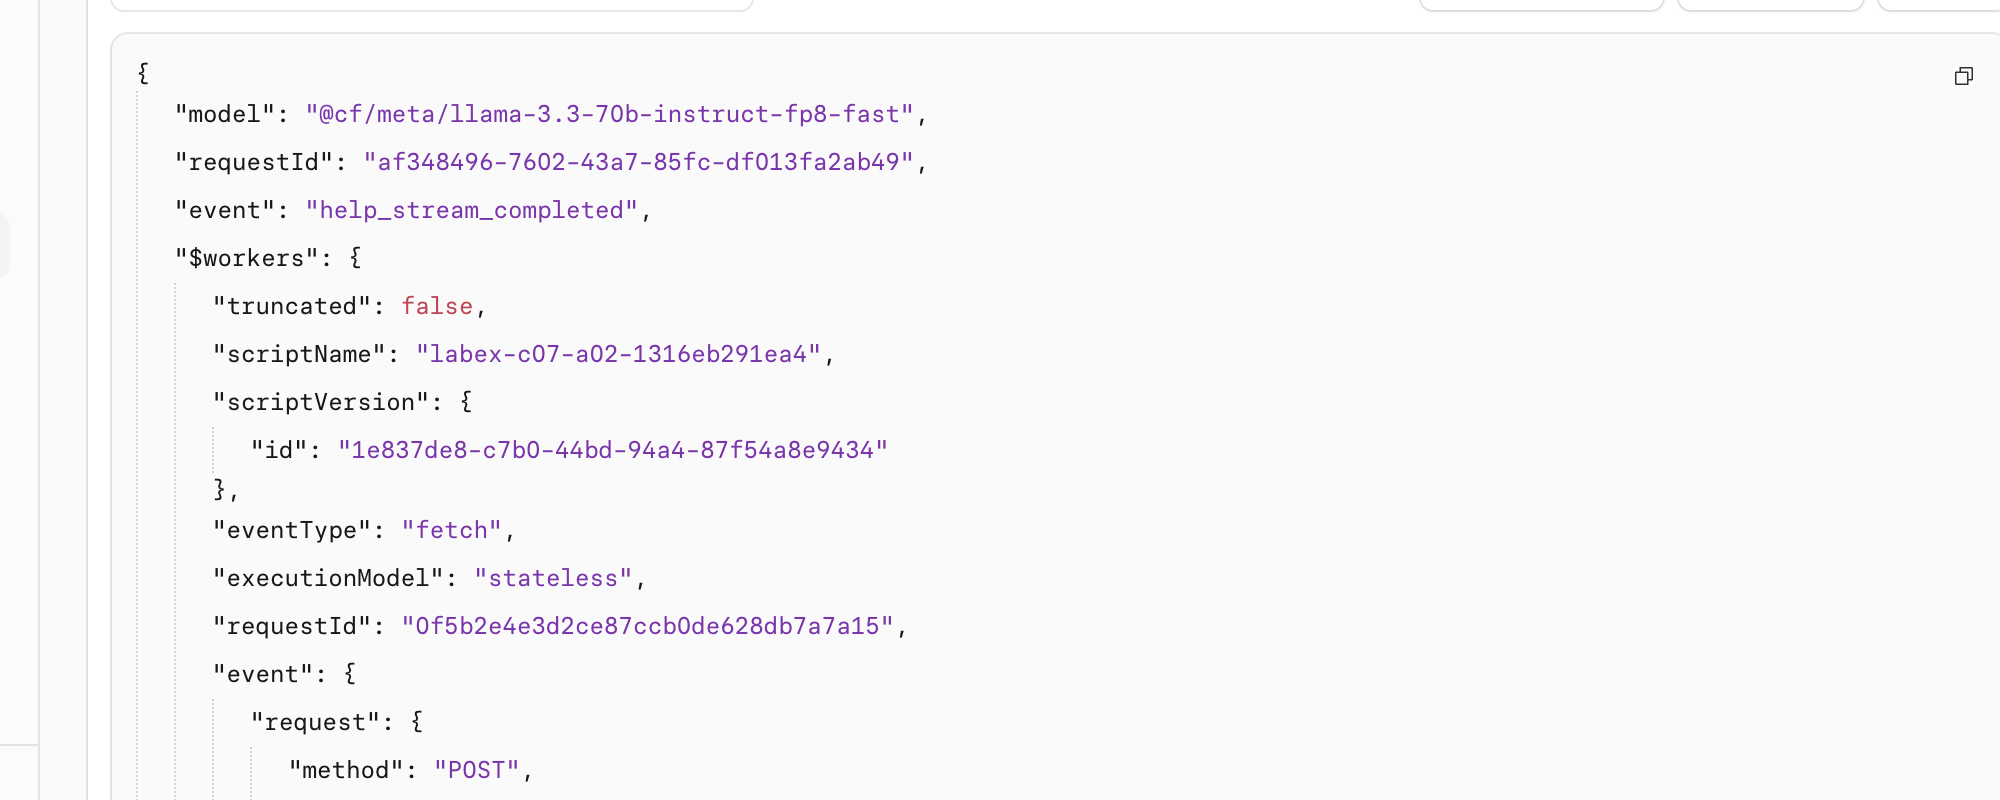
help_stream_completed を検索し、結果を 1 件展開して model、requestId、event を確認します。リクエスト ID は安全な相関値です。学習者の質問や生成された回答を保存せずに、ライフサイクルの記録を関連付けるのに役立ちます。
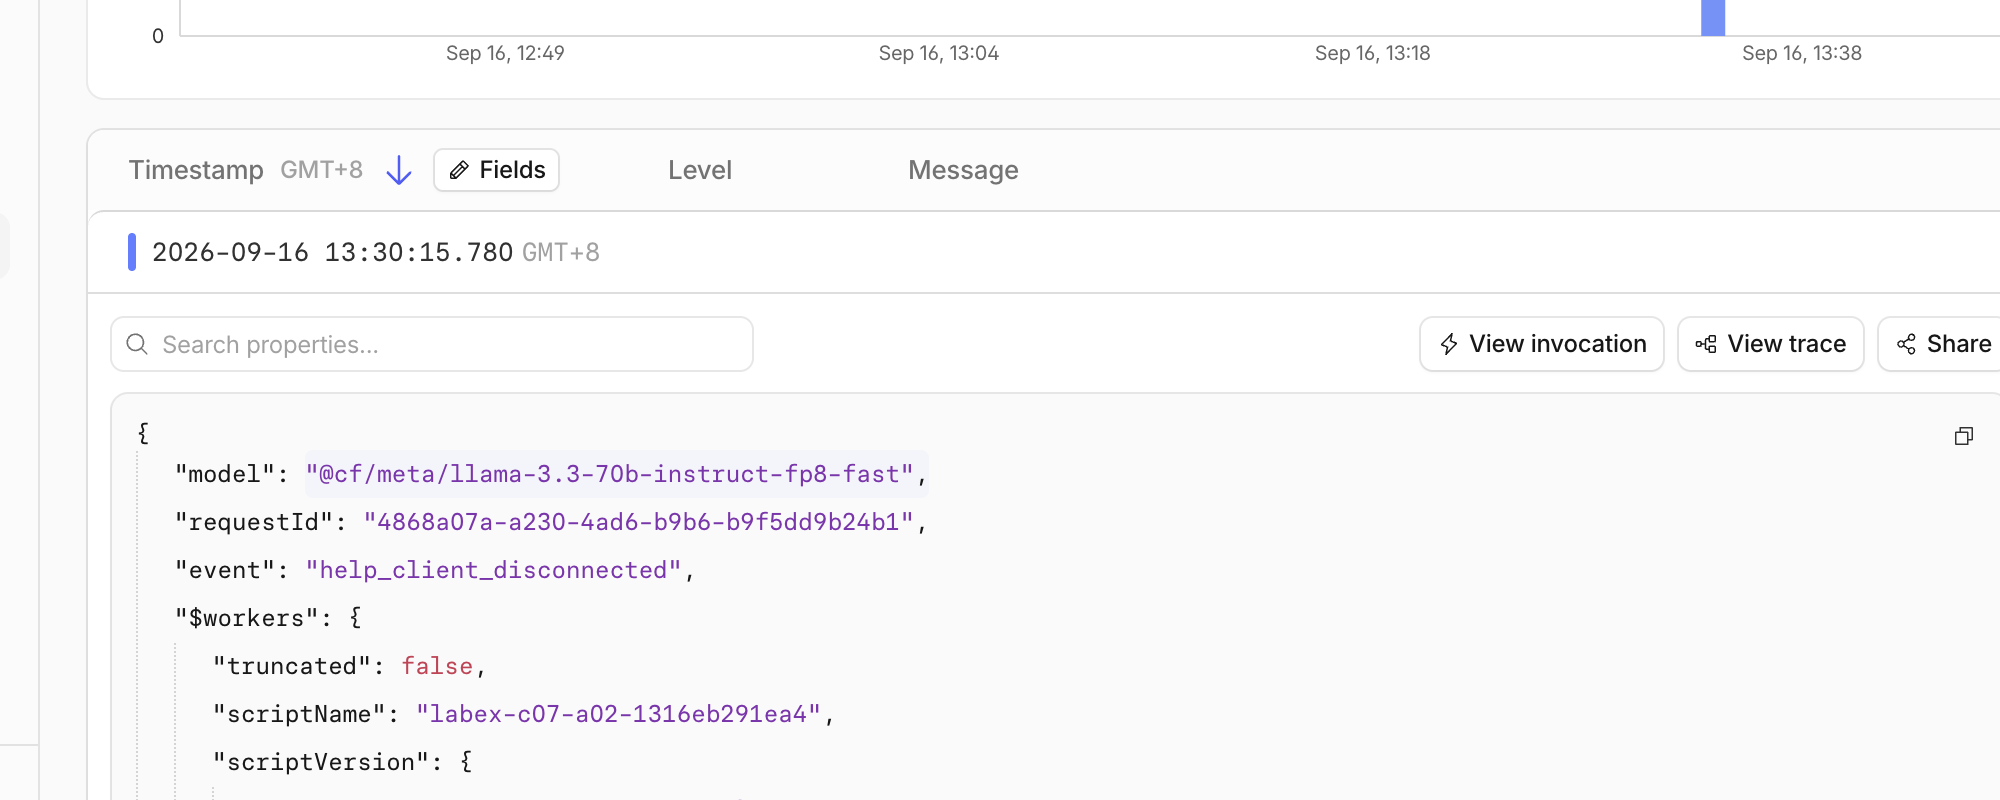
意図的にキャンセルした公開リクエストについては、help_client_disconnected を検索します。enable_request_signal を有効にすると、このイベントによって受信クライアントが切断したことを直接確認できます。ステップ 4 の決定論的テストでは、下流の cancel() がモデルのフィクスチャまで到達し、help_stream_cancelled を記録することを別途検証しています。実際のネットワークタイミングによっては、クラウド上で確認できる記録がリクエストシグナルのイベントになる場合があります。保存されたログはレスポンスより遅れて到着することがあるため、少し待ち、必要な場合に限って追加のキャンセルリクエストを最大 1 回だけ、上限時間を設けて実行します。
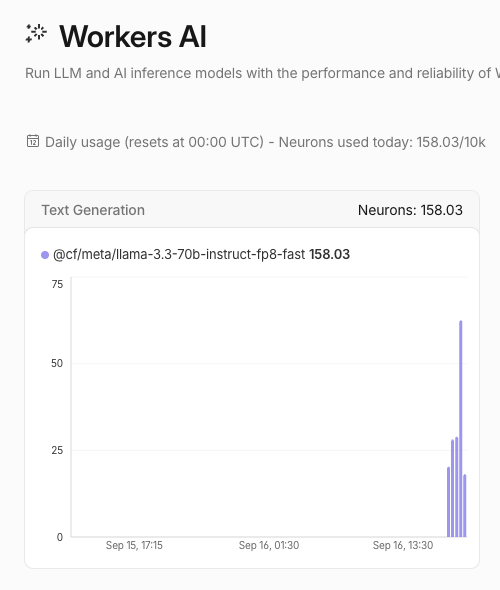
次に Workers AI を開き、今日のモデル使用量を確認します。Llama 3.3 モデルを探し、小さな演習が 10,000 Neurons の Free 割り当て内に収まっていることを確認します。次の例では、学習用アカウントでのすべての処理が 158.03/10k Neurons を使用しています。これにはそのアカウントで実行した他の演習も含まれるため、表示される数値は異なります。アカウントが Free 割り当て内に収まっている間は、Workers Paid プランはこの実験に必要ありません。使用量の表示には遅延がある場合があるため、グラフを更新するためだけに推論を繰り返さないでください。
これらのスクリーンショットにある Worker 名、リクエスト ID、タイムスタンプ、使用量は、使い捨ての実行で得られた例です。学習の対象は正確な値ではなく、イベント名とライフサイクルの関係です。
Worker を削除してログアウトする
このステップでは、使い捨ての Worker を削除し、その後この VM からログアウトします。Workers AI の使用量記録はアカウント単位の履歴です。そのため、Worker を削除すると公開エンドポイントは削除されますが、過去の記録が消えたり、アカウントのプランが変更されたりすることはありません。
wrangler.jsonc に記載されている正確な名前の Worker を削除します。
npx wrangler delete
Wrangler にこの実験で生成した一意の labex-c07-a02-... 名が表示されている場合だけ確認します。コマンドの最後に Successfully deleted と表示されます。Dashboard で Workers & Pages → Overview を更新し、その正確な名前が存在しないことを確認します。
VM がまだ認証済みの状態で、独立した管理チェックを実行します。
python3 .labex/verify.py deleted
PASS: deleted と表示された後にだけ、この VM に保存されている認証情報を削除します。
npx wrangler logout
npx wrangler whoami --json
loggedIn: false であることを確認します。ローカルファイルがないこと、ブラウザタブを閉じたこと、ネットワークエラーが発生したことだけでは、クラウド上の削除やログアウトを証明できません。
まとめ
回答全体をバッファリングするのではなく、増分 SSE 出力を転送する Workers AI エンドポイントを作成しました。クライアントに明示的な [DONE] シグナルが必要な理由、タイムアウトによって無期限の待機を防ぐ方法、意図的なキャンセルと失敗の違い、ストリームエラーを正常に終了させる方法を学びました。実際のローカル推論とデプロイ済み Worker による推論を確認し、ライフサイクルイベントを Dashboard の Observability に関連付け、使い捨て Worker を削除して、新しい VM からログアウトしました。