はじめに
V03 では、質問を埋め込みに変換し、近い内容のヘルプ記事を取得しました。しかし、実際のサポートシステムは通常、複数の顧客にサービスを提供します。セマンティック類似度だけで、呼び出し元がどの顧客のドキュメントを閲覧できるかを決めてはいけません。
この実験では、検索に 2 つの境界を追加します。Vectorize の namespace は 1 つのインデックス内を分割する領域です。1 つの名前空間だけを検索すると、類似度ランキングが始まる前に、他のすべての名前空間にあるベクトルが除外されます。次に、メタデータ filter を使って、category のようなフィールドでその顧客の領域をさらに絞り込みます。名前空間は適切な書類キャビネットを選び、カテゴリフィルターはその中の 1 つの引き出しを選ぶものだと考えてください。
どちらの仕組みも、ユーザー本人を認証するものではありません。アプリケーションはまずログイン、トークン、その他の本人確認情報を検証し、サーバー上で名前空間を決定する必要があります。この実験を安全かつ繰り返し実行できるように、この Worker では、すでに検証済みのセッションを表す 2 つの公開された合成セッションラベルを使用します。これらは学習用のフィクスチャであり、実際の認証情報でも、完全な認証システムでもありません。リクエストから顧客や名前空間を自由に選択することはできません。
Workers AI と Vectorize のバインディングを持つ、使い捨ての Worker を 1 つデプロイします。4 つの合成記事には、2 つの顧客名前空間で同じパスワードに関する文章が意図的に含まれています。実際の埋め込みによって現実的な検索を行い、正確な名前空間、カテゴリ、ID のチェックによって、モデルのスコアを採点しなくても分離を確認できます。また、認可された空の検索結果と、どちらのクラウドサービスも呼び出す前にスコープ上書きの試行を拒否する動作もテストします。
このコースに直接アクセスした場合は、まず LabEx を Cloudflare アカウントに接続する を完了してください。V01~V03 も前提条件です。これらの実験では、互換性のあるインデックス、非同期ミューテーション、セマンティック検索について学びます。
小さなインデックスとサイズを制限した BGE Small のリクエストは、ドキュメント化されている Workers Free の割り当てに収まります。Workers Paid は必要ありません。ただし、ローカル実行でもデプロイ済みのモデル呼び出しでも、アカウントで共有される Workers AI の 1 日あたりの割り当てを消費します。割り当てを利用できない場合は、何度も再試行せずに停止してください。
セットアップでは、Node.js 22.22.0 とプロジェクトローカルの Wrangler 4.132.0 を /home/labex/project/scoped-vector-search にインストールします。決定的なテストと、独立した読み取り専用チェックを提供します。ただし、Wrangler の認可、インデックスの作成、Worker のデプロイ、推論の実行、クラウドデータの投入は行いません。
スコープ検索のリソースを認可して名前を付ける
このステップでは、新しい VM を認可し、1 つの Worker と、それに対応する Vectorize インデックスを通常の Wrangler 設定で定義します。
用意されたプロジェクトに移動し、固定された CLI のバージョンを確認します。
cd /home/labex/project/scoped-vector-search
npx wrangler --version
4.132.0 と表示されることを確認します。デバイス認証を使うと、Cloudflare のパスワードを VM に渡さずに、一時的な OAuth 権限を VM に付与できます。要求するスコープには、アカウント情報の確認、使い捨てインデックス、Worker のデプロイ、埋め込みに使用する Workers AI バインディングが含まれます。
npx wrangler login --device --browser=false --scopes account:read user:read workers:write workers_scripts:write workers_kv:write ai:write
npx wrangler whoami --json
表示されたリンクをブラウザーで開き、現在のコードを入力して、学習用の対象アカウントを承認します。ターミナルに戻り、loggedIn: true、authType: OAuth Token、アカウント名が表示されることを確認してから、アカウント ID をコピーします。
ランダムなサフィックスを 1 つ生成し、その Worker 名からインデックス名を作成します。この命名方法により、後で正確にクリーンアップできます。
RUN="labex-c08-v04-$(openssl rand -hex 6)"
INDEX="$RUN-docs"
printf 'Worker: %s\nIndex:  %s\n' "$RUN" "$INDEX"
YOUR_ACCOUNT_ID を、whoami で表示された ID に置き換えます。binding は、Worker のコードから Cloudflare サービスを参照するローカル名です。AI は埋め込みを作成し、DOCUMENTS は index_name で指定した正確なインデックスを検索します。
cat > wrangler.jsonc <<JSON
{
  "\$schema": "./node_modules/wrangler/config-schema.json",
  "name": "$RUN",
  "account_id": "YOUR_ACCOUNT_ID",
  "main": "src/index.js",
  "compatibility_date": "2026-09-16",
  "compatibility_flags": ["nodejs_compat"],
  "workers_dev": true,
  "preview_urls": false,
  "observability": { "enabled": true },
  "ai": { "binding": "AI", "remote": true },
  "vectorize": [
    { "binding": "DOCUMENTS", "index_name": "$INDEX", "remote": true }
  ]
}
JSON
このファイルは使用するリソース名を定義するだけで、まだ何も作成しません。共有の学習用アカウントで書き込み操作を行う前に、対象と所有関係を明示しておくことが特に重要です。
サーバーでスコープを管理する検索 Worker を構築する
このステップでは、デプロイ前に境界を実装します。
x-lab-session ヘッダーでは、以前の認証レイヤーの結果をシミュレートするために、2 つの公開ラベルだけを使用します。resolveSession は、検証済みのコンテキストをサーバー上の名前空間に対応付けます。リクエスト本文では検索クエリと許可されたカテゴリを指定できますが、顧客や名前空間を指定することはできません。本番アプリケーションでは、これらのラベルを、適切に検証したセッションまたは ID プロバイダーに置き換えてください。名前空間はデータ整理の仕組みであり、認証ではありません。
4 つのドキュメントには、blue 顧客と green 顧客の両方に同じパスワードに関する文章が含まれています。このため、セキュリティ上の結果を簡単に確認できます。類似度だけでは複製された文章を区別できないため、顧客ごとに管理されたスコープだけが分離を維持できます。
cat > src/index.js <<'JS'
const MODEL = "@cf/baai/bge-small-en-v1.5";
const POOLING = "cls";
const DIMENSIONS = 384;
const ALLOWED_CATEGORIES = new Set(["account", "billing", "files"]);
const SESSION_CONTEXTS = Object.freeze({
  "blue-session": Object.freeze({ customer: "blue", namespace: "customer-blue" }),
  "green-session": Object.freeze({ customer: "green", namespace: "customer-green" })
});

const DOCUMENTS = [
  {
    id: "blue-password",
    namespace: "customer-blue",
    category: "account",
    title: "Reset a password",
    text: "Reset an expired or forgotten password to regain access to your account."
  },
  {
    id: "blue-invoice",
    namespace: "customer-blue",
    category: "billing",
    title: "Download an invoice",
    text: "Download an invoice or receipt for a completed payment."
  },
  {
    id: "green-password",
    namespace: "customer-green",
    category: "account",
    title: "Reset a password",
    text: "Reset an expired or forgotten password to regain access to your account."
  },
  {
    id: "green-upload",
    namespace: "customer-green",
    category: "files",
    title: "Upload a PDF",
    text: "Upload a PDF document and troubleshoot file size or format errors."
  }
];

function json(value, status = 200) {
  return Response.json(value, { status, headers: { "cache-control": "no-store" } });
}

export function resolveSession(label) {
  const context = SESSION_CONTEXTS[label];
  if (!context) throw new Error("session_invalid");
  return context;
}

export function parseSearchInput(value) {
  if (!value || typeof value !== "object" || Array.isArray(value)) throw new Error("invalid_json");
  for (const key of ["customer", "customerId", "namespace"]) {
    if (Object.prototype.hasOwnProperty.call(value, key)) throw new Error("scope_override_not_allowed");
  }
  const query = typeof value.query === "string" ? value.query.trim() : "";
  const category = typeof value.category === "string" ? value.category.trim() : "";
  if (!query || query.length > 200) throw new Error("query_required");
  if (!ALLOWED_CATEGORIES.has(category)) throw new Error("category_invalid");
  return { query, category };
}

export function validateEmbeddingBatch(result, expectedCount) {
  const vectors = result?.data;
  if (!Array.isArray(vectors) || vectors.length !== expectedCount || result?.shape?.[1] !== DIMENSIONS) {
    throw new Error("incompatible embedding batch");
  }
  for (const vector of vectors) {
    if (!Array.isArray(vector) || vector.length !== DIMENSIONS || !vector.every(Number.isFinite)) {
      throw new Error("invalid embedding vector");
    }
  }
  return vectors;
}

async function embed(env, texts) {
  const result = await env.AI.run(MODEL, { text: texts, pooling: POOLING });
  return validateEmbeddingBatch(result, texts.length);
}

async function seed(env) {
  const vectors = await embed(env, DOCUMENTS.map((document) => document.text));
  const records = DOCUMENTS.map((document, index) => ({
    id: document.id,
    namespace: document.namespace,
    values: vectors[index],
    metadata: {
      category: document.category,
      title: document.title,
      model: MODEL,
      pooling: POOLING
    }
  }));
  const mutation = await env.DOCUMENTS.upsert(records);
  console.log(JSON.stringify({ event: "scoped_documents_seeded", count: records.length, mutationId: mutation.mutationId }));
  return json({ mutationId: mutation.mutationId, count: records.length, model: MODEL, dimensions: DIMENSIONS, pooling: POOLING }, 202);
}

async function search(request, env) {
  let context;
  try {
    context = resolveSession(request.headers.get("x-lab-session") ?? "");
  } catch (error) {
    return json({ error: "session_invalid" }, 401);
  }

  let input;
  try {
    input = parseSearchInput(await request.json());
  } catch (error) {
    return json({ error: error instanceof Error ? error.message : "invalid_json" }, 400);
  }

  const [queryVector] = await embed(env, [input.query]);
  const result = await env.DOCUMENTS.query(queryVector, {
    topK: 3,
    namespace: context.namespace,
    filter: { category: input.category },
    returnMetadata: "all"
  });
  const matches = result.matches.map((match) => ({
    id: match.id,
    score: match.score,
    namespace: match.namespace,
    title: match.metadata?.title,
    category: match.metadata?.category
  }));
  console.log(JSON.stringify({
    event: "scoped_search",
    customer: context.customer,
    namespace: context.namespace,
    category: input.category,
    returnedCount: matches.length
  }));
  return json({
    customer: context.customer,
    namespace: context.namespace,
    category: input.category,
    candidateCount: result.matches.length,
    matches
  });
}

export default {
  async fetch(request, env) {
    const url = new URL(request.url);
    if (request.method === "POST" && url.pathname === "/seed") return seed(env);
    if (request.method === "POST" && url.pathname === "/search") return search(request, env);
    return json({ error: "not_found" }, 404);
  }
};
JS
決定的なテストを実行します。インメモリのバインディングを使うこのテストにより、クラウドの割り当てを消費せずに、Worker が両方の検索境界をサーバー側のコンテキストから構築していることを確認できます。
node --test test/worker.test.mjs
6 つのテストがすべて成功することを確認します。実際の設定からバインディングの型を生成し、デプロイせずにバンドルを確認します。
npx wrangler types
npx wrangler deploy --dry-run --outdir /tmp/v04-dry-run
生成されたファイルに AI: Ai と DOCUMENTS: VectorizeIndex が含まれていることを確認します。ドライランによって、ソースコードと設定を組み合わせてバンドルできることを確認できます。ただし、どちらのクラウドリソースも作成・テストしません。
フィルター可能なインデックスを作成してデプロイする
このステップでは、互換性のあるインデックスを作成し、category フィールドをフィルタリング用に準備して、その準備処理が完了した後に Worker をデプロイします。
ベクトルには、検索に使わないメタデータを保存することもできます。metadata index は、フィルターを先に適用するクエリで整理するフィールドを Vectorize に伝えます。このインデックスはドキュメントベクトルを挿入する前に存在していなければなりません。そうしないと、先に登録したレコードはそのメタデータフィルターの対象になりません。
BGE Small に一致する、384 次元・cosine メトリックのインデックスを作成します。--update-config=false を指定すると、すでに確認した明示的なバインディングを Wrangler が書き換えなくなります。
npx wrangler vectorize create "$INDEX" --dimensions=384 --metric=cosine --update-config=false
次に、文字列フィールド category の準備をキューに追加し、そのミューテーション ID を保存します。
set -o pipefail
npx wrangler vectorize create-metadata-index "$INDEX" \
  --propertyName=category \
  --type=string 2>&1 | tee .labex/category-index-output.txt
META_MUTATION=$(grep -Eo '[0-9a-fA-F]{8}-[0-9a-fA-F-]{27}' .labex/category-index-output.txt | tail -n 1)
if [ -z "$META_MUTATION" ]; then
  printf '%s\n' 'No metadata mutation ID was returned; fix the command before continuing.' >&2
else
  printf '%s\n' "$META_MUTATION" | tee .labex/category-mutation.txt
fi
受け付けられたミューテーションは、キューに追加された処理であり、完了した処理ではありません。シード処理の後にも再利用できる、読み取り専用の待機処理を 1 つ作成します。同じミューテーションとベクトル数を 3 回連続で読み取ることを条件にします。これにより、一時的に古い読み取り結果が、この実験の最終的な証拠になることを防ぎます。
cat > scripts/wait-for-vectorize.mjs <<'JS'
import { execFileSync } from "node:child_process";
import { readFileSync } from "node:fs";

const [indexName, mutationFile, expectedText] = process.argv.slice(2);
const mutationId = readFileSync(mutationFile, "utf8").trim();
const expectedCount = Number(expectedText);
if (!/^[0-9a-f-]{36}$/i.test(mutationId)) throw new Error("mutation file has no UUID");
if (!Number.isInteger(expectedCount) || expectedCount < 0) throw new Error("expected count is invalid");
const wrangler = "./node_modules/wrangler/bin/wrangler.js";
let consecutiveMatches = 0;

for (let attempt = 1; attempt <= 120; attempt += 1) {
  const output = execFileSync(process.execPath, [wrangler, "vectorize", "info", indexName, "--json"], { encoding: "utf8" });
  const info = JSON.parse(output);
  if (String(info.processedUpToMutation) === mutationId && info.vectorCount === expectedCount) consecutiveMatches += 1;
  else consecutiveMatches = 0;
  if (consecutiveMatches === 3) {
    console.log("mutation " + mutationId + " is consistently readable with " + expectedCount + " vectors");
    console.log(JSON.stringify(info, null, 2));
    process.exit(0);
  }
  await new Promise((resolve) => setTimeout(resolve, 2000));
}
throw new Error("mutation " + mutationId + " was not stable within four minutes");
JS
node scripts/wait-for-vectorize.mjs "$INDEX" .labex/category-mutation.txt 0
ミューテーションの処理が完了していても、別の一覧表示が追いついていないことがあります。読み取り専用のループに回数制限を設け、古い一覧結果を見て失敗と判断するのではなく、category の行が表示されるまで待ちます。
for attempt in {1..15}; do
  METADATA_INDEXES=$(npx wrangler vectorize list-metadata-index "$INDEX" 2>&1)
  if grep -Eq 'category.*String' <<<"$METADATA_INDEXES"; then
    break
  fi
  sleep 2
done
printf '%s\n' "$METADATA_INDEXES"
grep -Eq 'category.*String' <<<"$METADATA_INDEXES" || {
  printf '%s\n' 'The category metadata index is processed but not yet visible; rerun this read-only check.' >&2
  exit 1
}
category の型が String と表示されることを確認します。最後に、DOCUMENTS バインディングがこの準備済みインデックスを指す Worker をデプロイします。
set -o pipefail
npx wrangler deploy 2>&1 | tee .labex/deploy-output.txt
DEPLOY_URL=$(sed -nE 's#.*(https://[^[:space:]]+\.workers\.dev).*#\1#p' .labex/deploy-output.txt | tail -n 1)
if [ -z "$DEPLOY_URL" ]; then
  printf '%s\n' 'No workers.dev URL was returned; fix deployment before continuing.' >&2
else
  printf '%s\n' "$DEPLOY_URL" | tee .labex/deploy-url.txt
fi
インデックスはまだ空です。デプロイによってバインディングは接続されますが、ドキュメントの埋め込みが自動的に作成されるわけではありません。
2 つの顧客名前空間にデータを投入する
このステップでは、実際の埋め込みを作成し、各レコードを 1 つの顧客名前空間とカテゴリメタデータに対応付けて保存します。
名前空間はベクトルレコード自体に属します。2 つのパスワードレコードには意図的に同じ文章を設定していますが、別々のパーティションに保存されます。category は別のメタデータなので、1 つのレコードを blue 名前空間の account カテゴリに同時に所属させることができます。
固定されたシードエンドポイントを 1 回呼び出します。コーパスはサーバー側で管理されているため、リクエスト本文は空です。
DEPLOY_URL=$(cat .labex/deploy-url.txt)
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/seed" \
  -H 'content-type: application/json' \
  --data '{}' | tee .labex/seed-response.json
node -e '
  const value = JSON.parse(require("fs").readFileSync(".labex/seed-response.json", "utf8"));
  if (!/^[0-9a-f-]{36}$/i.test(value.mutationId)) throw new Error("seed mutation is missing");
  require("fs").writeFileSync(".labex/seed-mutation.txt", value.mutationId + "\n");
  console.log("accepted " + value.count + " scoped vectors in mutation " + value.mutationId);
'
count: 4、384 次元、cls プーリング、ミューテーション UUID が返ることを確認します。サービスが何秒かかるかを推測せず、対象のミューテーションと件数が処理されるまで待ちます。
node scripts/wait-for-vectorize.mjs "$INDEX" .labex/seed-mutation.txt 4
for attempt in {1..15}; do
  VECTOR_LIST=$(npx wrangler vectorize list-vectors "$INDEX" --count=10 2>&1)
  if grep -q 'blue-password' <<<"$VECTOR_LIST" &&
     grep -q 'blue-invoice' <<<"$VECTOR_LIST" &&
     grep -q 'green-password' <<<"$VECTOR_LIST" &&
     grep -q 'green-upload' <<<"$VECTOR_LIST"; then
    break
  fi
  sleep 2
done
printf '%s\n' "$VECTOR_LIST"
for id in blue-password blue-invoice green-password green-upload; do
  grep -q "$id" <<<"$VECTOR_LIST" || {
    printf 'The processed vector %s is not visible in the list yet; rerun this read-only check.\n' "$id" >&2
    exit 1
  }
done
一覧に blue-password、blue-invoice、green-password、green-upload が含まれていることを確認します。ID によって検索結果を元のドキュメントに対応付けられます。名前空間とカテゴリによって、類似しているレコードがクエリの対象になるかどうかが決まります。
顧客とカテゴリの分離を証明する
このステップでは、2 人の顧客として同じセマンティックな質問を実行し、認可された空の結果と安全でない上書きをテストします。
まず、blue の合成セッションで account カテゴリを検索します。
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/search" \
  -H 'content-type: application/json' \
  -H 'x-lab-session: blue-session' \
  --data '{"query":"My password expired","category":"account"}' \
  | tee .labex/blue-account.json
レスポンスに customer: blue、namespace: customer-blue が含まれ、blue-password だけが返ることを確認します。次に、green セッションで同じ質問を送信します。
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/search" \
  -H 'content-type: application/json' \
  -H 'x-lab-session: green-session' \
  --data '{"query":"My password expired","category":"account"}' \
  | tee .labex/green-account.json
今度は green-password だけが対象になります。ドキュメントの文章は同一なので、この違いは埋め込みモデルや偶然のスコアによるものではなく、検証済みセッションが選択した名前空間によるものです。
次に、blue セッションで files カテゴリを検索します。非常に関連性の高い green のアップロード記事は存在しますが、blue 名前空間にはファイルの記事がありません。
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/search" \
  -H 'content-type: application/json' \
  -H 'x-lab-session: blue-session' \
  --data '{"query":"Upload a PDF","category":"files"}' \
  | tee .labex/blue-files-empty.json
candidateCount: 0 と matches: [] が返ることを確認します。空の結果が、認可された正しい回答です。別の名前空間から関連レコードを借りて返すと、データ漏えいになります。
最後に、リクエスト本文から名前空間を上書きしてみます。
curl --silent --show-error \
  -o .labex/override-response.json \
  -w 'HTTP %{http_code}\n' \
  -X POST "$DEPLOY_URL/search" \
  -H 'content-type: application/json' \
  -H 'x-lab-session: blue-session' \
  --data '{"query":"Upload a PDF","category":"files","namespace":"customer-green"}'
cat .labex/override-response.json
HTTP 400 と scope_override_not_allowed が返ることを確認します。Worker は、埋め込み作成や Vectorize クエリを実行する前に、このフィールドを拒否します。クライアントは許可されたカテゴリを要求できますが、ID と顧客名前空間の対応付けを行えるのは、信頼されたサーバーロジックだけです。
Workers & Pages → 対象の labex-c08-v04-... Worker → Bindings を開きます。AI が Workers AI を指し、DOCUMENTS が使い捨ての正確な Vectorize インデックスを指していることを確認します。この対応関係により、コード内の env.AI と env.DOCUMENTS が管理対象サービスに接続される仕組みを視覚的に確認できます。独立したチェックでは、正確なバインディング ID も確認できます。
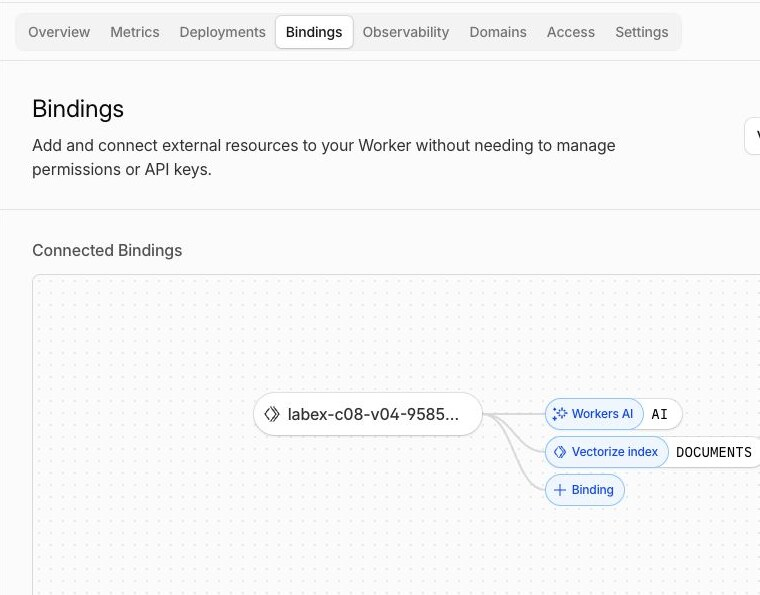
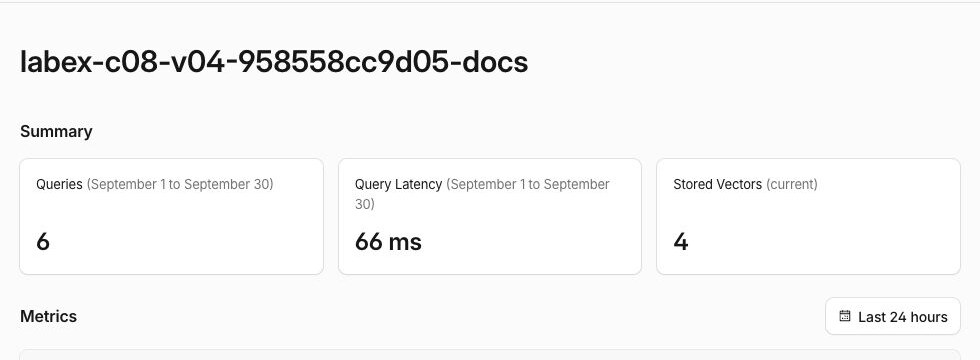
次に、AI → Vectorize → 対応する -docs インデックスを開きます。現在のベクトル数は最終的に 4 になり、クエリメトリクスにはスコープ付き検索が反映され始めます。ダッシュボードのカウンターは遅れて更新されることがあります。正確な ID、名前空間、カテゴリについては、認証済みのレコード読み取りと HTTP レスポンスを信頼してください。
Workers Logs を利用できる場合は、Worker の Observability → Logs ビューを開き、scoped_search エントリを確認します。このエントリに記録されるのは、合成された顧客ラベル、名前空間、カテゴリ、返却件数だけです。質問文やセッションラベルは記録されません。プライバシーに配慮して構造化されたログにより、機密性のあるリクエスト内容をコピーせずに、どのサーバー選択スコープが実行されたかを診断できます。
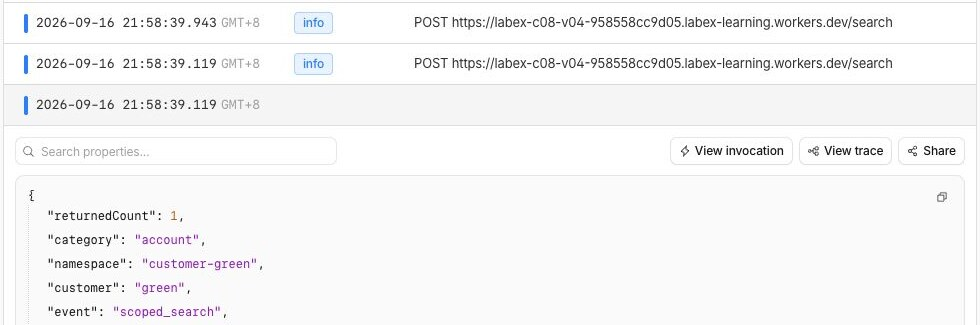
これらのスクリーンショットは、1 回の使い捨てテスト実行を示す例です。ランダムに生成されたリソース名、タイムスタンプ、レイテンシ、クエリ総数は異なります。例の値をそのままコピーするのではなく、バインディング名、現在のベクトル数、フィールド間の関係を比較してください。
スコープ検索のリソースを削除する
このステップでは、使い捨ての Worker とインデックスを削除し、Wrangler の認可が有効なうちに、それらが存在しないことを確認します。
以前のターミナルセッションの変数に依存しないように、wrangler.jsonc から正確な名前を取得します。
RUN=$(node -p 'JSON.parse(require("fs").readFileSync("wrangler.jsonc", "utf8")).name')
INDEX=$(node -p 'JSON.parse(require("fs").readFileSync("wrangler.jsonc", "utf8")).vectorize.find((item) => item.binding === "DOCUMENTS").index_name')
printf 'Worker: %s\nIndex: %s\n' "$RUN" "$INDEX"
両方の値が、一意の labex-c08-v04-... プレフィックスで始まっていることを確認します。まず Worker を削除して、デプロイ済みのコードがバインディングを保持しないようにします。その後、対応するインデックスだけを削除します。
npx wrangler delete --name "$RUN" --force
npx wrangler vectorize delete "$INDEX" --force
認証済みの一覧を保存し、正確な名前のインデックスが存在しないことを確認します。
npx wrangler vectorize list --json > .labex/indexes-after-cleanup.json
node -e '
  const rows = JSON.parse(require("fs").readFileSync(process.argv[1], "utf8"));
  if (rows.some((row) => row.name === process.argv[2])) throw new Error("lab index still exists");
  console.log("lab index is absent");
' .labex/indexes-after-cleanup.json "$INDEX"
ログアウトする前にこのステップを完了してください。ネットワーク障害や認可エラーでは、削除できたかどうかを判断できません。評価では、アカウントの読み取りが成功することと、正確な名前のリソースが存在しないことを別途確認します。
学習用 VM からログアウトする
このステップでは、この VM に付与した一時的な Wrangler の認可を削除します。クラウドリソースはすでに存在せず、認証済みのクリーンアップチェックも成功しています。
npx wrangler logout
npx wrangler whoami --json
loggedIn: false と表示されることを確認します。Cloudflare Dashboard のブラウザーセッションは別のものであり、学習用アカウントでは引き続き利用できます。
まとめ
セマンティック検索に、独立した 2 つの適格性チェックを追加しました。検証済みの合成セッションによってサーバー上で顧客名前空間を選択し、インデックス化した category フィールドによって、Vectorize が結果をランキングする前にその領域を絞り込みました。同じパスワードのドキュメントにより、類似度だけでは顧客分離を実現できないことを確認しました。また、blue セッションでの files 検索により、別の顧客から関連レコードを借りるよりも、認可された空の結果を返す方が安全であることも確認しました。
さらに、推論や Vectorize クエリを実行する前に、クライアントから送られた顧客と名前空間の上書きを拒否しました。Dashboard で実際のバインディング、インデックス、プライバシーに配慮したログの関係を確認し、認可された状態で使い捨ての Worker とインデックスを削除してからログアウトしました。V05 では、この安全な検索境界を再利用し、言語モデルが回答する前に、範囲を限定したソース証拠を組み立てます。