はじめに
V01 では識別可能なベクトルを保存し、V02 ではそれらのレコードを最新の状態に保ちました。この実験では、残っていた読み取り処理を追加します。ユーザーが質問を入力すると、アプリケーションはそのテキストを互換性のあるベクトルに変換し、保存済みのドキュメントのうち最も近い方向を指すものを Vectorize に問い合わせます。
これがセマンティック検索です。クエリに記事とまったく同じ単語を含める必要はなく、意味を表す埋め込みを比較します。クエリと保存済みドキュメントには、同じモデル、384 次元、cls プーリングを使用する必要があります。Vectorize の類似度スコアは、1 つのクエリに対して互換性のあるベクトルを順位付けするための値です。普遍的な信頼度の割合でも、記事が質問に答えていることの証明でもありません。
この実験では、2 つの Cloudflare バインディングを持つ使い捨ての Worker を 1 つ構築します。AI は、Cloudflare がホストする @cf/baai/bge-small-en-v1.5 埋め込みモデルに短いテキストを送信します。DOCUMENTS は、1 つの使い捨て Vectorize インデックスへの書き込みとクエリを行います。Worker には、合成ヘルプ記事 3 件を登録する固定の /seed 操作と、クエリ、topK、任意の最小スコアを受け取る /search 操作を実装します。topK は「最も近い候補を最大でこの数だけ返す」という意味であり、「返された候補が確実に関連している」という意味ではありません。
これは 3 つ目の Vectorize 実験です。直接この実験を開始した場合は、まず LabEx を Cloudflare アカウントに接続する を完了し、その後 V01 と V02 を完了してください。これにより、インデックスの互換性、安定した ID、非同期ミューテーションに慣れることができます。
Vectorize と Workers AI には、どちらも Free の割り当てがあります。この実験では小さなベクトルを 3 件保存し、短い埋め込みリクエストを数回だけ実行します。Workers Paid は必要ありません。ローカル実行でもデプロイ後の推論でも、共有されている Workers AI の 1 日あたりの上限を消費します。モデルまたは Free の割り当てが利用できない場合は、繰り返し再試行せずに停止してください。
セットアップでは、Node.js 22.22.0 とプロジェクト専用の Wrangler 4.132.0 を /home/labex/project/vector-search にインストールします。決定論的なテストと独立したチェックを用意しますが、Wrangler の認証、モデルの呼び出し、インデックスの作成、Worker のデプロイ、クラウドデータのシード登録は行いません。
検索リソースを認証して名前を付ける
このステップでは、新しい VM を認証し、Worker と対応する Vectorize インデックスの名前を指定する設定を 1 つ作成します。
準備済みのプロジェクトに移動し、固定された CLI のバージョンを確認します。
cd /home/labex/project/vector-search
npx wrangler --version
4.132.0 と表示されることを確認します。Wrangler はデバイスフローを使用するため、パスワードが VM に入力されることはありません。この使い捨ての実習に必要なアカウント情報、Worker、Vectorize、Workers AI へのアクセスを要求します。
Wrangler では、インデックス操作とスクリプトのデプロイおよび削除チェックを分けて扱います。Vectorize 用に workers:write、Worker 用に workers_scripts:write、Wrangler の依存関係を考慮した削除チェック用に workers_kv:write、モデルバインディング用に ai:write を要求します。
npx wrangler login --device --browser=false --scopes account:read user:read workers:write workers_scripts:write workers_kv:write ai:write
npx wrangler whoami --json
loggedIn: true と、学習に使用するアカウントが表示されることを確認します。ランダムなサフィックスを 1 つ生成し、それを使って両方のリソース名を作成します。これにより、削除時に無関係なリソースと取り違えることを防げます。
RUN="labex-c08-v03-$(openssl rand -hex 6)"
INDEX="$RUN-docs"
printf 'Worker: %s\nIndex:  %s\n' "$RUN" "$INDEX"
YOUR_ACCOUNT_ID を、選択したアカウントの実際の ID に置き換えます。バインディングとは、Worker のコードが管理対象の Cloudflare サービスを受け取るために使用する名前です。AI はモデル推論を提供し、DOCUMENTS は index_name で指定した正確な Vectorize インデックスを提供します。
cat > wrangler.jsonc <<JSON
{
  "\$schema": "./node_modules/wrangler/config-schema.json",
  "name": "$RUN",
  "account_id": "YOUR_ACCOUNT_ID",
  "main": "src/index.js",
  "compatibility_date": "2026-09-16",
  "workers_dev": true,
  "preview_urls": false,
  "observability": { "enabled": true },
  "ai": { "binding": "AI", "remote": true },
  "vectorize": [
    { "binding": "DOCUMENTS", "index_name": "$INDEX", "remote": true }
  ]
}
JSON
この設定はリソース名を指定するだけで、リソース自体は作成しません。この分離により、アカウントに変更を加える前に、想定している所有範囲を確認できます。
バインディングを使う検索 Worker を構築する
このステップでは、コードをデプロイする前に、固定ドキュメントのシード処理と、学習者が使う検索エンドポイントを実装します。
3 件のソースドキュメントは、アプリケーションコード内に保持します。Vectorize が保存するのはベクトルとメタデータであり、記事システム全体の正本ではないためです。/seed はこの固定コーパスを 1 回埋め込みます。/search は検証済みのクエリを 1 件埋め込み、最も近い topK 件の候補を Vectorize に問い合わせた後、minScore を適用します。返されたメタデータを使うことで、アプリケーションはベクトル ID を実用的な参照情報に戻せます。
cat > src/index.js <<'JS'
const MODEL = "@cf/baai/bge-small-en-v1.5";
const POOLING = "cls";
const DIMENSIONS = 384;

const DOCUMENTS = [
  {
    id: "password-reset",
    category: "account",
    title: "Reset an expired password",
    text: "Reset an expired or forgotten password to regain access to your account."
  },
  {
    id: "upload-pdf",
    category: "files",
    title: "Upload a PDF",
    text: "Upload a PDF document and troubleshoot file size or format errors."
  },
  {
    id: "billing-receipt",
    category: "billing",
    title: "Download a billing receipt",
    text: "Download a receipt for a completed invoice or payment."
  }
];

function json(value, status = 200) {
  return Response.json(value, { status, headers: { "cache-control": "no-store" } });
}

export function validateEmbeddingBatch(result, expectedCount) {
  const vectors = result?.data;
  if (!Array.isArray(vectors) || vectors.length !== expectedCount || result?.shape?.[1] !== DIMENSIONS) {
    throw new Error("incompatible embedding batch");
  }
  for (const vector of vectors) {
    if (!Array.isArray(vector) || vector.length !== DIMENSIONS || !vector.every(Number.isFinite)) {
      throw new Error("invalid embedding vector");
    }
  }
  return vectors;
}

export function parseSearchInput(value) {
  const query = typeof value?.query === "string" ? value.query.trim() : "";
  const topK = value?.topK === undefined ? 3 : value.topK;
  const minScore = value?.minScore === undefined ? 0 : value.minScore;
  if (!query || query.length > 200) throw new Error("query_required");
  if (!Number.isInteger(topK) || topK < 1 || topK > 3) throw new Error("topk_invalid");
  if (typeof minScore !== "number" || !Number.isFinite(minScore) || minScore < 0 || minScore > 1) throw new Error("minscore_invalid");
  return { query, topK, minScore };
}

async function embed(env, texts) {
  const result = await env.AI.run(MODEL, { text: texts, pooling: POOLING });
  return validateEmbeddingBatch(result, texts.length);
}

async function seed(env) {
  const vectors = await embed(env, DOCUMENTS.map((document) => document.text));
  const records = DOCUMENTS.map((document, index) => ({
    id: document.id,
    values: vectors[index],
    metadata: {
      category: document.category,
      published: true,
      title: document.title,
      model: MODEL,
      pooling: POOLING
    }
  }));
  const mutation = await env.DOCUMENTS.upsert(records);
  console.log(JSON.stringify({ event: "documents_seeded", count: records.length, mutationId: mutation.mutationId }));
  return json({ mutationId: mutation.mutationId, count: records.length, model: MODEL, dimensions: DIMENSIONS, pooling: POOLING }, 202);
}

async function search(request, env) {
  let input;
  try {
    input = parseSearchInput(await request.json());
  } catch (error) {
    return json({ error: error instanceof Error ? error.message : "invalid_json" }, 400);
  }
  const [queryVector] = await embed(env, [input.query]);
  const result = await env.DOCUMENTS.query(queryVector, { topK: input.topK, returnMetadata: "all" });
  const matches = result.matches
    .filter((match) => Number.isFinite(match.score) && match.score >= input.minScore)
    .map((match) => ({
      id: match.id,
      score: match.score,
      title: match.metadata?.title,
      category: match.metadata?.category
    }));
  console.log(JSON.stringify({ event: "documents_retrieved", candidateCount: result.matches.length, returnedCount: matches.length, topK: input.topK }));
  return json({ model: MODEL, dimensions: DIMENSIONS, pooling: POOLING, candidateCount: result.matches.length, matches });
}

export default {
  async fetch(request, env) {
    const url = new URL(request.url);
    if (request.method === "POST" && url.pathname === "/seed") return seed(env);
    if (request.method === "POST" && url.pathname === "/search") return search(request, env);
    return json({ error: "not_found" }, 404);
  }
};
JS
決定論的なテストを実行します。両方のバインディングを小さなインメモリのフィクスチャに置き換えるため、AI や Vectorize のクォータを消費せずに、検証と制御フローを確認できます。
node --test test/worker.test.mjs
5 件のテストがすべて成功することを確認します。次に、バインディングの型を生成し、Worker をデプロイせずに Wrangler でバンドルできることを確認します。
npx wrangler types
npx wrangler deploy --dry-run --outdir /tmp/v03-dry-run
生成された型ファイルに AI: Ai と DOCUMENTS: VectorizeIndex の両方が含まれていることを確認します。ドライランによって、モジュールと設定をまとめてバンドルできることは確認できますが、クラウドサービスが存在することまでは確認できません。
インデックスを作成して両方のバインディングをデプロイする
このステップでは、互換性のある空のインデックスを作成し、その後、両方の管理対象バインディングを受け取る Worker をデプロイします。
埋め込みモデルは 384 個の数値を返します。コサイン距離はベクトルの方向を比較するため、同じ不変の契約を持つインデックスを 1 つ作成します。
npx wrangler vectorize create "$INDEX" --dimensions=384 --metric=cosine --update-config=false
Cloudflare が設定済みの DOCUMENTS バインディングを実際のリソースに解決できるように、インデックスの作成後に Worker をデプロイします。
set -o pipefail
npx wrangler deploy 2>&1 | tee .labex/deploy-output.txt
Wrangler に両方のバインディングが一覧表示され、workers.dev URL が出力されることを確認します。サブドメインを推測して組み立てるのではなく、出力された URL を正確に保存します。
DEPLOY_URL=$(sed -nE 's#.*(https://[^[:space:]]+\.workers\.dev).*#\1#p' .labex/deploy-output.txt | tail -n 1)
if [ -z "$DEPLOY_URL" ]; then
  printf '%s\n' 'No workers.dev URL was returned; fix the deployment before continuing.' >&2
else
  printf '%s\n' "$DEPLOY_URL" | tee .labex/deploy-url.txt
fi
この時点では、インデックスは意図的に空です。デプロイによってサービスは接続されますが、ドキュメントの埋め込みやシード登録が自動的に行われるわけではありません。
ドキュメントの埋め込みをライブ環境に登録する
このステップでは、固定の /seed 操作を 1 回呼び出し、ミューテーションを記録して、3 件すべてのモデル埋め込みを読み取れるようになるまで待ちます。
Worker は 3 件の短いドキュメントテキストを、1 回のバッチで BGE Small に送信します。返された形状を検証し、安定した ID と有用なメタデータを付加して、レコードをアップサートします。コーパスはサーバー側で管理されているため、空の JSON オブジェクトを指定して呼び出します。
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/seed" \
  -H 'content-type: application/json' \
  --data '{}' | tee .labex/seed-response.json
count: 3、384 次元、cls プーリング、ミューテーション UUID を含む HTTP 202 のデータが返ることを確認します。受け付けられたミューテーションは非同期で処理されるため、以前の実験と同じ上限付きの安定性チェックを作成します。execFileSync は固定された Wrangler プロセスを実行し、readFileSync は保存したシードレスポンスを読み取ります。これらは Node.js の別々の組み込みモジュールから提供されます。
cat > scripts/wait-for-vectorize.mjs <<'JS'
import { execFileSync } from "node:child_process";
import { readFileSync } from "node:fs";

const indexName = process.argv[2];
const seed = JSON.parse(readFileSync(".labex/seed-response.json", "utf8"));
const mutationId = seed.mutationId;
if (!/^[0-9a-f-]{36}$/i.test(mutationId)) throw new Error("seed response has no mutation ID");
const wrangler = "./node_modules/wrangler/bin/wrangler.js";
let consecutiveMatches = 0;

for (let attempt = 1; attempt <= 120; attempt += 1) {
  const output = execFileSync(process.execPath, [wrangler, "vectorize", "info", indexName, "--json"], { encoding: "utf8" });
  const info = JSON.parse(output);
  if (info.processedUpToMutation === mutationId && info.vectorCount === 3) consecutiveMatches += 1;
  else consecutiveMatches = 0;
  if (consecutiveMatches === 3) {
    console.log(`mutation ${mutationId} is consistently readable with three vectors`);
    console.log(JSON.stringify(info, null, 2));
    process.exit(0);
  }
  await new Promise((resolve) => setTimeout(resolve, 2000));
}
throw new Error(`mutation ${mutationId} was not readable within four minutes`);
JS
node scripts/wait-for-vectorize.mjs "$INDEX"
3 回連続で一致する読み取りを行うことで、短時間だけ古いレプリカが表示される問題から、確認結果を保護します。待機処理が成功したら、安定したアプリケーション ID を一覧表示します。
npx wrangler vectorize list-vectors "$INDEX" --count=10
インベントリに password-reset、upload-pdf、billing-receipt が含まれていることを確認します。実際の値は、V01 と V02 で使用した決定論的な学習用ベクトルではなく、Cloudflare がホストするライブモデルから生成されています。
類似記事を取得して解釈する
このステップでは、パスワードに関する関連性の高い質問を 1 つ送信し、最も近い候補 2 件を確認して、順位付けと明示的な空の結果を区別します。
topK: 2 を指定します。Vectorize は小さなインデックス全体を調べる場合がありますが、最も近い候補を最大 2 件まで返します。クエリと記事は使われている正確な表現が異なっていても意味が強く一致するため、最初の結果はパスワード記事になるはずです。
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/search" \
  -H 'content-type: application/json' \
  --data '{"query":"My old password expired and I cannot sign in","topK":2}' \
  | tee .labex/password-search.json
node -e '
  const value = JSON.parse(require("fs").readFileSync(process.argv[1], "utf8"));
  console.table(value.matches);
' .labex/password-search.json
スコアの降順で 2 行が表示され、最初に password-reset が表示されることを確認します。スコアは相対的に比較してください。互換性のあるこのクエリとインデックスでは、値が大きいほど近いことを示しますが、0.8 は「80% 正解」という意味ではありません。topK も関連性のしきい値を適用するものではありません。
次に、無関係な質問を送り、minScore: 1 を設定します。Vectorize は 3 件の候補をアプリケーションに返しますが、アプリケーションはしきい値未満の候補をすべて除外します。
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/search" \
  -H 'content-type: application/json' \
  --data '{"query":"volcanic basalt crystallization","topK":3,"minScore":1}' \
  | tee .labex/empty-search.json
candidateCount: 3 と matches: [] が返ることを確認します。空のマッチリストはアプリケーションが明示的に行った判断であり、インデックスにベクトルが存在しないことを示すものではありません。
最後に、空の入力を送信します。
curl --silent --show-error \
  -o .labex/empty-input.json \
  -w 'HTTP %{http_code}\n' \
  -X POST "$DEPLOY_URL/search" \
  -H 'content-type: application/json' \
  --data '{"query":""}'
cat .labex/empty-input.json
HTTP 400 と query_required が返ることを確認します。検証はモデルやデータベースへの呼び出しより前に行われるため、不正な入力で推論やクエリの容量を消費することはありません。
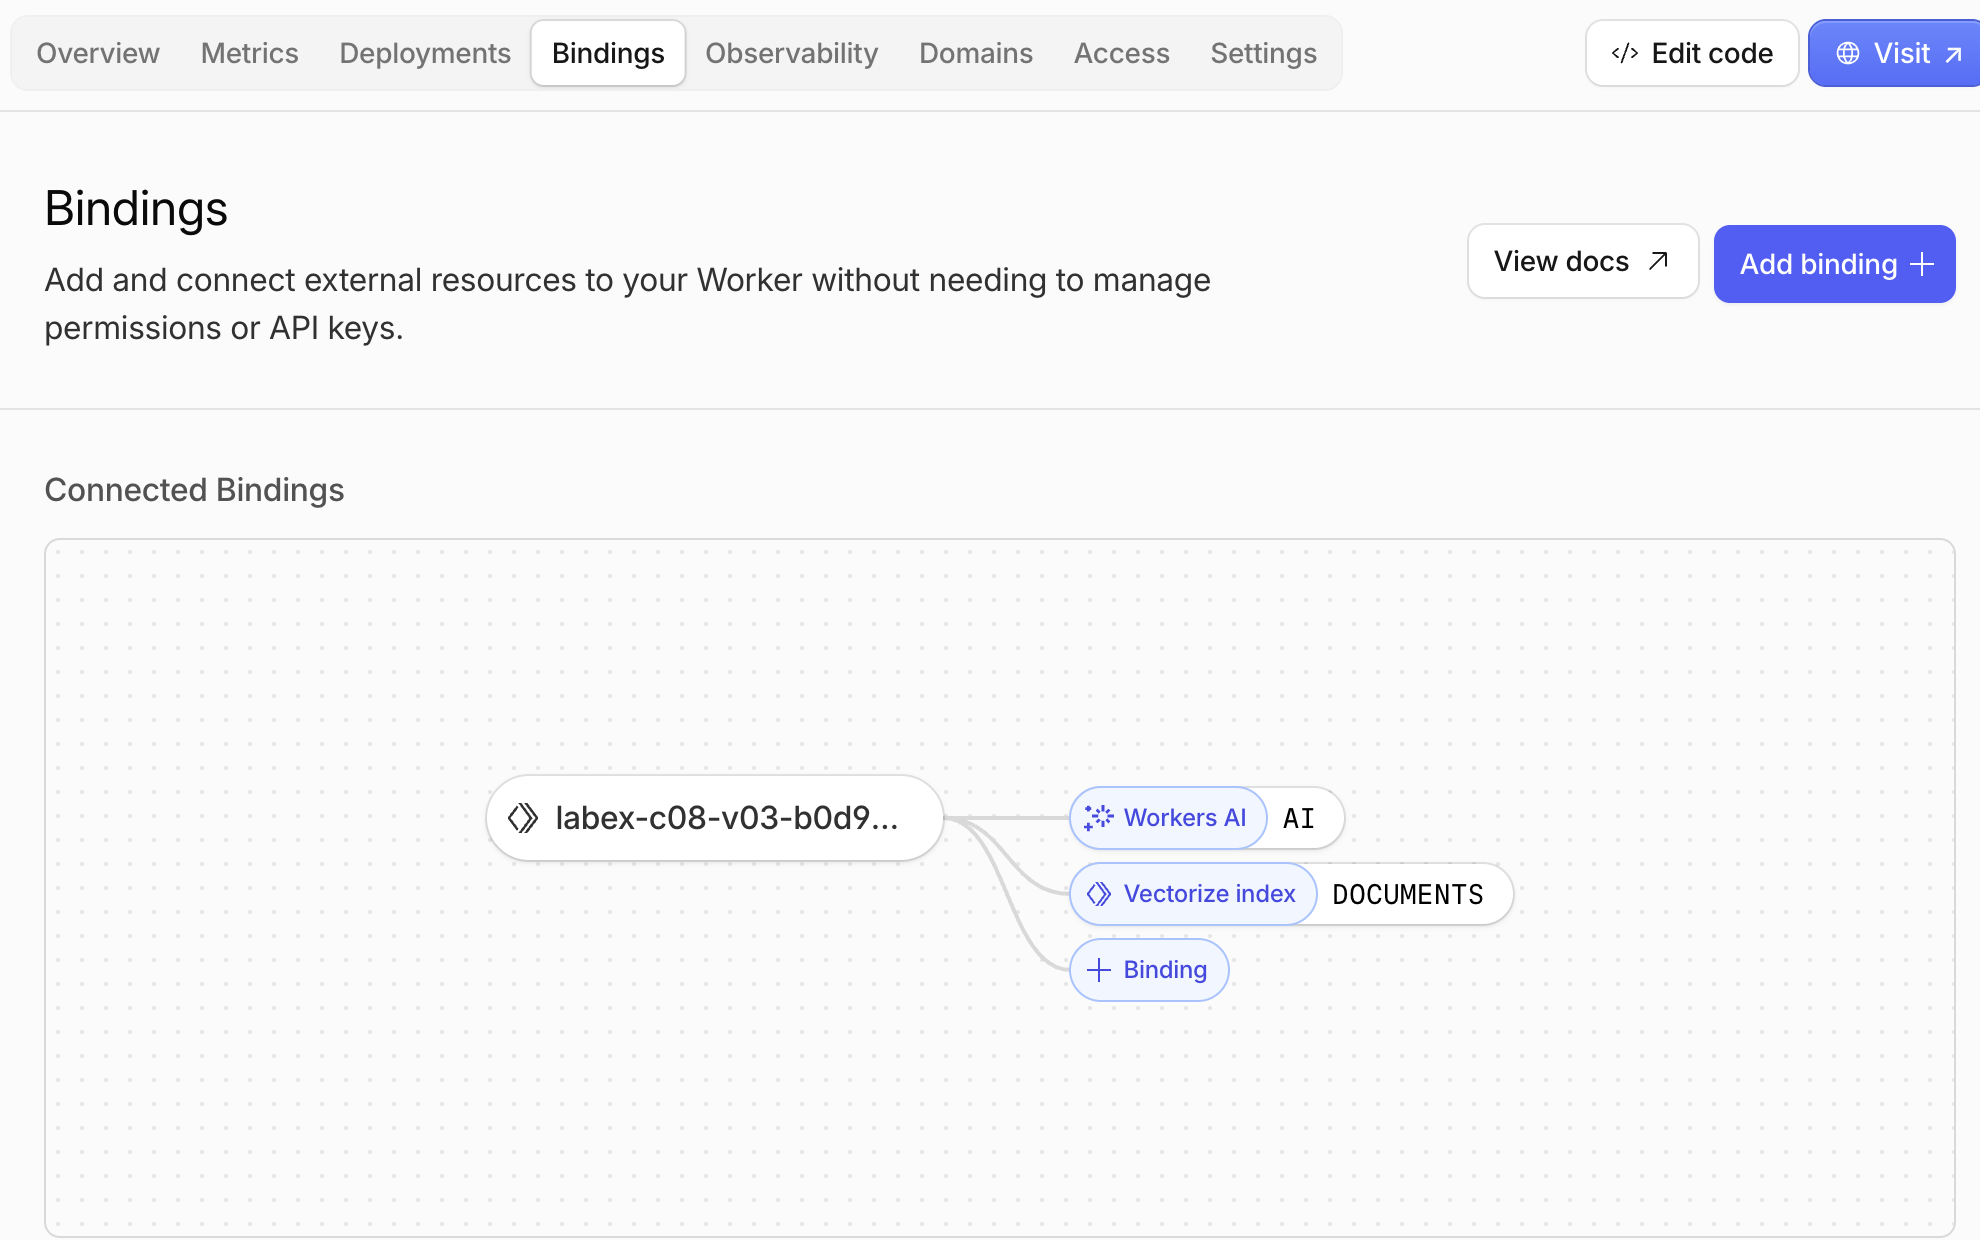
Workers & Pages → 対象の labex-c08-v03-... Worker → Bindings を開きます。バインディングによって、Worker コードは別の Cloudflare サービスを安全な名前で参照できます。ここでは、AI が env.AI から埋め込みモデルを実行するための名前であり、DOCUMENTS が env.DOCUMENTS からこの Vectorize インデックスをクエリするための名前です。
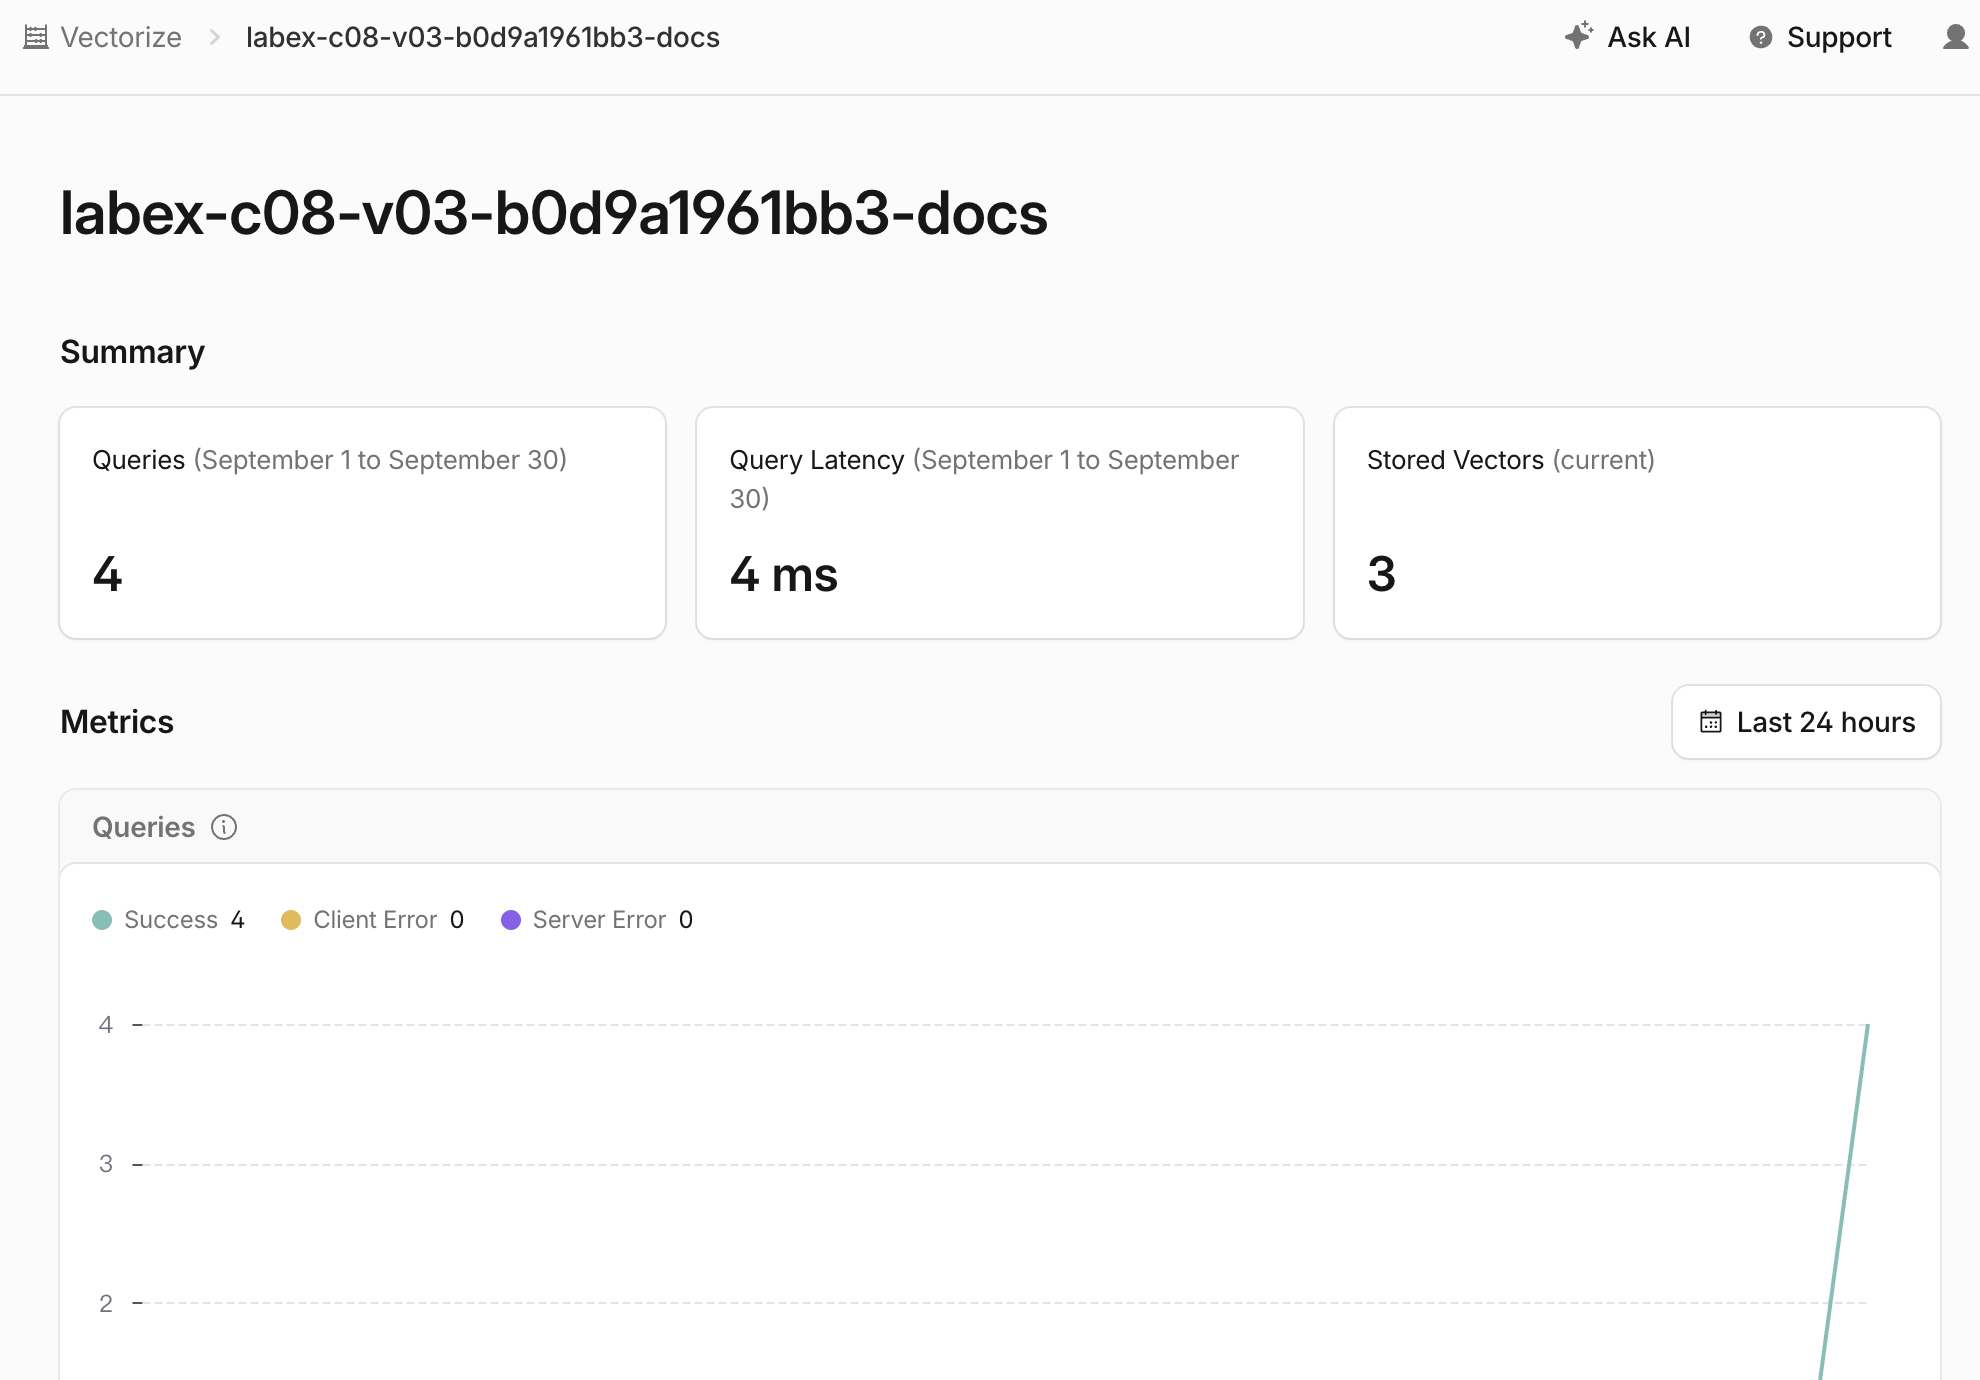
次に、AI → Vectorize → 対応する -docs インデックスを開きます。概要に、現在のベクトルが 3 件表示されることを確認します。これはシード登録した各ヘルプ記事に 1 件ずつ対応します。成功した検索のたびにクエリが追加されるため、繰り返し確認を行った場合、クエリ合計は例と異なることがあります。
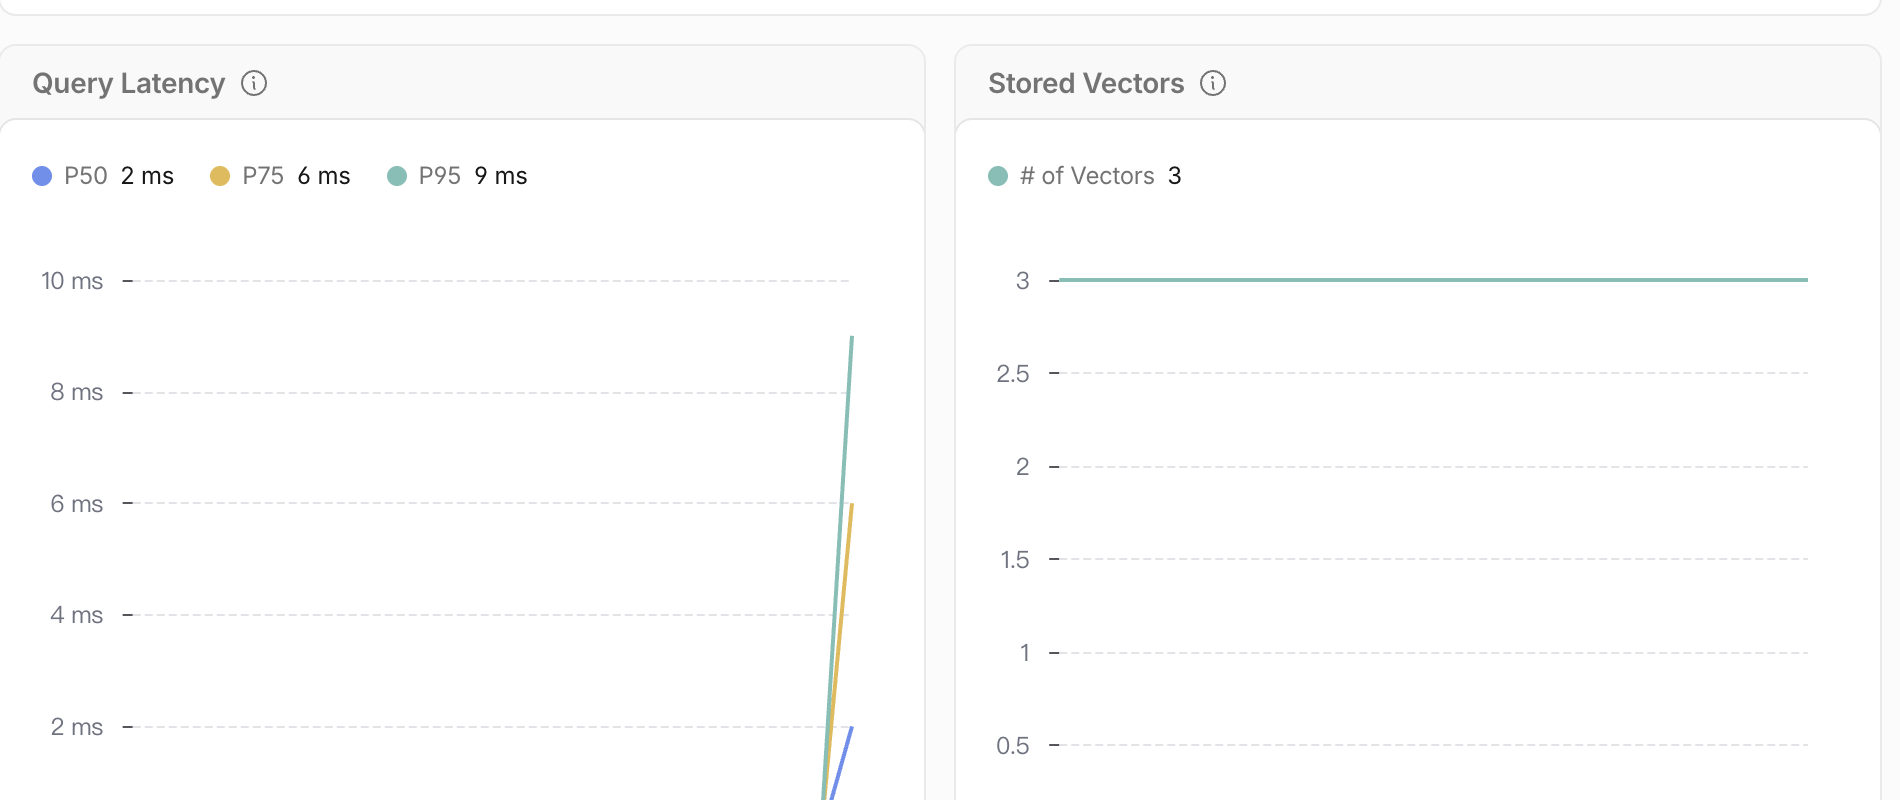
Metrics までスクロールします。P50、P75、P95 はレイテンシーのパーセンタイルです。たとえば P95 は、成功したクエリの 95% がその時間以内に完了したことを示します。これらの数値は速度を表すものであり、マッチの関連性を表すものではありません。検索するだけでドキュメントを追加・削除しない場合、Stored Vectors のグラフは 3 件のままです。
Dashboard のカウンターは、ターミナルより数秒遅れて更新されることがあります。API のレスポンス、返された ID、独立したチェックを正式な結果として扱ってください。Dashboard は、これらの結果を、実際に確認・操作できるリソースと結び付けるために使用します。
検索 Worker とインデックスを削除する
このステップでは、2 つの使い捨てクラウドリソースを削除し、Wrangler の認証が有効な間に、それらが存在しないことを確認します。ログアウトは最後に別のステップとして行います。削除チェックには Cloudflare への読み取りアクセスが必要なためです。
まず、wrangler.jsonc から正確な名前を取得します。新しいターミナルを開いて、以前の RUN と INDEX の変数が失われていても、安全に削除できます。
RUN=$(node -p 'JSON.parse(require("fs").readFileSync("wrangler.jsonc", "utf8")).name')
INDEX=$(node -p 'JSON.parse(require("fs").readFileSync("wrangler.jsonc", "utf8")).vectorize.find((item) => item.binding === "DOCUMENTS").index_name')
printf 'Worker: %s\nIndex: %s\n' "$RUN" "$INDEX"
削除する前に、両方の値が一意の labex-c08-v03-... プレフィックスで始まっていることを確認します。
まず Worker を削除します。これにより、デプロイ済みコードがインデックスへのバインディングを保持し続けることを防ぎます。
npx wrangler delete --name "$RUN" --force
対応するインデックスだけを削除し、その後、削除チェック用に認証済みのインベントリを保存します。
npx wrangler vectorize delete "$INDEX" --force
npx wrangler vectorize list --json > .labex/indexes-after-cleanup.json
node -e '
  const rows = JSON.parse(require("fs").readFileSync(process.argv[1], "utf8"));
  if (rows.some((row) => row.name === process.argv[2])) throw new Error("lab index still exists");
  console.log("lab index is absent");
' .labex/indexes-after-cleanup.json "$INDEX"
ログアウトする前に、このステップを完了してください。評価では Cloudflare に対して独立して確認を行うため、認証エラーやネットワークエラーは削除の証拠として認められません。
学習用 VM からログアウトする
このステップでは、この VM に一時的に付与された Wrangler の認証を削除します。クラウドリソースはすでに削除され、認証済みの削除チェックも成功しています。これで安全にログアウトできます。
npx wrangler logout
npx wrangler whoami --json
loggedIn: false と表示されることを確認します。Cloudflare Dashboard のブラウザーセッションは別のものであり、学習用アカウントでは引き続き利用できます。
まとめ
保存済みドキュメントの埋め込みとライブクエリの埋め込みに同じモデル契約を使用する Worker を構築しました。3 件の安定した ID を Vectorize にシード登録し、実際の非同期ミューテーションが読み取り可能になるまで待ちました。また、topK で候補数を制限し、スコアを相対的な順位付けの指標として解釈し、ベクトルそのものではなくメタデータを返し、アプリケーションのしきい値処理によって明示的な空の結果を生成しました。最後に、Dashboard で両方のクラウドバインディングを確認し、認証が有効な間に使い捨ての Worker とインデックスを削除してから、VM からログアウトしました。
V04 では、サーバー側で管理する顧客名前空間とメタデータフィルターを追加します。これにより、セマンティックに類似したレコードであっても、認証済みの検索範囲に属する場合だけ返すようにできます。