はじめに
V01 では、各ヘルプ記事に対して 1 つのベクトルを保存しました。実際の記事は固定されたままではありません。手順が変更されたり、タイトルが修正されたり、古いページが廃止されたりします。検索インデックスがこのライフサイクルに追従しないと、元の Web サイトが正しくても古い回答を返す可能性があります。
Cloudflare Vectorize には、関連する 3 つの書き込み操作があります。
- insert は新しいベクトル ID を追加します。既存の ID を暗黙的に置き換えることはありません。
- upsert は「update or insert」を意味し、その ID のベクトルとメタデータを置き換えます。
- ID による削除 は、インデックス全体を再構築せずに、指定したレコードを廃止します。
この実験では、合成ドキュメントを 3 件登録し、更新版のパスワード記事を upsert し、廃止された請求記事を削除します。さらに、無関係なアップロード記事が変更されていないことを確認します。各書き込み操作は非同期の mutation ID を返すため、書き込みが受け付けられた時点ですでに読み取り可能だと決めつけず、正確な状態になるまで待ちます。
これは 2 つ目の Vectorize 実験です。直接この実験を開始した場合は、まず LabEx を Cloudflare アカウントに接続する を完了し、その後 V01 を完了してください。これにより、インデックスの互換性、ドキュメント ID、mutation の反映タイミングに慣れることができます。
Vectorize は Workers Free で利用できます。この実験では、384 次元の小さなベクトルを最大 3 件保存し、読み取り回数にも上限を設けています。また、AI モデルは呼び出しません。そのため、Workers Paid と Workers AI Neurons は必要ありません。
セットアップでは、Node.js 22.22.0 とプロジェクトローカルの Wrangler 4.132.0 を /home/labex/project/document-lifecycle-index にインストールします。読み取り専用の独立した確認手段も用意しますが、Wrangler の認証、インデックスの作成、ベクトルの書き込み、Cloudflare アカウントの変更は行いません。
新しいドキュメントライフサイクル用インデックスを認証する
このステップでは、新しい VM を認証し、使用するアカウントを記録して、破棄可能な 1 つのインデックス用に一意のローカル設定を作成します。
用意されたプロジェクトに移動し、固定された CLI のバージョンを確認します。
cd /home/labex/project/document-lifecycle-index
npx wrangler --version
4.132.0 と表示されることを確認します。V01 で使用したものと同じ、制限されたアカウントアクセスと Workers リソースアクセスを認証します。
npx wrangler login --device --browser=false --scopes account:read user:read workers:write
npx wrangler whoami --json
loggedIn: true を確認し、学習用アカウントを特定して、一意の名前を生成します。
RUN="labex-c08-v02-$(openssl rand -hex 6)"
printf '%s\n' "$RUN"
YOUR_ACCOUNT_ID を、そのアカウントの実際の ID に置き換えます。
cat > wrangler.jsonc <<JSON
{
  "\$schema": "./node_modules/wrangler/config-schema.json",
  "name": "$RUN-tools",
  "account_id": "YOUR_ACCOUNT_ID",
  "compatibility_date": "2026-09-16",
  "vectorize": [
    { "binding": "DOCUMENTS", "index_name": "$RUN", "remote": true }
  ]
}
JSON
新しいインデックスは V01 から独立しています。以前の実験で得た知識は再利用しますが、以前の実験の VM やクラウドリソースには依存しません。
現在のドキュメントセットを登録する
このステップでは、インデックスを作成し、編集や廃止を行う前の現在のヘルプセンターを表す 3 件のレコードを insert します。
BGE Small embedding モデルで使用したものと同じ、384 次元・cosine の契約を作成します。
npx wrangler vectorize create "$RUN" --dimensions=384 --metric=cosine --update-config=false
再利用可能な、読み取り回数に上限のある待機処理を作成します。3 回連続で一致する読み取りを行うことで、一時的に古いレプリカから学習者に見える結果が返ることを防ぎます。
cat > scripts/wait-for-vectorize.mjs <<'JS'
import { execFileSync } from "node:child_process";

const [indexName, mutationId, expectedCountText] = process.argv.slice(2);
const expectedCount = Number(expectedCountText);
const wrangler = "./node_modules/wrangler/bin/wrangler.js";
let consecutiveMatches = 0;

for (let attempt = 1; attempt <= 120; attempt += 1) {
  const output = execFileSync(process.execPath, [wrangler, "vectorize", "info", indexName, "--json"], { encoding: "utf8" });
  const info = JSON.parse(output);
  if (info.processedUpToMutation === mutationId && info.vectorCount === expectedCount) {
    consecutiveMatches += 1;
  } else {
    consecutiveMatches = 0;
  }
  if (consecutiveMatches === 3) {
    console.log(`mutation ${mutationId} is consistently readable with ${expectedCount} vectors`);
    console.log(JSON.stringify(info, null, 2));
    process.exit(0);
  }
  await new Promise((resolve) => setTimeout(resolve, 2000));
}
throw new Error(`mutation ${mutationId} was not readable within four minutes`);
JS
決定論的なドキュメントベクトルを 3 件生成します。revision フィールドにより、後の置き換えを簡単に確認できます。メタデータオブジェクト全体には、元のドキュメントが更新された後に検索アプリケーションが必要とする情報が含まれています。
cat > scripts/create-seed.mjs <<'JS'
import { writeFileSync } from "node:fs";

const DIMENSIONS = 384;
const documents = [
  { id: "password-reset", axis: 0, category: "account", title: "Reset your password" },
  { id: "upload-pdf", axis: 1, category: "files", title: "Upload a PDF" },
  { id: "billing-receipt", axis: 2, category: "billing", title: "Download a billing receipt" }
];

const rows = documents.map((document) => {
  const values = Array(DIMENSIONS).fill(0);
  values[document.axis] = 1;
  return {
    id: document.id,
    values,
    metadata: {
      category: document.category,
      published: true,
      title: document.title,
      revision: 1,
      model: "@cf/baai/bge-small-en-v1.5",
      pooling: "cls"
    }
  };
});

writeFileSync("vectors/seed.ndjson", rows.map(JSON.stringify).join("\n") + "\n");
console.log(`prepared ${rows.length} current documents`);
JS
node scripts/create-seed.mjs
新しい ID だけを insert し、結果全体を保存して、実際の mutation が反映されるまで待ちます。
set -o pipefail
npx wrangler vectorize insert "$RUN" --file=vectors/seed.ndjson 2>&1 | tee .labex/seed-output.txt
Wrangler が、キューに追加されたベクトルが 3 件であることと mutation ID を報告した場合にのみ、次へ進みます。認証エラーやネットワークエラーが発生した場合は、結果が確定していません。待機処理を実行する前にエラーを解決してください。
SEED_MUTATION_ID=$(sed -nE 's/.*Mutation changeset identifier: ([0-9a-f-]{36}).*/\1/p' .labex/seed-output.txt | tail -n 1)
if [ -z "$SEED_MUTATION_ID" ]; then
  printf '%s\n' 'No seed mutation ID was returned; fix the insert error before waiting.' >&2
else
  node scripts/wait-for-vectorize.mjs "$RUN" "$SEED_MUTATION_ID" 3
fi
npx wrangler vectorize list-vectors "$RUN" --count=10
一覧には、安定したアプリケーション ID が 3 件含まれているはずです。これらは新しい ID なので、ここでは insert が適しています。次のステップでは、既存の ID を意図的に置き換えます。
更新版のパスワード記事を upsert する
このステップでは、安定した ID を維持したまま、password-reset のベクトルとメタデータを置き換えます。
upsert は、存在しない ID を insert するか、既存の ID を置き換えます。1 つの元ドキュメントが変更された場合に便利ですが、必要なメタデータ全体を送信しなければなりません。新しいレコードに含めなかったフィールドが引き継がれるとは限りません。
現在も有効なすべてのメタデータフィールドを保持しながら、異なる決定論的な軸と更新済みタイトルを使って revision 2 を作成します。
cat > scripts/create-update.mjs <<'JS'
import { writeFileSync } from "node:fs";

const values = Array(384).fill(0);
values[3] = 1;
const updated = {
  id: "password-reset",
  values,
  metadata: {
    category: "account",
    published: true,
    title: "Reset an expired password",
    revision: 2,
    model: "@cf/baai/bge-small-en-v1.5",
    pooling: "cls"
  }
};

writeFileSync("vectors/password-update.ndjson", JSON.stringify(updated) + "\n");
console.log("prepared password-reset revision 2");
JS
node scripts/create-update.mjs
置き換えを送信し、その正確な mutation ID を保存します。
set -o pipefail
npx wrangler vectorize upsert "$RUN" --file=vectors/password-update.ndjson 2>&1 | tee .labex/upsert-output.txt
UPSERT_MUTATION_ID=$(sed -nE 's/.*Mutation changeset identifier: ([0-9a-f-]{36}).*/\1/p' .labex/upsert-output.txt | tail -n 1)
if [ -z "$UPSERT_MUTATION_ID" ]; then
  printf '%s\n' 'No upsert mutation ID was returned; fix the write error before waiting.' >&2
else
  node scripts/wait-for-vectorize.mjs "$RUN" "$UPSERT_MUTATION_ID" 3
fi
npx wrangler vectorize get-vectors "$RUN" --ids password-reset > .labex/password-after-upsert.txt
node - <<'JS'
const text = require("fs").readFileSync(".labex/password-after-upsert.txt", "utf8");
const [row] = JSON.parse(text.slice(text.indexOf("[")));
console.table([{ id: row.id, dimensions: row.values.length, changedAxis: row.values[3], title: row.metadata.title, revision: row.metadata.revision }]);
JS
同じ ID、384 次元、axis 3 が 1、更新後のタイトル、revision 2 が表示されることを確認します。upsert は 4 件目のドキュメントを追加するのではなく、1 つの ID を置き換えるため、合計件数は 3 件のままです。
インデックスを再構築せずに 1 件のドキュメントを廃止する
このステップでは、安定した ID を使って廃止された請求記事を削除し、更新したパスワード記事と変更していないアップロード記事が残っていることを確認します。
ID による削除は、インデックス全体を削除するより対象が限定されます。インデックスの契約と、無関係なすべてのレコードはそのまま残ります。廃止する ID だけを指定して送信します。
set -o pipefail
npx wrangler vectorize delete-vectors "$RUN" --ids billing-receipt 2>&1 | tee .labex/delete-output.txt
削除の mutation と、ベクトル数が 2 件になるまで待ちます。
DELETE_MUTATION_ID=$(sed -nE 's/.*Mutation changeset identifier: ([0-9a-f-]{36}).*/\1/p' .labex/delete-output.txt | tail -n 1)
if [ -z "$DELETE_MUTATION_ID" ]; then
  printf '%s\n' 'No delete mutation ID was returned; fix the write error before waiting.' >&2
else
  node scripts/wait-for-vectorize.mjs "$RUN" "$DELETE_MUTATION_ID" 2
fi
npx wrangler vectorize list-vectors "$RUN" --count=10
npx wrangler vectorize get-vectors "$RUN" --ids password-reset upload-pdf billing-receipt > .labex/documents-after-retirement.txt
node - <<'JS'
const text = require("fs").readFileSync(".labex/documents-after-retirement.txt", "utf8");
const rows = JSON.parse(text.slice(text.indexOf("[")));
console.table(rows.map((row) => ({ id: row.id, title: row.metadata.title, revision: row.metadata.revision })));
JS
残るのは password-reset の revision 2 と upload-pdf の revision 1 だけです。billing-receipt が存在しないことには意味があります。同じ認証済みの読み取りで、残るはずの 2 件も取得できているからです。
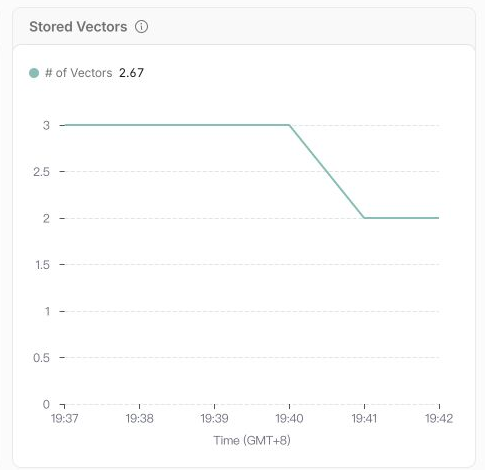
Cloudflare Dashboard で対象のアカウントを開き、AI → Vectorize に移動してから、$RUN に指定した名前のインデックスを開きます。概要に保存済みベクトルが 2 件と表示されることを確認します。Stored Vectors チャートで、表示されたライフサイクルとコマンドを対応付けます。seed mutation の後に件数が 3 件まで増え、対象を絞った削除の後に 2 件まで減少しています。Dashboard ではどの ID が削除されたか分からないため、ID を示す証拠としては Wrangler と独立した API の読み取り結果を使用します。
概要を見ると現在の状態を一目で確認できます。1 件を廃止した後も、2 件のドキュメントが検索可能です。
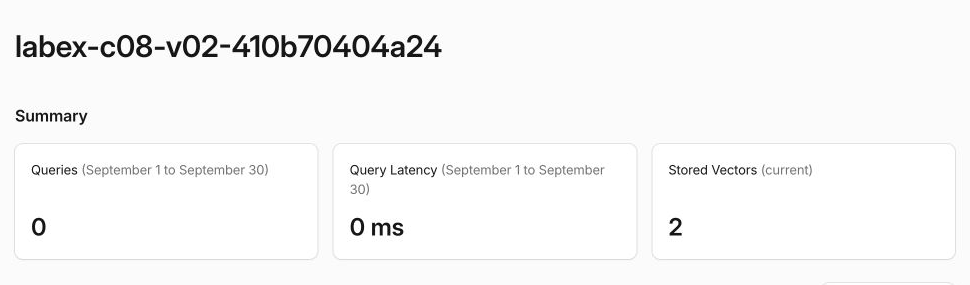
チャートを見ると、ライフサイクルを視覚的に確認できます。線が複数の 1 分間サンプルをまたぐため、平均値が一時的に小数になる場合があります。重要なのは、保存済みベクトルが 3 件から 2 件へ明確に変化していることです。
ライフサイクル用インデックスを削除してログアウトする
このステップでは、対象を絞ったドキュメントライフサイクルを確認した後で、破棄可能なインデックス全体を削除します。
前のステップで 1 件のベクトルを削除しても、インデックスは維持されていました。最後のコマンドでは、実験用リソース全体を意図的に削除します。
npx wrangler vectorize delete "$RUN" --force
npx wrangler vectorize list --json > .labex/indexes-after-cleanup.json
node -e '
  const rows = JSON.parse(require("fs").readFileSync(process.argv[1], "utf8"));
  if (rows.some((row) => row.name === process.argv[2])) throw new Error("lab index still exists");
  console.log("lab index is absent");
' .labex/indexes-after-cleanup.json "$RUN"
認証済みの一覧取得が成功している間に、この実験のクリーンアップ確認を完了します。この確認が成功するまで Wrangler の認証を維持してください。先にログアウトすると、認証エラーと削除成功を区別できなくなるためです。
その後、この VM の認証を削除し、構造化された結果を確認します。
npx wrangler logout
npx wrangler whoami --json
loggedIn: false と表示されることを確認します。別途開いている Dashboard のブラウザーセッションは、引き続き学習用アカウントで利用できます。
まとめ
最初に現在のドキュメント ID を 3 件用意し、upsert で更新版の記事についてベクトルとメタデータ全体を置き換え、対象を絞った削除で古い記事を 1 件廃止しました。正確な mutation ID と、連続して一致する読み取りを行う待機処理により、受け付けられた書き込みと読み取り可能な状態を区別できました。
また、実際のインデックス処理で重要な 2 つの安全性も確認しました。更新によって同じ ID の重複が作られないことと、廃止によって無関係なドキュメントが削除されないことです。最後に、2 件になった状態を Dashboard で確認し、破棄可能なインデックスを削除して、認証済みの一覧から消えたことを確認し、新しい VM からログアウトしました。
V03 では、同じモデル契約でライブクエリ埋め込みを生成し、維持したインデックスから類似するヘルプ記事を取得します。