はじめに
人間が読む AI の回答は、表現が多少変わっても問題にならないことがあります。しかし、アプリケーションコードには、より厳密な形式が必要です。たとえばチケット振り分けサービスでは、category や priority などの名前付きフィールドと、あらかじめ決められた値が必要になります。Structured output は、自由形式の文章ではなく、機械で読み取れるデータをモデルに返させる仕組みです。
この実験では、JSON Mode と JSON Schema を使用します。JSON はデータ形式です。スキーマは、必須フィールド、許可される値の型、予期しないフィールドを禁止するかどうかを定義する契約です。モデルにスキーマへの準拠を要求すると、レスポンスの形は整いやすくなります。ただし、これは信頼境界ではありません。モデルの出力は依然として外部データであり、欠落、不正な形式、アプリケーションとの互換性不足が発生する可能性があります。
この実験では POST /extract を構築します。Worker は小さな合成サポートチケットを 1 件、Cloudflare 上でホストされた Llama モデルに送り、カテゴリ、優先度、短い要約、フォローアップ要否の 4 つのフィールドを要求します。その後、同じスキーマを Worker 内で Ajv により独立して検証し、受け入れたレコードを返します。決定的なテストフィクスチャによって不正なモデル出力を注入し、無効なデータが受け入れレスポンスに入らず、エラーパスに進むことを確認します。
これはコースの 3 番目の実験です。Cloudflare Worker が HTTP リクエストを処理すること、および AI binding が env.AI として Workers AI を公開することを前提とします。コースに直接参加した場合は、まず Connect LabEx to Your Cloudflare Account を完了してください。VM のターミナルの使い方、Wrangler の認証、学習用アカウントの確認、アカウント ID の保存方法を学べます。
この実験では JSON Mode に対応する @cf/meta/llama-3.3-70b-instruct-fp8-fast を使用し、すべてのプロンプトと結果を小さく保ちます。Workers Free アカウントには現在、共有の 1 日 10,000 Neurons 割り当てがあります。そのため、無料割り当てが残っている間は Workers Paid は必要ありません。ローカル推論でも Cloudflare に接続し、その割り当てを消費します。モデルまたは割り当てを利用できない場合は、リクエストを繰り返し送信せずに停止してください。
セットアップでは、Node.js 22.22.0、プロジェクトローカルの Wrangler 4.132.0、Ajv 8.17.1 を /home/labex/project/ticket-fields にインストールします。また、決定的なテストと独立したチェックを用意します。セットアップでログイン、モデル呼び出し、Worker のデプロイ、クラウドリソースの作成は行いません。使い捨ての Worker を削除し、ログアウトを確認するまで、この VM を開いたままにしてください。
VM を認証し、抽出用 Worker を設定する
このステップでは、新しい VM を認証し、使い捨ての Worker を 1 つ設定します。Dashboard のログインはブラウザに属します。一方、新しい VM 上の Wrangler が学習用アカウントを管理するには、別途、制限付きの認証が必要です。
用意されたプロジェクトに移動し、固定された Wrangler のバージョンを確認します。
cd /home/labex/project/ticket-fields
npx wrangler --version
4.132.0 と表示されることを確認します。以前の Workers AI 実験と同じ、必要最小限の権限を要求します。Wrangler 4.132.0 は Worker の削除時に KV の依存関係を確認するため、この実験では KV データを作成しませんが、workers_kv:write を指定して無関係なクリーンアップエラーを防ぎます。
npx wrangler login --device --browser=false --scopes account:read user:read workers_scripts:write workers_kv:write ai:write
表示されたリンクを開き、現在のデバイスコードを入力します。アカウントと権限を確認し、学習用アカウントを認証してください。ターミナルに戻り、構造化された ID 情報を確認します。
npx wrangler whoami --json
loggedIn: true を確認し、対象アカウントの name と id を読み取ります。使い捨て Worker に一意の名前を生成します。
RUN="labex-c07-a03-$(openssl rand -hex 6)"
printf '%s\n' "$RUN"
YOUR_ACCOUNT_ID を対象アカウントの実際の ID に置き換えます。
cat > wrangler.jsonc <<JSON
{
  "\$schema": "./node_modules/wrangler/config-schema.json",
  "name": "$RUN",
  "account_id": "YOUR_ACCOUNT_ID",
  "main": "src/index.js",
  "compatibility_date": "2026-09-16",
  "workers_dev": true,
  "preview_urls": false,
  "observability": {
    "enabled": true,
    "head_sampling_rate": 1
  },
  "ai": {
    "binding": "AI",
    "remote": true
  }
}
JSON
AI binding は env.AI として利用できるようになります。remote: true は、ローカルの Worker プロセスから実際のアカウントに接続されたモデルを呼び出すことを意味します。Observability によって、デプロイ後に確認する簡潔なライフサイクルイベントが保存されます。この時点では、推論もデプロイもまだ実行されていません。
構造化出力の契約を確認する
このステップでは、アプリケーションを保護する 2 つの層を確認します。JSON Mode はモデルへのリクエストにスキーマを含めます。Ajv は Worker 内で返された値を同じスキーマに照らして検証します。最初の層は生成を誘導し、2 番目の層はその値を安全に受け入れるかどうかを決定します。
Worker の環境型を生成します。
npx wrangler types
grep -A4 'interface __BaseEnv_Env' worker-configuration.d.ts
AI: Ai を探します。これはプラットフォームが提供する binding であり、ソースコードに保存するモデル API キーではありません。
レコードには次の 4 つのフィールドがあります。
category: billing | account | upload | other
priority: low | medium | high
summary: nonempty text, at most 160 characters
needs_follow_up: true or false
JSON Schema では、type が値の種類を制御し、enum が値を既知のリストに制限し、required が存在しなければならないフィールドを指定します。additionalProperties: false は予期しないフィールドを拒否します。この最後のルールは重要です。これがないと、追加されたフィールドが気付かれないまま通過する可能性があります。スキーマが定義するのは構造であり、モデルの解釈が客観的に正しいかどうかではありません。受け入れたフィールドについて、人間または後続のビジネスルールによる確認が必要になる場合もあります。
決定的なテストに用意された不正なフィクスチャを確認します。
grep -nE 'security|priority: 1|internal_note|not-an-object' test/worker.test.mjs
これらのフィクスチャは Neurons を消費しません。ライブプロンプトを繰り返し送信して意図的に生成させるのではなく、テストで、発生してはならないケースを確実に検証できます。
検証済みの抽出エンドポイントを構築する
このステップでは、スキーマ、モデルリクエスト、アプリケーション側の検証を実装します。Ajv の検証に合格した分岐だけが record を返します。
Worker のエントリポイントを作成します。
cat > src/index.js <<'JS'
import Ajv from "ajv";

const MODEL = "@cf/meta/llama-3.3-70b-instruct-fp8-fast";
const MAX_TICKET = 1200;

export const TICKET_SCHEMA = {
  type: "object",
  properties: {
    category: { type: "string", enum: ["billing", "account", "upload", "other"] },
    priority: { type: "string", enum: ["low", "medium", "high"] },
    summary: { type: "string", minLength: 1, maxLength: 160 },
    needs_follow_up: { type: "boolean" }
  },
  required: ["category", "priority", "summary", "needs_follow_up"],
  additionalProperties: false
};

const ajv = new Ajv({ allErrors: true });
const isTicketRecord = ajv.compile(TICKET_SCHEMA);

function json(data, status = 200) {
  return Response.json(data, { status });
}

async function readTicket(request) {
  const contentType = request.headers.get("content-type") || "";
  if (!contentType.toLowerCase().includes("application/json")) {
    return { error: json({ error: "json_required" }, 415) };
  }

  const raw = await request.text();
  if (raw.length > 2048) {
    return { error: json({ error: "ticket_too_large" }, 413) };
  }

  let body;
  try {
    body = JSON.parse(raw);
  } catch {
    return { error: json({ error: "invalid_json" }, 400) };
  }

  const ticket = typeof body?.ticket === "string" ? body.ticket.trim() : "";
  if (!ticket) return { error: json({ error: "invalid_ticket" }, 400) };
  if (ticket.length > MAX_TICKET) {
    return { error: json({ error: "ticket_too_large" }, 413) };
  }
  return { ticket };
}

async function extractTicket(request, env) {
  const parsed = await readTicket(request);
  if (parsed.error) return parsed.error;

  const requestId = crypto.randomUUID();
  const details = { requestId, model: MODEL };

  let result;
  try {
    result = await env.AI.run(MODEL, {
      messages: [
        {
          role: "system",
          content: "Extract support-ticket fields. Use only evidence in the ticket. Keep the summary short and do not add fields."
        },
        { role: "user", content: parsed.ticket }
      ],
      response_format: {
        type: "json_schema",
        json_schema: TICKET_SCHEMA
      },
      max_tokens: 160,
      temperature: 0
    });
  } catch {
    console.error(JSON.stringify({ event: "ticket_extraction_failed", ...details }));
    return json({ error: "model_unavailable", requestId }, 502);
  }

  const candidate = result?.response;
  if (!isTicketRecord(candidate)) {
    console.error(JSON.stringify({ event: "ticket_output_rejected", ...details }));
    return json({ error: "invalid_model_output", requestId }, 502);
  }

  console.log(JSON.stringify({ event: "ticket_output_accepted", ...details }));
  return json({ record: candidate, requestId });
}

export default {
  async fetch(request, env) {
    const url = new URL(request.url);
    if (request.method === "GET" && url.pathname === "/health") {
      return json({ status: "ok" });
    }
    if (request.method === "POST" && url.pathname === "/extract") {
      return extractTicket(request, env);
    }
    return json({ error: "not_found" }, 404);
  }
};
JS
Worker はチケット本文や返却フィールドをログに記録しません。リクエスト ID によって、サポート内容を Observability データにコピーせずに、クライアントのレスポンスと受け入れ、拒否、失敗の各ライフサイクルイベントを関連付けます。Ajv のエラー詳細もクライアントレスポンスには含めません。内部の検証設計が明らかになる可能性があるためです。クライアントには安定した invalid_model_output 契約だけを返します。
決定的なテストを実行します。
node --test test/worker.test.mjs
5 件のテストがすべて成功することを確認します。1 件のテストでは、偽の AI binding を通じて 7 種類の不正な候補を注入し、すべてのレスポンスに record が含まれないことを要求します。次に、デプロイせずに実際の Worker をバンドルします。
npx wrangler deploy --dry-run
フィクスチャによって、モデル出力の変動に依存せず、拒否の動作を確認できます。dry run によって、ソース、Ajv 依存関係、Worker 設定をまとめてバンドルできることを確認できます。次のステップでは、実際の構造化推論を 1 回実行します。
実際の構造化結果を 1 件取得する
このステップでは、VM から Worker を実行し、JSON Mode のリクエストを実際に 1 件送信します。「ローカル」とはリクエストハンドラーがローカルで動作するという意味です。AI binding は引き続き指定した Cloudflare アカウントを使用し、1 日の割り当てを消費します。
Wrangler をバックグラウンドで起動し、プロセス ID を保存します。
npx wrangler dev --port 8787 > .labex/dev.log 2>&1 &
echo $! > .labex/dev.pid
AI を使用しないヘルスチェックのエンドポイントを待ちます。
for attempt in $(seq 1 30); do
  if curl --silent --fail http://127.0.0.1:8787/health; then
    break
  fi
  sleep 1
done
明確な合成チケットを 1 件送信します。
curl --silent --show-error http://127.0.0.1:8787/extract \
  --header 'Content-Type: application/json' \
  --data '{"ticket":"Customer cannot upload a PDF and needs help before today’s deadline."}'
record と requestId を含む JSON レスポンスが返ることを確認します。カテゴリ、優先度、要約の表現、フォローアップ要否の具体的な値は変わる可能性があります。重要なのは、record にフィールドが正確に 4 つ含まれ、すべての値がスキーマを満たしていることです。
次に、モデルが呼び出される前に、不正なアプリケーションリクエストが拒否されることを確認します。
curl --silent --show-error --write-out '\nHTTP %{http_code}\n' \
  http://127.0.0.1:8787/extract \
  --header 'Content-Type: application/json' \
  --data '{"ticket":""}'
{"error":"invalid_ticket"} と HTTP 400 が返ることを確認します。入力検証はモデル呼び出しを保護し、出力検証はアプリケーションレコードを保護します。これは別々の境界です。
デプロイして受け入れた出力を確認する
このステップでは、同じ検証済みエンドポイントをデプロイし、Dashboard に表示される状態と実行時の結果を関連付けます。まず、保存した開発プロセスだけを停止します。
kill "$(cat .labex/dev.pid)"
wait "$(cat .labex/dev.pid)" 2>/dev/null || true
Worker をデプロイします。
npx wrangler deploy
Wrangler が表示する正確な workers.dev URL を保存します。
WORKER_URL="https://YOUR_WORKER_URL"
公開エンドポイントに、制限したリクエストを 1 件送信します。
curl --silent --show-error "$WORKER_URL/extract" \
  --header 'Content-Type: application/json' \
  --data '{"ticket":"Customer cannot upload a PDF and needs help before today’s deadline."}'
公開レスポンスでも、record の下にスキーマのフィールドが正確に 4 つ含まれることを確認します。HTTP の成功ステータスだけでは不十分です。独立したチェックでは、返された各フィールドと、デプロイされた AI binding も検証します。
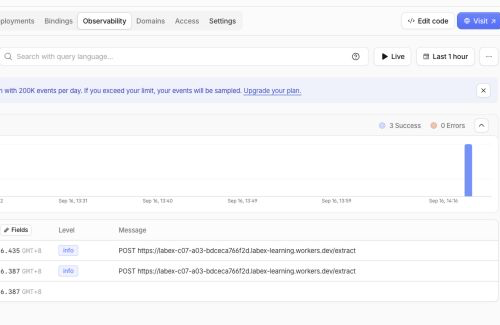
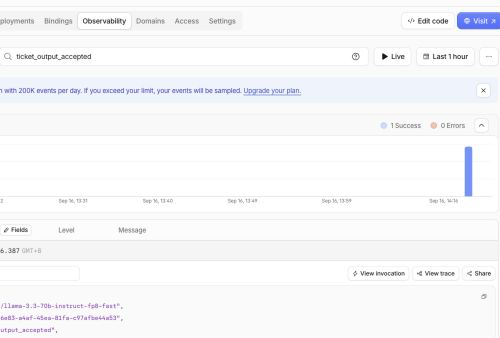
Cloudflare Dashboard を開き、Workers & Pages → Overview → labex-c07-a03-... Worker に移動します。binding を確認し、次に Observability → Logs を開きます。ticket_output_accepted を検索してイベントを展開し、model、requestId、イベント名を確認します。ログには意図的にチケット本文と抽出されたレコードを含めていません。
以下の binding 画面は、使い捨てのデバッグ実行のものです。図と表はいずれも、AI という名前を Workers AI に関連付けています。これは、Worker 内の env.AI に対応する Dashboard 上の表示です。実際に作成した Worker の一意な名前は異なります。
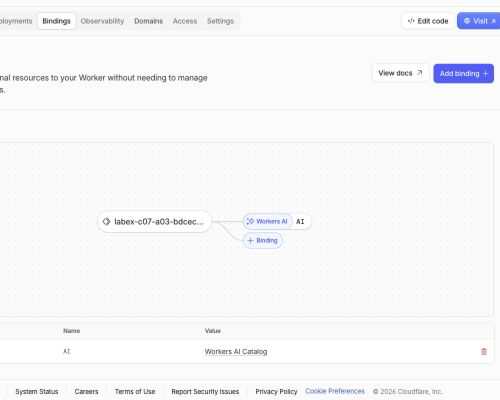
同じ実行では、公開リクエストと独立したチェックの後に、3 Success と 0 Errors が記録されました。これらの合計は例であり、必須の件数ではありません。重要なのは、選択した Worker が表示された /extract リクエストを正常に処理したという関係です。
ticket_output_accepted で絞り込むと、展開されたアプリケーションイベントに、正確な Llama モデル、リクエスト ID、受け入れイベント名が表示されます。合成チケットや抽出レコードは含まれていません。これにより、プライバシー境界を確認できます。ただし、ログ行だけでスキーマ検証の成功を証明しているわけではありません。その証明には、実行時のレスポンスと独立したチェックを使用します。
次に Workers AI を開き、本日のモデル使用量を確認します。Llama 3.3 モデルを見つけ、制限された実習が 10,000 Neurons の Workers Free 割り当て内に収まっていることを確認します。Dashboard の反映には時間がかかる場合があるため、グラフやログを更新する目的で推論を繰り返さず、しばらく待ってください。
例のアカウントでは、Llama モデルに対して 261.63/10k Neurons と表示されました。この合計には、同じ学習用アカウントで以前に行ったコース制作上の実習も含まれているため、この実験だけのコストではなく、実際の値は異なります。確認すべき点は、例の数値と一致することではなく、Free 割り当て内に収まっていることです。
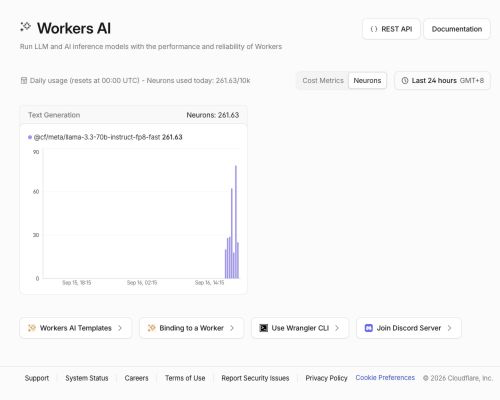
Dashboard の値は、この使い捨て実行に対応しています。学習上の確認ポイントは、正確な Worker の識別情報、その AI binding、プライバシーを制限した受け入れイベント、Free 割り当て内の使用量です。Dashboard の表示が遅れている場合でも、CLI、API、実行時のチェックが正式な確認手段です。
Worker を削除してログアウトする
このステップでは、使い捨て Worker を削除し、その後でこの VM の認証を解除します。Workers AI の使用量はアカウント単位の履歴です。そのため、Worker を削除するとエンドポイントは削除されますが、使用量の記録は消えず、アカウントのプランも変更されません。
wrangler.jsonc に記載された正確な Worker を削除します。
npx wrangler delete
Wrangler にこの実験で作成した一意の labex-c07-a03-... 名が表示された場合にのみ確認してください。コマンドの最後に Successfully deleted と表示されることを確認します。Workers & Pages → Overview を更新し、その正確な名前が表示されないことを確認します。
VM がまだ認証された状態で、独立した管理チェックを実行します。
python3 .labex/verify.py deleted
PASS: deleted と表示された後でのみ、VM に保存された認証情報を削除します。
npx wrangler logout
npx wrangler whoami --json
loggedIn: false になっていることを確認します。ローカルファイルが存在しないこと、ブラウザのタブを閉じたこと、ネットワークエラーが発生したことだけでは、クラウド上の削除やログアウトの証明にはなりません。
まとめ
JSON Mode と JSON Schema を使って構造化されたチケットフィールドを要求する Workers AI エンドポイントを構築しました。要求した形式と信頼できるデータは同じではないことを学び、Ajv を独立したアプリケーション境界として使用しました。また、不正なフィクスチャによって、無効なモデル出力が受け入れレコードになることを防げると確認しました。Workers Free 上でローカルとデプロイ済みの実行結果を 1 件ずつ確認し、受け入れイベントを Dashboard の Observability と関連付け、使い捨て Worker を削除して、新しい VM からログアウトしました。