はじめに
前の Workers AI 埋め込み実験では、テキストが embedding になりました。これは、意味同士の有用な関係を表す順序付きの数値リストです。Embedding は元の記事そのものでも、生成された回答でもありません。アプリケーションが安定したドキュメント ID とともに保存し、後から近いベクトルを検索できて初めて、検索に役立ちます。
Cloudflare Vectorize はベクトルデータベースです。行と列を中心に設計されたテーブルとは異なり、ベクトルインデックスは数値ベクトルを効率的に比較するために設計されています。各インデックスは作成時に、次の 2 つの互換性に関する設定を固定します。
- dimensions — 各ベクトルに含まれる数値の個数
- distance metric — Vectorize がどのベクトルを最近傍と判断するかを決める方法
Cloudflare がホストする @cf/baai/bge-small-en-v1.5 embedding 用に 384 次元のインデックスを作成し、A04 で紹介した方向ベースの比較と同じ cosine distance を選択します。category と published のメタデータインデックスを追加し、合成した小さなヘルプ記事ベクトルを 3 件挿入します。その後、非同期ミューテーションが読み取り可能になるまで待ち、3 次元のベクトルが拒否されることを確認します。
これは Vectorize コースの最初の実験です。直接この実験を開始した場合は、まず LabEx を Cloudflare アカウントに接続する を完了してください。LabEx VM のターミナル、Wrangler の認証、学習用アカウントの確認、アカウント ID の設定方法を学べます。ベクトル、次元数、cosine similarity に慣れていない場合は、先に Workers AI A04 を完了してください。
Vectorize は Workers Free で利用できます。現在含まれている利用枠は、この実験で扱う 384 次元ベクトル 3 件と読み取り専用の確認処理を大きく上回るため、Workers Paid は必要ありません。この実験では Workers AI を呼び出さないため、Neurons も消費しません。
セットアップでは、Node.js 22.22.0 とプロジェクトローカルの Wrangler 4.132.0 を /home/labex/project/document-vector-index にインストールします。また、独立した読み取り専用の確認処理も用意します。セットアップによって Wrangler の認証、インデックスの作成、ベクトルの書き込み、Cloudflare アカウントの変更が行われることはありません。
VM を認証し、インデックス名を設定する
このステップでは、新しい VM を認証し、使用する学習用アカウントを選択し、使い捨ての一意なインデックス名を記録します。
Cloudflare Dashboard のログイン状態はブラウザに属します。一方、この新しい VM の Wrangler は別のクライアントなので、Vectorize リソースを管理する前に限定的な認証が必要です。
用意されたプロジェクトに移動し、固定された CLI バージョンを確認します。
cd /home/labex/project/document-vector-index
npx wrangler --version
4.132.0 と表示されることを確認します。アカウントの識別情報の読み取りと Workers リソースの管理を要求します。この Wrangler バージョンでは、workers:write OAuth スコープに、この実験で使用する Vectorize 管理操作が含まれています。推論処理は行わないため、AI スコープは要求しません。
npx wrangler login --device --browser=false --scopes account:read user:read workers:write
表示されたリンクを開き、現在のコードを入力します。アカウントと権限を確認して、学習用アカウントを認証します。その後、構造化された識別情報を確認します。
npx wrangler whoami --json
loggedIn: true と表示され、使用する学習用アカウントが特定できることを確認します。使い捨ての一意なインデックス名を生成します。
RUN="labex-c08-v01-$(openssl rand -hex 6)"
printf '%s\n' "$RUN"
YOUR_ACCOUNT_ID を、そのアカウントの実際の ID に置き換えます。
cat > wrangler.jsonc <<JSON
{
  "\$schema": "./node_modules/wrangler/config-schema.json",
  "name": "$RUN-tools",
  "account_id": "YOUR_ACCOUNT_ID",
  "compatibility_date": "2026-09-16",
  "vectorize": [
    { "binding": "DOCUMENTS", "index_name": "$RUN", "remote": true }
  ]
}
JSON
この binding には、次の実験で Worker コードから使用する関係を記録します。DOCUMENTS はアプリケーション側で使う名前で、index_name は所有するクラウドリソースの名前です。remote: true によって、ローカル Worker は分離されたローカルシミュレーションではなく、実際のリモートインデックスに接続します。
インデックスとフィルタリング可能なフィールドを作成する
このステップでは、固定されたベクトルの契約を作成し、後でフィルタリングに使う 2 つのメタデータフィールドを準備します。
インデックスの次元数と距離メトリクスは固定されます。すべての比較が同じ数値の契約に従う必要があるためです。BGE Small は 384 個の数値を生成します。Cosine distance はベクトルの方向を比較するため、A04 で扱った意味重視の embedding に適しています。
V2 インデックスを作成します。
npx wrangler vectorize create "$RUN" --dimensions=384 --metric=cosine --update-config=false
ベクトルには、ドキュメントのカテゴリなどの小さなメタデータも付加できます。メタデータを保存しただけでは、自動的にフィルタリング可能にはなりません。metadata index は、どのフィールドをフィルター用に準備するかを Vectorize に伝えます。ベクトルを挿入する前に、次のフィールドを作成します。
npx wrangler vectorize create-metadata-index "$RUN" --propertyName=category --type=string | tee .labex/category-index-output.txt
npx wrangler vectorize create-metadata-index "$RUN" --propertyName=published --type=boolean | tee .labex/published-index-output.txt
--update-config=false によって、すでに記述した binding を置き換えるかどうかを Wrangler が確認することを防ぎます。メタデータインデックスの作成は非同期です。各コマンドはミューテーションをキューに追加するため、成功メッセージは Cloudflare が変更を受け付けたことを示すだけで、すべての読み取りにすぐ反映されたことを示すわけではありません。
再利用できる待機スクリプトを作成します。このスクリプトは読み取り専用の vectorize info コマンドだけを実行し、正確なミューテーション ID を比較します。また、結果を信頼する前に、一致する読み取りが 3 回連続することを要求します。この追加確認により、一時的に古い読み取りレプリカを最終状態として表示することを防ぎます。4 分後にエラーで停止するため、無期限に待ち続けることもありません。
cat > scripts/wait-for-vectorize.mjs <<'JS'
import { execFileSync } from "node:child_process";

const [indexName, mutationId, expectedCountText] = process.argv.slice(2);
const expectedCount = Number(expectedCountText);
const wrangler = "./node_modules/wrangler/bin/wrangler.js";
let consecutiveMatches = 0;

for (let attempt = 1; attempt <= 120; attempt += 1) {
  const output = execFileSync(process.execPath, [wrangler, "vectorize", "info", indexName, "--json"], { encoding: "utf8" });
  const info = JSON.parse(output);
  if (info.processedUpToMutation === mutationId && info.vectorCount === expectedCount) {
    consecutiveMatches += 1;
  } else {
    consecutiveMatches = 0;
  }
  if (consecutiveMatches === 3) {
    console.log(`mutation ${mutationId} is consistently readable with ${expectedCount} vectors`);
    console.log(JSON.stringify(info, null, 2));
    process.exit(0);
  }
  await new Promise((resolve) => setTimeout(resolve, 2000));
}
throw new Error(`mutation ${mutationId} was not readable within four minutes`);
JS

METADATA_MUTATION_ID=$(sed -nE 's/.*Mutation changeset identifier: ([0-9a-f-]{36}).*/\1/p' .labex/published-index-output.txt | tail -n 1)
test -n "$METADATA_MUTATION_ID"
node scripts/wait-for-vectorize.mjs "$RUN" "$METADATA_MUTATION_ID" 0
npx wrangler vectorize get "$RUN"
npx wrangler vectorize list-metadata-index "$RUN"
最後に表示されるテーブルで、384 次元、cosine distance、category が String、published が Bool になっていることを確認します。Bool は、--type=boolean で作成したフィールドに対する現在の API 表示名です。2 つ目のメタデータミューテーションを待つことで、次のベクトル挿入が未完了のインデックス準備処理の後ろで待たされることを防ぎます。
識別子付きドキュメントベクトルを作成する
このステップでは、ID とメタデータを個別に確認できる、小さく透明性の高いベクトルのテストデータを生成します。
ベクトルデータベースは、元のドキュメントを置き換えるものではありません。各ベクトルには、アプリケーションが実際のコンテンツに対応付けるための安定した ID が必要です。この実験では、合成したヘルプ記事 ID を 3 件使い、カテゴリ、公開状態、embedding モデル、プーリング方法をメタデータとして記録します。
実際の embedding は V03 で扱います。ここでは決定論的なベクトルを使うため、保存動作を再現でき、無料で実行できます。各ドキュメントは異なる軸の方向を指し、384 個の位置になるまで 0 が続きます。
透明性の高いテストデータ生成スクリプトを作成します。
cat > scripts/create-vectors.mjs <<'JS'
import { writeFileSync } from "node:fs";

const DIMENSIONS = 384;
const MODEL = "@cf/baai/bge-small-en-v1.5";
const POOLING = "cls";
const documents = [
  { id: "password-reset", axis: 0, category: "account" },
  { id: "upload-pdf", axis: 1, category: "files" },
  { id: "billing-receipt", axis: 2, category: "billing" }
];

function unitVector(axis) {
  const values = Array(DIMENSIONS).fill(0);
  values[axis] = 1;
  return values;
}

const rows = documents.map((document) => ({
  id: document.id,
  values: unitVector(document.axis),
  metadata: {
    category: document.category,
    published: true,
    model: MODEL,
    pooling: POOLING
  }
}));

writeFileSync("vectors/documents.ndjson", rows.map(JSON.stringify).join("\n") + "\n");
console.log(`wrote ${rows.length} vectors with ${DIMENSIONS} dimensions each`);
JS
node scripts/create-vectors.mjs
NDJSON は newline-delimited JSON の略です。外側を 1 つの JSON 配列で囲むのではなく、1 行に 1 つの完全なベクトルオブジェクトを記述します。Wrangler はこの形式をバッチでストリーミングできます。1,152 個の数値をすべて表示せず、ID と形状を確認します。
node - <<'JS'
const rows = require("fs").readFileSync("vectors/documents.ndjson", "utf8").trim().split("\n").map(JSON.parse);
console.table(rows.map(({ id, values, metadata }) => ({ id, dimensions: values.length, category: metadata.category, published: metadata.published })));
JS
3 行すべてで、次元数が 384 と表示されるはずです。model と cls pooling のメタデータは互換性を記録するためのものです。Vectorize がその意味上の互換性を自動的に推測したり検証したりするわけではありません。
ベクトルを挿入し、ミューテーションを待つ
このステップでは、3 件のベクトルを 1 つのバッチで挿入し、その正確な非同期ミューテーションが読み取り可能になるまで待ちます。
Vectorize への書き込みは非同期です。挿入リクエストはまず永続的な write-ahead log に到達し、mutation ID を返します。その後、バックグラウンド処理によって、そのミューテーションが読み取りに反映されます。この設計により書き込みを効率化できますが、「受け付けられた時点」と「読み取り可能になった時点」は異なります。
3 件のベクトルをまとめて挿入し、完全な結果を保存します。pipefail によって、後続の tee コマンドが成功しても Wrangler の失敗が隠れないようにします。
set -o pipefail
npx wrangler vectorize insert "$RUN" --file=vectors/documents.ndjson 2>&1 | tee .labex/insert-output.txt
Wrangler が 3 件のベクトルをキューに追加したことと、ミューテーション識別子を表示したことを確認してから続行します。API が認証エラーまたはネットワークエラーを返した場合、その結果だけでは判断できません。npx wrangler whoami --json を確認してから、同じ挿入ブロックを 1 回再実行してください。実際のミューテーション ID がない状態で待機スクリプトを開始しないでください。
受け付けられたミューテーションを取り出し、ID が存在する場合だけ待機します。
MUTATION_ID=$(sed -nE 's/.*Mutation changeset identifier: ([0-9a-f-]{36}).*/\1/p' .labex/insert-output.txt | tail -n 1)
if [ -z "$MUTATION_ID" ]; then
  printf '%s\n' 'No mutation ID was returned; fix the insert error before waiting.' >&2
else
  printf 'Waiting for mutation %s\n' "$MUTATION_ID"
  node scripts/wait-for-vectorize.mjs "$RUN" "$MUTATION_ID" 3
fi
待機スクリプトの最後の JSON で、vectorCount が 3 になり、記録したミューテーション ID が表示されることを確認します。一致する読み取りを 3 回要求することで、短時間のレプリカ遅延が学習者に見える結果へ影響することを防ぎます。固定時間の sleep よりも、上限付きのポーリングの方が安全です。ミューテーションが速く完了すればすぐに終了し、正常だが遅いミューテーションには重複書き込みを発生させずに時間を与えられます。
ドキュメントを読み取り、互換性をテストする
このステップでは、受け付けられたレコードを読み取り、互換性のない書き込みが拒否されることを確認し、CLI の状態を Dashboard と照合します。
アプリケーション ID を使って保存済みレコードを読み取ります。
完全なレコードを保存し、その後、1,152 個の数値でターミナルを埋め尽くさないように、簡潔なテーブルを表示します。
npx wrangler vectorize get-vectors "$RUN" --ids password-reset upload-pdf billing-receipt > .labex/stored-vectors.txt
node - <<'JS'
const text = require("fs").readFileSync(".labex/stored-vectors.txt", "utf8");
const rows = JSON.parse(text.slice(text.indexOf("[")));
console.table(rows.map(({ id, values, metadata }) => ({ id, dimensions: values.length, category: metadata.category, published: metadata.published })));
JS
各サマリー行に、ID、384 個の値を持つ形状、メタデータが保持されていることを確認します。raw ファイルには独立した確認に使える完全な値が含まれています。get-vectors は既知のレコードを読み取るコマンドであり、類似度検索ではありません。類似度クエリは V03 で扱います。
次に、値が 3 個しかない、意図的に互換性のないレコードを 1 件作成します。
cat > vectors/incompatible.ndjson <<'NDJSON'
{"id":"wrong-dimensions","values":[1,0,0],"metadata":{"category":"account","published":true}}
NDJSON
if npx wrangler vectorize insert "$RUN" --file=vectors/incompatible.ndjson > .labex/incompatible.log 2>&1; then
  STATUS=0
else
  STATUS=$?
fi
printf '%s\n' "$STATUS" > .labex/incompatible-exit.txt
sed -n '/invalid vector/p' .labex/incompatible.log
test "$STATUS" -ne 0
この拒否によってインデックスの契約が保護されます。3 個の位置しかないベクトルは、384 個の位置を持つベクトルと意味のある比較ができないためです。受け付けられたレコードが残り、拒否された ID が表示されないことを確認します。
npx wrangler vectorize info "$RUN"
npx wrangler vectorize list-vectors "$RUN" --count=10
npx wrangler vectorize get-vectors "$RUN" --ids wrong-dimensions
選択したアカウントの Cloudflare Dashboard を開き、AI → Vectorize に移動します。インベントリで CLI の名前と実際のインデックスが対応していることを確認できます。384 次元、cosine distance、合計 3 個のベクトルが表示されます。この小さな例では、課金対象の使用量はありません。
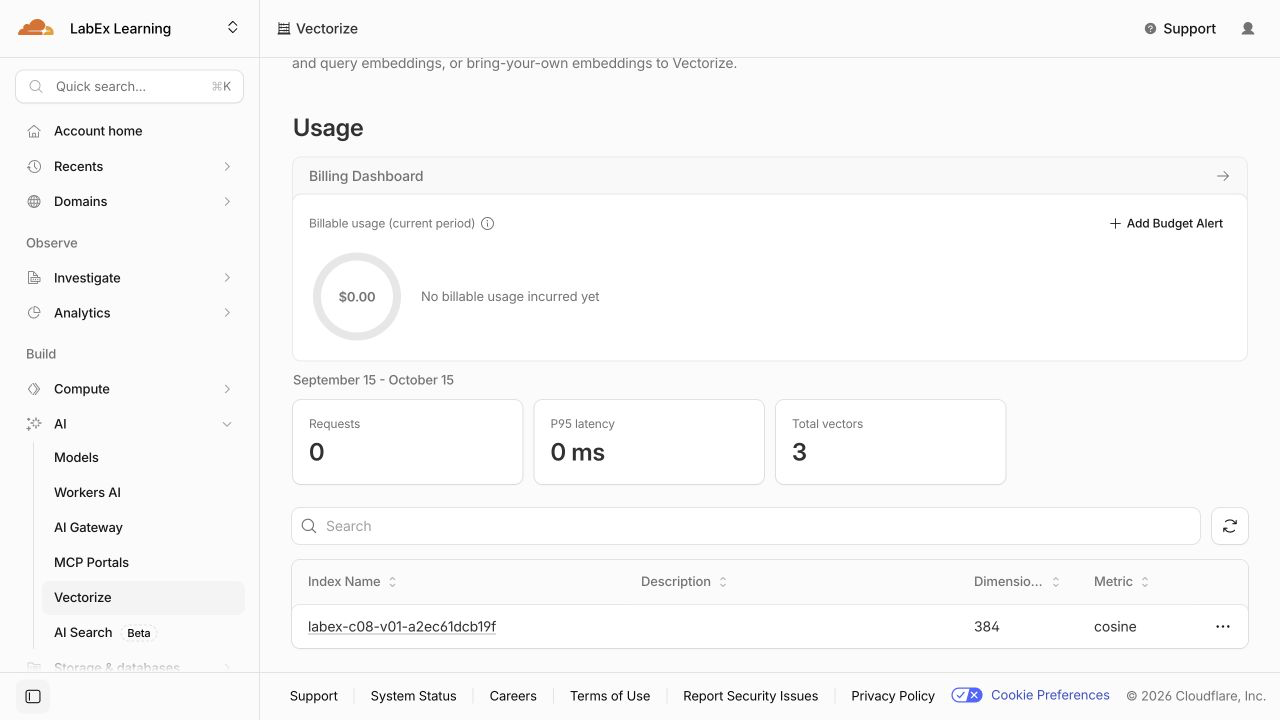
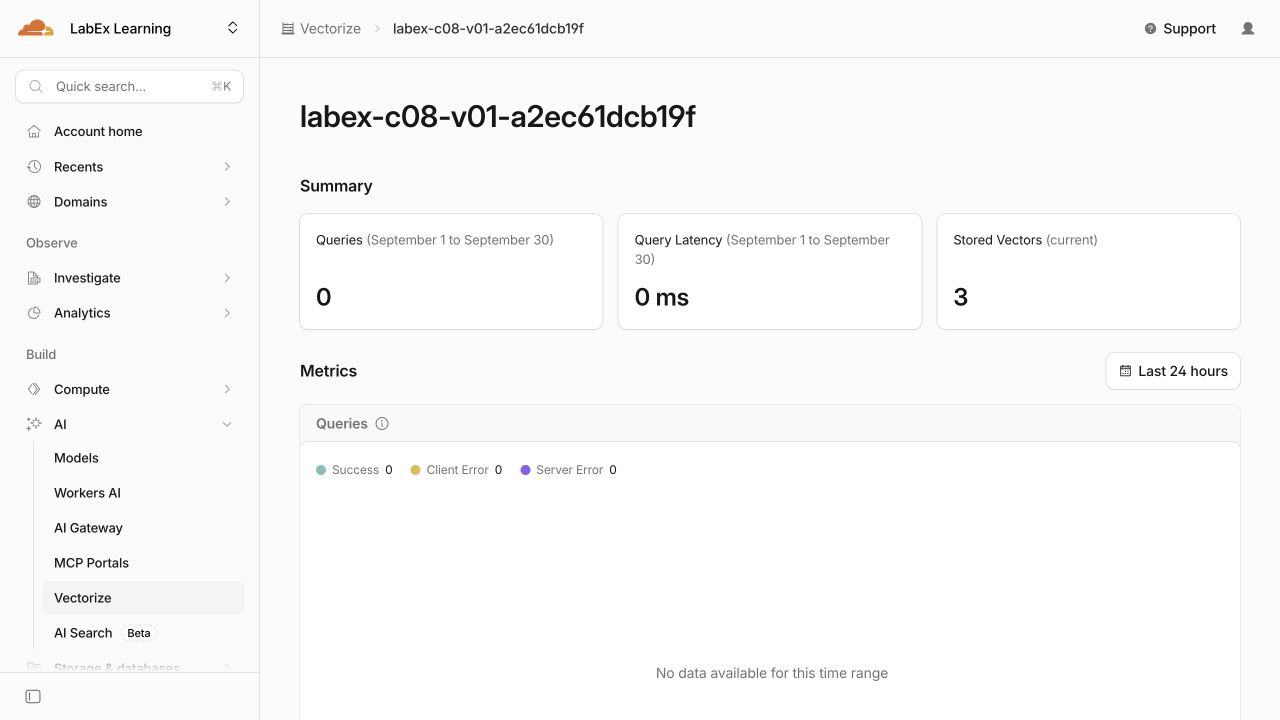
$RUN に記録された名前のインデックスを開きます。概要に、現在保存されているベクトルが 3 個表示されます。この最初の実験では ID 読み取りだけを行うため、クエリ数は 0 のままです。類似度クエリは V03 で始めます。
Stored Vectors までスクロールします。このグラフによって、非同期で読み取り可能になる流れを具体的に確認できます。挿入ミューテーションの処理が完了すると、件数は 0 から 3 に変わります。
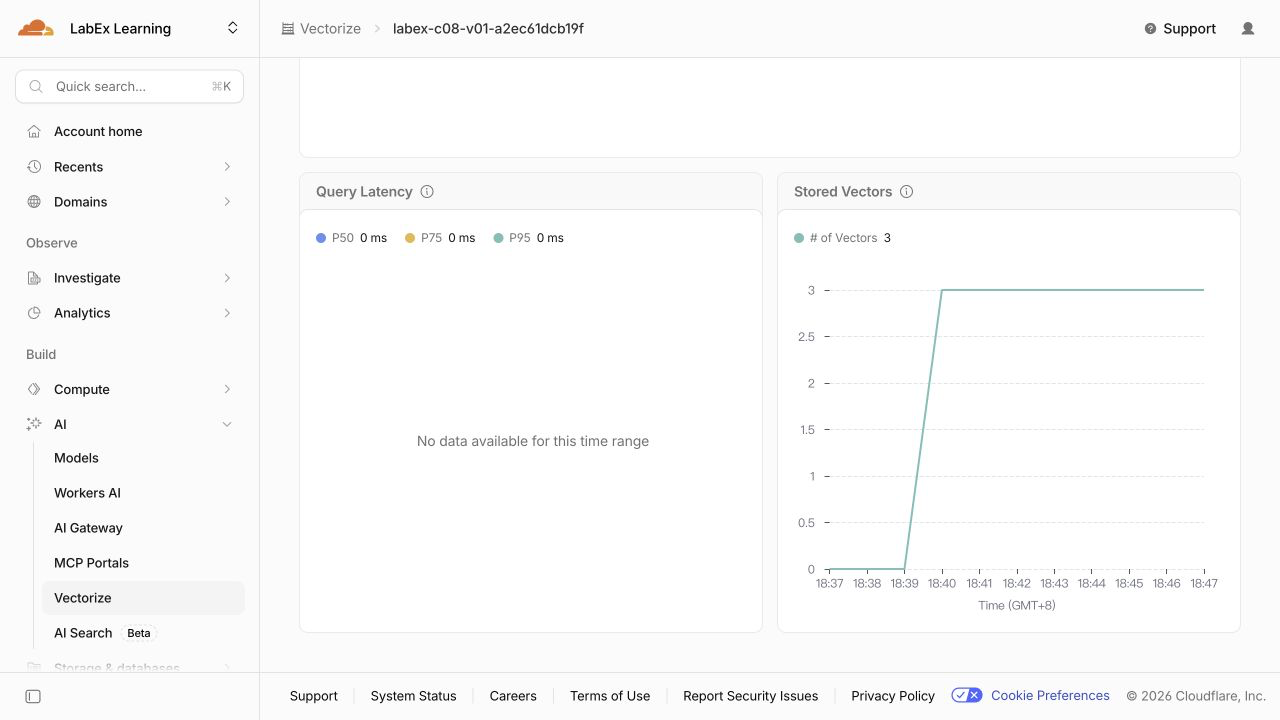
現在の Dashboard には、個々のベクトル ID やメタデータインデックスの定義は表示されません。password-reset、upload-pdf、billing-receipt、category、published については、前の Wrangler による読み取り結果を使ってください。件数だけを示すグラフから、これらの詳細を推測しないでください。Dashboard のページは全体像を把握するために役立ちますが、独立した確認処理では信頼できる API の読み取り結果を使います。
ここに示したスクリーンショットは、実験で Cloudflare の受け入れ確認が完了した後に、ある使い捨て実行環境で取得した例です。ランダムに生成したインデックス名やタイムスタンプは異なります。例の値をコピーするのではなく、設定と所有する ID が一致していることを確認してください。
使い捨てインデックスを削除し、ログアウトする
このステップでは、所有している正確なインデックスを削除し、認証済みの一覧から存在しないことを確認してから、VM の認証を解除します。
インデックス、そのメタデータインデックス、ベクトルは、1 つの使い捨てリソースを構成します。認証が有効なうちに、wrangler.jsonc に保存した正確な名前を削除します。
npx wrangler vectorize delete "$RUN" --force
認証済みのインベントリ読み取りによって、インデックスが存在しないことを確認します。
npx wrangler vectorize list --json > .labex/indexes-after-cleanup.json
node -e '
  const rows = JSON.parse(require("fs").readFileSync(process.argv[1], "utf8"));
  if (rows.some((row) => row.name === process.argv[2])) throw new Error("lab index still exists");
  console.log("lab index is absent");
' .labex/indexes-after-cleanup.json "$RUN"
このインベントリ読み取りが成功することが重要です。ネットワークエラーや認証エラーでは、削除されたことを証明できません。VM の認証を取り消す前に、クリーンアップの確認を実行します。
bash verify6-1.sh
最後に、VM の Wrangler ログインを削除し、構造化された結果を確認します。
npx wrangler logout
npx wrangler whoami --json
loggedIn: false と表示されることを確認します。Dashboard のブラウザログインは別のものであり、学習用アカウントでは引き続き利用できます。
まとめ
選択した embedding モデルと同じ 384 次元の契約を持つ Vectorize V2 インデックスを作成し、cosine distance を選択して、後のフィルターに使う 2 つのメタデータフィールドを準備しました。識別子付きの決定論的なベクトルを生成し、NDJSON として挿入しました。また、受け付けられた非同期ミューテーションと、処理済みで読み取り可能になったミューテーションを区別し、保存されたレコードを ID で読み取りました。
さらに、次元数が正しくないベクトルが Vectorize によって拒否され、互換性のあるレコードは保持されることを確認しました。最後に、Dashboard で実際のリソースを確認し、正確な使い捨てインデックスを削除して、認証済みの一覧から存在しないことを確認し、新しい VM の Wrangler 認証を削除しました。
次の実験では、このライフサイクルを upsert と削除によって拡張し、変更または廃止されたドキュメントがインデックスに古い状態で残らないようにします。