はじめに
V03 では、質問を埋め込みに変換し、関連性の高いヘルプ記事を取得しました。V04 では、その結果をサーバーが管理する customer と category の範囲内に限定しました。検索結果はそれだけでも役立ちますが、多くのサポートアプリケーションでは、もう 1 つの手順が必要です。承認済みのパッセージを短い自然言語の回答に変換します。
このパターンは retrieval-augmented generation と呼ばれ、通常は RAG と略されます。アプリケーションはまず根拠となる情報を取得し、それらのレコードだけから小さなコンテキストを作成し、そのコンテキストに基づいて回答するよう言語モデルに依頼します。検索機能だけで、モデルが自動的に正確になるわけではありません。アプリケーション側で、使用可能なソースを制御し、プロンプトに入れるテキスト量を制限し、ソース ID を保持し、承認済みの証拠がない場合は停止する必要があります。
この実験では、2 つの Cloudflare バインディングを持つ使い捨ての Worker を 1 つ構築します。DOCUMENTS は Vectorize インデックスを検索し、AI は BGE Small 埋め込みモデルと Cloudflare がホストする Llama テキスト生成モデルの両方を実行します。Worker は、コード内に用意された corpus を使って返された vector ID を解決します。vector metadata は検索には役立ちますが、正規の記事本文としては扱いません。
エンドポイントは、生成された回答と並べて、アプリケーションが制御する sources 配列を返します。選択した namespace と category の範囲内で検索結果が見つからない場合は、テキスト生成モデルを呼び出さず、固定された no_evidence レスポンスを返します。モデルに推測で回答させるよりも、この明示的な分岐のほうが安全です。
このコースに直接アクセスした場合は、まず Connect LabEx to Your Cloudflare Account を完了してください。V01〜V04 が前提条件です。これらの実験では、互換性のあるインデックス、非同期 mutation、セマンティック検索、サーバーが制御するスコープについて学びます。
この実験では、Cloudflare がホストする @cf/meta/llama-3.3-70b-instruct-fp8-fast モデルを使用します。このモデルは、前の Workers AI コースで Workers Free 上での動作確認が済んでいるためです。DeepSeek V4 Flash も Cloudflare がホストしていますが、現在は有料アクセスが必要です。そのため、受講者に必須の依存関係ではありません。この実験が送信するのは、サイズを制限した埋め込みリクエストと生成リクエストだけです。アカウントで共有される Workers AI の無料割り当てが利用できる間は、Workers Paid は必要ありません。
セットアップでは、Node.js 22.22.0 とプロジェクトローカルの Wrangler 4.132.0 を /home/labex/project/grounded-answer にインストールします。決定的なテストと、独立した読み取り専用チェックも用意されています。ただし、Wrangler の認証、インデックスの作成、Worker のデプロイ、推論の実行、クラウドデータのシードは行いません。
RAG リソースを認証して名前を付ける
このステップでは、新しい VM を認証し、学習用アカウントを確認し、作成前に Worker と Vectorize インデックスのペアを 1 つ定義します。
準備済みのプロジェクトに移動し、固定されたツールのバージョンを確認します。
cd /home/labex/project/grounded-answer
node --version
npx wrangler --version
Node.js は v22.22.0、Wrangler は 4.132.0 と表示されるはずです。ブラウザーでの Dashboard ログインは、この VM を自動的に認証しません。そのため、アカウント情報、使い捨ての Worker、Vectorize、Workers AI に必要な権限を指定して、Wrangler のデバイスフローを使用します。
npx wrangler login --device --browser=false --scopes account:read user:read workers:write workers_scripts:write workers_kv:write ai:write
npx wrangler whoami --json
表示された認証リンクを開き、コードが一致することを確認して、対象の LabEx Learning アカウントを承認します。コード、パスワード、トークンを他人に送らないでください。JSON の結果で loggedIn: true を確認し、アカウント名と ID を控えます。
ランダムなサフィックスを 1 つ生成します。後で正確なペアを識別してクリーンアップできるように、両方のリソース名で同じサフィックスを使用します。
RUN="labex-c08-v05-$(openssl rand -hex 6)"
INDEX="$RUN-docs"
printf 'Worker: %s\nIndex: %s\n' "$RUN" "$INDEX"
wrangler.jsonc を作成します。ヒアドキュメントでは、JSON マーカーの間にあるブロックをファイルに書き込みます。$RUN と $INDEX は、この VM 用の一意な名前に展開されます。YOUR_ACCOUNT_ID を whoami で表示された ID に置き換えてください。
cat > wrangler.jsonc <<JSON
{
  "\$schema": "./node_modules/wrangler/config-schema.json",
  "name": "$RUN",
  "main": "src/index.js",
  "compatibility_date": "2026-09-16",
  "compatibility_flags": ["nodejs_compat"],
  "account_id": "YOUR_ACCOUNT_ID",
  "workers_dev": true,
  "preview_urls": false,
  "observability": { "enabled": true },
  "ai": { "binding": "AI" },
  "vectorize": [
    { "binding": "DOCUMENTS", "index_name": "$INDEX", "remote": true }
  ]
}
JSON
AI は 1 つのバインディングです。コードからは 2 つのモデルを呼び出しますが、バインディングは 1 つだけです。DOCUMENTS は対応するインデックスを指します。このファイルは使用するリソース名を定義するだけで、まだ何も作成しません。
Retrieve-Then-Generate Worker を構築する
このステップでは、完全な RAG の流れを実装し、クラウドのクォータを使う前に、決定的なインメモリバインディングで各判断を検証します。
用意されている CORPUS は、ID とテキストを対応付ける正規のマップです。Vectorize には埋め込みと検索可能な metadata を保存します。クエリ後、Worker はこのマップで解決できる ID だけを受け入れます。その後、プロンプトに含めるパッセージは最大 2 件に制限します。これにより、スコアが高いという理由だけで、想定外のインデックスレコードがモデルのコンテキストになることを防ぎます。
Worker のソースを作成します。
cat > src/index.js <<'JS'
export const EMBEDDING_MODEL = "@cf/baai/bge-small-en-v1.5";
export const ANSWER_MODEL = "@cf/meta/llama-3.3-70b-instruct-fp8-fast";
const DIMENSIONS = 384;
const POOLING = "cls";
const ALLOWED_CATEGORIES = new Set(["account", "billing", "files"]);

export const CORPUS = [
  {
    id: "password-reset",
    namespace: "customer-blue",
    category: "account",
    title: "Reset a password",
    url: "https://support.example.test/articles/password-reset",
    text: "If a password expires, open the sign-in page, choose Forgot password, and use the one-time reset link sent to the verified email address."
  },
  {
    id: "mfa-recovery",
    namespace: "customer-blue",
    category: "account",
    title: "Recover multi-factor access",
    url: "https://support.example.test/articles/mfa-recovery",
    text: "If the authenticator device is unavailable, enter a saved recovery code. Contact an administrator only after all recovery codes are exhausted."
  },
  {
    id: "billing-receipt",
    namespace: "customer-blue",
    category: "billing",
    title: "Download a billing receipt",
    url: "https://support.example.test/articles/billing-receipt",
    text: "Open Billing, select a completed payment, and choose Download receipt to save a PDF copy."
  }
];

const CORPUS_BY_ID = new Map(CORPUS.map((item) => [item.id, item]));

function json(value, status = 200) {
  return Response.json(value, { status });
}

export function resolveSession(value) {
  if (value === "blue-session") return { customer: "blue", namespace: "customer-blue" };
  throw new Error("session_invalid");
}

export function parseAnswerInput(value) {
  if (!value || typeof value !== "object" || Array.isArray(value)) throw new Error("invalid_json");
  for (const key of ["customer", "customerId", "namespace", "sources", "context"]) {
    if (Object.prototype.hasOwnProperty.call(value, key)) throw new Error("scope_override_not_allowed");
  }
  const question = typeof value.question === "string" ? value.question.trim() : "";
  const category = typeof value.category === "string" ? value.category.trim() : "";
  if (!question || question.length > 240) throw new Error("question_required");
  if (!ALLOWED_CATEGORIES.has(category)) throw new Error("category_invalid");
  return { question, category };
}

export function validateEmbeddingBatch(result, expectedCount) {
  const vectors = result?.data;
  if (!Array.isArray(vectors) || vectors.length !== expectedCount || result?.shape?.[1] !== DIMENSIONS) {
    throw new Error("incompatible embedding batch");
  }
  for (const vector of vectors) {
    if (!Array.isArray(vector) || vector.length !== DIMENSIONS || !vector.every(Number.isFinite)) {
      throw new Error("invalid embedding vector");
    }
  }
  return vectors;
}

async function embed(env, texts) {
  const result = await env.AI.run(EMBEDDING_MODEL, { text: texts, pooling: POOLING });
  return validateEmbeddingBatch(result, texts.length);
}

async function seed(env) {
  const vectors = await embed(env, CORPUS.map((item) => item.text));
  const records = CORPUS.map((item, index) => ({
    id: item.id,
    namespace: item.namespace,
    values: vectors[index],
    metadata: {
      category: item.category,
      title: item.title,
      model: EMBEDDING_MODEL,
      pooling: POOLING
    }
  }));
  const mutation = await env.DOCUMENTS.upsert(records);
  console.log(JSON.stringify({ event: "grounding_sources_seeded", count: records.length, mutationId: mutation.mutationId }));
  return json({ mutationId: mutation.mutationId, count: records.length, model: EMBEDDING_MODEL, dimensions: DIMENSIONS, pooling: POOLING }, 202);
}

function noEvidence(category, candidateCount) {
  console.log(JSON.stringify({ event: "grounded_no_evidence", category, candidateCount }));
  return json({
    mode: "no_evidence",
    generated: false,
    answer: "I don't have enough approved evidence to answer that question.",
    sources: []
  });
}

async function answer(request, env) {
  let scope;
  try {
    scope = resolveSession(request.headers.get("x-lab-session") ?? "");
  } catch {
    return json({ error: "session_invalid" }, 401);
  }

  let input;
  try {
    input = parseAnswerInput(await request.json());
  } catch (error) {
    return json({ error: error instanceof Error ? error.message : "invalid_json" }, 400);
  }

  const [queryVector] = await embed(env, [input.question]);
  const result = await env.DOCUMENTS.query(queryVector, {
    topK: 2,
    namespace: scope.namespace,
    filter: { category: input.category },
    returnMetadata: "all"
  });

  const sources = result.matches.flatMap((match) => {
    const article = CORPUS_BY_ID.get(match.id);
    if (!article || article.namespace !== scope.namespace || article.category !== input.category) return [];
    return [{
      id: article.id,
      title: article.title,
      url: article.url,
      text: article.text,
      score: match.score
    }];
  });

  if (sources.length === 0) return noEvidence(input.category, result.matches.length);

  const context = sources.map((source) =>
    "[source:" + source.id + "] " + source.title + "\n" + source.text
  ).join("\n\n");
  const generation = await env.AI.run(ANSWER_MODEL, {
    messages: [
      {
        role: "system",
        content: "Answer only from the supplied support context. Keep the answer under 80 words. Cite supporting source IDs in square brackets. If the context is insufficient, say you do not have enough approved evidence."
      },
      {
        role: "user",
        content: "Question: " + input.question + "\n\nApproved context:\n" + context
      }
    ],
    max_tokens: 160,
    temperature: 0
  });
  const generatedAnswer = typeof generation?.response === "string" ? generation.response.trim() : "";
  if (!generatedAnswer) return json({ error: "generation_failed" }, 502);

  const references = sources.map(({ id, title, url, score }) => ({ id, title, url, score }));
  console.log(JSON.stringify({
    event: "grounded_answer",
    customer: scope.customer,
    namespace: scope.namespace,
    category: input.category,
    sourceIds: references.map((source) => source.id),
    sourceCount: references.length
  }));
  return json({
    mode: "grounded",
    generated: true,
    model: ANSWER_MODEL,
    answer: generatedAnswer,
    sources: references
  });
}

export default {
  async fetch(request, env) {
    const url = new URL(request.url);
    if (request.method === "POST" && url.pathname === "/seed") return seed(env);
    if (request.method === "POST" && url.pathname === "/answer") return answer(request, env);
    return json({ error: "not_found" }, 404);
  }
};
JS
answer() の処理順に注目してください。サーバーが所有するスコープを検証し、質問を埋め込み、対象となる一致結果を最大 2 件取得し、各 ID を CORPUS で解決し、サイズを制限したコンテキストを作成してから生成します。公開レスポンスには完全なコンテキストテキストとベクトル値を含めず、解決可能なソース参照だけを残します。
決定的なテストスイートを実行します。
node --test test/worker.test.mjs
7 件のテストがすべて成功するはずです。偽のバインディングにより、未知の ID と空の検索結果がテキスト生成に渡らないことを確認できます。バインディング型を生成し、デプロイせずにプロジェクトをバンドルします。
npx wrangler types
npx wrangler deploy --dry-run --outdir /tmp/v05-dry-run
生成された型には AI: Ai と DOCUMENTS: VectorizeIndex が含まれるはずです。ドライランによってファイルを一緒にバンドルできることを確認できます。ただし、クラウドリソースの作成や、どちらかのモデルの実行は行いません。
準備済みインデックスを作成してデプロイする
このステップでは、互換性のある Vectorize インデックスを作成し、category をフィルタリングに使用できるよう準備して、その準備が安定した後に Worker をデプロイします。
BGE Small で使用する 384 次元の cosine インデックスを作成します。--update-config=false により、確認済みの明示的なバインディングを Wrangler が書き換えないようにします。
npx wrangler vectorize create "$INDEX" --dimensions=384 --metric=cosine --update-config=false
category 用の string metadata インデックスを作成し、返された mutation ID を保存します。set -o pipefail により、tee が出力のコピーも作成する場合でも、Wrangler が失敗したときにパイプライン全体が失敗します。
set -o pipefail
npx wrangler vectorize create-metadata-index "$INDEX" \
  --propertyName=category \
  --type=string 2>&1 | tee .labex/category-index-output.txt
META_MUTATION=$(grep -Eo '[0-9a-fA-F]{8}-[0-9a-fA-F-]{27}' .labex/category-index-output.txt | tail -n 1)
if [ -z "$META_MUTATION" ]; then
  printf '%s\n' 'No metadata mutation ID was returned; fix the command before continuing.' >&2
else
  printf '%s\n' "$META_MUTATION" | tee .labex/category-mutation.txt
fi
受け付けられた mutation は、キューに入った処理です。正確な mutation と vector count が 3 回連続した読み取りで確認できるまで待つ、範囲を限定した読み取り専用の待機スクリプトを作成します。
cat > scripts/wait-for-vectorize.mjs <<'JS'
import { execFileSync } from "node:child_process";
import { readFileSync } from "node:fs";

const [indexName, mutationFile, expectedText] = process.argv.slice(2);
const mutationId = readFileSync(mutationFile, "utf8").trim();
const expectedCount = Number(expectedText);
if (!/^[0-9a-f-]{36}$/i.test(mutationId)) throw new Error("mutation file has no UUID");
if (!Number.isInteger(expectedCount) || expectedCount < 0) throw new Error("expected count is invalid");
const wrangler = "./node_modules/wrangler/bin/wrangler.js";
let consecutiveMatches = 0;

for (let attempt = 1; attempt <= 120; attempt += 1) {
  const output = execFileSync(process.execPath, [wrangler, "vectorize", "info", indexName, "--json"], { encoding: "utf8" });
  const info = JSON.parse(output);
  if (String(info.processedUpToMutation) === mutationId && info.vectorCount === expectedCount) consecutiveMatches += 1;
  else consecutiveMatches = 0;
  if (consecutiveMatches === 3) {
    console.log("mutation " + mutationId + " is consistently readable with " + expectedCount + " vectors");
    console.log(JSON.stringify(info, null, 2));
    process.exit(0);
  }
  await new Promise((resolve) => setTimeout(resolve, 2000));
}
throw new Error("mutation " + mutationId + " was not stable within four minutes");
JS
node scripts/wait-for-vectorize.mjs "$INDEX" .labex/category-mutation.txt 0
個別の一覧表示は、処理済み mutation の状態より遅れて更新されることがあります。そのため、表示される行についてもしばらく待ちます。
for attempt in {1..15}; do
  METADATA_INDEXES=$(npx wrangler vectorize list-metadata-index "$INDEX" 2>&1)
  if grep -Eq 'category.*String' <<<"$METADATA_INDEXES"; then
    break
  fi
  sleep 2
done
printf '%s\n' "$METADATA_INDEXES"
grep -Eq 'category.*String' <<<"$METADATA_INDEXES" || {
  printf '%s\n' 'The category metadata index is processed but not yet visible; rerun this read-only check.' >&2
  exit 1
}
最後にデプロイし、公開 Worker URL を保存します。
set -o pipefail
npx wrangler deploy 2>&1 | tee .labex/deploy-output.txt
DEPLOY_URL=$(sed -nE 's#.*(https://[^[:space:]]+\.workers\.dev).*#\1#p' .labex/deploy-output.txt | tail -n 1)
if [ -z "$DEPLOY_URL" ]; then
  printf '%s\n' 'No workers.dev URL was returned; fix deployment before continuing.' >&2
else
  printf '%s\n' "$DEPLOY_URL" | tee .labex/deploy-url.txt
fi
この時点で、インデックスはまだ空です。デプロイによってバインディングは接続されますが、埋め込みやソースレコードが自動的に作成されるわけではありません。
承認済みソース corpus をシードする
このステップでは、用意されている 3 件の記事のライブ埋め込みを作成し、すべてのソース ID を読み取れるようになるまで待ちます。
ソーステキストは CORPUS に保持されます。vector レコードには、互換性のある埋め込みと小さな検索用 metadata が含まれます。この分離により、アプリケーションは vector metadata から任意のテキストを信頼するのではなく、ID を承認済みの記事本文に解決できます。
固定の seed エンドポイントを 1 回呼び出します。
DEPLOY_URL=$(cat .labex/deploy-url.txt)
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/seed" \
  -H 'content-type: application/json' \
  --data '{}' | tee .labex/seed-response.json
node -e '
  const value = JSON.parse(require("fs").readFileSync(".labex/seed-response.json", "utf8"));
  if (!/^[0-9a-f-]{36}$/i.test(value.mutationId)) throw new Error("seed mutation is missing");
  require("fs").writeFileSync(".labex/seed-mutation.txt", value.mutationId + "\n");
  console.log("accepted " + value.count + " source vectors in mutation " + value.mutationId);
'
3 件のレコード、384 次元、cls pooling、mutation UUID が表示されるはずです。正確な状態になるまで待ち、その後、別のインベントリ表示に 3 件すべての ID が現れるまで少し待ちます。
node scripts/wait-for-vectorize.mjs "$INDEX" .labex/seed-mutation.txt 3
for attempt in {1..15}; do
  VECTOR_LIST=$(npx wrangler vectorize list-vectors "$INDEX" --count=10 2>&1)
  if grep -q 'password-reset' <<<"$VECTOR_LIST" &&
     grep -q 'mfa-recovery' <<<"$VECTOR_LIST" &&
     grep -q 'billing-receipt' <<<"$VECTOR_LIST"; then
    break
  fi
  sleep 2
done
printf '%s\n' "$VECTOR_LIST"
for id in password-reset mfa-recovery billing-receipt; do
  grep -q "$id" <<<"$VECTOR_LIST" || {
    printf 'The processed source %s is not visible in the list yet; rerun this read-only check.\n' "$id" >&2
    exit 1
  }
done
これで各 ID は、検索結果を CORPUS 内の正確な 1 件の記事に結び付けます。インデックスには files の記事を意図的に入れていません。そのため、類似度のしきい値に依存せず、証拠なしの分岐を確認できます。
Grounded 回答と証拠なしの回答を比較する
このステップでは、サポート対象の質問を 1 件と、承認された category にソースが存在しない質問を 1 件送信します。この違いによって、RAG の制御フローを確認できます。
blue アカウントのスコープ内で、期限切れのパスワードをリセットする方法を質問します。
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/answer" \
  -H 'content-type: application/json' \
  -H 'x-lab-session: blue-session' \
  --data '{"question":"How do I reset my expired password?","category":"account"}' \
  | tee .labex/grounded-answer.json
mode: grounded、generated: true、空ではない回答、そして password-reset を先頭とする sources 配列が返るはずです。モデルによって回答文は異なる場合があります。安定して確認できる点は、返された ID、title、URL がすべて用意された corpus で解決でき、承認済みの account パッセージだけがプロンプトに入っていることです。
次に、同じサーバー管理の customer スコープを維持したまま、ファイルのアップロードについて質問します。files は許可された category ですが、この corpus には対象となる file レコードがありません。
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/answer" \
  -H 'content-type: application/json' \
  -H 'x-lab-session: blue-session' \
  --data '{"question":"How do I upload a PDF?","category":"files"}' \
  | tee .labex/no-evidence-answer.json
mode: no_evidence、generated: false、固定メッセージ I don't have enough approved evidence to answer that question.、sources: [] が返るはずです。Worker は検索のために質問を埋め込みましたが、承認済みのコンテキストがなかったため、テキスト生成はスキップしました。
namespace を自分で指定する安全でないリクエストを 1 件試します。
curl --silent --show-error \
  -o .labex/override-response.json \
  -w 'HTTP %{http_code}\n' \
  -X POST "$DEPLOY_URL/answer" \
  -H 'content-type: application/json' \
  -H 'x-lab-session: blue-session' \
  --data '{"question":"Help","category":"account","namespace":"customer-green"}'
cat .labex/override-response.json
HTTP 400 と scope_override_not_allowed が返るはずです。RAG は、V04 で学んだ認可境界を置き換えるものではありません。テキストをモデルのコンテキストにする前に、検索自体を安全にする必要があります。
Workers & Pages → labex-c08-v05-... Worker → Bindings を開きます。AI が Workers AI を指し、DOCUMENTS が対応する Vectorize インデックスを指していることを確認してください。この画面で、コード内の 2 つのサービス名と、実際に管理されているリソースの対応関係を確認できます。
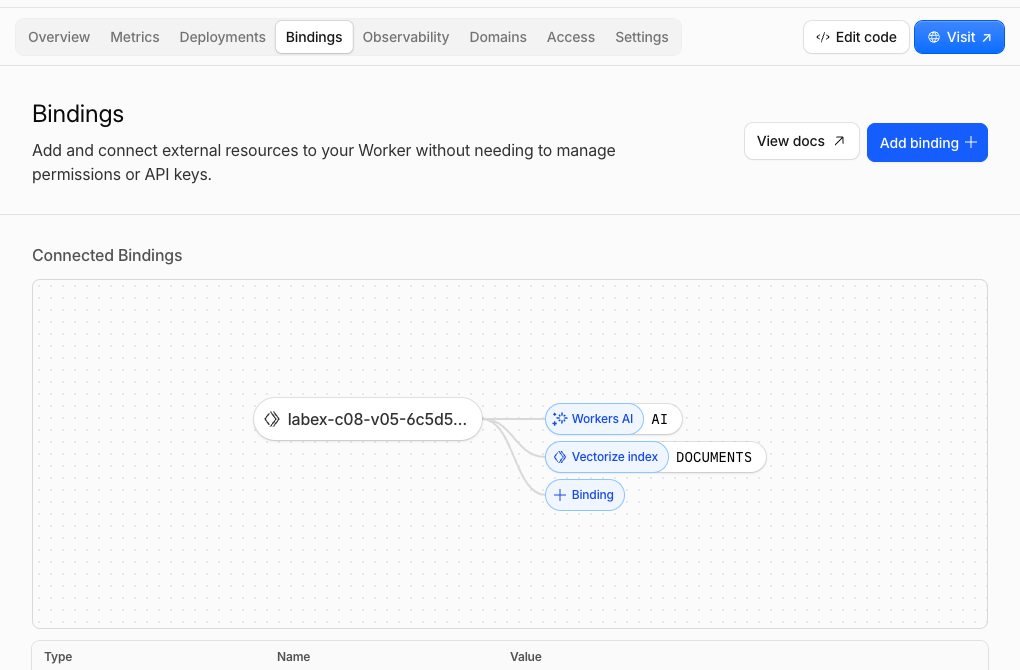
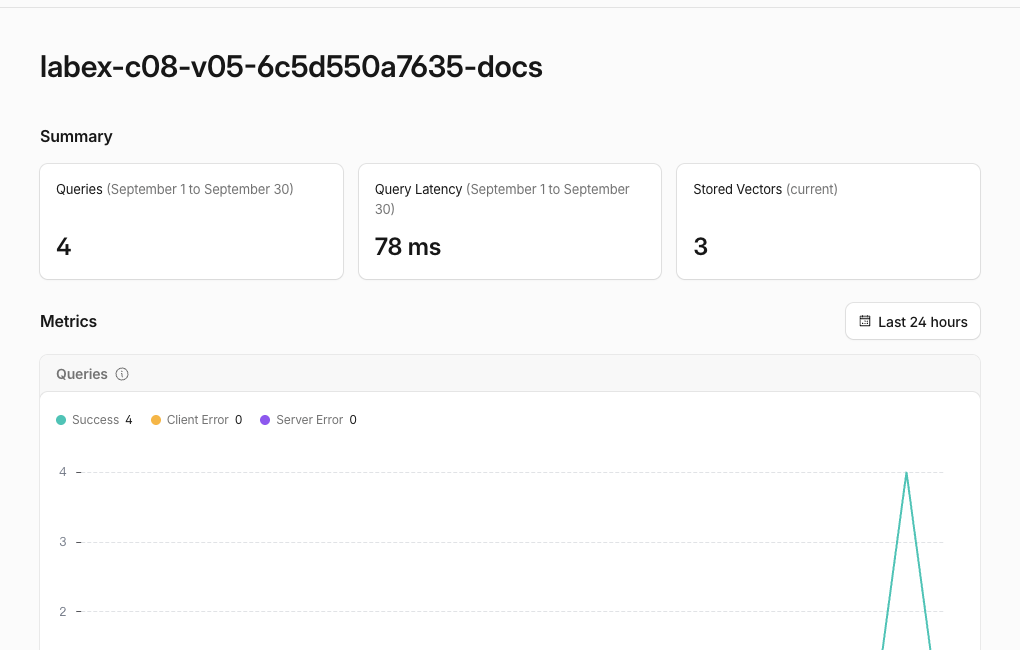
次に、AI → Vectorize → 対応する -docs インデックスを開きます。現在の件数は最終的に 3 vector になるはずです。また、クエリのアクティビティには、grounded 検索と証拠なしの検索が反映されます。Dashboard のメトリクスは遅れて更新される場合があるため、認証済みの ID 読み取りとエンドポイントのレスポンスを正式な確認結果として扱います。
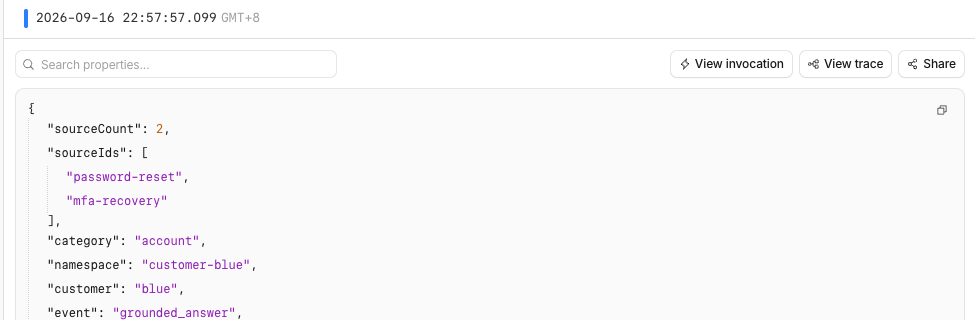
Workers Logs が利用できる場合は、Observability → Logs を開き、grounded_answer と grounded_no_evidence のエントリを確認します。ログには category、ソース ID、件数が含まれますが、質問、回答、パッセージ本文、セッションラベル、vector 値は含まれません。これにより、プロンプトをログにコピーせず、運用担当者が制御フローを確認できます。
Grounded-Answer リソースを削除する
このステップでは、使い捨ての Worker と Vectorize インデックスを削除し、Wrangler の認証が有効な間に、それらが存在しないことを確認します。
以前のターミナルセッションの変数に依存しないように、wrangler.jsonc から正確な名前を取得します。
RUN=$(node -p 'JSON.parse(require("fs").readFileSync("wrangler.jsonc", "utf8")).name')
INDEX=$(node -p 'JSON.parse(require("fs").readFileSync("wrangler.jsonc", "utf8")).vectorize.find((item) => item.binding === "DOCUMENTS").index_name')
printf 'Worker: %s\nIndex: %s\n' "$RUN" "$INDEX"
両方の値が、一意の labex-c08-v05-... プレフィックスを使用していることを確認します。まず Worker を削除し、デプロイ済みコードがバインディングを保持しないようにします。その後、対応するインデックスだけを削除します。
npx wrangler delete --name "$RUN" --force
npx wrangler vectorize delete "$INDEX" --force
認証済みのインデックス一覧を保存し、正確な名前が存在しないことを確認します。
npx wrangler vectorize list --json > .labex/indexes-after-cleanup.json
node -e '
  const rows = JSON.parse(require("fs").readFileSync(process.argv[1], "utf8"));
  if (rows.some((row) => row.name === process.argv[2])) throw new Error("lab index still exists");
  console.log("lab index is absent");
' .labex/indexes-after-cleanup.json "$INDEX"
ログアウトする前に、このチェックを完了してください。ネットワークエラーや認証エラーでは、削除できたとは判断できません。評価では、アカウントの読み取りが成功し、正確な名前が存在しないことが別途確認されます。
学習用 VM からログアウトする
このステップでは、この VM に一時的に保存された Wrangler の認証を削除します。クラウドリソースはすでに存在せず、認証済みのクリーンアップチェックも成功しています。
npx wrangler logout
npx wrangler whoami --json
loggedIn: false と表示されるはずです。Cloudflare Dashboard のブラウザーセッションは別のものであり、学習用アカウントでは引き続き利用できます。
まとめ
小規模な retrieval-augmented generation エンドポイントを構築しました。サーバーが制御するスコープによって Vectorize の検索範囲を限定し、返された ID を承認済み corpus で解決し、最大 2 件のパッセージだけをモデルのコンテキストに入れ、生成された文章が変動しても安定したソース参照を回答と一緒に返しました。
また、対象となる検索結果が空の場合は、テキスト生成を実行せず、固定された証拠なしの分岐に進むことを確認しました。検索前にクライアントからのスコープ上書きを拒否し、Worker、Vectorize、プライバシーを考慮した observability の関係を確認し、認証状態のまま両方の使い捨てリソースを削除してからログアウトしました。コースのチャレンジでは、同じスコープ境界に違反する壊れたエンドポイントを修正します。