



はじめに
AI モデルは一時的に利用できなくなったり、過負荷になったり、理解できない入力を受け取ったりすることがあります。フォールバックを用意すると、アプリケーションはすぐにエラーを返す代わりに、あらかじめ決めた代替手段を使えます。実用的なフォールバックには上限があります。短い順序付きリストと明確な停止条件を持ち、無限に再試行したり、最初の成功後にすべてのモデルを呼び出したりしてはいけません。
この実験では、2 つの経路を持つ小さな Cloudflare Worker をデプロイします。フォールバック経路では、チャット形式の入力を意図的に embedding モデルへ送り、予測可能な互換性エラーを捕捉した後、1 つのチャットモデルを呼び出します。正常経路では、互換性のあるプライマリチャットモデルを呼び出して終了します。すべての試行は同じ AI Gateway を通るため、ログからどのモデルが失敗し、どのモデルがリクエストを完了したかを確認できます。
このコースを直接開いた場合は、まず LabEx を Cloudflare アカウントに接続する を完了してください。LabEx ターミナル、Wrangler のデバイス認証、アカウント選択、アカウント ID について学べます。また、この実験はゲートウェイと Workers AI の概念を基にしているため、先に ゲートウェイ経由で推論をルーティングする も完了してください。
この実験では、Cloudflare がホストする Workers AI モデルと Workers AI binding を使用します。Workers Paid、外部プロバイダーのキー、非推奨の Universal Endpoint は必要ありません。制御された失敗試行は推論の前に拒否され、各成功経路は短い応答だけを生成します。共有の Workers AI 1 日割り当てが利用できない場合は、再試行を繰り返さずに停止してください。
セットアップでは、Node.js 22.22.0 とプロジェクトローカルの Wrangler 4.132.0 を /home/labex/project/ai-gateway-fallback にインストールします。独立したチェックを準備しますが、Wrangler の認証、クラウドリソースの作成、Worker のデプロイ、モデルへのトラフィック送信は行いません。LabEx は実験終了後に VM を破棄しますが、リモートの Worker、ゲートウェイ、API トークンは残るため、自分で削除してください。
VM を認証して復旧経路に名前を付ける
各実験は新しい VM で開始します。このステップでは、学習用アカウントで Wrangler を使用できるように認証し、1 つのゲートウェイ、1 つの Worker、1 つの一時トークンに一意の名前を付けて保存します。
cd /home/labex/project/ai-gateway-fallback
npx wrangler --version
npx wrangler login --device --browser=false
表示されたリンクを開き、コードを入力して、使用する学習用アカウントを認証します。Wrangler は、この実験の後続ステップに必要な Worker のデプロイ権限と Workers AI 権限を要求します。承認する前に、表示されたアカウントが正しいことを確認してください。その後、構造化された ID 情報を確認します。
npx wrangler whoami --json
Wrangler 4.132.0 と loggedIn: true が表示されることを確認します。YOUR_ACCOUNT_ID を、対象アカウントに表示された実際の 32 文字の ID に置き換えてください。
GATEWAY_ID="labex-c09-g05-$(openssl rand -hex 6)"
WORKER_NAME="${GATEWAY_ID/g05/g05-worker}"
TOKEN_NAME="$GATEWAY_ID-token"
cat > .labex/state.json <<JSON
{
  "accountId": "YOUR_ACCOUNT_ID",
  "gatewayId": "$GATEWAY_ID",
  "workerName": "$WORKER_NAME",
  "tokenName": "$TOKEN_NAME"
}
JSON
cat .labex/state.json
これらの識別子は秘密情報ではありません。保存しておくと、後の検証とクリーンアップで、この実験のリソースだけを対象にできます。
観測可能な AI Gateway を作成する
このステップでは、2 つのモデル経路を記録する共通のチェックポイントを作成します。
AI Gateway は、アプリケーションとモデル呼び出しの間に置く名前付きのチェックポイントです。アプリケーションがモデルを切り替えても、複数の試行についてログとメタデータを 1 か所に集められます。
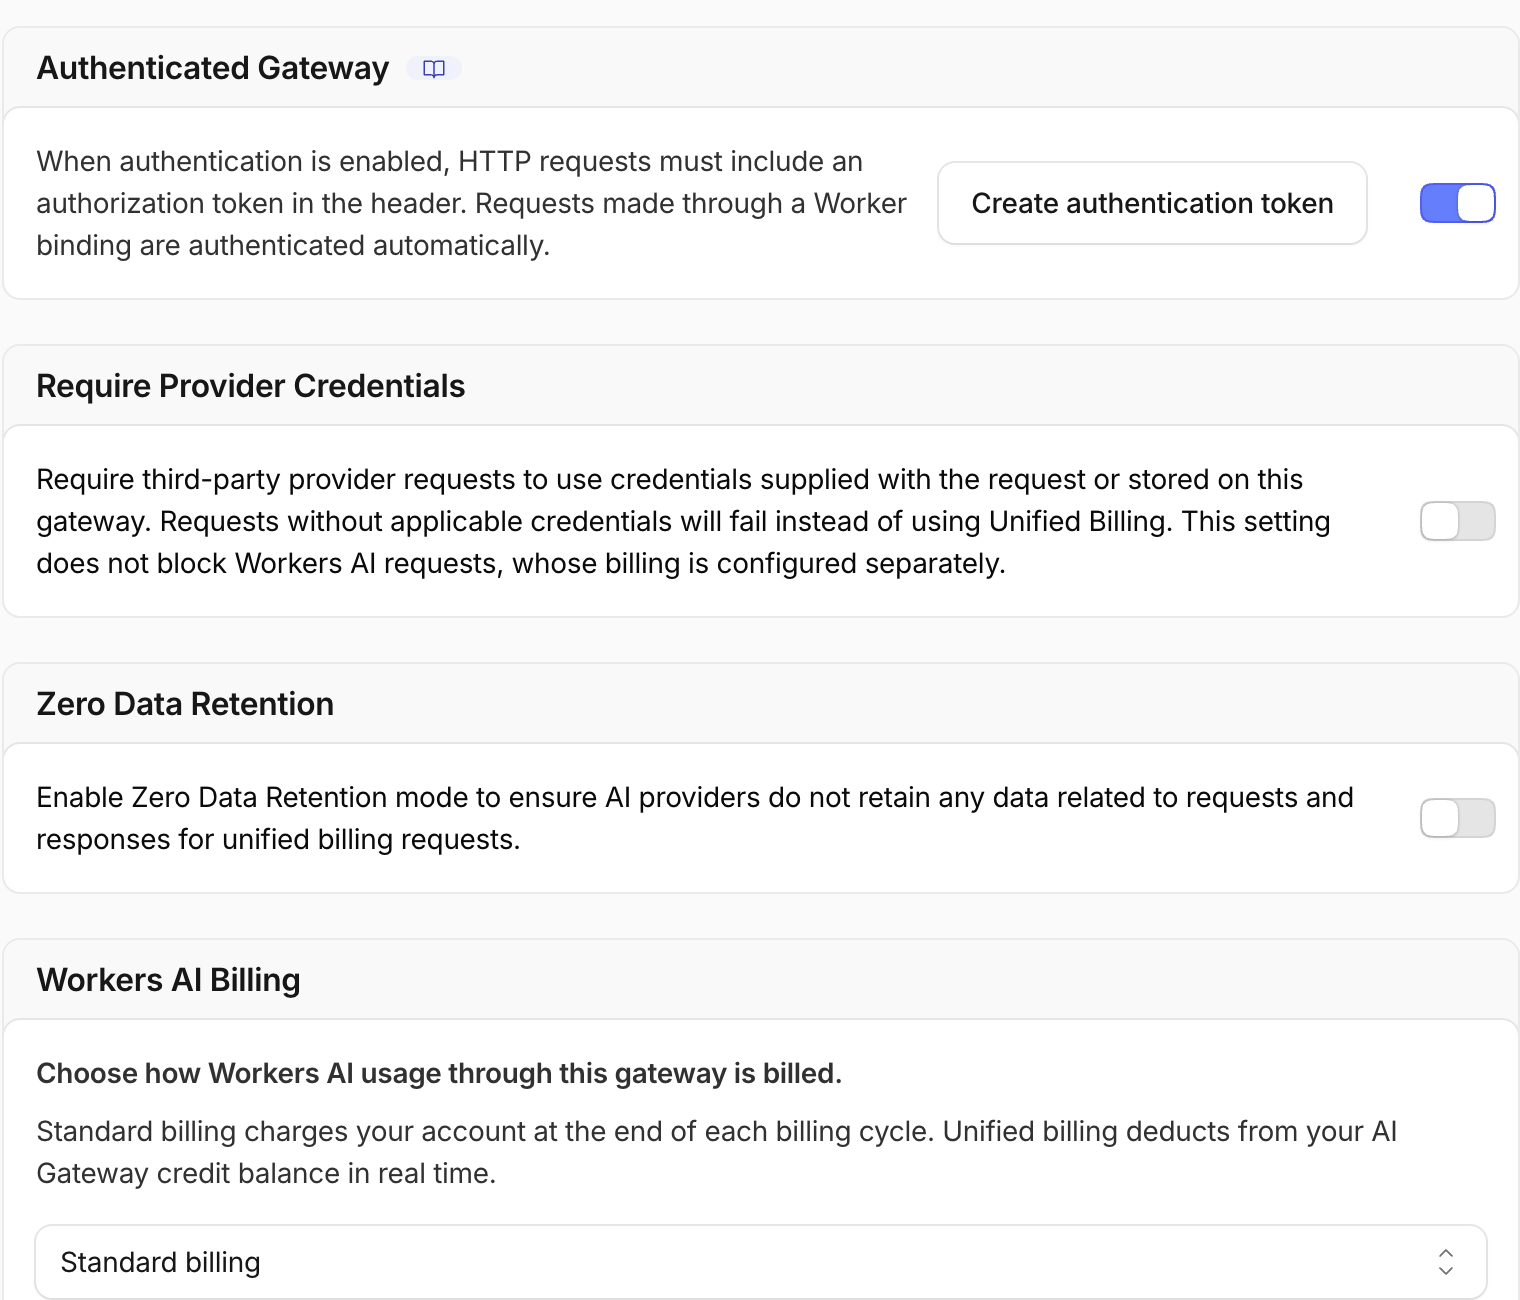
Cloudflare Dashboard を開き、AI → AI Gateway → Create a custom gateway を選択します。保存した gatewayId を使用してください。Collect Logs と Authenticated Gateway は有効なままにします。キャッシュ、レート制限、再試行、支出上限は無効のままにし、Workers AI の課金設定は Standard のままにします。その後、ゲートウェイを作成します。
My Profile → API Tokens を開き、Create Token → Create Custom Token を選択して、保存した tokenName を使用します。対象の学習用アカウントに限定して、アカウント権限 AI Gateway — Edit と AI Gateway — Run を追加します。この一時トークンを使うと、この実験のゲートウェイだけを読み取り、後で削除できます。デプロイする Worker にトークンを埋め込むことはありません。
トークンを作成したら、Cloudflare が一度だけ表示する検証コマンドから、Bearer の後ろにある値だけをコピーし、非表示入力で保存します。
bash -c '
while :; do
  read -ersp "Paste the AI Gateway token: " GATEWAY_TOKEN
  printf "\n"
  [ -n "$GATEWAY_TOKEN" ] && break
  printf "Token cannot be empty; paste it again.\n" >&2
done
umask 077
printf "%s" "$GATEWAY_TOKEN" > .labex/gateway-token
unset GATEWAY_TOKEN
chmod 600 .labex/gateway-token
'
重要な非秘密設定だけを読み取ります。
ACCOUNT_ID=$(node -p 'JSON.parse(require("fs").readFileSync(".labex/state.json")).accountId')
GATEWAY_ID=$(node -p 'JSON.parse(require("fs").readFileSync(".labex/state.json")).gatewayId')
GATEWAY_TOKEN=$(cat .labex/gateway-token)
curl --http1.1 -fsS -H "Authorization: Bearer $GATEWAY_TOKEN" \
  "https://api.cloudflare.com/client/v4/accounts/$ACCOUNT_ID/ai-gateway/gateways/$GATEWAY_ID" \
  > .labex/gateway.json
unset GATEWAY_TOKEN
node -e 'const g=require("./.labex/gateway.json").result; console.log({id:g.id,collect_logs:g.collect_logs,authentication:g.authentication})'
保存したゲートウェイ ID と、両方の値が true になっていることを確認します。
2 回の試行を行う Worker を定義する
このステップでは、通常の Worker コードで復旧ポリシーを記述します。ループではなく、明示的な 2 回の呼び出しで構成するため、最大コストとレイテンシーを把握しやすくなります。
フォールバック経路の最初の呼び出しでは embedding モデルを使用します。Embedding モデルはテキストを数値ベクトルに変換するもので、チャットの messages は受け付けません。チャット形式の入力を渡すと、推論前に安全で決定的な互換性エラーが発生します。catch ブロックはそのエラーを記録し、互換性のあるチャットモデルを 1 回呼び出します。
GATEWAY_ID=$(node -p 'JSON.parse(require("fs").readFileSync(".labex/state.json")).gatewayId')
WORKER_NAME=$(node -p 'JSON.parse(require("fs").readFileSync(".labex/state.json")).workerName')
cat > wrangler.jsonc <<JSON
{
  "name": "$WORKER_NAME",
  "main": "src/index.js",
  "compatibility_date": "2026-09-17",
  "ai": { "binding": "AI" }
}
JSON
cat > src/index.js <<JS
export default {
  async fetch(request, env) {
    const healthy = new URL(request.url).pathname === "/healthy";
    const attempts = [];
    const gateway = {
      gateway: {
        id: "$GATEWAY_ID",
        metadata: {
          lab: "g05-fallback",
          mode: healthy ? "healthy" : "fallback",
          synthetic: true
        }
      }
    };

    if (!healthy) {
      try {
        await env.AI.run(
          "@cf/baai/bge-small-en-v1.5",
          { messages: [{ role: "user", content: "Reply with ROUTE OK" }] },
          gateway
        );
        attempts.push({ model: "@cf/baai/bge-small-en-v1.5", status: "unexpected-success" });
      } catch (error) {
        attempts.push({
          model: "@cf/baai/bge-small-en-v1.5",
          status: "failed",
          reason: String(error).slice(0, 180)
        });
      }
    }

    const selectedModel = healthy
      ? "@cf/meta/llama-3.3-70b-instruct-fp8-fast"
      : "@cf/meta/llama-3.2-3b-instruct";
    const result = await env.AI.run(
      selectedModel,
      { prompt: "Reply with exactly: ROUTE OK", max_tokens: 12 },
      gateway
    );
    attempts.push({ model: selectedModel, status: "succeeded" });

    return Response.json({
      mode: healthy ? "healthy-primary" : "fallback-recovery",
      usedFallback: !healthy,
      selectedModel,
      attempts,
      response: result.response
    });
  }
};
JS
npx wrangler deploy --dry-run
AI binding によって、Worker から Workers AI に直接アクセスできます。gateway オプションは各呼び出しを保存したゲートウェイ経由でルーティングし、プロンプト、認証情報、個人識別子を含まない合成メタデータだけを付加します。
デプロイしてフォールバック経路を実行する
このステップでは、Worker をデプロイし、制御された復旧ケースを 1 回だけ実行します。
Worker をデプロイし、アカウントに割り当てられた正確な URL をテストで使用できるように、Wrangler の出力を保存します。
npx wrangler deploy 2>&1 | tee .labex/deploy-output.txt
WORKER_URL=$(grep -Eo 'https://[^ ]+\.workers\.dev' .labex/deploy-output.txt | tail -1)
printf '%s\n' "$WORKER_URL" | tee .labex/worker-url.txt
デプロイが成功しても、workers.dev の経路が伝播するまで数秒かかる場合があります。追加のモデルトラフィックを送信せずに URL をポーリングします。404 はエッジ経路がまだ準備できていないことを示すだけで、ループは最初の 200 応答で停止します。
WORKER_URL=$(cat .labex/worker-url.txt)
for attempt in $(seq 1 12); do
  STATUS=$(curl --http1.1 -sS -o .labex/fallback-response.json -w '%{http_code}' "$WORKER_URL/fallback")
  printf 'attempt %s: HTTP %s\n' "$attempt" "$STATUS"
  [ "$STATUS" = 200 ] && break
  [ "$attempt" -eq 12 ] && exit 1
  sleep 5
done
python3 -m json.tool < .labex/fallback-response.json
usedFallback: true、2 回の試行、embedding モデルの failed、@cf/meta/llama-3.2-3b-instruct の succeeded を確認します。生成された文言の完全一致は採点対象ではありません。採点対象は経路の判断です。
正常なプライマリが早期終了することを証明する
このステップでは、プライマリモデルが成功すると不要なフォールバック呼び出しが発生しないことを確認します。
フォールバックは、プライマリ経路が正常に動作しているときには介入しない場合にのみ正しく機能します。/healthy 経路は互換性のあるチャットモデルから開始するため、1 回の試行だけを実行して終了するはずです。
WORKER_URL=$(cat .labex/worker-url.txt)
curl --http1.1 -fsS "$WORKER_URL/healthy" \
  | tee .labex/healthy-response.json \
  | python3 -m json.tool
usedFallback: false、selectedModel が @cf/meta/llama-3.3-70b-instruct-fp8-fast、成功した試行が正確に 1 回であることを確認します。これが short-circuit 動作です。成功すると、経路は直ちに終了します。
Gateway のログから経路を読み取る
このステップでは、Worker の JSON 結果を AI Gateway の独立した証拠と照合します。
Worker のレスポンスはアプリケーションの動作を示します。AI Gateway のログは、プロバイダー側の独立した証拠になります。ログが表示されるまで数秒かかる場合があるため、少し待ってからルーティングに関係するフィールドだけを出力します。
sleep 8
ACCOUNT_ID=$(node -p 'JSON.parse(require("fs").readFileSync(".labex/state.json")).accountId')
GATEWAY_ID=$(node -p 'JSON.parse(require("fs").readFileSync(".labex/state.json")).gatewayId')
GATEWAY_TOKEN=$(cat .labex/gateway-token)
curl --http1.1 -fsS -H "Authorization: Bearer $GATEWAY_TOKEN" \
  "https://api.cloudflare.com/client/v4/accounts/$ACCOUNT_ID/ai-gateway/gateways/$GATEWAY_ID/logs?per_page=50" \
  > .labex/logs.json
unset GATEWAY_TOKEN
node - <<'NODE'
const rows=require('./.labex/logs.json').result||[];
const meta=row=>{try{return typeof row.metadata==='string'?JSON.parse(row.metadata):(row.metadata||{})}catch{return {}}};
console.table(rows.filter(row=>meta(row).lab==='g05-fallback').map(row=>({
  mode:meta(row).mode, model:row.model, success:row.success, status:row.status_code
})));
NODE
Dashboard でゲートウェイの Logs ページを開きます。フォールバックグループには、失敗した embedding モデルの行と、成功したフォールバックモデルの行が含まれているはずです。正常グループには、成功したプライマリチャットモデルだけが含まれているはずです。
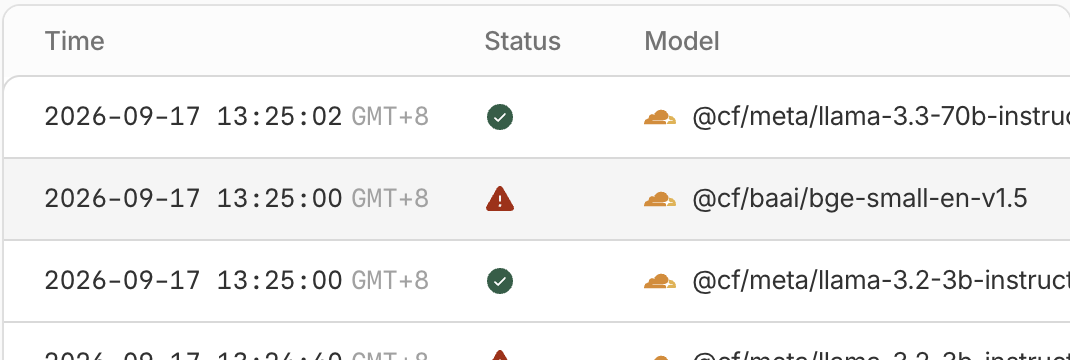
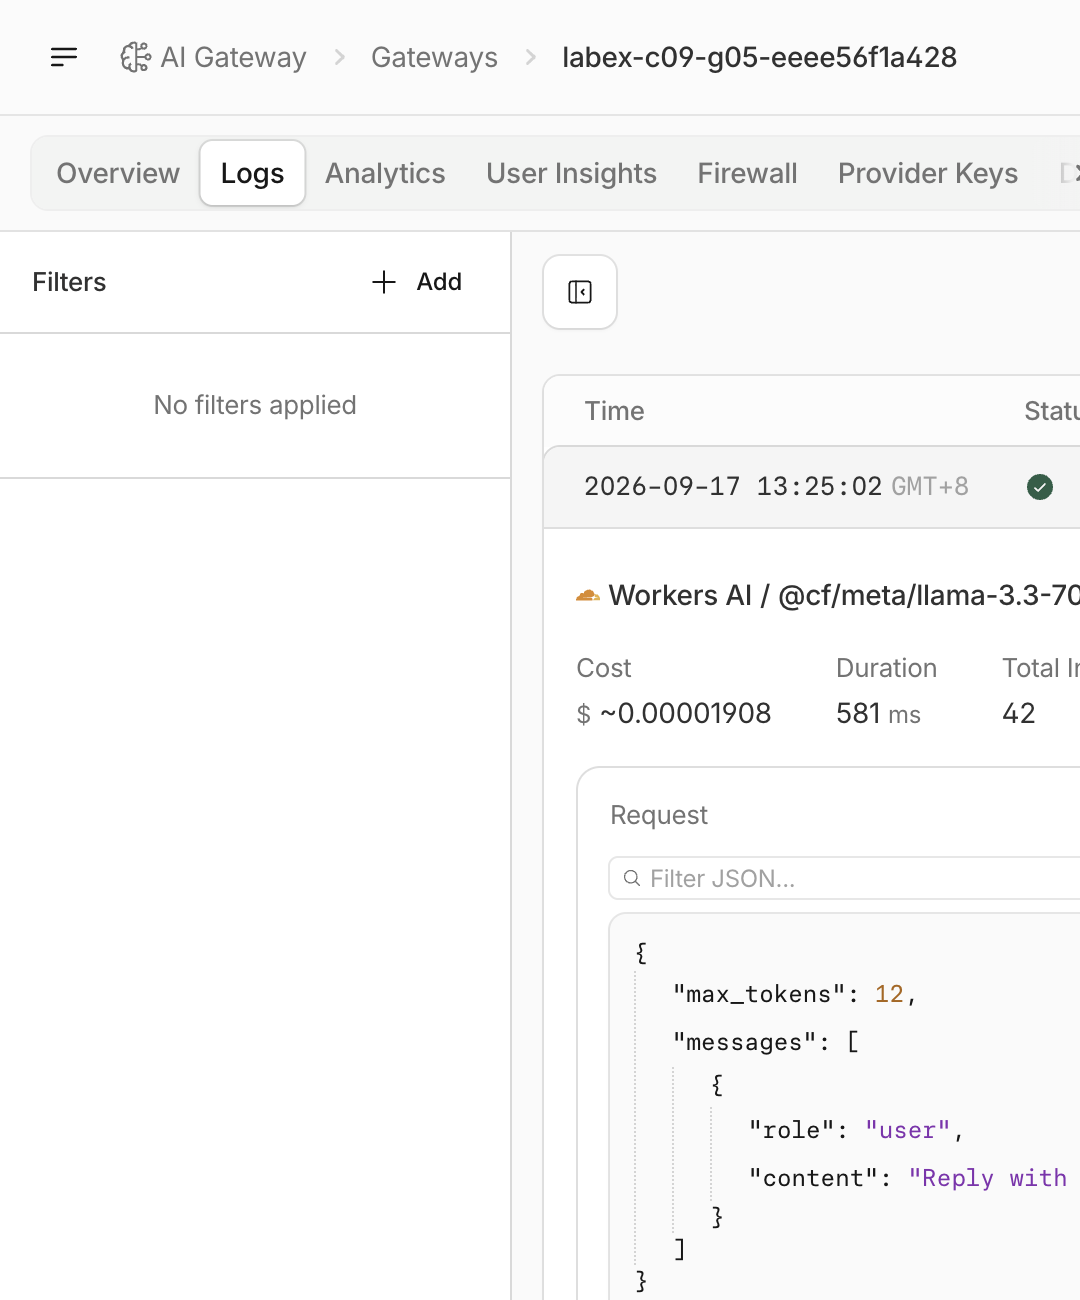
mode メタデータによって、プロンプトや秘密情報を含めずにログ行を関連付けられます。経路を説明するのはモデル、成功可否、ステータスであり、生成された文章だけでは判断できません。
上限付き復旧の契約を確認する
このステップでは、両方の経路を比較し、モデル試行回数の最大値を確認します。
ここまでに、互いに一致する 3 種類の証拠がそろっています。
- ソースには明示的な
env.AI.run()呼び出しが 2 つあり、再試行ループはありません。 /fallbackは 1 回の失敗に続いて 1 回の成功を報告します。/healthyは 1 回の成功を報告して停止します。
保存したレスポンスから、簡潔な比較を表示します。
node - <<'NODE'
for (const name of ['fallback','healthy']) {
  const body=require(`./.labex/${name}-response.json`);
  console.log(name, {
    usedFallback: body.usedFallback,
    selectedModel: body.selectedModel,
    attemptCount: body.attempts.length,
    statuses: body.attempts.map(item=>item.status)
  });
}
NODE
最大試行回数は 2 回です。フォールバックも失敗した場合、Worker は経路を再開せずにエラーを返します。本番アプリケーションではタイムアウト、サーキットブレーカー、ユーザー向けエラーを追加することもできますが、追加する復旧メカニズムもそれぞれ独立して上限を持ち、観測可能である必要があります。
使い捨てのリソースを削除する
このステップでは、この実験が所有するすべてのリモートリソースを削除し、ローカルの認証情報も削除します。
まず Worker を削除して、新しいゲートウェイトラフィックを生成できないようにします。次に、state.json に記録されたゲートウェイだけを削除します。
ACCOUNT_ID=$(node -p 'JSON.parse(require("fs").readFileSync(".labex/state.json")).accountId')
GATEWAY_ID=$(node -p 'JSON.parse(require("fs").readFileSync(".labex/state.json")).gatewayId')
WORKER_NAME=$(node -p 'JSON.parse(require("fs").readFileSync(".labex/state.json")).workerName')
GATEWAY_TOKEN=$(cat .labex/gateway-token)
npx wrangler delete --name "$WORKER_NAME" --force
curl --http1.1 -fsS -X DELETE \
  -H "Authorization: Bearer $GATEWAY_TOKEN" \
  "https://api.cloudflare.com/client/v4/accounts/$ACCOUNT_ID/ai-gateway/gateways/$GATEWAY_ID" \
  > .labex/delete-gateway.json
unset GATEWAY_TOKEN
node -p 'require("./.labex/delete-gateway.json").success'
true が表示されることを確認します。2 つの一時認証情報がまだこの VM に存在する間に、Worker とゲートウェイが存在しないことを示す独立した証拠を保存します。
set +e
npx wrangler deployments list --name "$WORKER_NAME" --json \
  > .labex/worker-after-delete.json 2> .labex/worker-absent.err
printf '%s\n' "$?" > .labex/worker-absent-status.txt
set -e
GATEWAY_TOKEN=$(cat .labex/gateway-token)
curl --http1.1 -fsS -H "Authorization: Bearer $GATEWAY_TOKEN" \
  "https://api.cloudflare.com/client/v4/accounts/$ACCOUNT_ID/ai-gateway/gateways" \
  > .labex/gateways-after-delete.json
unset GATEWAY_TOKEN
GATEWAY_ID="$GATEWAY_ID" node - <<'NODE'
const rows=require('./.labex/gateways-after-delete.json').result||[];
console.log('gateway absent:', !rows.some(row=>row.id===process.env.GATEWAY_ID));
NODE
grep -Ei '10090|10007|script_not_found|does not exist' .labex/worker-absent.err
gateway absent: true と、script_not_found、コード 10090、コード 10007、または does not exist などの Worker 不在レスポンスを確認します。Wrangler は、同じスクリプト不在エラーでも異なる形式を返す場合があります。ネットワークエラーや認証エラーは削除の証拠になりません。
次に、My Profile → API Tokens を開き、保存した正確な tokenName のトークンを削除します。最後に、VM 内のコピーを削除してログアウトします。
shred -u .labex/gateway-token
npx wrangler logout
npx wrangler whoami --json
loggedIn: false が表示されることを確認します。後で VM を削除すればローカルファイルも消えますが、リモートリソースの削除と認証の取り消しを行うのは、ここで実行したコマンドだけです。
まとめ
Cloudflare がホストする 2 つのモデルを使って、上限付きの復旧経路を構築しました。互換性のないプライマリの試行を制御された形で失敗させ、1 つのフォールバックモデルでリクエストを復旧し、正常なプライマリでは 1 回の呼び出しで停止しました。AI Gateway のログによって、アプリケーションの判断と、プロバイダー側に記録されたモデルおよびステータスの証拠を関連付けました。また、明示的な試行回数の制限、安全なメタデータ、検証済みのクリーンアップが、信頼性の高いフォールバック設計に必要である理由も学びました。


