Introduction
V03 transformait une question en embedding et récupérait les articles d'aide les plus proches. Toutefois, un véritable système de support sert généralement plusieurs clients. La similarité sémantique ne doit donc jamais décider à elle seule quels documents d'un client un appelant peut consulter.
Dans ce laboratoire, vous allez ajouter deux limites de recherche. Un espace de noms Vectorize est une partition au sein d'un même index. Une recherche dans un espace de noms exclut les vecteurs de tous les autres espaces avant le classement par similarité. Un filtre de métadonnées réduit ensuite cette partition client selon un champ tel que category. Vous pouvez voir l'espace de noms comme le choix du bon classeur, et le filtre de catégorie comme le choix d'un tiroir à l'intérieur de ce classeur.
Aucun de ces mécanismes n'authentifie une personne. L'application doit d'abord valider une connexion, un jeton ou un autre signal d'identité, puis déduire l'espace de noms côté serveur. Pour que l'exercice reste sûr et reproductible, ce Worker utilise deux libellés de session synthétiques publics représentant des sessions déjà validées. Il s'agit de données de test pédagogiques, pas de véritables identifiants ni d'un système d'authentification complet. Une requête ne peut jamais choisir elle-même son client ou son espace de noms.
Vous allez déployer un Worker éphémère avec des bindings Workers AI et Vectorize. Quatre articles synthétiques contiennent volontairement le même texte de mot de passe dans deux espaces de noms clients. Les embeddings générés en temps réel rendent la recherche réaliste, tandis que les vérifications exactes de l'espace de noms, de la catégorie et de l'ID prouvent l'isolation sans évaluer les scores exacts d'un modèle. Vous testerez également un résultat vide autorisé et rejetterez une tentative de remplacement de la portée avant tout appel à l'un ou l'autre service cloud.
Si vous avez accédé directement à ce cours, commencez par terminer Connecter LabEx à votre compte Cloudflare. V01 à V03 sont également des prérequis : ils présentent les index compatibles, les mutations asynchrones et la recherche sémantique.
Le petit index et les requêtes BGE Small limitées respectent les quotas documentés de Workers Free ; Workers Paid n'est pas requis. Les appels au modèle, qu'ils soient locaux ou déployés, consomment tout de même l'allocation quotidienne Workers AI partagée du compte. Si cette allocation n'est pas disponible, arrêtez-vous au lieu de réessayer de manière répétée.
La configuration installe Node.js 22.22.0 et Wrangler 4.132.0, installé dans le projet, dans /home/labex/project/scoped-vector-search. Elle fournit des tests déterministes et des vérifications indépendantes en lecture seule, mais elle n'autorise pas Wrangler, ne crée pas d'index, ne déploie pas de Worker, n'exécute pas d'inférence et n'insère pas de données dans le cloud.
Autoriser et nommer les ressources de recherche cloisonnée
Dans cette étape, vous allez autoriser la VM fraîchement préparée et décrire un Worker ainsi que son index Vectorize associé dans la configuration Wrangler standard.
Accédez au projet préparé et vérifiez la version figée de l'interface CLI :
cd /home/labex/project/scoped-vector-search
npx wrangler --version
La sortie attendue est 4.132.0. L'autorisation via l'appareil permet à la VM de recevoir une autorisation OAuth temporaire sans transmettre votre mot de passe Cloudflare. Les portées demandées couvrent l'identité du compte, l'index éphémère, le déploiement du Worker et le binding Workers AI utilisé pour les embeddings :
npx wrangler login --device --browser=false --scopes account:read user:read workers:write workers_scripts:write workers_kv:write ai:write
npx wrangler whoami --json
Ouvrez le lien affiché dans votre navigateur, saisissez le code actuel et autorisez le compte d'apprentissage prévu. De retour dans le terminal, vérifiez loggedIn: true, authType: OAuth Token et le nom du compte avant de copier son ID.
Générez un suffixe aléatoire, puis dérivez le nom de l'index à partir du nom du Worker. Cette convention de propriété rend le nettoyage ultérieur précis :
RUN="labex-c08-v04-$(openssl rand -hex 6)"
INDEX="$RUN-docs"
printf 'Worker: %s\nIndex:  %s\n' "$RUN" "$INDEX"
Remplacez YOUR_ACCOUNT_ID par l'ID affiché par whoami. Un binding fournit au code du Worker un nom local pour un service Cloudflare : AI créera les embeddings et DOCUMENTS interrogera l'index exact indiqué par index_name.
cat > wrangler.jsonc <<JSON
{
  "\$schema": "./node_modules/wrangler/config-schema.json",
  "name": "$RUN",
  "account_id": "YOUR_ACCOUNT_ID",
  "main": "src/index.js",
  "compatibility_date": "2026-09-16",
  "compatibility_flags": ["nodejs_compat"],
  "workers_dev": true,
  "preview_urls": false,
  "observability": { "enabled": true },
  "ai": { "binding": "AI", "remote": true },
  "vectorize": [
    { "binding": "DOCUMENTS", "index_name": "$INDEX", "remote": true }
  ]
}
JSON
Le fichier nomme les ressources prévues, mais n'en crée encore aucune. Dans un compte d'apprentissage partagé, il est particulièrement important d'expliciter l'identité et la propriété avant toute écriture.
Créer un Worker de recherche cloisonné côté serveur
Dans cette étape, vous allez implémenter la limite avant de la déployer.
L'en-tête x-lab-session utilise uniquement deux libellés publics pour simuler le résultat d'une couche d'authentification précédente. resolveSession associe ce contexte validé à un espace de noms côté serveur. Le corps de la requête peut choisir une question et une catégorie autorisée, mais il ne peut pas indiquer de client ni d'espace de noms. Dans une application de production, remplacez ces libellés par une session ou un fournisseur d'identité correctement vérifié ; un espace de noms organise les données, mais ne constitue pas une authentification.
Les quatre documents contiennent un texte de mot de passe identique pour les clients blue et green. Le résultat de sécurité est ainsi facile à observer : la similarité ne peut pas distinguer les copies, donc seul le périmètre contrôlé par le serveur peut les séparer.
cat > src/index.js <<'JS'
const MODEL = "@cf/baai/bge-small-en-v1.5";
const POOLING = "cls";
const DIMENSIONS = 384;
const ALLOWED_CATEGORIES = new Set(["account", "billing", "files"]);
const SESSION_CONTEXTS = Object.freeze({
  "blue-session": Object.freeze({ customer: "blue", namespace: "customer-blue" }),
  "green-session": Object.freeze({ customer: "green", namespace: "customer-green" })
});

const DOCUMENTS = [
  {
    id: "blue-password",
    namespace: "customer-blue",
    category: "account",
    title: "Reset a password",
    text: "Reset an expired or forgotten password to regain access to your account."
  },
  {
    id: "blue-invoice",
    namespace: "customer-blue",
    category: "billing",
    title: "Download an invoice",
    text: "Download an invoice or receipt for a completed payment."
  },
  {
    id: "green-password",
    namespace: "customer-green",
    category: "account",
    title: "Reset a password",
    text: "Reset an expired or forgotten password to regain access to your account."
  },
  {
    id: "green-upload",
    namespace: "customer-green",
    category: "files",
    title: "Upload a PDF",
    text: "Upload a PDF document and troubleshoot file size or format errors."
  }
];

function json(value, status = 200) {
  return Response.json(value, { status, headers: { "cache-control": "no-store" } });
}

export function resolveSession(label) {
  const context = SESSION_CONTEXTS[label];
  if (!context) throw new Error("session_invalid");
  return context;
}

export function parseSearchInput(value) {
  if (!value || typeof value !== "object" || Array.isArray(value)) throw new Error("invalid_json");
  for (const key of ["customer", "customerId", "namespace"]) {
    if (Object.prototype.hasOwnProperty.call(value, key)) throw new Error("scope_override_not_allowed");
  }
  const query = typeof value.query === "string" ? value.query.trim() : "";
  const category = typeof value.category === "string" ? value.category.trim() : "";
  if (!query || query.length > 200) throw new Error("query_required");
  if (!ALLOWED_CATEGORIES.has(category)) throw new Error("category_invalid");
  return { query, category };
}

export function validateEmbeddingBatch(result, expectedCount) {
  const vectors = result?.data;
  if (!Array.isArray(vectors) || vectors.length !== expectedCount || result?.shape?.[1] !== DIMENSIONS) {
    throw new Error("incompatible embedding batch");
  }
  for (const vector of vectors) {
    if (!Array.isArray(vector) || vector.length !== DIMENSIONS || !vector.every(Number.isFinite)) {
      throw new Error("invalid embedding vector");
    }
  }
  return vectors;
}

async function embed(env, texts) {
  const result = await env.AI.run(MODEL, { text: texts, pooling: POOLING });
  return validateEmbeddingBatch(result, texts.length);
}

async function seed(env) {
  const vectors = await embed(env, DOCUMENTS.map((document) => document.text));
  const records = DOCUMENTS.map((document, index) => ({
    id: document.id,
    namespace: document.namespace,
    values: vectors[index],
    metadata: {
      category: document.category,
      title: document.title,
      model: MODEL,
      pooling: POOLING
    }
  }));
  const mutation = await env.DOCUMENTS.upsert(records);
  console.log(JSON.stringify({ event: "scoped_documents_seeded", count: records.length, mutationId: mutation.mutationId }));
  return json({ mutationId: mutation.mutationId, count: records.length, model: MODEL, dimensions: DIMENSIONS, pooling: POOLING }, 202);
}

async function search(request, env) {
  let context;
  try {
    context = resolveSession(request.headers.get("x-lab-session") ?? "");
  } catch (error) {
    return json({ error: "session_invalid" }, 401);
  }

  let input;
  try {
    input = parseSearchInput(await request.json());
  } catch (error) {
    return json({ error: error instanceof Error ? error.message : "invalid_json" }, 400);
  }

  const [queryVector] = await embed(env, [input.query]);
  const result = await env.DOCUMENTS.query(queryVector, {
    topK: 3,
    namespace: context.namespace,
    filter: { category: input.category },
    returnMetadata: "all"
  });
  const matches = result.matches.map((match) => ({
    id: match.id,
    score: match.score,
    namespace: match.namespace,
    title: match.metadata?.title,
    category: match.metadata?.category
  }));
  console.log(JSON.stringify({
    event: "scoped_search",
    customer: context.customer,
    namespace: context.namespace,
    category: input.category,
    returnedCount: matches.length
  }));
  return json({
    customer: context.customer,
    namespace: context.namespace,
    category: input.category,
    candidateCount: result.matches.length,
    matches
  });
}

export default {
  async fetch(request, env) {
    const url = new URL(request.url);
    if (request.method === "POST" && url.pathname === "/seed") return seed(env);
    if (request.method === "POST" && url.pathname === "/search") return search(request, env);
    return json({ error: "not_found" }, 404);
  }
};
JS
Lancez les tests déterministes. Leurs bindings en mémoire prouvent que le Worker construit les deux limites de requête à partir du contexte côté serveur, sans consommer le quota cloud :
node --test test/worker.test.mjs
Vous devez obtenir six tests réussis. Générez ensuite les types des bindings à partir de la configuration réelle, puis créez le bundle sans le déployer :
npx wrangler types
npx wrangler deploy --dry-run --outdir /tmp/v04-dry-run
Le fichier généré doit contenir AI: Ai et DOCUMENTS: VectorizeIndex. Le mode dry run prouve que le code source et la configuration sont compatibles ; il ne crée ni ne teste aucune des deux ressources cloud.
Créer l'index filtrable et déployer
Dans cette étape, vous allez créer l'index compatible, préparer le champ category pour le filtrage, puis déployer le Worker uniquement une fois cette préparation traitée.
Un vecteur peut stocker des métadonnées sans les rendre interrogeables. Un index de métadonnées indique à Vectorize quel champ organiser pour les requêtes avec filtrage préalable. Il doit exister avant l'insertion des vecteurs des documents ; sinon, les enregistrements précédents ne participeront pas à ce filtre de métadonnées.
Créez un index de 384 dimensions avec une métrique cosinus, compatible avec BGE Small. --update-config=false empêche Wrangler de réécrire le binding explicite que vous avez déjà vérifié :
npx wrangler vectorize create "$INDEX" --dimensions=384 --metric=cosine --update-config=false
Mettez maintenant en file d'attente la préparation du champ texte category et conservez son identifiant de mutation :
set -o pipefail
npx wrangler vectorize create-metadata-index "$INDEX" \
  --propertyName=category \
  --type=string 2>&1 | tee .labex/category-index-output.txt
META_MUTATION=$(grep -Eo '[0-9a-fA-F]{8}-[0-9a-fA-F-]{27}' .labex/category-index-output.txt | tail -n 1)
if [ -z "$META_MUTATION" ]; then
  printf '%s\n' 'No metadata mutation ID was returned; fix the command before continuing.' >&2
else
  printf '%s\n' "$META_MUTATION" | tee .labex/category-mutation.txt
fi
Une mutation acceptée correspond à un travail mis en file d'attente, pas à un travail terminé. Écrivez une seule attente bornée en lecture seule que vous réutiliserez après l'insertion des données. Elle exige trois lectures consécutives de la même mutation et du même nombre de vecteurs, afin qu'une lecture brièvement obsolète ne devienne pas la preuve finale du laboratoire :
cat > scripts/wait-for-vectorize.mjs <<'JS'
import { execFileSync } from "node:child_process";
import { readFileSync } from "node:fs";

const [indexName, mutationFile, expectedText] = process.argv.slice(2);
const mutationId = readFileSync(mutationFile, "utf8").trim();
const expectedCount = Number(expectedText);
if (!/^[0-9a-f-]{36}$/i.test(mutationId)) throw new Error("mutation file has no UUID");
if (!Number.isInteger(expectedCount) || expectedCount < 0) throw new Error("expected count is invalid");
const wrangler = "./node_modules/wrangler/bin/wrangler.js";
let consecutiveMatches = 0;

for (let attempt = 1; attempt <= 120; attempt += 1) {
  const output = execFileSync(process.execPath, [wrangler, "vectorize", "info", indexName, "--json"], { encoding: "utf8" });
  const info = JSON.parse(output);
  if (String(info.processedUpToMutation) === mutationId && info.vectorCount === expectedCount) consecutiveMatches += 1;
  else consecutiveMatches = 0;
  if (consecutiveMatches === 3) {
    console.log("mutation " + mutationId + " is consistently readable with " + expectedCount + " vectors");
    console.log(JSON.stringify(info, null, 2));
    process.exit(0);
  }
  await new Promise((resolve) => setTimeout(resolve, 2000));
}
throw new Error("mutation " + mutationId + " was not stable within four minutes");
JS
node scripts/wait-for-vectorize.mjs "$INDEX" .labex/category-mutation.txt 0
La mutation peut être traitée avant que la vue de liste séparée ne soit à jour. Utilisez une boucle bornée en lecture seule pour attendre que la ligne category soit visible, au lieu de considérer une seule réponse obsolète de la liste comme un échec :
for attempt in {1..15}; do
  METADATA_INDEXES=$(npx wrangler vectorize list-metadata-index "$INDEX" 2>&1)
  if grep -Eq 'category.*String' <<<"$METADATA_INDEXES"; then
    break
  fi
  sleep 2
done
printf '%s\n' "$METADATA_INDEXES"
grep -Eq 'category.*String' <<<"$METADATA_INDEXES" || {
  printf '%s\n' 'The category metadata index is processed but not yet visible; rerun this read-only check.' >&2
  exit 1
}
Vous devez obtenir category avec le type String. Déployez enfin le Worker dont le binding DOCUMENTS pointe vers cet index préparé :
set -o pipefail
npx wrangler deploy 2>&1 | tee .labex/deploy-output.txt
DEPLOY_URL=$(sed -nE 's#.*(https://[^[:space:]]+\.workers\.dev).*#\1#p' .labex/deploy-output.txt | tail -n 1)
if [ -z "$DEPLOY_URL" ]; then
  printf '%s\n' 'No workers.dev URL was returned; fix deployment before continuing.' >&2
else
  printf '%s\n' "$DEPLOY_URL" | tee .labex/deploy-url.txt
fi
L'index est encore vide. Le déploiement connecte les bindings ; il ne crée pas automatiquement les embeddings des documents.
Insérer des données dans deux espaces de noms clients
Dans cette étape, vous allez créer des embeddings en temps réel et stocker chaque enregistrement dans exactement un espace de noms client, avec ses métadonnées de catégorie.
Un espace de noms appartient au vecteur lui-même. Les deux enregistrements de mot de passe contiennent volontairement un texte identique, mais résident dans des partitions différentes. category est une métadonnée distincte : un enregistrement peut donc appartenir simultanément à l'espace de noms blue et à la catégorie account.
Appelez une seule fois le point de terminaison fixe d'insertion. Le corpus est contrôlé par le serveur, donc le corps de la requête est vide :
DEPLOY_URL=$(cat .labex/deploy-url.txt)
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/seed" \
  -H 'content-type: application/json' \
  --data '{}' | tee .labex/seed-response.json
node -e '
  const value = JSON.parse(require("fs").readFileSync(".labex/seed-response.json", "utf8"));
  if (!/^[0-9a-f-]{36}$/i.test(value.mutationId)) throw new Error("seed mutation is missing");
  require("fs").writeFileSync(".labex/seed-mutation.txt", value.mutationId + "\n");
  console.log("accepted " + value.count + " scoped vectors in mutation " + value.mutationId);
'
Vous devez obtenir count: 4, 384 dimensions, un pooling cls et un UUID de mutation. Attendez cette mutation et ce nombre exacts au lieu de deviner le délai nécessaire au service :
node scripts/wait-for-vectorize.mjs "$INDEX" .labex/seed-mutation.txt 4
for attempt in {1..15}; do
  VECTOR_LIST=$(npx wrangler vectorize list-vectors "$INDEX" --count=10 2>&1)
  if grep -q 'blue-password' <<<"$VECTOR_LIST" &&
     grep -q 'blue-invoice' <<<"$VECTOR_LIST" &&
     grep -q 'green-password' <<<"$VECTOR_LIST" &&
     grep -q 'green-upload' <<<"$VECTOR_LIST"; then
    break
  fi
  sleep 2
done
printf '%s\n' "$VECTOR_LIST"
for id in blue-password blue-invoice green-password green-upload; do
  grep -q "$id" <<<"$VECTOR_LIST" || {
    printf 'The processed vector %s is not visible in the list yet; rerun this read-only check.\n' "$id" >&2
    exit 1
  }
done
L'inventaire doit contenir blue-password, blue-invoice, green-password et green-upload. Les ID relient les résultats aux documents source ; l'espace de noms et la catégorie déterminent si un enregistrement autrement similaire peut être retenu par une requête.
Prouver l'isolation par client et par catégorie
Dans cette étape, vous allez poser la même question sémantique pour deux clients, puis tester un résultat vide autorisé et un remplacement non sécurisé.
Commencez avec la session synthétique blue et la catégorie account :
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/search" \
  -H 'content-type: application/json' \
  -H 'x-lab-session: blue-session' \
  --data '{"query":"My password expired","category":"account"}' \
  | tee .labex/blue-account.json
La réponse doit indiquer customer: blue, namespace: customer-blue et uniquement blue-password. Envoyez maintenant la même question avec la session green :
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/search" \
  -H 'content-type: application/json' \
  -H 'x-lab-session: green-session' \
  --data '{"query":"My password expired","category":"account"}' \
  | tee .labex/green-account.json
Cette fois, seul green-password peut être retenu. Le texte du document est identique ; cette différence provient donc de l'espace de noms sélectionné par la session validée, et non du modèle d'embedding ni d'un score favorable obtenu par hasard.
Demandez ensuite à la session blue la catégorie files. Un article green très pertinent sur l'envoi existe, mais l'espace de noms blue ne contient aucun article concernant les fichiers :
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/search" \
  -H 'content-type: application/json' \
  -H 'x-lab-session: blue-session' \
  --data '{"query":"Upload a PDF","category":"files"}' \
  | tee .labex/blue-files-empty.json
Vous devez obtenir candidateCount: 0 et matches: []. Une réponse vide est la réponse autorisée correcte ; emprunter un enregistrement pertinent dans un autre espace de noms constituerait une fuite de données.
Enfin, essayez de remplacer l'espace de noms depuis le corps de la requête :
curl --silent --show-error \
  -o .labex/override-response.json \
  -w 'HTTP %{http_code}\n' \
  -X POST "$DEPLOY_URL/search" \
  -H 'content-type: application/json' \
  -H 'x-lab-session: blue-session' \
  --data '{"query":"Upload a PDF","category":"files","namespace":"customer-green"}'
cat .labex/override-response.json
Vous devez obtenir HTTP 400 et scope_override_not_allowed. Le Worker rejette le champ avant toute opération d'embedding ou de requête Vectorize. Le client peut demander une catégorie autorisée, mais seule une logique serveur de confiance associe l'identité à un espace de noms client.
Ouvrez Workers & Pages → votre Worker labex-c08-v04-... → Bindings. Vérifiez que AI pointe vers Workers AI et que DOCUMENTS pointe vers l'index Vectorize éphémère exact. Cette relation visuelle explique comment env.AI et env.DOCUMENTS dans le code accèdent aux services gérés ; les vérifications indépendantes prouvent toujours les identités exactes des bindings.
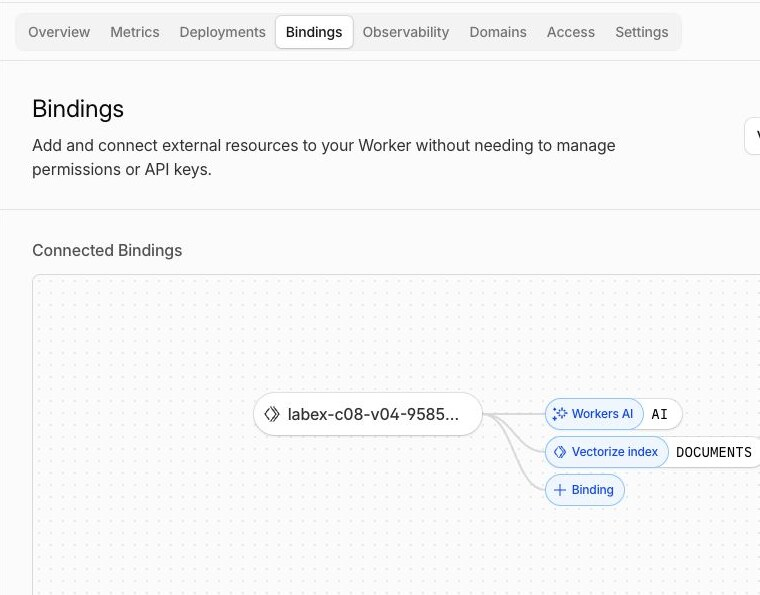
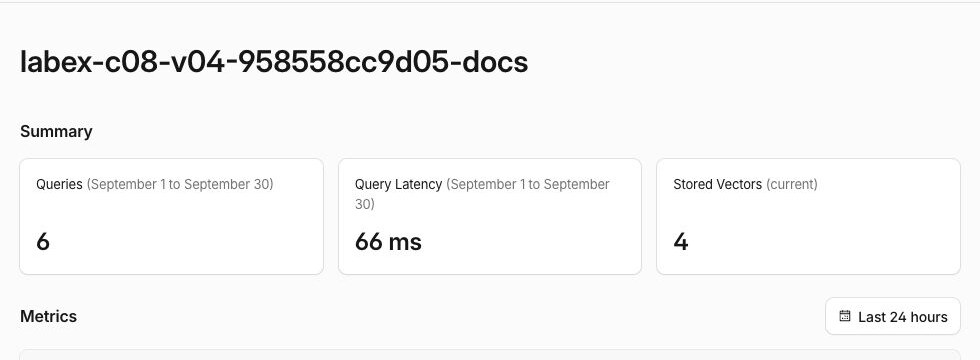
Ouvrez ensuite AI → Vectorize → l'index -docs correspondant. Le nombre actuel de vecteurs doit finalement atteindre quatre, et les métriques de requêtes doivent commencer à refléter les recherches cloisonnées. Les compteurs du tableau de bord peuvent prendre du retard ; les lectures authentifiées des enregistrements et les réponses HTTP restent les sources faisant foi pour les ID, espaces de noms et catégories exacts.
Si Workers Logs est disponible, ouvrez la vue Observability → Logs du Worker et examinez une entrée scoped_search. Elle enregistre uniquement le libellé client synthétique, l'espace de noms, la catégorie et le nombre de résultats retournés, pas le texte de la question ni le libellé de session. Des journaux structurés et limités du point de vue de la confidentialité permettent de diagnostiquer la portée sélectionnée par le serveur sans recopier le contenu sensible de la requête.
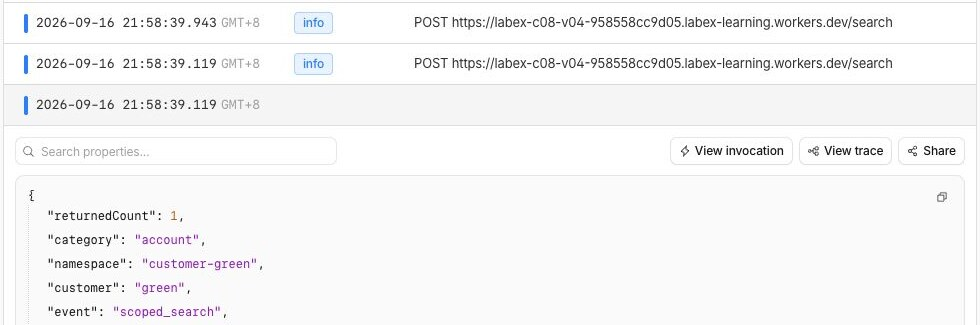
Ces captures présentent des exemples ciblés issus d'une exécution de test éphémère. Le nom aléatoire de vos ressources, les horodatages, la latence et le nombre total de requêtes seront différents ; comparez les noms des bindings, le nombre actuel de vecteurs et les relations entre les champs plutôt que de recopier les valeurs de l'exemple.
Supprimer les ressources de recherche cloisonnée
Dans cette étape, vous allez supprimer le Worker et l'index éphémères, puis prouver leur absence tant que Wrangler est encore autorisé.
Récupérez les noms exacts depuis wrangler.jsonc, afin que le nettoyage ne dépende pas des variables d'une session de terminal précédente :
RUN=$(node -p 'JSON.parse(require("fs").readFileSync("wrangler.jsonc", "utf8")).name')
INDEX=$(node -p 'JSON.parse(require("fs").readFileSync("wrangler.jsonc", "utf8")).vectorize.find((item) => item.binding === "DOCUMENTS").index_name')
printf 'Worker: %s\nIndex: %s\n' "$RUN" "$INDEX"
Vérifiez que les deux valeurs commencent par votre préfixe unique labex-c08-v04-.... Supprimez d'abord le Worker afin qu'aucun code déployé ne conserve le binding, puis supprimez uniquement l'index qui lui est associé :
npx wrangler delete --name "$RUN" --force
npx wrangler vectorize delete "$INDEX" --force
Enregistrez un inventaire authentifié réussi et vérifiez le nom exact :
npx wrangler vectorize list --json > .labex/indexes-after-cleanup.json
node -e '
  const rows = JSON.parse(require("fs").readFileSync(process.argv[1], "utf8"));
  if (rows.some((row) => row.name === process.argv[2])) throw new Error("lab index still exists");
  console.log("lab index is absent");
' .labex/indexes-after-cleanup.json "$INDEX"
Terminez cette étape avant de vous déconnecter. Une erreur réseau ou d'autorisation ne permet pas de conclure ; l'évaluation exige indépendamment des lectures de compte réussies et l'absence du nom exact.
Se déconnecter de la VM d'apprentissage
Dans cette étape, vous allez supprimer l'autorisation Wrangler temporaire de cette VM. Les ressources cloud ont déjà disparu et la vérification de nettoyage authentifiée a réussi :
npx wrangler logout
npx wrangler whoami --json
Vous devez obtenir loggedIn: false. La session du navigateur dans le tableau de bord Cloudflare est distincte et reste disponible pour votre compte d'apprentissage.
Résumé
Vous avez ajouté deux vérifications indépendantes d'éligibilité à la recherche sémantique. Une session synthétique validée a sélectionné un espace de noms client côté serveur, puis un champ category indexé a réduit cette partition avant le classement par Vectorize. Les documents de mot de passe identiques ont prouvé que la similarité seule ne peut pas assurer l'isolation entre clients, tandis que la requête blue sur les fichiers a montré qu'un résultat vide autorisé est préférable à l'emprunt d'un enregistrement pertinent appartenant à un autre client.
Vous avez également rejeté les remplacements de client et d'espace de noms fournis par le client avant l'inférence, inspecté dans le tableau de bord les relations réelles entre bindings, index et journaux limités du point de vue de la confidentialité, supprimé le Worker et l'index éphémères avec l'autorisation active, puis vous vous êtes déconnecté. V05 réutilisera cette limite de recherche sûre pour rassembler des éléments de preuve source limités avant qu'un modèle de langage ne réponde.