Introduction
V01 a stocké des vecteurs identifiés, et V02 a maintenu ces enregistrements à jour. Cet atelier ajoute le chemin de lecture manquant : une personne saisit une question, l’application transforme ce texte en vecteur compatible, puis demande à Vectorize quels documents stockés pointent dans les directions les plus proches.
Il s’agit de recherche sémantique. Elle compare des embeddings orientés vers le sens au lieu d’exiger que la requête répète les mots exacts d’un article. La requête et les documents stockés doivent utiliser le même modèle, 384 dimensions et une agrégation cls. Un score de similarité Vectorize aide à classer les vecteurs compatibles pour une requête ; il ne représente pas un pourcentage universel de confiance et ne prouve pas qu’un article répond à la question.
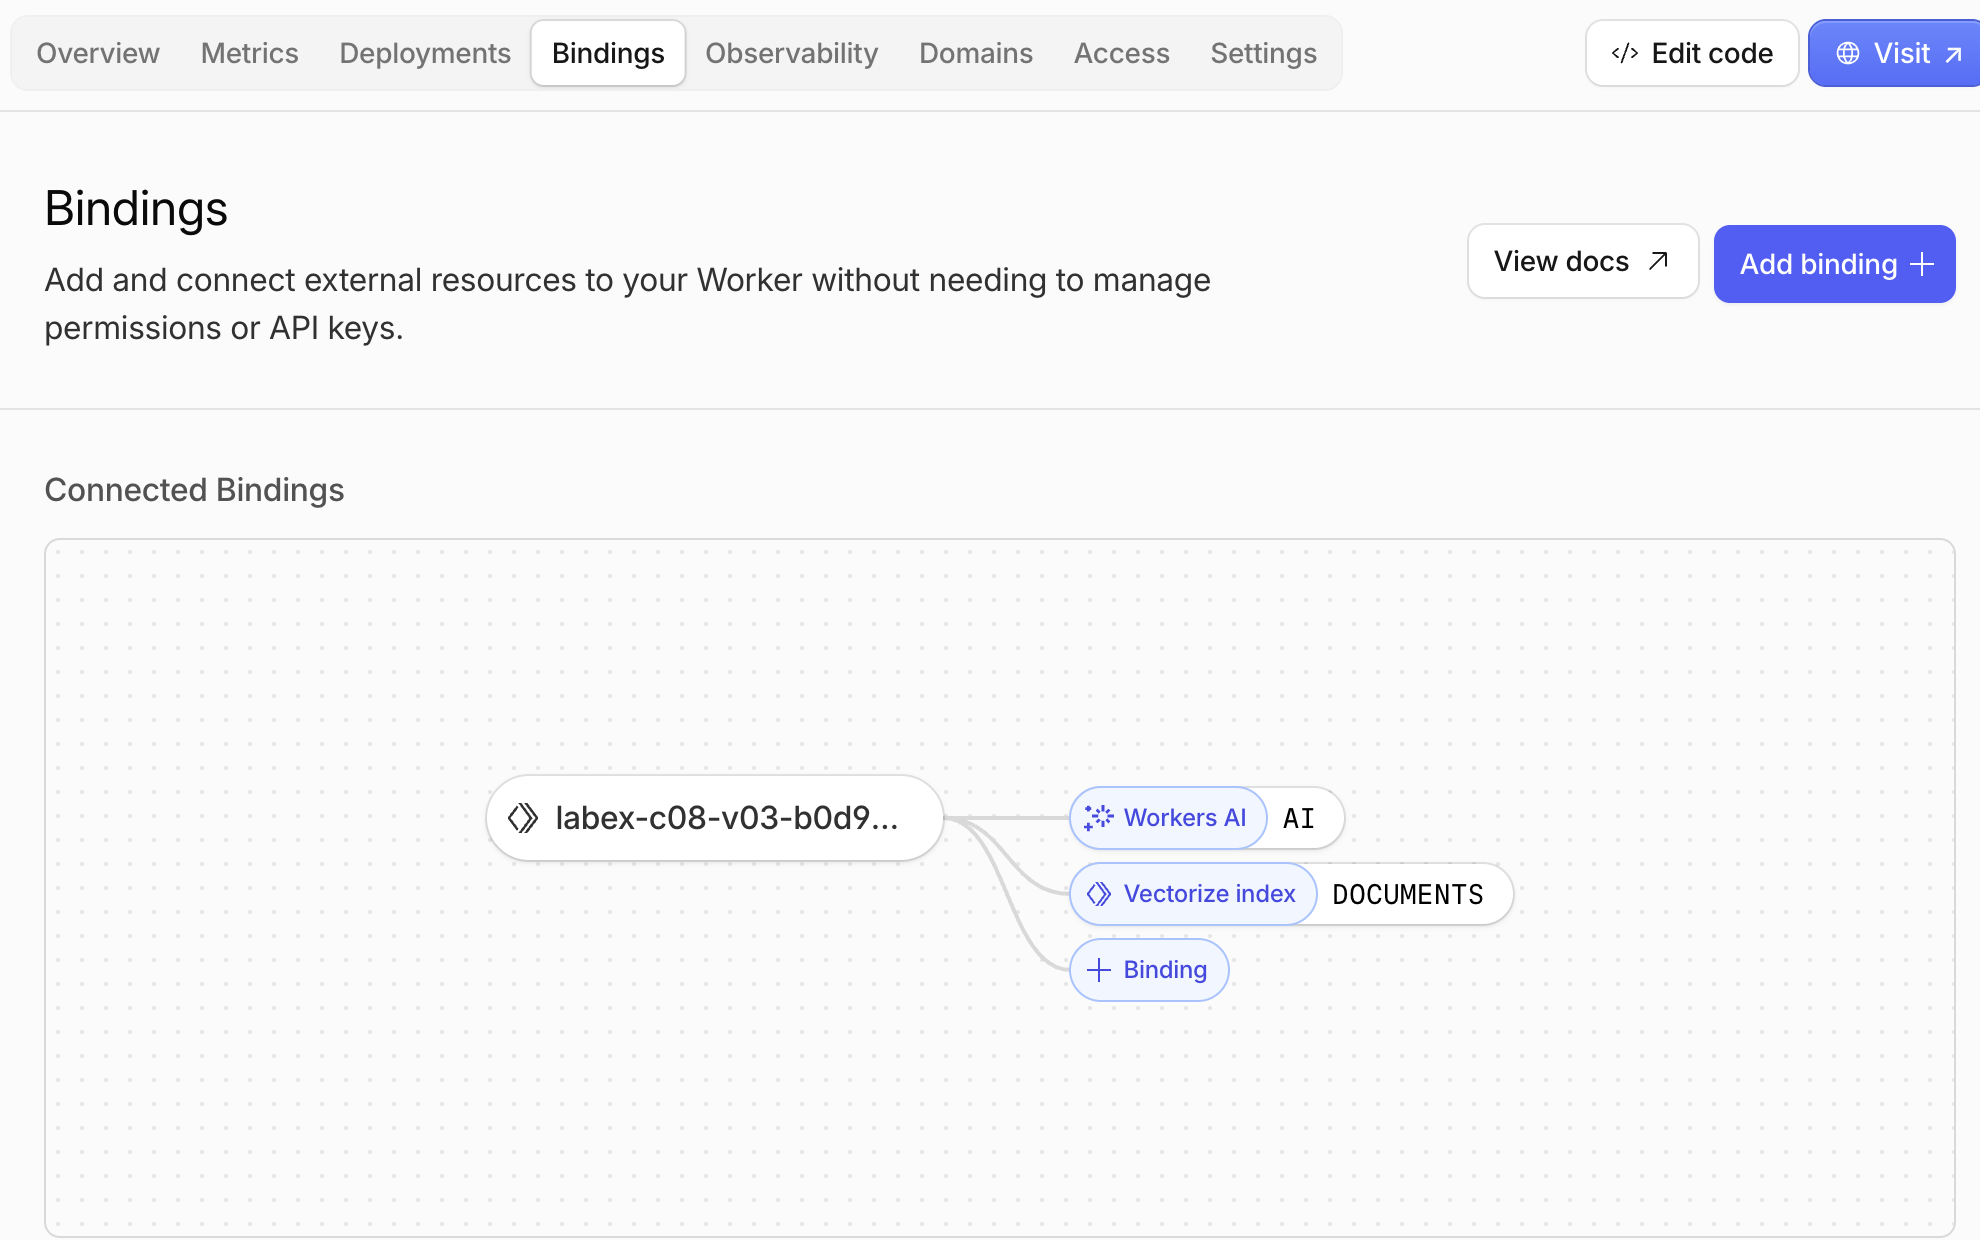
Vous allez créer un Worker éphémère avec deux liaisons Cloudflare. AI envoie les textes courts au modèle d’embeddings @cf/baai/bge-small-en-v1.5 hébergé par Cloudflare. DOCUMENTS écrit dans un index Vectorize éphémère et interroge cet index. Le Worker expose une opération /seed fixe pour trois articles d’aide synthétiques et une opération /search qui accepte une requête, topK et un score minimal facultatif. topK signifie « renvoyer au plus ce nombre de candidats les plus proches », et non « ces candidats sont définitivement pertinents ».
Il s’agit du troisième atelier Vectorize. Si vous êtes arrivé directement ici, commencez par terminer Connect LabEx to Your Cloudflare Account, puis terminez V01 et V02 afin de vous familiariser avec la compatibilité des index, les identifiants stables et les mutations asynchrones.
Vectorize et Workers AI disposent tous deux de quotas gratuits. Cet atelier stocke trois petits vecteurs et n’effectue que quelques requêtes d’embeddings courtes. Il ne nécessite pas Workers Paid. L’inférence locale ou déployée consomme tout de même l’allocation quotidienne partagée de Workers AI. Arrêtez-vous au lieu de réessayer sans cesse si le modèle ou l’allocation gratuite n’est pas disponible.
La configuration installe Node.js 22.22.0 ainsi que Wrangler 4.132.0, installé localement dans le projet /home/labex/project/vector-search. Elle fournit des tests déterministes et des vérifications indépendantes, mais elle n’autorise pas Wrangler, n’appelle pas de modèle, ne crée pas d’index, ne déploie pas de Worker et n’insère pas de données dans le cloud.
Autoriser Wrangler et nommer les ressources de recherche
Dans cette étape, vous allez autoriser la VM fraîchement créée et créer une configuration qui nomme le Worker et l’index Vectorize qui lui est associé.
Accédez au projet préparé et vérifiez la version de la CLI épinglée :
cd /home/labex/project/vector-search
npx wrangler --version
La sortie attendue est 4.132.0. Wrangler utilise un flux d’autorisation par appareil afin que votre mot de passe n’entre jamais dans la VM. Demandez l’accès à l’identité du compte, au Worker, à Vectorize et à Workers AI pour cet exercice éphémère :
Wrangler sépare les opérations sur l’index du déploiement du script et des vérifications de nettoyage. Demandez workers:write pour Vectorize, workers_scripts:write pour le Worker, workers_kv:write pour la vérification de suppression de Wrangler qui respecte les dépendances, et ai:write pour la liaison du modèle :
npx wrangler login --device --browser=false --scopes account:read user:read workers:write workers_scripts:write workers_kv:write ai:write
npx wrangler whoami --json
Vérifiez que loggedIn: true apparaît et que le compte d’apprentissage est bien celui attendu. Générez un suffixe aléatoire, puis dérivez les deux noms de ressources à partir de celui-ci afin que le nettoyage ne les confonde pas avec des ressources sans rapport :
RUN="labex-c08-v03-$(openssl rand -hex 6)"
INDEX="$RUN-docs"
printf 'Worker: %s\nIndex:  %s\n' "$RUN" "$INDEX"
Remplacez YOUR_ACCOUNT_ID par l’identifiant réel du compte sélectionné. Une liaison est le nom par lequel le code du Worker reçoit un service Cloudflare géré. AI fournira l’inférence du modèle ; DOCUMENTS fournira l’index Vectorize exact nommé par index_name.
cat > wrangler.jsonc <<JSON
{
  "\$schema": "./node_modules/wrangler/config-schema.json",
  "name": "$RUN",
  "account_id": "YOUR_ACCOUNT_ID",
  "main": "src/index.js",
  "compatibility_date": "2026-09-16",
  "workers_dev": true,
  "preview_urls": false,
  "observability": { "enabled": true },
  "ai": { "binding": "AI", "remote": true },
  "vectorize": [
    { "binding": "DOCUMENTS", "index_name": "$INDEX", "remote": true }
  ]
}
JSON
La configuration nomme les ressources, mais ne les crée pas. Cette séparation vous permet d’inspecter la limite de responsabilité prévue avant toute modification du compte.
Créer le Worker de recherche avec ses liaisons
Dans cette étape, vous allez implémenter l’insertion fixe des documents et le point d’accès de recherche destiné à l’apprenant avant de déployer le moindre code.
Les trois documents sources restent dans le code de l’application, car Vectorize stocke des vecteurs et des métadonnées, et non le système de référence complet des articles. /seed transforme ce corpus fixe en embeddings une seule fois. /search transforme une requête validée en embedding, demande à Vectorize les topK candidats les plus proches, puis applique minScore. Les métadonnées renvoyées aident l’application à convertir les identifiants de vecteurs en références utiles.
cat > src/index.js <<'JS'
const MODEL = "@cf/baai/bge-small-en-v1.5";
const POOLING = "cls";
const DIMENSIONS = 384;

const DOCUMENTS = [
  {
    id: "password-reset",
    category: "account",
    title: "Reset an expired password",
    text: "Reset an expired or forgotten password to regain access to your account."
  },
  {
    id: "upload-pdf",
    category: "files",
    title: "Upload a PDF",
    text: "Upload a PDF document and troubleshoot file size or format errors."
  },
  {
    id: "billing-receipt",
    category: "billing",
    title: "Download a billing receipt",
    text: "Download a receipt for a completed invoice or payment."
  }
];

function json(value, status = 200) {
  return Response.json(value, { status, headers: { "cache-control": "no-store" } });
}

export function validateEmbeddingBatch(result, expectedCount) {
  const vectors = result?.data;
  if (!Array.isArray(vectors) || vectors.length !== expectedCount || result?.shape?.[1] !== DIMENSIONS) {
    throw new Error("incompatible embedding batch");
  }
  for (const vector of vectors) {
    if (!Array.isArray(vector) || vector.length !== DIMENSIONS || !vector.every(Number.isFinite)) {
      throw new Error("invalid embedding vector");
    }
  }
  return vectors;
}

export function parseSearchInput(value) {
  const query = typeof value?.query === "string" ? value.query.trim() : "";
  const topK = value?.topK === undefined ? 3 : value.topK;
  const minScore = value?.minScore === undefined ? 0 : value.minScore;
  if (!query || query.length > 200) throw new Error("query_required");
  if (!Number.isInteger(topK) || topK < 1 || topK > 3) throw new Error("topk_invalid");
  if (typeof minScore !== "number" || !Number.isFinite(minScore) || minScore < 0 || minScore > 1) throw new Error("minscore_invalid");
  return { query, topK, minScore };
}

async function embed(env, texts) {
  const result = await env.AI.run(MODEL, { text: texts, pooling: POOLING });
  return validateEmbeddingBatch(result, texts.length);
}

async function seed(env) {
  const vectors = await embed(env, DOCUMENTS.map((document) => document.text));
  const records = DOCUMENTS.map((document, index) => ({
    id: document.id,
    values: vectors[index],
    metadata: {
      category: document.category,
      published: true,
      title: document.title,
      model: MODEL,
      pooling: POOLING
    }
  }));
  const mutation = await env.DOCUMENTS.upsert(records);
  console.log(JSON.stringify({ event: "documents_seeded", count: records.length, mutationId: mutation.mutationId }));
  return json({ mutationId: mutation.mutationId, count: records.length, model: MODEL, dimensions: DIMENSIONS, pooling: POOLING }, 202);
}

async function search(request, env) {
  let input;
  try {
    input = parseSearchInput(await request.json());
  } catch (error) {
    return json({ error: error instanceof Error ? error.message : "invalid_json" }, 400);
  }
  const [queryVector] = await embed(env, [input.query]);
  const result = await env.DOCUMENTS.query(queryVector, { topK: input.topK, returnMetadata: "all" });
  const matches = result.matches
    .filter((match) => Number.isFinite(match.score) && match.score >= input.minScore)
    .map((match) => ({
      id: match.id,
      score: match.score,
      title: match.metadata?.title,
      category: match.metadata?.category
    }));
  console.log(JSON.stringify({ event: "documents_retrieved", candidateCount: result.matches.length, returnedCount: matches.length, topK: input.topK }));
  return json({ model: MODEL, dimensions: DIMENSIONS, pooling: POOLING, candidateCount: result.matches.length, matches });
}

export default {
  async fetch(request, env) {
    const url = new URL(request.url);
    if (request.method === "POST" && url.pathname === "/seed") return seed(env);
    if (request.method === "POST" && url.pathname === "/search") return search(request, env);
    return json({ error: "not_found" }, 404);
  }
};
JS
Exécutez les tests déterministes. Ils remplacent les deux liaisons par de petites données en mémoire. Ils vérifient donc la validation et le flux de contrôle sans consommer le quota d’AI ou de Vectorize :
node --test test/worker.test.mjs
Vous devez obtenir cinq tests réussis. Générez ensuite les types des liaisons et demandez à Wrangler de regrouper le Worker sans le déployer :
npx wrangler types
npx wrangler deploy --dry-run --outdir /tmp/v03-dry-run
Le fichier de types généré doit contenir AI: Ai et DOCUMENTS: VectorizeIndex. Une exécution à blanc confirme que le module et la configuration peuvent être regroupés ; elle ne prouve pas que les services cloud existent.
Créer l’index et déployer les deux liaisons
Dans cette étape, vous allez créer l’index compatible vide, puis déployer le Worker qui reçoit les deux liaisons gérées.
Le modèle d’embeddings renvoie 384 nombres. La distance cosinus compare leur direction. Créez donc un index avec le même contrat immuable :
npx wrangler vectorize create "$INDEX" --dimensions=384 --metric=cosine --update-config=false
Déployez le Worker uniquement après la création de l’index, car Cloudflare doit associer la liaison DOCUMENTS configurée à une ressource réelle :
set -o pipefail
npx wrangler deploy 2>&1 | tee .labex/deploy-output.txt
Wrangler doit afficher les deux liaisons ainsi que l’URL workers.dev. Enregistrez l’URL exacte au lieu de reconstruire un sous-domaine au hasard :
DEPLOY_URL=$(sed -nE 's#.*(https://[^[:space:]]+\.workers\.dev).*#\1#p' .labex/deploy-output.txt | tail -n 1)
if [ -z "$DEPLOY_URL" ]; then
  printf '%s\n' 'No workers.dev URL was returned; fix the deployment before continuing.' >&2
else
  printf '%s\n' "$DEPLOY_URL" | tee .labex/deploy-url.txt
fi
À ce stade, l’index est intentionnellement vide. Le déploiement connecte les services ; il ne transforme pas automatiquement les documents en embeddings et ne les insère pas.
Insérer les embeddings des documents en direct
Dans cette étape, vous allez appeler une fois l’opération fixe /seed, enregistrer sa mutation et attendre que les trois embeddings produits par le modèle soient lisibles.
Le Worker envoie les trois textes courts des documents à BGE Small en un seul lot. Il vérifie la forme renvoyée, ajoute des identifiants stables et des métadonnées utiles, puis insère ou remplace les enregistrements. Appelez-le avec un objet JSON vide, car le corpus est contrôlé par le serveur :
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/seed" \
  -H 'content-type: application/json' \
  --data '{}' | tee .labex/seed-response.json
Vous devez obtenir une réponse HTTP 202 contenant count: 3, 384 dimensions, l’agrégation cls et un UUID de mutation. La mutation acceptée est asynchrone. Créez donc la même vérification de stabilité limitée que dans les ateliers précédents. execFileSync exécute le processus Wrangler épinglé, tandis que readFileSync lit la réponse d’insertion enregistrée ; ces fonctions proviennent de deux modules intégrés différents de Node.js :
cat > scripts/wait-for-vectorize.mjs <<'JS'
import { execFileSync } from "node:child_process";
import { readFileSync } from "node:fs";

const indexName = process.argv[2];
const seed = JSON.parse(readFileSync(".labex/seed-response.json", "utf8"));
const mutationId = seed.mutationId;
if (!/^[0-9a-f-]{36}$/i.test(mutationId)) throw new Error("seed response has no mutation ID");
const wrangler = "./node_modules/wrangler/bin/wrangler.js";
let consecutiveMatches = 0;

for (let attempt = 1; attempt <= 120; attempt += 1) {
  const output = execFileSync(process.execPath, [wrangler, "vectorize", "info", indexName, "--json"], { encoding: "utf8" });
  const info = JSON.parse(output);
  if (info.processedUpToMutation === mutationId && info.vectorCount === 3) consecutiveMatches += 1;
  else consecutiveMatches = 0;
  if (consecutiveMatches === 3) {
    console.log(`mutation ${mutationId} is consistently readable with three vectors`);
    console.log(JSON.stringify(info, null, 2));
    process.exit(0);
  }
  await new Promise((resolve) => setTimeout(resolve, 2000));
}
throw new Error(`mutation ${mutationId} was not readable within four minutes`);
JS
node scripts/wait-for-vectorize.mjs "$INDEX"
Les trois lectures correspondantes protègent le résultat visible contre une réplique momentanément obsolète. Une fois l’attente terminée, affichez les identifiants stables de l’application :
npx wrangler vectorize list-vectors "$INDEX" --count=10
L’inventaire doit contenir password-reset, upload-pdf et billing-receipt. Leurs valeurs réelles proviennent du modèle hébergé par Cloudflare, et non des vecteurs pédagogiques déterministes utilisés dans V01 et V02.
Récupérer et interpréter des articles similaires
Dans cette étape, vous allez envoyer une question précise sur un mot de passe, examiner les deux candidats les plus proches et distinguer le classement d’un résultat explicitement vide.
Demandez topK: 2. Vectorize peut examiner tout le petit index, mais il renvoie au plus les deux candidats les plus proches. Le premier résultat doit être l’article sur le mot de passe, car la requête et l’article ont un sens fortement similaire, même si leur formulation exacte diffère :
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/search" \
  -H 'content-type: application/json' \
  --data '{"query":"My old password expired and I cannot sign in","topK":2}' \
  | tee .labex/password-search.json
node -e '
  const value = JSON.parse(require("fs").readFileSync(process.argv[1], "utf8"));
  console.table(value.matches);
' .labex/password-search.json
Vous devez obtenir deux lignes classées par score décroissant, avec password-reset en premier. Interprétez les scores de manière comparative : une valeur plus élevée indique une plus grande proximité pour cette requête et cet index compatibles, mais 0.8 ne signifie pas « 80 % correct ». topK n’applique pas non plus de seuil de pertinence.
Posez maintenant une question sans rapport et définissez minScore: 1. Vectorize renvoie tout de même trois candidats à l’application, mais celle-ci supprime chaque candidat dont le score est inférieur au seuil :
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/search" \
  -H 'content-type: application/json' \
  --data '{"query":"volcanic basalt crystallization","topK":3,"minScore":1}' \
  | tee .labex/empty-search.json
Vous devez obtenir candidateCount: 3 et matches: []. Une liste de correspondances vide est une décision explicite de l’application ; elle ne prouve pas que l’index ne contient aucun vecteur.
Envoyez enfin une entrée vide :
curl --silent --show-error \
  -o .labex/empty-input.json \
  -w 'HTTP %{http_code}\n' \
  -X POST "$DEPLOY_URL/search" \
  -H 'content-type: application/json' \
  --data '{"query":""}'
cat .labex/empty-input.json
Vous devez obtenir HTTP 400 et query_required. La validation se produit avant l’appel au modèle ou à la base de données. Une entrée incorrecte ne consomme donc pas de capacité d’inférence ou de requête.
Ouvrez Workers & Pages → votre Worker labex-c08-v03-... → Bindings. Une liaison donne au code du Worker un nom sûr pour accéder à un autre service Cloudflare. Ici, AI est le nom utilisé par env.AI pour exécuter le modèle d’embeddings, tandis que DOCUMENTS est le nom utilisé par env.DOCUMENTS pour interroger cet index Vectorize précis.
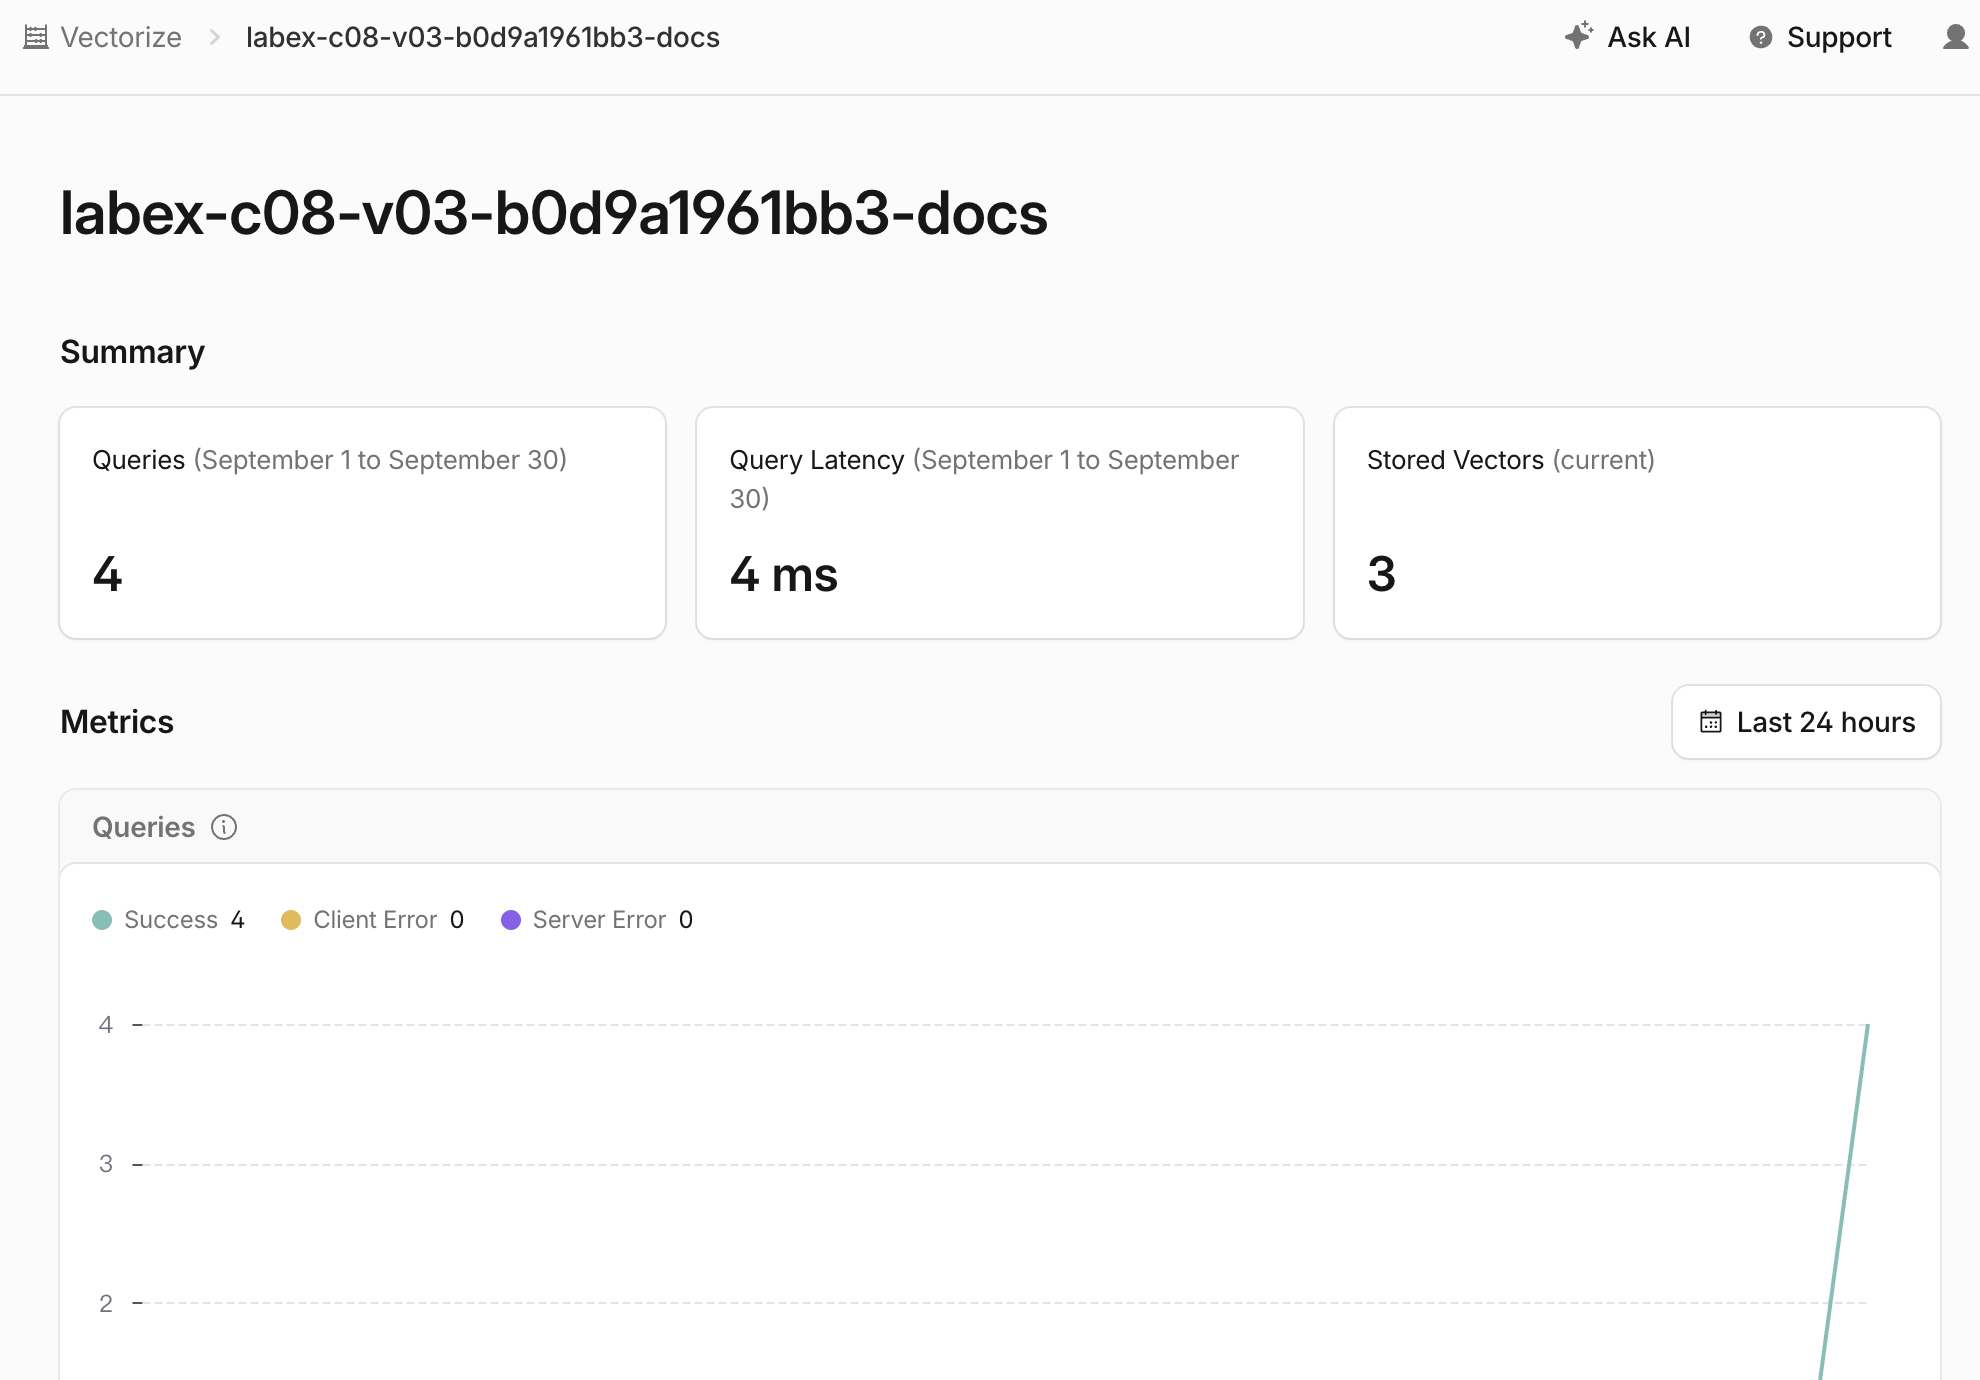
Ouvrez ensuite AI → Vectorize → l’index -docs correspondant. Le récapitulatif doit afficher trois vecteurs actuels : un pour chacun des articles d’aide que vous avez insérés. Le total des requêtes peut différer de l’exemple, car chaque recherche réussie ajoute une requête, y compris les vérifications répétées.
Faites défiler la page jusqu’à Metrics. P50, P75 et P95 sont des percentiles de latence : par exemple, P95 signifie que 95 % des requêtes réussies se sont terminées en ce temps ou moins. Ces nombres décrivent la rapidité, et non la pertinence d’une correspondance. Le graphique Stored Vectors doit rester à trois tant que vous effectuez uniquement des recherches et que vous n’ajoutez ni ne supprimez de documents.
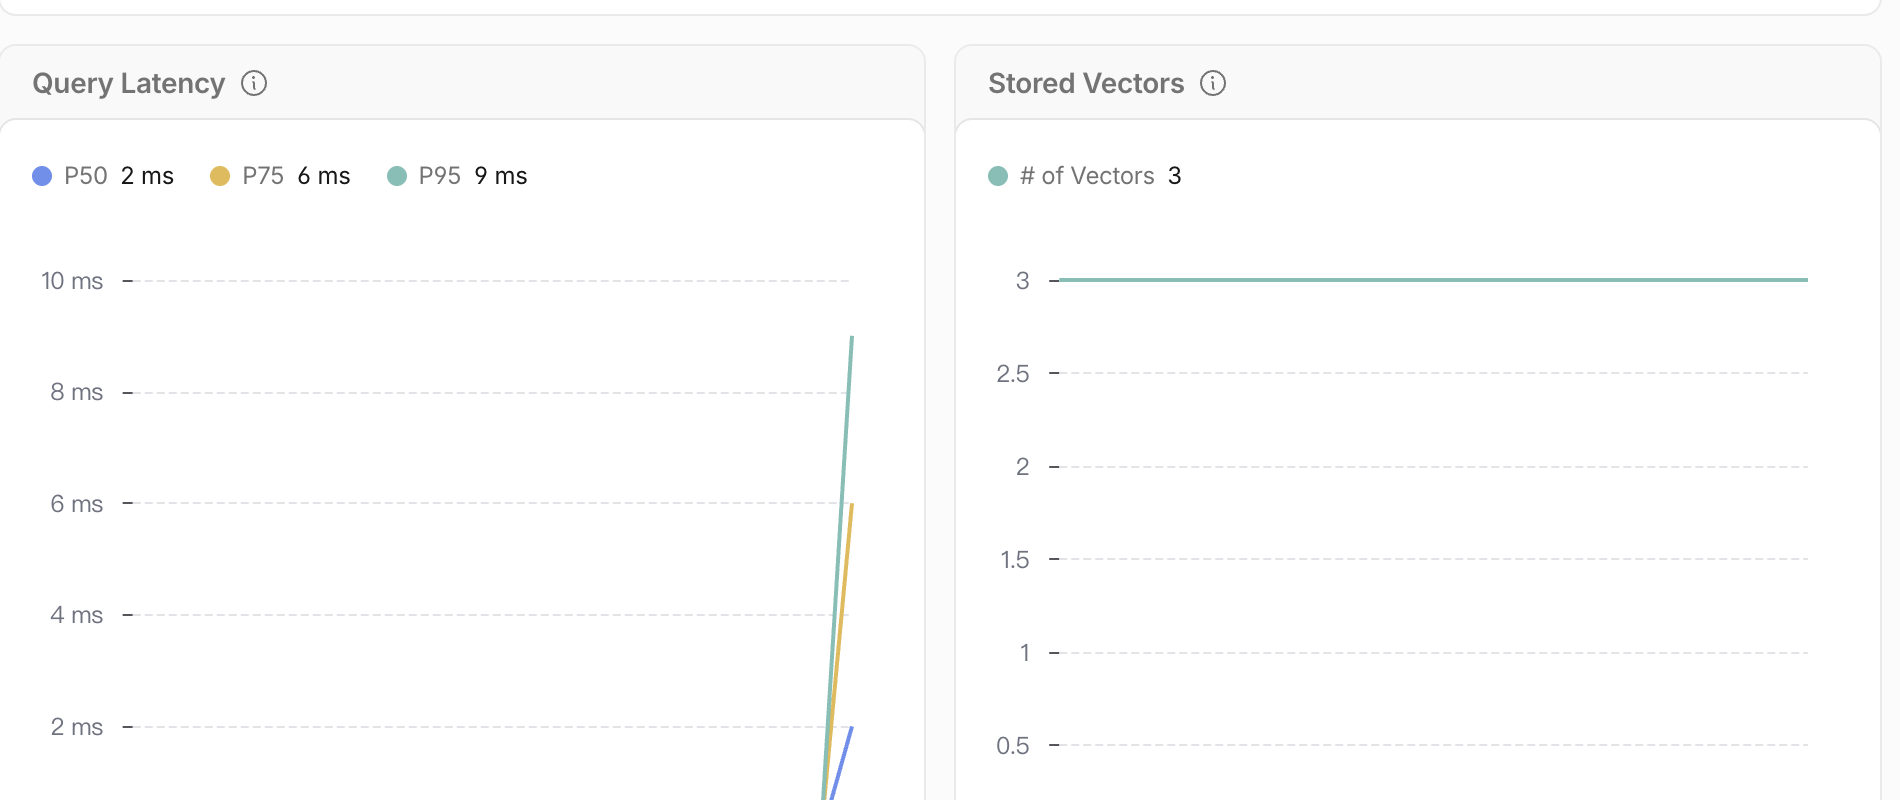
Les compteurs du tableau de bord peuvent avoir quelques instants de retard sur le terminal. Considérez les réponses de l’API, les identifiants renvoyés et les vérifications indépendantes comme les résultats de référence ; utilisez le Dashboard pour relier ces résultats aux ressources que vous pouvez consulter et gérer.
Supprimer le Worker de recherche et l’index
Dans cette étape, vous allez supprimer les deux ressources cloud éphémères et prouver leur absence pendant que Wrangler est encore autorisé. La déconnexion est une étape finale distincte, car la vérification du nettoyage nécessite un accès en lecture à Cloudflare.
Commencez par récupérer les noms exacts dans wrangler.jsonc. Le nettoyage reste ainsi sûr, même si vous avez ouvert un nouveau terminal et que les variables RUN et INDEX précédentes n’existent plus :
RUN=$(node -p 'JSON.parse(require("fs").readFileSync("wrangler.jsonc", "utf8")).name')
INDEX=$(node -p 'JSON.parse(require("fs").readFileSync("wrangler.jsonc", "utf8")).vectorize.find((item) => item.binding === "DOCUMENTS").index_name')
printf 'Worker: %s\nIndex: %s\n' "$RUN" "$INDEX"
Avant toute suppression, vérifiez que les deux valeurs commencent par votre préfixe unique labex-c08-v03-....
Supprimez d’abord le Worker afin qu’aucun code déployé ne conserve une liaison vers l’index :
npx wrangler delete --name "$RUN" --force
Supprimez uniquement l’index associé, puis enregistrez un inventaire authentifié réussi pour l’évaluation du nettoyage :
npx wrangler vectorize delete "$INDEX" --force
npx wrangler vectorize list --json > .labex/indexes-after-cleanup.json
node -e '
  const rows = JSON.parse(require("fs").readFileSync(process.argv[1], "utf8"));
  if (rows.some((row) => row.name === process.argv[2])) throw new Error("lab index still exists");
  console.log("lab index is absent");
' .labex/indexes-after-cleanup.json "$INDEX"
Terminez cette étape maintenant, avant la déconnexion. L’évaluation lit indépendamment les informations de Cloudflare et ne considère pas une erreur d’authentification ou de réseau comme une preuve de suppression.
Se déconnecter de la VM d’apprentissage
Dans cette étape, vous allez supprimer l’autorisation temporaire de Wrangler sur cette VM. Les ressources cloud ont déjà été supprimées et la vérification authentifiée du nettoyage a réussi. Vous pouvez donc maintenant vous déconnecter en toute sécurité :
npx wrangler logout
npx wrangler whoami --json
Vous devez obtenir loggedIn: false. La session du navigateur ouverte sur le Dashboard Cloudflare est distincte et reste disponible pour votre compte d’apprentissage.
Résumé
Vous avez créé un Worker qui utilise le même contrat de modèle pour les embeddings des documents stockés et ceux des requêtes en direct, inséré trois identifiants stables dans Vectorize et attendu que la mutation asynchrone réelle soit terminée. Vous avez utilisé topK pour limiter le nombre de candidats, interprété les scores comme des indicateurs de classement relatifs, renvoyé les métadonnées plutôt que les vecteurs bruts et produit un résultat vide explicite après l’application d’un seuil. Enfin, vous avez confirmé les deux liaisons cloud dans le Dashboard, supprimé le Worker et l’index éphémères tout en restant autorisé, puis vous vous êtes déconnecté de la VM.
V04 ajoutera des espaces de noms client contrôlés par le serveur ainsi que des filtres de métadonnées, afin qu’un enregistrement sémantiquement similaire ne soit renvoyé que s’il appartient également au périmètre de recherche autorisé.