Introduction
Dans V01, vous avez stocké un vecteur pour chaque article d’aide. Les articles réels restent rarement figés : les instructions évoluent, les titres sont corrigés et les pages obsolètes sont retirées. Un index de recherche doit suivre ce cycle de vie. Sinon, il peut renvoyer des réponses obsolètes même lorsque le site source est à jour.
Cloudflare Vectorize fournit trois opérations d’écriture associées :
- insert ajoute un nouvel ID de vecteur et ne doit pas remplacer silencieusement un ID existant ;
- upsert signifie « mettre à jour ou insérer » et remplace le vecteur ainsi que les métadonnées associées à cet ID ;
- delete by ID retire les enregistrements sélectionnés sans reconstruire tout l’index.
Vous allez initialiser trois documents synthétiques, mettre à jour un article sur la réinitialisation du mot de passe, supprimer un article de facturation retiré et vérifier que l’article indépendant sur l’envoi de fichiers n’a jamais changé. Chaque écriture renvoie un ID de mutation asynchrone. Vous attendrez donc l’état exact au lieu de supposer qu’une écriture acceptée est déjà lisible.
Il s’agit du deuxième lab Vectorize. Si vous êtes arrivé directement ici, terminez d’abord Connect LabEx to Your Cloudflare Account, puis terminez V01 afin de vous familiariser avec la compatibilité de l’index, les ID de documents et la visibilité des mutations.
Vectorize est disponible avec Workers Free. Ce lab stocke au maximum trois petits vecteurs de 384 dimensions, effectue des lectures limitées et n’appelle aucun modèle d’IA. Workers Paid et Workers AI Neurons ne sont donc pas nécessaires.
La configuration installe Node.js 22.22.0 ainsi que Wrangler 4.132.0, installé localement dans le projet /home/labex/project/document-lifecycle-index. Elle fournit des vérifications indépendantes en lecture seule, mais n’autorise pas Wrangler, ne crée pas d’index, n’écrit pas de vecteurs et ne modifie pas votre compte Cloudflare.
Autoriser un nouvel index de cycle de vie des documents
Dans cette étape, vous allez autoriser la nouvelle VM, enregistrer le compte prévu et créer une configuration locale unique pour un index temporaire.
Accédez au projet préparé et vérifiez la version figée de l’interface de ligne de commande :
cd /home/labex/project/document-lifecycle-index
npx wrangler --version
La sortie attendue est 4.132.0. Autorisez le même compte limité et le même accès aux ressources Workers que dans V01 :
npx wrangler login --device --browser=false --scopes account:read user:read workers:write
npx wrangler whoami --json
Vérifiez la présence de loggedIn: true, identifiez votre compte d’apprentissage et générez un nom unique :
RUN="labex-c08-v02-$(openssl rand -hex 6)"
printf '%s\n' "$RUN"
Remplacez YOUR_ACCOUNT_ID par l’ID réel de ce compte :
cat > wrangler.jsonc <<JSON
{
  "\$schema": "./node_modules/wrangler/config-schema.json",
  "name": "$RUN-tools",
  "account_id": "YOUR_ACCOUNT_ID",
  "compatibility_date": "2026-09-16",
  "vectorize": [
    { "binding": "DOCUMENTS", "index_name": "$RUN", "remote": true }
  ]
}
JSON
Le nouvel index est indépendant de V01. Réutiliser vos connaissances ne signifie pas dépendre de la VM ou de la ressource cloud d’un lab précédent.
Initialiser l’ensemble actuel de documents
Dans cette étape, vous allez créer l’index et insérer les trois enregistrements qui représentent le centre d’aide actuel avant toute modification ou suppression.
Créez le même contrat cosine à 384 dimensions que celui utilisé par le modèle d’embedding BGE Small :
npx wrangler vectorize create "$RUN" --dimensions=384 --metric=cosine --update-config=false
Créez un mécanisme d’attente réutilisable et limité. Trois lectures concordantes protègent le résultat visible par l’apprenant contre une réplique temporairement obsolète :
cat > scripts/wait-for-vectorize.mjs <<'JS'
import { execFileSync } from "node:child_process";

const [indexName, mutationId, expectedCountText] = process.argv.slice(2);
const expectedCount = Number(expectedCountText);
const wrangler = "./node_modules/wrangler/bin/wrangler.js";
let consecutiveMatches = 0;

for (let attempt = 1; attempt <= 120; attempt += 1) {
  const output = execFileSync(process.execPath, [wrangler, "vectorize", "info", indexName, "--json"], { encoding: "utf8" });
  const info = JSON.parse(output);
  if (info.processedUpToMutation === mutationId && info.vectorCount === expectedCount) {
    consecutiveMatches += 1;
  } else {
    consecutiveMatches = 0;
  }
  if (consecutiveMatches === 3) {
    console.log(`mutation ${mutationId} is consistently readable with ${expectedCount} vectors`);
    console.log(JSON.stringify(info, null, 2));
    process.exit(0);
  }
  await new Promise((resolve) => setTimeout(resolve, 2000));
}
throw new Error(`mutation ${mutationId} was not readable within four minutes`);
JS
Générez trois vecteurs de documents déterministes. Le champ revision permet de reconnaître facilement le remplacement ultérieur ; l’objet complet de métadonnées représente les informations dont l’application de recherche aurait besoin après une mise à jour de la source.
cat > scripts/create-seed.mjs <<'JS'
import { writeFileSync } from "node:fs";

const DIMENSIONS = 384;
const documents = [
  { id: "password-reset", axis: 0, category: "account", title: "Reset your password" },
  { id: "upload-pdf", axis: 1, category: "files", title: "Upload a PDF" },
  { id: "billing-receipt", axis: 2, category: "billing", title: "Download a billing receipt" }
];

const rows = documents.map((document) => {
  const values = Array(DIMENSIONS).fill(0);
  values[document.axis] = 1;
  return {
    id: document.id,
    values,
    metadata: {
      category: document.category,
      published: true,
      title: document.title,
      revision: 1,
      model: "@cf/baai/bge-small-en-v1.5",
      pooling: "cls"
    }
  };
});

writeFileSync("vectors/seed.ndjson", rows.map(JSON.stringify).join("\n") + "\n");
console.log(`prepared ${rows.length} current documents`);
JS
node scripts/create-seed.mjs
Insérez uniquement de nouveaux IDs, conservez l’intégralité du résultat et attendez la mutation réelle :
set -o pipefail
npx wrangler vectorize insert "$RUN" --file=vectors/seed.ndjson 2>&1 | tee .labex/seed-output.txt
Ne continuez que lorsque Wrangler indique que trois vecteurs ont été mis en file d’attente et affiche un ID de mutation. Une erreur d’authentification ou de réseau ne permet pas de conclure ; corrigez-la avant d’attendre.
SEED_MUTATION_ID=$(sed -nE 's/.*Mutation changeset identifier: ([0-9a-f-]{36}).*/\1/p' .labex/seed-output.txt | tail -n 1)
if [ -z "$SEED_MUTATION_ID" ]; then
  printf '%s\n' 'No seed mutation ID was returned; fix the insert error before waiting.' >&2
else
  node scripts/wait-for-vectorize.mjs "$RUN" "$SEED_MUTATION_ID" 3
fi
npx wrangler vectorize list-vectors "$RUN" --count=10
L’inventaire doit contenir les trois ID d’application stables. insert convient ici, car ces IDs sont nouveaux ; à l’étape suivante, vous remplacerez volontairement un ID existant.
Mettre à jour l’article sur le mot de passe
Dans cette étape, vous allez remplacer le vecteur et les métadonnées de password-reset tout en conservant son ID stable.
Un upsert insère un ID absent ou remplace un ID existant. Le remplacement est utile lorsqu’un document source change, mais vous devez alors envoyer l’ensemble des métadonnées souhaitées. Ne supposez pas que les champs absents du nouvel enregistrement seront conservés.
Créez la révision 2 avec un axe déterministe différent et un titre mis à jour, tout en conservant chaque champ de métadonnées encore valide :
cat > scripts/create-update.mjs <<'JS'
import { writeFileSync } from "node:fs";

const values = Array(384).fill(0);
values[3] = 1;
const updated = {
  id: "password-reset",
  values,
  metadata: {
    category: "account",
    published: true,
    title: "Reset an expired password",
    revision: 2,
    model: "@cf/baai/bge-small-en-v1.5",
    pooling: "cls"
  }
};

writeFileSync("vectors/password-update.ndjson", JSON.stringify(updated) + "\n");
console.log("prepared password-reset revision 2");
JS
node scripts/create-update.mjs
Envoyez le remplacement et conservez son ID de mutation exact :
set -o pipefail
npx wrangler vectorize upsert "$RUN" --file=vectors/password-update.ndjson 2>&1 | tee .labex/upsert-output.txt
UPSERT_MUTATION_ID=$(sed -nE 's/.*Mutation changeset identifier: ([0-9a-f-]{36}).*/\1/p' .labex/upsert-output.txt | tail -n 1)
if [ -z "$UPSERT_MUTATION_ID" ]; then
  printf '%s\n' 'No upsert mutation ID was returned; fix the write error before waiting.' >&2
else
  node scripts/wait-for-vectorize.mjs "$RUN" "$UPSERT_MUTATION_ID" 3
fi
npx wrangler vectorize get-vectors "$RUN" --ids password-reset > .labex/password-after-upsert.txt
node - <<'JS'
const text = require("fs").readFileSync(".labex/password-after-upsert.txt", "utf8");
const [row] = JSON.parse(text.slice(text.indexOf("[")));
console.table([{ id: row.id, dimensions: row.values.length, changedAxis: row.values[3], title: row.metadata.title, revision: row.metadata.revision }]);
JS
Vous devez obtenir le même ID, 384 dimensions, l’axe 3 égal à 1, le titre mis à jour et la révision 2. Le nombre total reste égal à trois, car l’upsert a remplacé une identité existante au lieu d’ajouter un quatrième document.
Retirer un document sans reconstruire l’index
Dans cette étape, vous allez supprimer l’article de facturation retiré à l’aide de son ID stable et vérifier que l’article mis à jour sur le mot de passe ainsi que l’article intact sur l’envoi de fichiers sont toujours présents.
La suppression par ID est plus ciblée que la suppression d’un index : le contrat de l’index et tous les autres enregistrements restent en place. Envoyez uniquement l’ID retiré :
set -o pipefail
npx wrangler vectorize delete-vectors "$RUN" --ids billing-receipt 2>&1 | tee .labex/delete-output.txt
Attendez la mutation de suppression et un nombre de deux vecteurs :
DELETE_MUTATION_ID=$(sed -nE 's/.*Mutation changeset identifier: ([0-9a-f-]{36}).*/\1/p' .labex/delete-output.txt | tail -n 1)
if [ -z "$DELETE_MUTATION_ID" ]; then
  printf '%s\n' 'No delete mutation ID was returned; fix the write error before waiting.' >&2
else
  node scripts/wait-for-vectorize.mjs "$RUN" "$DELETE_MUTATION_ID" 2
fi
npx wrangler vectorize list-vectors "$RUN" --count=10
npx wrangler vectorize get-vectors "$RUN" --ids password-reset upload-pdf billing-receipt > .labex/documents-after-retirement.txt
node - <<'JS'
const text = require("fs").readFileSync(".labex/documents-after-retirement.txt", "utf8");
const rows = JSON.parse(text.slice(text.indexOf("[")));
console.table(rows.map((row) => ({ id: row.id, title: row.metadata.title, revision: row.metadata.revision })));
JS
Seuls password-reset en révision 2 et upload-pdf en révision 1 doivent rester. L’absence de billing-receipt est significative, car la même lecture authentifiée a également renvoyé les deux enregistrements qui devaient être conservés.
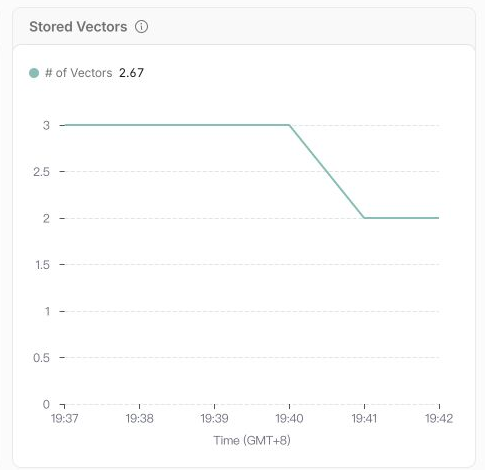
Ouvrez le compte sélectionné dans le Cloudflare Dashboard, puis accédez à AI → Vectorize et ouvrez l’index indiqué par $RUN. Vérifiez que le résumé indique deux vecteurs stockés. Dans le graphique Stored Vectors, reliez le cycle de vie visible aux commandes : le nombre passe à trois après la mutation d’initialisation, puis redescend à deux après la suppression ciblée. Le Dashboard n’indique pas quel ID a été supprimé ; les lectures effectuées avec Wrangler et l’API indépendante restent donc les preuves d’identité faisant foi.
Le résumé vous donne une vue immédiate de l’état actuel : deux documents restent interrogeables après le retrait d’un enregistrement.
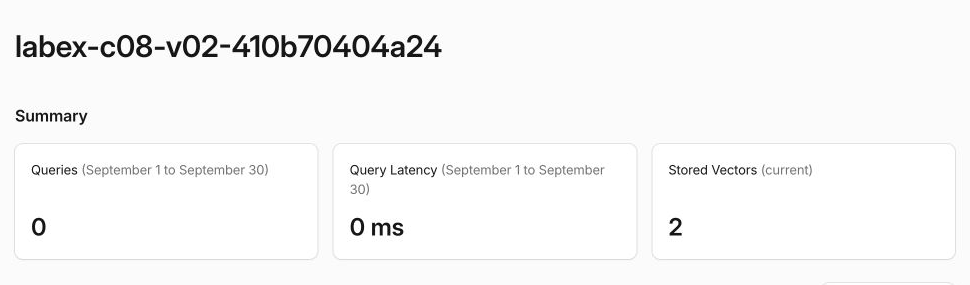
Le graphique représente visuellement le cycle de vie. Sa moyenne peut brièvement afficher un nombre décimal, car la ligne couvre plusieurs échantillons d’une minute ; l’élément important est la transition visible de trois vecteurs stockés à deux.
Supprimer l’index du cycle de vie et se déconnecter
Dans cette étape, vous allez supprimer l’intégralité de l’index temporaire uniquement après avoir vérifié le cycle de vie ciblé du document.
La suppression d’un vecteur à l’étape précédente a conservé l’index. La commande finale suivante supprime volontairement toute la ressource du lab :
npx wrangler vectorize delete "$RUN" --force
npx wrangler vectorize list --json > .labex/indexes-after-cleanup.json
node -e '
  const rows = JSON.parse(require("fs").readFileSync(process.argv[1], "utf8"));
  if (rows.some((row) => row.name === process.argv[2])) throw new Error("lab index still exists");
  console.log("lab index is absent");
' .labex/indexes-after-cleanup.json "$RUN"
Effectuez la vérification de nettoyage du lab tant que l’inventaire authentifié réussi est encore disponible. Gardez Wrangler autorisé jusqu’à la réussite de cette vérification, car une déconnexion préalable rendrait une erreur d’authentification impossible à distinguer d’une suppression réussie.
Supprimez ensuite l’autorisation de cette VM et examinez le résultat structuré :
npx wrangler logout
npx wrangler whoami --json
La sortie attendue contient loggedIn: false. La session distincte du Dashboard dans le navigateur reste disponible pour votre compte d’apprentissage.
Résumé
Vous avez commencé avec trois ID de documents actuels, utilisé upsert pour remplacer le vecteur et les métadonnées complets d’un article révisé, puis utilisé une suppression ciblée pour retirer un article obsolète. Les ID de mutation exacts et les lectures consécutives limitées ont permis de distinguer les écritures acceptées de l’état réellement lisible.
Vous avez également vérifié les deux propriétés de sécurité importantes dans un pipeline d’indexation réel : une mise à jour n’a pas créé de doublon d’identité et un retrait n’a pas supprimé les documents indépendants. Enfin, vous avez relié l’état à deux enregistrements au Dashboard, supprimé l’index temporaire, confirmé son absence avec une requête authentifiée et déconnecté la nouvelle VM.
V03 générera un embedding de requête en temps réel avec le même contrat de modèle et utilisera l’index maintenu pour retrouver des articles d’aide similaires.