Introduction
Dans le laboratoire précédent consacré aux embeddings de Workers AI, le texte est devenu un embedding : une liste ordonnée de nombres qui représente des relations utiles entre les significations. Un embedding n'est ni l'article d'origine ni une réponse générée. Il devient utile pour la recherche uniquement lorsqu'une application peut le stocker avec un identifiant de document stable, puis retrouver ultérieurement les vecteurs qui en sont proches.
Cloudflare Vectorize est une base de données vectorielle. Contrairement à une table conçue autour de lignes et de colonnes, un index vectoriel est conçu pour comparer efficacement des vecteurs numériques. Lors de sa création, chaque index fixe deux choix de compatibilité :
- dimensions — le nombre de nombres contenus dans chaque vecteur ;
- distance metric — la méthode utilisée par Vectorize pour déterminer quels vecteurs sont les plus proches.
Vous allez créer un index de 384 dimensions pour les embeddings @cf/baai/bge-small-en-v1.5 hébergés par Cloudflare et choisir la distance cosinus, la même comparaison fondée sur la direction que celle présentée dans A04. Vous ajouterez des index de métadonnées pour category et published, insérerez trois petits vecteurs synthétiques d'articles d'aide, attendrez que la mutation asynchrone devienne lisible, puis vérifierez qu'un vecteur de trois dimensions est rejeté.
Il s'agit du premier laboratoire du cours Vectorize. Si vous êtes arrivé directement ici, terminez d'abord Connect LabEx to Your Cloudflare Account afin d'apprendre à utiliser le terminal de la VM LabEx, à autoriser Wrangler, à confirmer votre compte d'apprentissage et à configurer son ID de compte. Terminez d'abord le laboratoire Workers AI A04 si les vecteurs, les dimensions ou la similarité cosinus ne vous sont pas familiers.
Vectorize est disponible avec Workers Free. Le quota inclus actuel est largement supérieur aux trois vecteurs de 384 dimensions et aux vérifications en lecture seule de ce laboratoire ; Workers Paid n'est donc pas nécessaire. Ce laboratoire n'appelle pas Workers AI et ne consomme aucun Neuron.
La configuration installe Node.js 22.22.0 et Wrangler 4.132.0 dans /home/labex/project/document-vector-index. Elle fournit également des vérifications indépendantes en lecture seule. La configuration n'autorise pas Wrangler, ne crée pas d'index, n'écrit pas de vecteurs et ne modifie pas votre compte Cloudflare.
Autoriser la VM et nommer l'index
Dans cette étape, vous allez autoriser la nouvelle VM, sélectionner le compte d'apprentissage souhaité et enregistrer un nom d'index temporaire unique.
La connexion au tableau de bord Cloudflare appartient à votre navigateur. Wrangler, dans cette nouvelle VM, est un client distinct ; il a donc besoin d'une autorisation limitée avant de pouvoir gérer des ressources Vectorize.
Accédez au projet préparé et confirmez la version verrouillée de la CLI :
cd /home/labex/project/document-vector-index
npx wrangler --version
La sortie attendue est 4.132.0. Demandez l'identité du compte et l'autorisation de gérer les ressources Workers. Dans cette version de Wrangler, le périmètre OAuth workers:write inclut les opérations de gestion Vectorize utilisées ici ; le laboratoire ne demande pas de périmètre AI, car il n'effectue aucune inférence.
npx wrangler login --device --browser=false --scopes account:read user:read workers:write
Ouvrez le lien affiché, saisissez le code actuel, vérifiez le compte et les autorisations, puis autorisez votre compte d'apprentissage. Inspectez ensuite les données d'identité structurées :
npx wrangler whoami --json
Vérifiez que loggedIn: true apparaît et identifiez le compte d'apprentissage souhaité. Générez un nom d'index temporaire unique :
RUN="labex-c08-v01-$(openssl rand -hex 6)"
printf '%s\n' "$RUN"
Remplacez YOUR_ACCOUNT_ID par l'ID réel de ce compte :
cat > wrangler.jsonc <<JSON
{
  "\$schema": "./node_modules/wrangler/config-schema.json",
  "name": "$RUN-tools",
  "account_id": "YOUR_ACCOUNT_ID",
  "compatibility_date": "2026-09-16",
  "vectorize": [
    { "binding": "DOCUMENTS", "index_name": "$RUN", "remote": true }
  ]
}
JSON
Le binding enregistre la relation que les prochains laboratoires utiliseront dans le code du Worker : DOCUMENTS est le nom utilisé par l'application, tandis que index_name désigne la ressource cloud gérée. remote: true signifie qu'un Worker local se connecterait au véritable index distant plutôt qu'à une simulation locale isolée.
Créer l'index et ses champs filtrables
Dans cette étape, vous allez définir le contrat vectoriel fixe et préparer deux champs de métadonnées pour les filtrages ultérieurs.
Les dimensions et la métrique de distance d'un index sont fixes, car chaque comparaison doit respecter le même contrat numérique. BGE Small produit 384 nombres. La distance cosinus compare la direction des vecteurs, ce qui convient aux embeddings orientés vers le sens présentés dans A04.
Créez l'index V2 :
npx wrangler vectorize create "$RUN" --dimensions=384 --metric=cosine --update-config=false
Les vecteurs peuvent également contenir de petites métadonnées, comme la catégorie d'un document. Le stockage de métadonnées ne les rend pas automatiquement filtrables. Un index de métadonnées indique à Vectorize le champ à préparer pour les filtres. Créez ces champs avant d'insérer les vecteurs :
npx wrangler vectorize create-metadata-index "$RUN" --propertyName=category --type=string | tee .labex/category-index-output.txt
npx wrangler vectorize create-metadata-index "$RUN" --propertyName=published --type=boolean | tee .labex/published-index-output.txt
--update-config=false empêche Wrangler de proposer de remplacer le binding que vous avez déjà écrit. La création d'un index de métadonnées est asynchrone. Chaque commande place une mutation dans la file d'attente ; un message de réussite signifie donc que Cloudflare a accepté la modification, et non que toutes les lectures la voient déjà.
Créez un outil d'attente réutilisable. Il exécute uniquement la commande en lecture seule vectorize info, compare l'ID exact de la mutation et exige trois lectures concordantes consécutives avant de considérer le résultat comme fiable. Cette confirmation supplémentaire évite de présenter une réplique de lecture momentanément obsolète comme l'état final. Après quatre minutes, l'outil s'arrête avec une erreur au lieu d'attendre indéfiniment :
cat > scripts/wait-for-vectorize.mjs <<'JS'
import { execFileSync } from "node:child_process";

const [indexName, mutationId, expectedCountText] = process.argv.slice(2);
const expectedCount = Number(expectedCountText);
const wrangler = "./node_modules/wrangler/bin/wrangler.js";
let consecutiveMatches = 0;

for (let attempt = 1; attempt <= 120; attempt += 1) {
  const output = execFileSync(process.execPath, [wrangler, "vectorize", "info", indexName, "--json"], { encoding: "utf8" });
  const info = JSON.parse(output);
  if (info.processedUpToMutation === mutationId && info.vectorCount === expectedCount) {
    consecutiveMatches += 1;
  } else {
    consecutiveMatches = 0;
  }
  if (consecutiveMatches === 3) {
    console.log(`mutation ${mutationId} is consistently readable with ${expectedCount} vectors`);
    console.log(JSON.stringify(info, null, 2));
    process.exit(0);
  }
  await new Promise((resolve) => setTimeout(resolve, 2000));
}
throw new Error(`mutation ${mutationId} was not readable within four minutes`);
JS

METADATA_MUTATION_ID=$(sed -nE 's/.*Mutation changeset identifier: ([0-9a-f-]{36}).*/\1/p' .labex/published-index-output.txt | tail -n 1)
test -n "$METADATA_MUTATION_ID"
node scripts/wait-for-vectorize.mjs "$RUN" "$METADATA_MUTATION_ID" 0
npx wrangler vectorize get "$RUN"
npx wrangler vectorize list-metadata-index "$RUN"
Les tableaux finaux doivent afficher 384 dimensions, la distance cosinus, category comme String et published comme Bool. Bool est le nom d'affichage actuel de l'API pour le champ créé avec --type=boolean. Attendre la deuxième mutation de métadonnées évite que l'insertion des prochains vecteurs reste bloquée par la préparation inachevée de l'index.
Construire des vecteurs de documents identifiés
Dans cette étape, vous allez générer un petit jeu de vecteurs transparent dont les identifiants et les métadonnées peuvent être vérifiés indépendamment.
Une base de données vectorielle ne remplace pas le document source. Chaque vecteur a besoin d'un identifiant stable que votre application peut associer au contenu réel. Ce laboratoire utilise trois identifiants synthétiques d'articles d'aide et enregistre comme métadonnées leur catégorie, leur état de publication, le modèle d'embedding et le choix de pooling.
Les embeddings réels seront utilisés dans V03. Ici, des vecteurs déterministes rendent le comportement du stockage reproductible et gratuit : chaque document pointe le long d'un axe différent, puis est complété par des zéros jusqu'à atteindre 384 positions.
Créez le générateur de données transparent :
cat > scripts/create-vectors.mjs <<'JS'
import { writeFileSync } from "node:fs";

const DIMENSIONS = 384;
const MODEL = "@cf/baai/bge-small-en-v1.5";
const POOLING = "cls";
const documents = [
  { id: "password-reset", axis: 0, category: "account" },
  { id: "upload-pdf", axis: 1, category: "files" },
  { id: "billing-receipt", axis: 2, category: "billing" }
];

function unitVector(axis) {
  const values = Array(DIMENSIONS).fill(0);
  values[axis] = 1;
  return values;
}

const rows = documents.map((document) => ({
  id: document.id,
  values: unitVector(document.axis),
  metadata: {
    category: document.category,
    published: true,
    model: MODEL,
    pooling: POOLING
  }
}));

writeFileSync("vectors/documents.ndjson", rows.map(JSON.stringify).join("\n") + "\n");
console.log(`wrote ${rows.length} vectors with ${DIMENSIONS} dimensions each`);
JS
node scripts/create-vectors.mjs
NDJSON signifie JSON délimité par des sauts de ligne : un objet vectoriel complet par ligne, plutôt qu'un tableau JSON englobant l'ensemble. Wrangler peut diffuser ce format par lots. Inspectez les identifiants et les dimensions sans afficher les 1 152 nombres :
node - <<'JS'
const rows = require("fs").readFileSync("vectors/documents.ndjson", "utf8").trim().split("\n").map(JSON.parse);
console.table(rows.map(({ id, values, metadata }) => ({ id, dimensions: values.length, category: metadata.category, published: metadata.published })));
JS
Les trois lignes doivent indiquer 384 dimensions. Les métadonnées du modèle et du pooling cls documentent la compatibilité ; Vectorize ne déduit pas et ne valide pas cette signification sémantique à votre place.
Insérer les vecteurs et attendre leur mutation
Dans cette étape, vous allez insérer un lot et attendre que sa mutation asynchrone exacte devienne visible dans les lectures.
Les écritures Vectorize sont asynchrones. Une insertion atteint d'abord un journal d'écriture durable et renvoie un ID de mutation. Le traitement en arrière-plan rend ensuite cette mutation visible pour les lectures. Cette conception rend les écritures efficaces, mais signifie que « acceptée » et « lisible » correspondent à deux moments différents.
Insérez le lot de trois vecteurs et conservez le résultat complet. pipefail empêche qu'un échec de Wrangler soit masqué par la réussite de la commande tee qui suit :
set -o pipefail
npx wrangler vectorize insert "$RUN" --file=vectors/documents.ndjson 2>&1 | tee .labex/insert-output.txt
Ne continuez qu'après le message de Wrangler indiquant qu'il a mis trois vecteurs en file d'attente et affichant un identifiant de mutation. Si l'API renvoie à la place une erreur d'authentification ou de réseau, ce résultat ne permet pas de conclure : vérifiez npx wrangler whoami --json, puis exécutez une fois de plus ce même bloc d'insertion. Ne démarrez pas l'outil d'attente sans véritable ID de mutation.
Extrayez la mutation acceptée et attendez uniquement lorsqu'elle existe :
MUTATION_ID=$(sed -nE 's/.*Mutation changeset identifier: ([0-9a-f-]{36}).*/\1/p' .labex/insert-output.txt | tail -n 1)
if [ -z "$MUTATION_ID" ]; then
  printf '%s\n' 'No mutation ID was returned; fix the insert error before waiting.' >&2
else
  printf 'Waiting for mutation %s\n' "$MUTATION_ID"
  node scripts/wait-for-vectorize.mjs "$RUN" "$MUTATION_ID" 3
fi
Le JSON final de l'outil d'attente doit afficher vectorCount égal à 3 ainsi que l'ID de mutation enregistré. Exiger trois lectures concordantes rend le résultat visible par l'apprenant résistant à un bref retard de réplication. Une interrogation limitée dans le temps est plus sûre qu'une attente fixe : une mutation rapide se termine rapidement, tandis qu'une mutation saine mais plus lente dispose du temps nécessaire sans générer de nouvelles écritures en double.
Lire les documents et tester la compatibilité
Dans cette étape, vous allez lire les enregistrements acceptés, observer le rejet d'une écriture incompatible et relier l'état de la CLI à celui du tableau de bord.
Lisez les enregistrements stockés à l'aide de leurs identifiants d'application :
Enregistrez les enregistrements complets, puis affichez un tableau compact au lieu d'encombrer le terminal avec 1 152 nombres :
npx wrangler vectorize get-vectors "$RUN" --ids password-reset upload-pdf billing-receipt > .labex/stored-vectors.txt
node - <<'JS'
const text = require("fs").readFileSync(".labex/stored-vectors.txt", "utf8");
const rows = JSON.parse(text.slice(text.indexOf("[")));
console.table(rows.map(({ id, values, metadata }) => ({ id, dimensions: values.length, category: metadata.category, published: metadata.published })));
JS
Chaque ligne du résumé doit conserver son identifiant, sa structure de 384 valeurs et ses métadonnées. Le fichier brut contient toutes les valeurs pour permettre une vérification indépendante. get-vectors lit des enregistrements connus ; il ne s'agit pas d'une recherche par similarité. Les requêtes de similarité seront présentées dans V03.
Créez maintenant un enregistrement volontairement incompatible contenant seulement trois valeurs :
cat > vectors/incompatible.ndjson <<'NDJSON'
{"id":"wrong-dimensions","values":[1,0,0],"metadata":{"category":"account","published":true}}
NDJSON
if npx wrangler vectorize insert "$RUN" --file=vectors/incompatible.ndjson > .labex/incompatible.log 2>&1; then
  STATUS=0
else
  STATUS=$?
fi
printf '%s\n' "$STATUS" > .labex/incompatible-exit.txt
sed -n '/invalid vector/p' .labex/incompatible.log
test "$STATUS" -ne 0
Ce rejet protège le contrat de l'index : un vecteur de trois positions ne peut pas être comparé de manière pertinente avec des vecteurs de 384 positions. Vérifiez que les enregistrements acceptés sont toujours présents et que l'identifiant rejeté n'apparaît pas :
npx wrangler vectorize info "$RUN"
npx wrangler vectorize list-vectors "$RUN" --count=10
npx wrangler vectorize get-vectors "$RUN" --ids wrong-dimensions
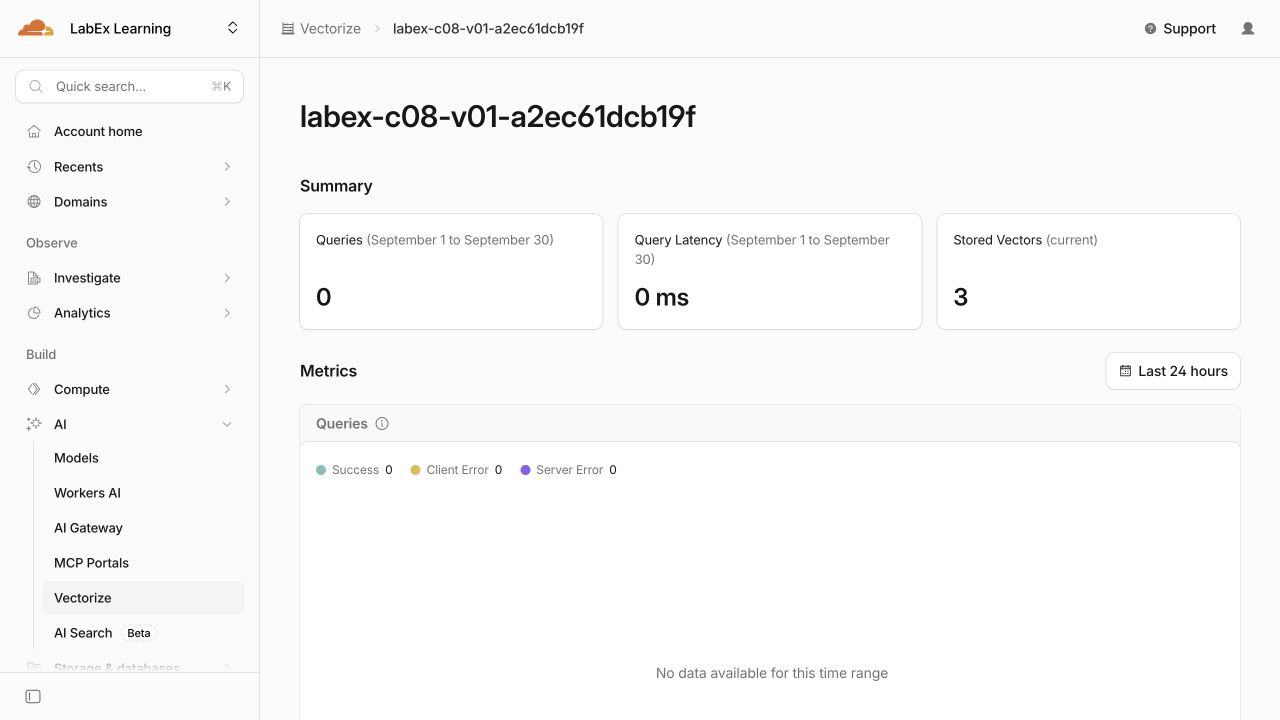
Ouvrez le tableau de bord Cloudflare pour le compte sélectionné et accédez à AI → Vectorize. L'inventaire relie le nom de la CLI à l'index réel, affiche 384 dimensions et la distance cosinus, et indique un total de trois vecteurs sans utilisation facturable dans cet exemple réduit.
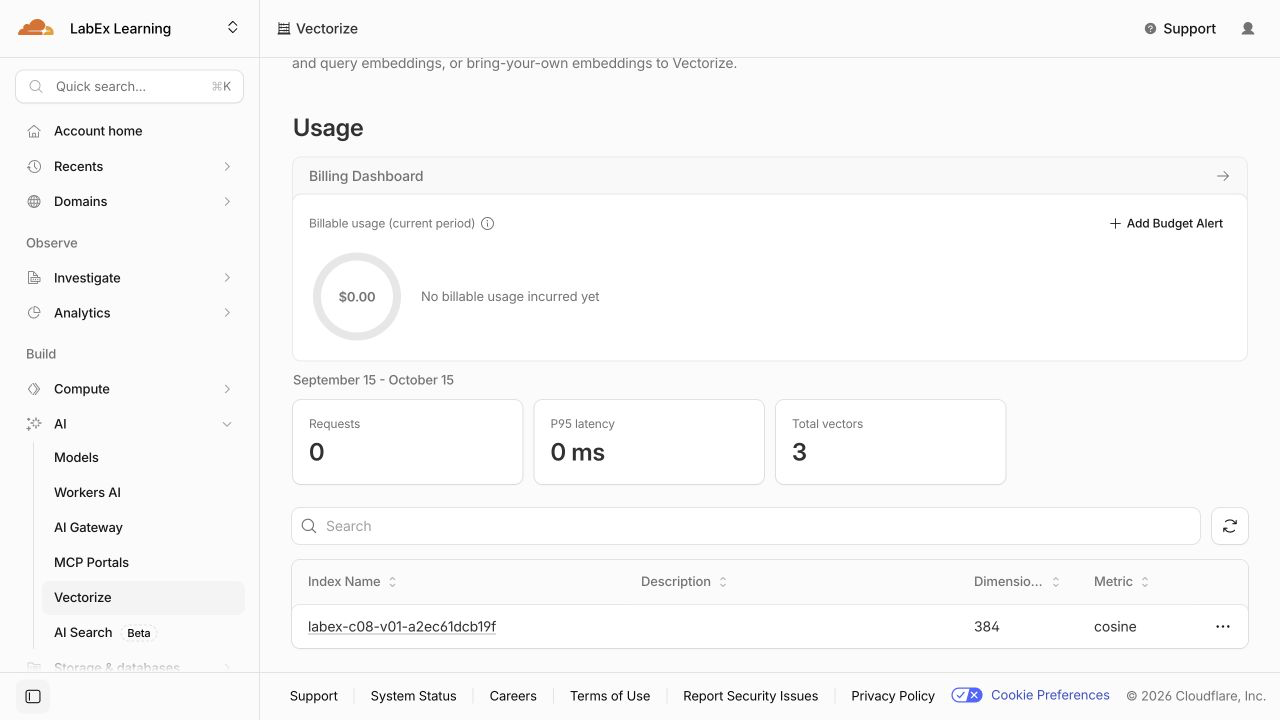
Ouvrez l'index nommé dans $RUN. Son résumé affiche trois vecteurs actuellement stockés. Le nombre de requêtes reste égal à zéro, car ce premier laboratoire utilise des lectures par identifiant ; les requêtes de similarité commencent dans V03.
Faites défiler la page jusqu'à Stored Vectors. Le graphique rend concrète la visibilité asynchrone : le nombre reste d'abord à zéro, puis passe à trois lorsque la mutation d'insertion est traitée.
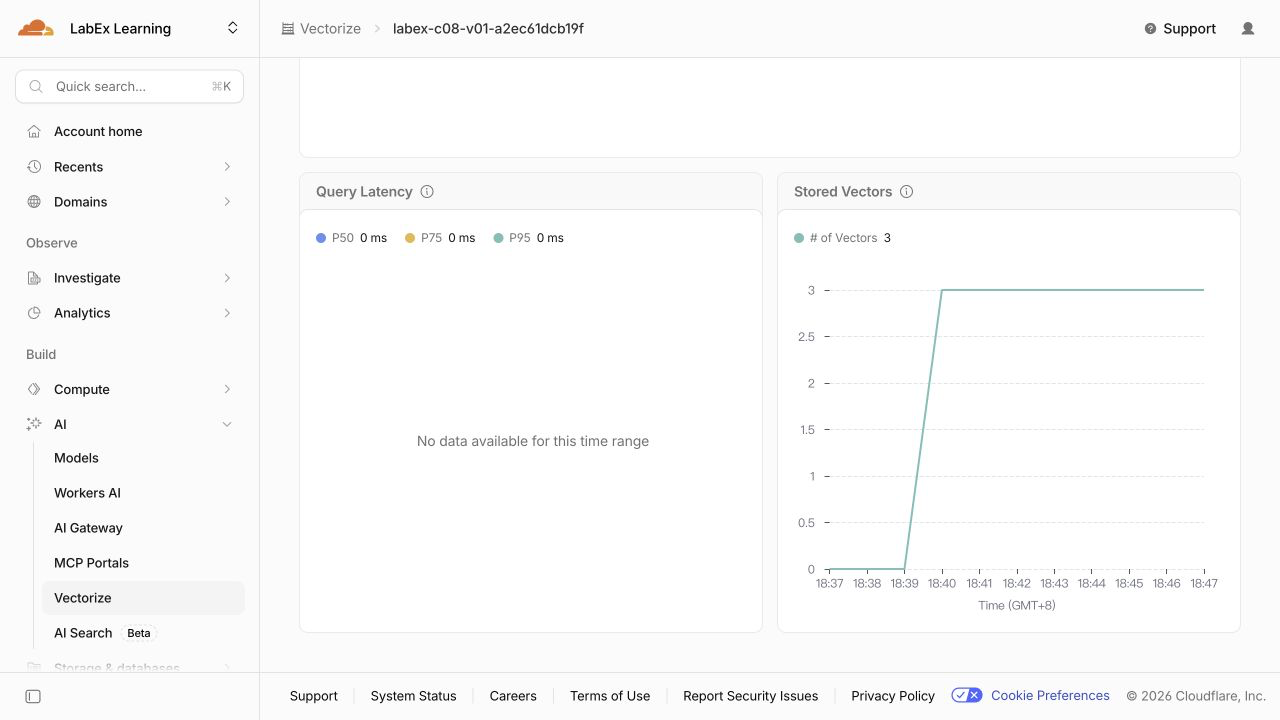
Le tableau de bord actuel ne répertorie ni les identifiants individuels des vecteurs ni les définitions des index de métadonnées. Utilisez les lectures Wrangler précédentes pour password-reset, upload-pdf, billing-receipt, category et published ; ne déduisez pas ces informations d'un graphique qui n'affiche qu'un total. Les pages du tableau de bord aident à se repérer, tandis que les vérifications indépendantes utilisent des lectures d'API faisant autorité.
Les captures d'écran présentées ici après l'acceptation cloud du laboratoire sont des exemples issus d'une exécution temporaire. Le nom aléatoire de votre index et vos horodatages seront différents ; faites correspondre la configuration et les identifiants gérés, plutôt que de recopier les valeurs d'exemple.
Supprimer l'index temporaire et se déconnecter
Dans cette étape, vous allez supprimer l'index exact qui vous appartient, prouver son absence par une lecture authentifiée, puis supprimer l'autorisation de la VM.
L'index, ses index de métadonnées et ses vecteurs constituent une seule ressource temporaire. Supprimez le nom exact enregistré dans wrangler.jsonc tant que l'autorisation est encore disponible :
npx wrangler vectorize delete "$RUN" --force
Confirmez son absence au moyen d'une lecture d'inventaire authentifiée :
npx wrangler vectorize list --json > .labex/indexes-after-cleanup.json
node -e '
  const rows = JSON.parse(require("fs").readFileSync(process.argv[1], "utf8"));
  if (rows.some((row) => row.name === process.argv[2])) throw new Error("lab index still exists");
  console.log("lab index is absent");
' .labex/indexes-after-cleanup.json "$RUN"
La réussite de cet inventaire est importante : une erreur réseau ou d'autorisation ne prouverait pas la suppression. Exécutez l'évaluation du nettoyage avant de révoquer l'autorisation de la VM :
bash verify6-1.sh
Supprimez enfin la connexion Wrangler de la VM et inspectez le résultat structuré :
npx wrangler logout
npx wrangler whoami --json
La sortie attendue contient loggedIn: false. La connexion au tableau de bord dans le navigateur est distincte et reste disponible pour votre compte d'apprentissage.
Résumé
Vous avez créé un index Vectorize V2 avec le même contrat de 384 dimensions que le modèle d'embedding sélectionné, choisi la distance cosinus et préparé deux champs de métadonnées pour les filtres ultérieurs. Vous avez généré des vecteurs déterministes identifiés, les avez insérés au format NDJSON, distingué une mutation asynchrone acceptée d'une mutation traitée, puis relu les enregistrements stockés par identifiant.
Vous avez également démontré que Vectorize rejette un vecteur dont les dimensions sont incorrectes tout en conservant les enregistrements compatibles. Enfin, vous avez inspecté la ressource réelle dans le tableau de bord, supprimé l'index temporaire exact, confirmé son absence par une lecture authentifiée et supprimé l'autorisation Wrangler de la nouvelle VM.
Le prochain laboratoire s'appuie sur ce cycle de vie avec upsert et la suppression, afin que les documents modifiés ou retirés ne laissent pas l'index obsolète.