Introduction
V03 transformait les questions en embeddings et récupérait les articles d'aide proches. V04 conservait ces résultats dans une limite contrôlée par le serveur, définie par le client et la catégorie. La récupération est utile en elle-même, mais de nombreuses applications de support nécessitent une étape supplémentaire : transformer les passages approuvés en une réponse courte en langage naturel.
Ce modèle s'appelle la génération augmentée par récupération, généralement abrégée en RAG. L'application récupère d'abord les éléments de preuve, construit un petit contexte à partir de ces seuls enregistrements, puis demande à un modèle de langage de répondre à partir de ce contexte. La récupération ne rend pas automatiquement un modèle fiable. L'application doit toujours contrôler les sources admissibles, limiter la quantité de texte insérée dans le prompt, conserver l'identité des sources et s'arrêter lorsqu'aucune preuve approuvée n'existe.
Vous allez construire un Worker temporaire avec deux bindings Cloudflare. DOCUMENTS recherche dans un index Vectorize, tandis que AI exécute à la fois le modèle d'embedding BGE Small et un modèle Cloudflare de génération de texte basé sur Llama. Le Worker résout les ID vectoriels renvoyés à l'aide d'un corpus fourni dans le code ; les métadonnées vectorielles sont utiles pour la recherche, mais ne sont pas considérées comme le contenu canonique des articles.
L'endpoint renverra un tableau sources contrôlé par l'application à côté de la réponse générée. Si la récupération ne trouve rien dans l'espace de noms et la catégorie sélectionnés, il renverra une réponse fixe no_evidence sans appeler le modèle de génération de texte. Cette branche explicite est plus sûre que de demander au modèle d'improviser.
Si vous avez accédé directement à ce cours, commencez par terminer Connect LabEx to Your Cloudflare Account. V01 à V04 sont des prérequis : ils présentent les index compatibles, les mutations asynchrones, la récupération sémantique et la portée contrôlée par le serveur.
Ce lab utilise le modèle Cloudflare @cf/meta/llama-3.3-70b-instruct-fp8-fast, car il a déjà été testé sur Workers Free dans le cours Workers AI précédent. DeepSeek V4 Flash est hébergé par Cloudflare, mais nécessite actuellement un accès payant ; il ne constitue donc pas une dépendance obligatoire pour l'apprenant. Le lab envoie uniquement des requêtes d'embedding et de génération limitées ; Workers Paid n'est pas nécessaire tant que l'allocation gratuite partagée de Workers AI du compte reste disponible.
La configuration installe Node.js 22.22.0 et Wrangler 4.132.0 local au projet dans /home/labex/project/grounded-answer. Elle fournit des tests déterministes et des vérifications indépendantes en lecture seule, mais n'autorise pas Wrangler, ne crée pas d'index, ne déploie pas de Worker, n'exécute pas d'inférence et n'insère pas de données dans le cloud.
Autoriser Wrangler et nommer les ressources RAG
Dans cette étape, vous allez autoriser cette nouvelle VM, vérifier le compte d'apprentissage et définir un Worker ainsi qu'un index Vectorize associés avant de créer quoi que ce soit.
Accédez au projet préparé et vérifiez les versions des outils verrouillées :
cd /home/labex/project/grounded-answer
node --version
npx wrangler --version
Vous devez obtenir Node.js v22.22.0 et Wrangler 4.132.0. La connexion au Dashboard dans votre navigateur n'autorise pas automatiquement cette VM. Utilisez donc le flux d'autorisation par appareil de Wrangler avec les permissions nécessaires pour l'identité du compte, le Worker temporaire, Vectorize et Workers AI :
npx wrangler login --device --browser=false --scopes account:read user:read workers:write workers_scripts:write workers_kv:write ai:write
npx wrangler whoami --json
Ouvrez le lien d'autorisation affiché, vérifiez que le code correspond et approuvez le compte LabEx Learning prévu. Ne communiquez le code, le mot de passe ou le jeton à personne. Dans le résultat JSON, vérifiez loggedIn: true, puis notez le nom et l'ID du compte.
Générez un suffixe aléatoire. Les deux noms de ressources le partageront afin que le nettoyage puisse identifier exactement cette paire :
RUN="labex-c08-v05-$(openssl rand -hex 6)"
INDEX="$RUN-docs"
printf 'Worker: %s\nIndex: %s\n' "$RUN" "$INDEX"
Créez wrangler.jsonc. Un document here-document écrit dans le fichier le bloc situé entre les marqueurs JSON ; $RUN et $INDEX sont remplacés par les noms uniques de cette VM. Remplacez YOUR_ACCOUNT_ID par l'ID affiché par whoami :
cat > wrangler.jsonc <<JSON
{
  "\$schema": "./node_modules/wrangler/config-schema.json",
  "name": "$RUN",
  "main": "src/index.js",
  "compatibility_date": "2026-09-16",
  "compatibility_flags": ["nodejs_compat"],
  "account_id": "YOUR_ACCOUNT_ID",
  "workers_dev": true,
  "preview_urls": false,
  "observability": { "enabled": true },
  "ai": { "binding": "AI" },
  "vectorize": [
    { "binding": "DOCUMENTS", "index_name": "$INDEX", "remote": true }
  ]
}
JSON
AI correspond à un seul binding, même si le code l'utilisera pour appeler deux modèles. DOCUMENTS pointe vers l'index associé. Le fichier définit les ressources prévues, mais n'en crée encore aucune.
Construire le Worker de récupération puis génération
Dans cette étape, vous allez implémenter toute la séquence RAG et vérifier ses décisions avec des bindings déterministes en mémoire avant d'utiliser le quota cloud.
Le CORPUS fourni est la table canonique qui associe les ID aux textes. Vectorize stocke les embeddings et les métadonnées interrogeables ; après une requête, le Worker n'accepte que les ID qui peuvent être résolus dans cette table. Il inclut ensuite au maximum deux passages dans le prompt. Ainsi, un enregistrement inattendu de l'index ne peut pas devenir du contexte du modèle simplement parce qu'il a obtenu un score élevé.
Créez le code source du Worker :
cat > src/index.js <<'JS'
export const EMBEDDING_MODEL = "@cf/baai/bge-small-en-v1.5";
export const ANSWER_MODEL = "@cf/meta/llama-3.3-70b-instruct-fp8-fast";
const DIMENSIONS = 384;
const POOLING = "cls";
const ALLOWED_CATEGORIES = new Set(["account", "billing", "files"]);

export const CORPUS = [
  {
    id: "password-reset",
    namespace: "customer-blue",
    category: "account",
    title: "Reset a password",
    url: "https://support.example.test/articles/password-reset",
    text: "If a password expires, open the sign-in page, choose Forgot password, and use the one-time reset link sent to the verified email address."
  },
  {
    id: "mfa-recovery",
    namespace: "customer-blue",
    category: "account",
    title: "Recover multi-factor access",
    url: "https://support.example.test/articles/mfa-recovery",
    text: "If the authenticator device is unavailable, enter a saved recovery code. Contact an administrator only after all recovery codes are exhausted."
  },
  {
    id: "billing-receipt",
    namespace: "customer-blue",
    category: "billing",
    title: "Download a billing receipt",
    url: "https://support.example.test/articles/billing-receipt",
    text: "Open Billing, select a completed payment, and choose Download receipt to save a PDF copy."
  }
];

const CORPUS_BY_ID = new Map(CORPUS.map((item) => [item.id, item]));

function json(value, status = 200) {
  return Response.json(value, { status });
}

export function resolveSession(value) {
  if (value === "blue-session") return { customer: "blue", namespace: "customer-blue" };
  throw new Error("session_invalid");
}

export function parseAnswerInput(value) {
  if (!value || typeof value !== "object" || Array.isArray(value)) throw new Error("invalid_json");
  for (const key of ["customer", "customerId", "namespace", "sources", "context"]) {
    if (Object.prototype.hasOwnProperty.call(value, key)) throw new Error("scope_override_not_allowed");
  }
  const question = typeof value.question === "string" ? value.question.trim() : "";
  const category = typeof value.category === "string" ? value.category.trim() : "";
  if (!question || question.length > 240) throw new Error("question_required");
  if (!ALLOWED_CATEGORIES.has(category)) throw new Error("category_invalid");
  return { question, category };
}

export function validateEmbeddingBatch(result, expectedCount) {
  const vectors = result?.data;
  if (!Array.isArray(vectors) || vectors.length !== expectedCount || result?.shape?.[1] !== DIMENSIONS) {
    throw new Error("incompatible embedding batch");
  }
  for (const vector of vectors) {
    if (!Array.isArray(vector) || vector.length !== DIMENSIONS || !vector.every(Number.isFinite)) {
      throw new Error("invalid embedding vector");
    }
  }
  return vectors;
}

async function embed(env, texts) {
  const result = await env.AI.run(EMBEDDING_MODEL, { text: texts, pooling: POOLING });
  return validateEmbeddingBatch(result, texts.length);
}

async function seed(env) {
  const vectors = await embed(env, CORPUS.map((item) => item.text));
  const records = CORPUS.map((item, index) => ({
    id: item.id,
    namespace: item.namespace,
    values: vectors[index],
    metadata: {
      category: item.category,
      title: item.title,
      model: EMBEDDING_MODEL,
      pooling: POOLING
    }
  }));
  const mutation = await env.DOCUMENTS.upsert(records);
  console.log(JSON.stringify({ event: "grounding_sources_seeded", count: records.length, mutationId: mutation.mutationId }));
  return json({ mutationId: mutation.mutationId, count: records.length, model: EMBEDDING_MODEL, dimensions: DIMENSIONS, pooling: POOLING }, 202);
}

function noEvidence(category, candidateCount) {
  console.log(JSON.stringify({ event: "grounded_no_evidence", category, candidateCount }));
  return json({
    mode: "no_evidence",
    generated: false,
    answer: "I don't have enough approved evidence to answer that question.",
    sources: []
  });
}

async function answer(request, env) {
  let scope;
  try {
    scope = resolveSession(request.headers.get("x-lab-session") ?? "");
  } catch {
    return json({ error: "session_invalid" }, 401);
  }

  let input;
  try {
    input = parseAnswerInput(await request.json());
  } catch (error) {
    return json({ error: error instanceof Error ? error.message : "invalid_json" }, 400);
  }

  const [queryVector] = await embed(env, [input.question]);
  const result = await env.DOCUMENTS.query(queryVector, {
    topK: 2,
    namespace: scope.namespace,
    filter: { category: input.category },
    returnMetadata: "all"
  });

  const sources = result.matches.flatMap((match) => {
    const article = CORPUS_BY_ID.get(match.id);
    if (!article || article.namespace !== scope.namespace || article.category !== input.category) return [];
    return [{
      id: article.id,
      title: article.title,
      url: article.url,
      text: article.text,
      score: match.score
    }];
  });

  if (sources.length === 0) return noEvidence(input.category, result.matches.length);

  const context = sources.map((source) =>
    "[source:" + source.id + "] " + source.title + "\n" + source.text
  ).join("\n\n");
  const generation = await env.AI.run(ANSWER_MODEL, {
    messages: [
      {
        role: "system",
        content: "Answer only from the supplied support context. Keep the answer under 80 words. Cite supporting source IDs in square brackets. If the context is insufficient, say you do not have enough approved evidence."
      },
      {
        role: "user",
        content: "Question: " + input.question + "\n\nApproved context:\n" + context
      }
    ],
    max_tokens: 160,
    temperature: 0
  });
  const generatedAnswer = typeof generation?.response === "string" ? generation.response.trim() : "";
  if (!generatedAnswer) return json({ error: "generation_failed" }, 502);

  const references = sources.map(({ id, title, url, score }) => ({ id, title, url, score }));
  console.log(JSON.stringify({
    event: "grounded_answer",
    customer: scope.customer,
    namespace: scope.namespace,
    category: input.category,
    sourceIds: references.map((source) => source.id),
    sourceCount: references.length
  }));
  return json({
    mode: "grounded",
    generated: true,
    model: ANSWER_MODEL,
    answer: generatedAnswer,
    sources: references
  });
}

export default {
  async fetch(request, env) {
    const url = new URL(request.url);
    if (request.method === "POST" && url.pathname === "/seed") return seed(env);
    if (request.method === "POST" && url.pathname === "/answer") return answer(request, env);
    return json({ error: "not_found" }, 404);
  }
};
JS
Observez l'ordre des opérations dans answer() : valider la portée gérée par le serveur, transformer la question en embedding, récupérer au maximum deux correspondances admissibles, résoudre chaque ID dans CORPUS, construire un contexte limité, puis générer la réponse. La réponse publique exclut le texte complet du contexte et les valeurs vectorielles, mais conserve des références de sources résolubles.
Exécutez la suite de tests déterministes :
node --test test/worker.test.mjs
Vous devez obtenir sept tests réussis. Les bindings simulés vérifient que les ID inconnus et une récupération vide n'atteignent jamais la génération de texte. Générez les types des bindings et créez le bundle du projet sans le déployer :
npx wrangler types
npx wrangler deploy --dry-run --outdir /tmp/v05-dry-run
Les types générés doivent inclure AI: Ai et DOCUMENTS: VectorizeIndex. Une exécution à blanc confirme que les fichiers peuvent être regroupés ; elle ne crée aucune ressource cloud et n'exécute aucun des deux modèles.
Créer l'index préparé et déployer
Dans cette étape, vous allez créer un index Vectorize compatible, préparer category pour le filtrage, puis déployer le Worker une fois cette préparation stabilisée.
Créez l'index cosine à 384 dimensions utilisé par BGE Small. --update-config=false empêche Wrangler de réécrire le binding explicite que vous avez déjà vérifié :
npx wrangler vectorize create "$INDEX" --dimensions=384 --metric=cosine --update-config=false
Créez l'index de métadonnées de type chaîne pour category et enregistrez l'ID de mutation renvoyé. set -o pipefail fait échouer le pipeline si Wrangler échoue, même si tee écrit également une copie de la sortie :
set -o pipefail
npx wrangler vectorize create-metadata-index "$INDEX" \
  --propertyName=category \
  --type=string 2>&1 | tee .labex/category-index-output.txt
META_MUTATION=$(grep -Eo '[0-9a-fA-F]{8}-[0-9a-fA-F-]{27}' .labex/category-index-output.txt | tail -n 1)
if [ -z "$META_MUTATION" ]; then
  printf '%s\n' 'No metadata mutation ID was returned; fix the command before continuing.' >&2
else
  printf '%s\n' "$META_MUTATION" | tee .labex/category-mutation.txt
fi
Une mutation acceptée est une tâche mise en file d'attente. Créez un script d'attente limité, en lecture seule, qui exige de retrouver exactement la mutation et le nombre de vecteurs lors de trois lectures consécutives :
cat > scripts/wait-for-vectorize.mjs <<'JS'
import { execFileSync } from "node:child_process";
import { readFileSync } from "node:fs";

const [indexName, mutationFile, expectedText] = process.argv.slice(2);
const mutationId = readFileSync(mutationFile, "utf8").trim();
const expectedCount = Number(expectedText);
if (!/^[0-9a-f-]{36}$/i.test(mutationId)) throw new Error("mutation file has no UUID");
if (!Number.isInteger(expectedCount) || expectedCount < 0) throw new Error("expected count is invalid");
const wrangler = "./node_modules/wrangler/bin/wrangler.js";
let consecutiveMatches = 0;

for (let attempt = 1; attempt <= 120; attempt += 1) {
  const output = execFileSync(process.execPath, [wrangler, "vectorize", "info", indexName, "--json"], { encoding: "utf8" });
  const info = JSON.parse(output);
  if (String(info.processedUpToMutation) === mutationId && info.vectorCount === expectedCount) consecutiveMatches += 1;
  else consecutiveMatches = 0;
  if (consecutiveMatches === 3) {
    console.log("mutation " + mutationId + " is consistently readable with " + expectedCount + " vectors");
    console.log(JSON.stringify(info, null, 2));
    process.exit(0);
  }
  await new Promise((resolve) => setTimeout(resolve, 2000));
}
throw new Error("mutation " + mutationId + " was not stable within four minutes");
JS
node scripts/wait-for-vectorize.mjs "$INDEX" .labex/category-mutation.txt 0
La vue distincte de la liste peut prendre du retard par rapport à l'état de la mutation traitée. Attendez donc brièvement que sa ligne soit également visible :
for attempt in {1..15}; do
  METADATA_INDEXES=$(npx wrangler vectorize list-metadata-index "$INDEX" 2>&1)
  if grep -Eq 'category.*String' <<<"$METADATA_INDEXES"; then
    break
  fi
  sleep 2
done
printf '%s\n' "$METADATA_INDEXES"
grep -Eq 'category.*String' <<<"$METADATA_INDEXES" || {
  printf '%s\n' 'The category metadata index is processed but not yet visible; rerun this read-only check.' >&2
  exit 1
}
Enfin, déployez le Worker et enregistrez son URL publique :
set -o pipefail
npx wrangler deploy 2>&1 | tee .labex/deploy-output.txt
DEPLOY_URL=$(sed -nE 's#.*(https://[^[:space:]]+\.workers\.dev).*#\1#p' .labex/deploy-output.txt | tail -n 1)
if [ -z "$DEPLOY_URL" ]; then
  printf '%s\n' 'No workers.dev URL was returned; fix deployment before continuing.' >&2
else
  printf '%s\n' "$DEPLOY_URL" | tee .labex/deploy-url.txt
fi
L'index est encore vide. Le déploiement connecte les bindings ; il ne crée pas automatiquement les embeddings ni les enregistrements de sources.
Insérer le corpus de sources approuvées
Dans cette étape, vous allez créer les embeddings réels des trois articles fournis et attendre que chaque ID de source soit lisible.
Le texte des sources reste dans CORPUS ; les enregistrements vectoriels contiennent l'embedding compatible ainsi que quelques métadonnées de recherche. Cette séparation permet à l'application de résoudre un ID vers le contenu approuvé d'un article, au lieu de faire confiance à du texte arbitraire copié depuis les métadonnées vectorielles.
Appelez une seule fois l'endpoint fixe d'insertion :
DEPLOY_URL=$(cat .labex/deploy-url.txt)
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/seed" \
  -H 'content-type: application/json' \
  --data '{}' | tee .labex/seed-response.json
node -e '
  const value = JSON.parse(require("fs").readFileSync(".labex/seed-response.json", "utf8"));
  if (!/^[0-9a-f-]{36}$/i.test(value.mutationId)) throw new Error("seed mutation is missing");
  require("fs").writeFileSync(".labex/seed-mutation.txt", value.mutationId + "\n");
  console.log("accepted " + value.count + " source vectors in mutation " + value.mutationId);
'
Vous devez obtenir trois enregistrements, 384 dimensions, un pooling cls et un UUID de mutation. Attendez cet état exact, puis attendez brièvement que les trois ID apparaissent dans la vue d'inventaire distincte :
node scripts/wait-for-vectorize.mjs "$INDEX" .labex/seed-mutation.txt 3
for attempt in {1..15}; do
  VECTOR_LIST=$(npx wrangler vectorize list-vectors "$INDEX" --count=10 2>&1)
  if grep -q 'password-reset' <<<"$VECTOR_LIST" &&
     grep -q 'mfa-recovery' <<<"$VECTOR_LIST" &&
     grep -q 'billing-receipt' <<<"$VECTOR_LIST"; then
    break
  fi
  sleep 2
done
printf '%s\n' "$VECTOR_LIST"
for id in password-reset mfa-recovery billing-receipt; do
  grep -q "$id" <<<"$VECTOR_LIST" || {
    printf 'The processed source %s is not visible in the list yet; rerun this read-only check.\n' "$id" >&2
    exit 1
  }
done
Chaque ID relie désormais les résultats de recherche à une entrée précise du corpus. L'index ne contient volontairement aucun article files, ce qui rend la branche « absence de preuves » observable sans dépendre d'un seuil de similarité.
Comparer les réponses fondées sur des sources et sans preuves
Dans cette étape, vous allez envoyer une question prise en charge et une question dont la catégorie autorisée ne possède aucune source. Le contraste rend le flux de contrôle RAG visible.
Demandez comment réinitialiser un mot de passe expiré dans la portée du compte blue :
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/answer" \
  -H 'content-type: application/json' \
  -H 'x-lab-session: blue-session' \
  --data '{"question":"How do I reset my expired password?","category":"account"}' \
  | tee .labex/grounded-answer.json
Vous devez obtenir mode: grounded, generated: true, une réponse non vide et un tableau sources dont le premier élément est password-reset. La formulation produite par le modèle peut varier. La preuve stable est que chaque ID, titre et URL renvoyé peut être résolu dans le corpus fourni et que seuls des passages account approuvés ont été placés dans le prompt.
Demandez maintenant comment téléverser un fichier tout en conservant la même portée client contrôlée par le serveur. files est une catégorie autorisée, mais ce corpus ne contient aucun enregistrement de fichier admissible :
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/answer" \
  -H 'content-type: application/json' \
  -H 'x-lab-session: blue-session' \
  --data '{"question":"How do I upload a PDF?","category":"files"}' \
  | tee .labex/no-evidence-answer.json
Vous devez obtenir mode: no_evidence, generated: false, le message fixe I don't have enough approved evidence to answer that question. et sources: []. Le Worker a tout de même transformé la question en embedding pour effectuer la recherche, mais il a ignoré la génération de texte puisqu'aucun contexte approuvé n'était disponible.
Essayez une requête non sûre qui fournit son propre espace de noms :
curl --silent --show-error \
  -o .labex/override-response.json \
  -w 'HTTP %{http_code}\n' \
  -X POST "$DEPLOY_URL/answer" \
  -H 'content-type: application/json' \
  -H 'x-lab-session: blue-session' \
  --data '{"question":"Help","category":"account","namespace":"customer-green"}'
cat .labex/override-response.json
Vous devez obtenir HTTP 400 et scope_override_not_allowed. Le RAG ne remplace pas la limite d'autorisation étudiée dans V04 ; la récupération doit d'abord être sûre avant que son texte ne devienne le contexte du modèle.
Ouvrez Workers & Pages → votre Worker labex-c08-v05-... → Bindings. Vérifiez que AI pointe vers Workers AI et que DOCUMENTS pointe vers l'index Vectorize associé. Cette vue relie les deux noms de services utilisés dans le code aux ressources gérées réelles.
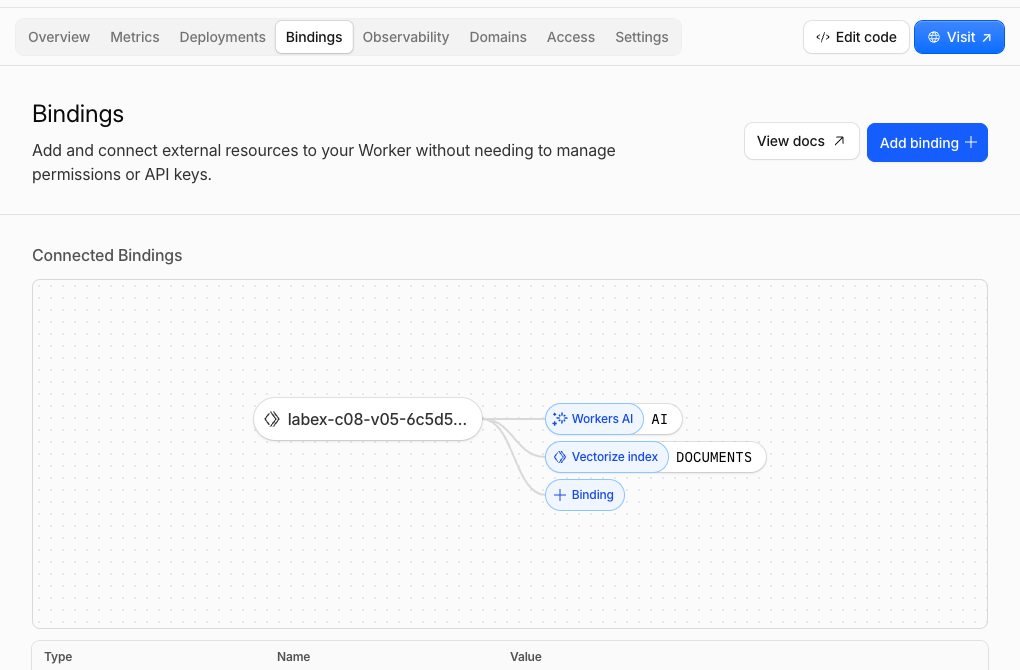
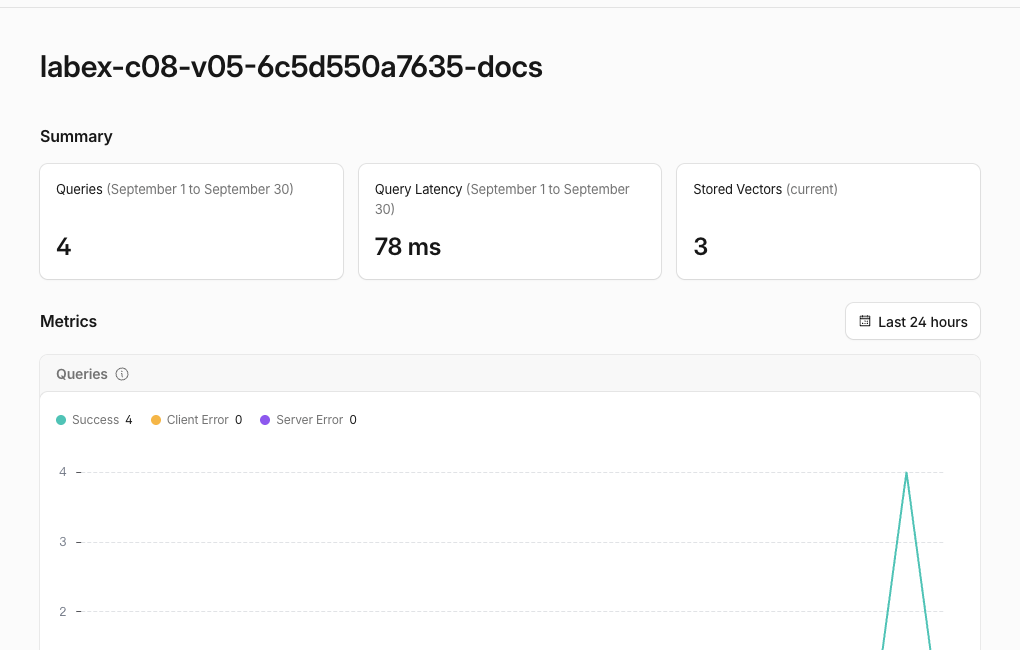
Ouvrez ensuite AI → Vectorize → l'index -docs correspondant. Le nombre actuel doit finir par afficher trois vecteurs, et l'activité des requêtes doit refléter les recherches avec et sans preuves. Les métriques du Dashboard peuvent prendre du retard ; les lectures authentifiées des ID et les réponses de l'endpoint restent les références fiables.
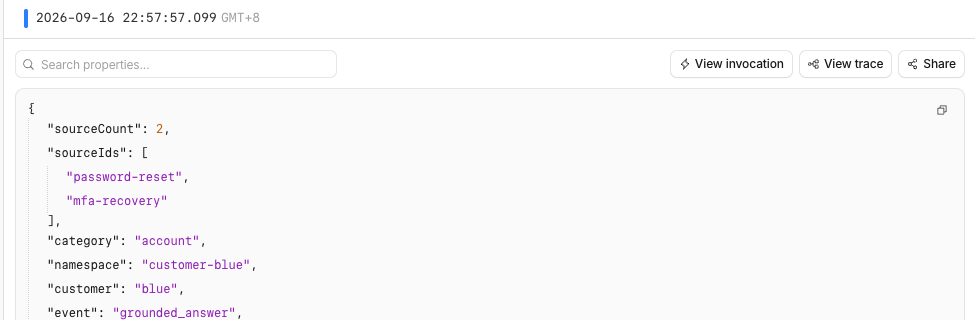
Si Workers Logs est disponible, ouvrez Observability → Logs et examinez les entrées grounded_answer et grounded_no_evidence. Les journaux contiennent la catégorie, les ID des sources et les nombres, mais excluent la question, la réponse, le texte des passages, l'étiquette de session et les valeurs vectorielles. Les opérateurs disposent ainsi d'éléments utiles sur le flux de contrôle sans recopier le prompt dans les journaux.
Supprimer les ressources de la réponse fondée sur des sources
Dans cette étape, vous allez supprimer le Worker temporaire et l'index Vectorize, puis confirmer leur absence tant que Wrangler est encore autorisé.
Récupérez les deux noms exacts depuis wrangler.jsonc afin que le nettoyage ne dépende pas de variables provenant d'une session de terminal précédente :
RUN=$(node -p 'JSON.parse(require("fs").readFileSync("wrangler.jsonc", "utf8")).name')
INDEX=$(node -p 'JSON.parse(require("fs").readFileSync("wrangler.jsonc", "utf8")).vectorize.find((item) => item.binding === "DOCUMENTS").index_name')
printf 'Worker: %s\nIndex: %s\n' "$RUN" "$INDEX"
Vérifiez que les deux valeurs utilisent votre préfixe unique labex-c08-v05-.... Supprimez d'abord le Worker afin qu'aucun code déployé ne conserve le binding, puis supprimez uniquement l'index qui lui est associé :
npx wrangler delete --name "$RUN" --force
npx wrangler vectorize delete "$INDEX" --force
Enregistrez un inventaire authentifié des index et vérifiez l'absence du nom exact :
npx wrangler vectorize list --json > .labex/indexes-after-cleanup.json
node -e '
  const rows = JSON.parse(require("fs").readFileSync(process.argv[1], "utf8"));
  if (rows.some((row) => row.name === process.argv[2])) throw new Error("lab index still exists");
  console.log("lab index is absent");
' .labex/indexes-after-cleanup.json "$INDEX"
Effectuez cette vérification avant de vous déconnecter. Une erreur réseau ou d'autorisation ne permet pas de conclure ; l'évaluation exige séparément des lectures réussies du compte et l'absence du nom exact.
Se déconnecter de la VM d'apprentissage
Dans cette étape, vous allez supprimer l'autorisation Wrangler temporaire de cette VM. Les ressources cloud ont déjà été supprimées et la vérification de nettoyage authentifiée a réussi :
npx wrangler logout
npx wrangler whoami --json
Vous devez obtenir loggedIn: false. La session du Cloudflare Dashboard dans le navigateur est distincte et reste disponible pour votre compte d'apprentissage.
Résumé
Vous avez construit un petit endpoint de génération augmentée par récupération : la portée contrôlée par le serveur a limité la recherche Vectorize, les ID renvoyés ont été résolus dans un corpus approuvé, au maximum deux passages sont devenus le contexte du modèle et l'application a renvoyé des références de sources stables à côté d'une formulation générée variable.
Vous avez également vérifié qu'une recherche vide autorisée suit une branche fixe no_evidence sans génération de texte, que les remplacements de portée fournis par le client sont rejetés avant la récupération, et que les relations entre le Worker, Vectorize et l'observabilité limitée pour la confidentialité peuvent être inspectées. Vous avez supprimé les deux ressources temporaires tout en restant autorisé, puis vous vous êtes déconnecté. Le challenge du cours vous demandera de réparer un endpoint défectueux qui enfreint la même limite de portée.