



Introduction
L’application envoie actuellement lectures et écritures au même primaire. Vous créerez un réplica PostgreSQL, y dirigerez les requêtes et prouverez que les nouvelles écritures du primaire y deviennent lisibles, tandis qu’il refuse les écritures directes.
C’est une extension facultative après les laboratoires de connexion, SQL et récupération. L’environnement démarre indépendamment avec un primaire et trois commandes. Vous supprimerez le réplica et le primaire à la fin.
Lien avec les certifications
Ce laboratoire propose une pratique introductive des sujets d’examen suivants.
- Cloud Practitioner (CLF-C02) · Tâche 3.4 : Reconnaître un cas d’utilisation de réplica de lecture relationnel.
- Solutions Architect – Associate (SAA-C03) · Tâche 3.3 : Configurer des réplicas pour le mode d’accès en lecture d’une application.
Créer et inspecter un réplica de lecture
Dans cette étape, vous créerez un second PostgreSQL recevant les modifications du primaire.
Un réplica de lecture sert les requêtes depuis des données copiées. PostgreSQL transmet les modifications par son journal d’écriture anticipée, le WAL. Le serveur de secours rejoue ces modifications ; c’est un moteur séparé et la réplication peut prendre du retard sur une écriture nouvellement validée.
Un réplica de lecture et un serveur de secours Multi-AZ ont des objectifs différents. Le réplica fournit un endpoint pour les requêtes applicatives. Le secours d’un déploiement standard d’instance DB Multi-AZ assure disponibilité et basculement, sans servir les lectures applicatives. Ce laboratoire implémente un réplica, pas un basculement Multi-AZ.
Chargez les paramètres de connexion :
cd /home/labex/project
source database.env
Inspectez la source :
aws rds \
  describe-db-instances \
  --db-instance-identifier orders-db \
  --query 'DBInstances[0].{Identifier:DBInstanceIdentifier,Status:DBInstanceStatus,BackupRetention:BackupRetentionPeriod,Endpoint:Endpoint}'
RDS exige une durée de rétention des sauvegardes non nulle sur la source d’un réplica. Ce laboratoire fournit un primaire avec rétention 1. Vous utiliserez cette configuration ; l’exercice ne teste pas la planification des sauvegardes automatiques.
Créez le réplica :
aws rds \
  create-db-instance-read-replica \
  --db-instance-identifier orders-reader \
  --source-db-instance-identifier orders-db \
  --db-instance-class db.t3.micro \
  --no-publicly-accessible \
  --query 'DBInstance.{Identifier:DBInstanceIdentifier,Source:ReadReplicaSourceDBInstanceIdentifier,Status:DBInstanceStatus,Endpoint:Endpoint}'
aws rds \
  wait db-instance-available \
  --db-instance-identifier orders-reader
Inspectez les deux ressources :
aws rds \
  describe-db-instances \
  --query 'DBInstances[].{Identifier:DBInstanceIdentifier,Source:ReadReplicaSourceDBInstanceIdentifier,Endpoint:Endpoint.Address}' \
  --output table
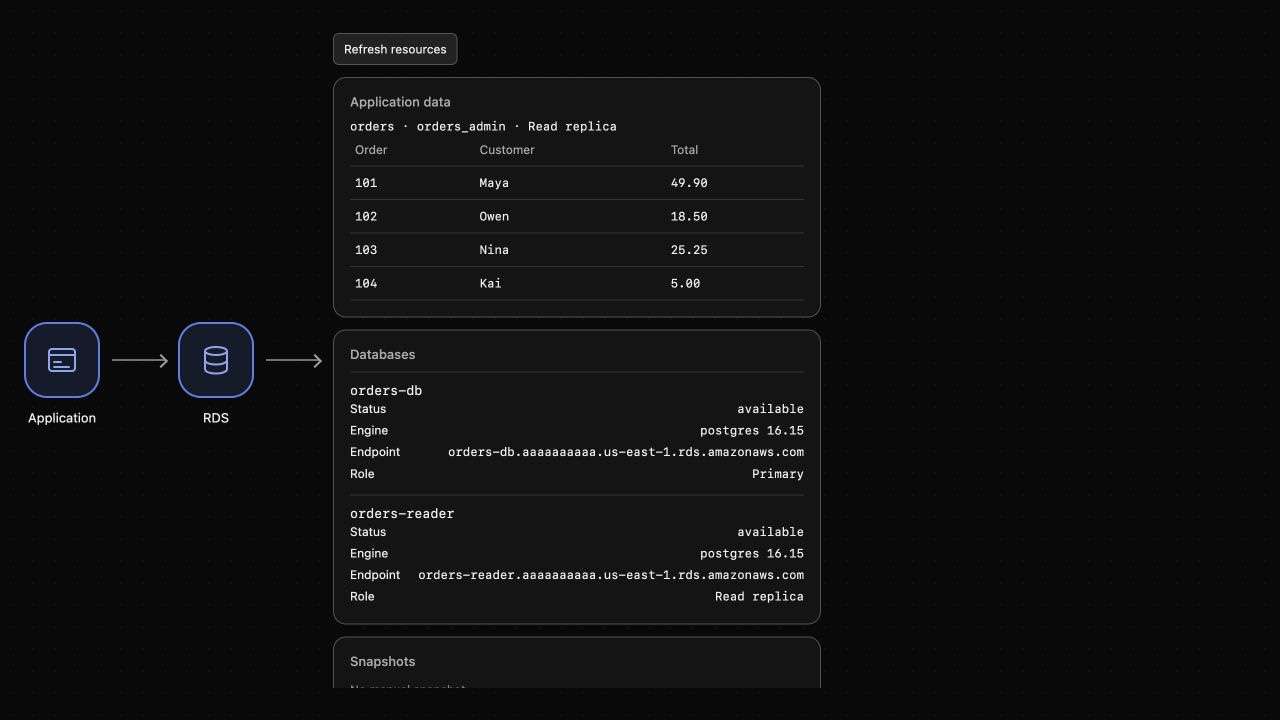
Vous devez obtenir un endpoint distinct pour orders-reader et une relation de source vers orders-db. AWS View doit lister primaire et réplica.
Interrogez le véritable moteur du réplica :
psql \
  "service=orders-reader" \
  --command 'SELECT current_database(), pg_is_in_recovery();'
Vous devez obtenir la base orders et pg_is_in_recovery égal à t (true). PostgreSQL fonctionne réellement en récupération de secours, au-delà d’une simple étiquette de réplica sur la ressource RDS.
Séparer les endpoints de lecture et d’écriture
Dans cette étape, vous garderez les écritures sur le primaire et enverrez les lectures au réplica.
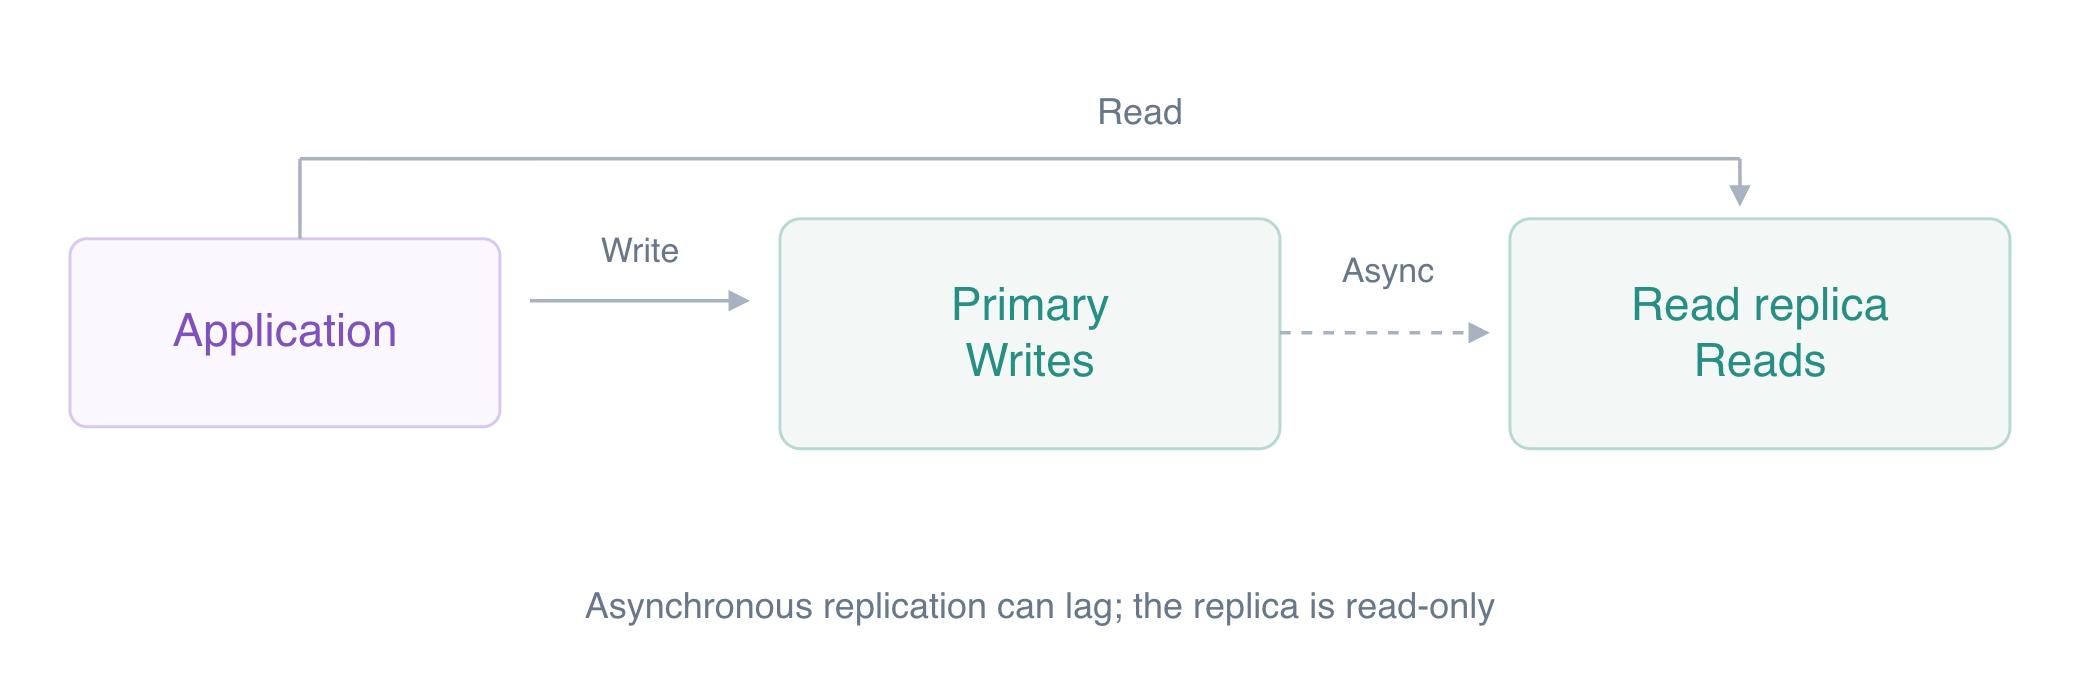
Schéma conceptuel: Les écritures vont au primaire ; les lectures peuvent utiliser la réplique asynchrone.
Inspectez la configuration applicative :
cat app-config.json
Les deux champs de serveur indiquent le primaire. Obtenez l’endpoint du réplica :
READER_ENDPOINT=$(aws rds \
  describe-db-instances \
  --db-instance-identifier orders-reader \
  --query 'DBInstances[0].Endpoint.Address' \
  --output text)
Changez seulement read_host :
jq \
  --arg host "$READER_ENDPOINT" \
  '.read_host = $host' \
  app-config.json > app-config.new
mv app-config.new app-config.json
Lisez par l’application :
curl \
  --silent \
  --show-error \
  --fail \
  http://127.0.0.1:8080/application/orders | jq
Vous devez obtenir les trois commandes initiales et read_only: true. La réponse vient de la connexion SQL réelle de l’application au secours. AWS View doit identifier la source applicative comme un réplica de lecture.
Le réplica utilise les identités de base copiées de la source. L’endpoint détermine l’instance atteinte ; l’authentification et les droits SQL continuent de s’appliquer.
Observer la réplication et refuser les écritures
Dans cette étape, vous enregistrerez une commande par le primaire et la lirez sur le réplica.
Ajoutez une commande par l’application. Son gestionnaire POST utilise write_host, qui pointe toujours vers le primaire :
curl \
  --silent \
  --show-error \
  --fail \
  --request POST \
  --header 'Content-Type: application/json' \
  --data '{"order_id":104,"customer":"Kai","total":"5.00"}' \
  http://127.0.0.1:8080/application/orders
Vous devez obtenir saved: true. Interrogez source et réplica séparément :
psql \
  "service=orders-db" \
  --command 'SELECT order_id, customer, total FROM orders WHERE order_id = 104;'
psql \
  "service=orders-reader" \
  --command 'SELECT order_id, customer, total FROM orders WHERE order_id = 104;'
Vous devez retrouver la commande de Kai à 5.00 sur les deux. Si la première lecture du réplica ne la trouve pas encore, répétez la même requête après un moment : la réplication asynchrone permet un délai. Un réplica convient aux charges riches en lectures, mais une cohérence immédiate peut imposer de lire le primaire après une écriture.
Relisez la liste de l’application :
curl \
  --silent \
  --show-error \
  --fail \
  http://127.0.0.1:8080/application/orders | jq
Vous devez obtenir quatre commandes et read_only: true.
Tentez une véritable insertion sur le réplica :
psql \
  "service=orders-reader" \
  --set=ON_ERROR_STOP=1 \
  --command "INSERT INTO orders (order_id, customer, total) VALUES (105, 'Lena', 9.00);"
Vous devez obtenir une erreur indiquant qu’INSERT ne peut pas s’exécuter dans une transaction en lecture seule. La récupération refuse l’écriture même avec l’identité maître. Confirmez que la commande tentée n’existe sur aucun des moteurs :
psql \
  "service=orders-db" \
  --command 'SELECT count(*) FROM orders WHERE order_id = 105;'
psql \
  "service=orders-reader" \
  --command 'SELECT count(*) FROM orders WHERE order_id = 105;'
Vous devez obtenir 0 sur chacun. Les écritures vont au primaire ; les lectures peuvent utiliser le réplica si leurs exigences de cohérence le permettent.
Supprimer le réplica et le primaire
Dans cette étape, vous supprimerez les deux instances d’exercice.
Supprimez d’abord le réplica, puis la source :
aws rds \
  delete-db-instance \
  --db-instance-identifier orders-reader \
  --skip-final-snapshot \
  --query 'DBInstance.DBInstanceIdentifier'
aws rds \
  wait db-instance-deleted \
  --db-instance-identifier orders-reader
aws rds \
  delete-db-instance \
  --db-instance-identifier orders-db \
  --skip-final-snapshot \
  --query 'DBInstance.DBInstanceIdentifier'
aws rds \
  wait db-instance-deleted \
  --db-instance-identifier orders-db
aws rds \
  describe-db-instances \
  --query 'DBInstances[].DBInstanceIdentifier'
Vous devez obtenir [] et aucune base dans AWS View. Conservez l’application et les ressources réseau préparées.
Résumé
Vous avez créé un réplica PostgreSQL et vérifié son véritable mode de récupération. Vous avez séparé les endpoints, observé une écriture du primaire atteindre le réplica et confirmé le refus des écritures directes. Vous avez enfin supprimé les deux instances.
Un réplica répond aux besoins de lecture ; son objectif et son comportement diffèrent du secours d’un déploiement standard d’instance DB Multi-AZ. Le défi final applique les compétences de connexion et de diagnostic apprises.


