Introduction
Le magasin conserve ses ventes par mois. September est déjà catalogué ; le fichier October est local. Chargez-le dans son préfixe S3, enregistrez sa partition Glue, puis interrogez le nouveau mois et les deux mois avec Athena.
Terminez Query S3 Data with Athena. Cet environnement indépendant fournit sales partitionnée, September et sa partition, le nouveau CSV et une identité AWS configurée. Aucun compte personnel ni ressource antérieure n’est nécessaire. Utilisez les commandes ordinaires S3/Glue/Athena dans Terminal et comparez fichiers, partitions et résultats réels dans AWS View.
Pertinence pour la certification
| Certification | Tâche de l’examen | Pratique |
|---|---|---|
| Cloud Practitioner (CLF-C02) | Task 3.7 | Expliquer comment les métadonnées Glue rendent les données S3 partitionnées accessibles à Athena. |
Ajouter le fichier du nouveau mois
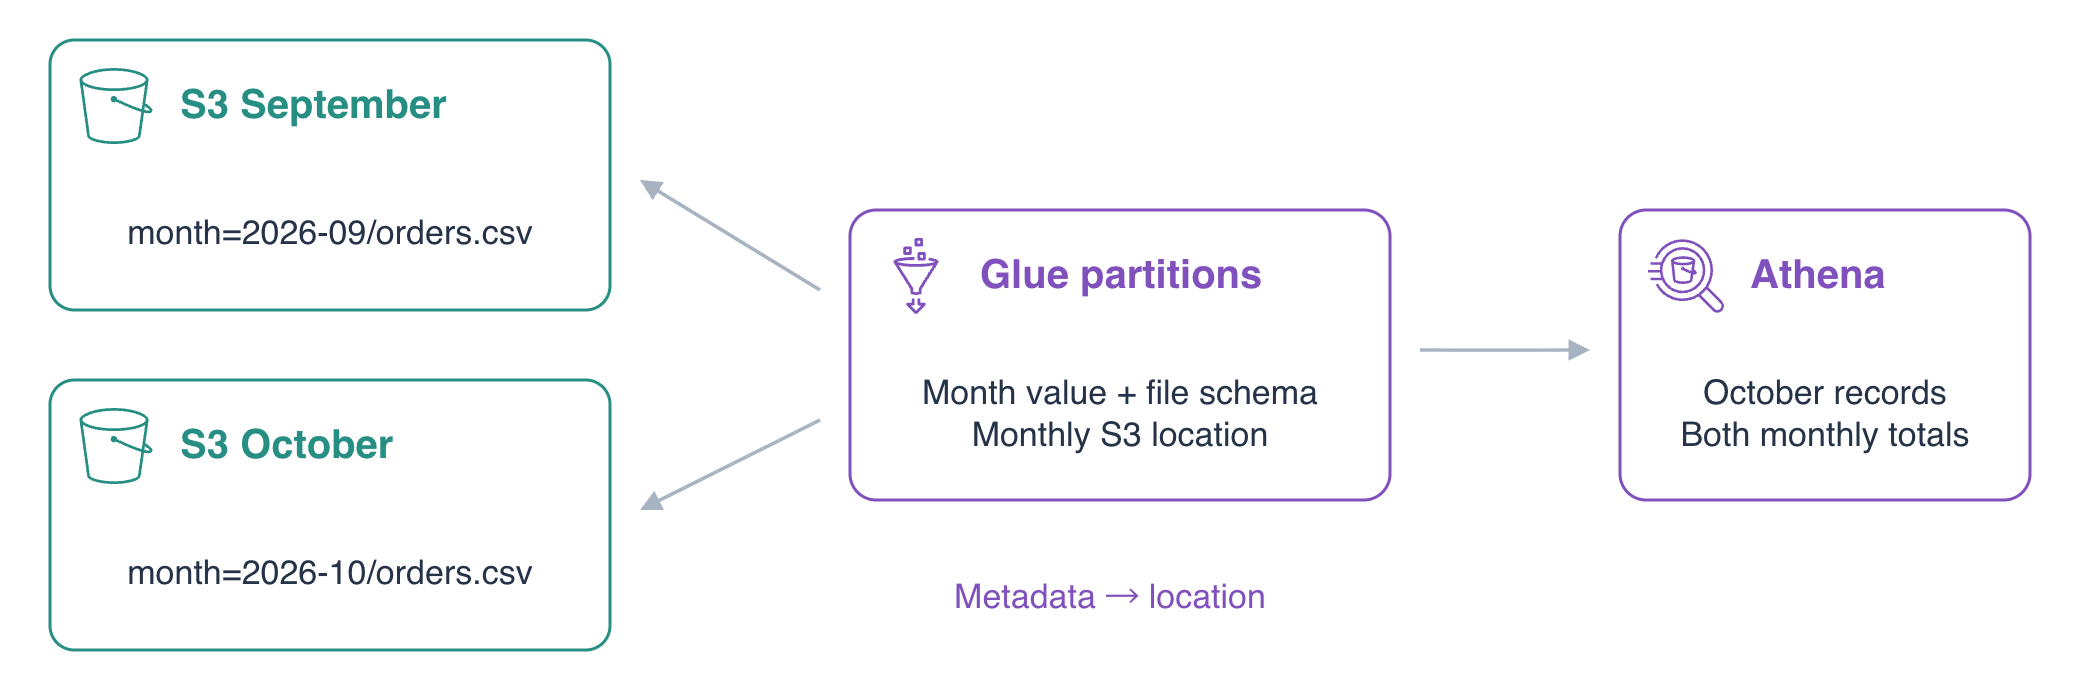
Dans cette étape, chargez October sans changer September. Une partition groupe les données par clé, comme le mois. sales/month=2026-09/ contient September, sales/month=2026-10/ recevra October. Le motif key=value montre le groupe ; charger un fichier ne l’enregistre pas automatiquement dans Glue.
Entrez dans le projet et vérifiez l’identité :
cd /home/labex/project
aws sts \
  get-caller-identity
L’ARN se termine par labex-an03-operator. jq -r extrait du texte JSON ; $(...) le conserve dans une variable :
INPUT_BUCKET=$(jq -r .input_bucket resources.json)
echo "$INPUT_BUCKET"
DATABASE=$(jq -r .database resources.json)
echo "$DATABASE"
SALES_LOCATION=$(jq -r .input_location resources.json)
echo "$SALES_LOCATION"
RESULT_LOCATION=$(jq -r .output_location resources.json)
echo "$RESULT_LOCATION"
--recursive inclut les préfixes imbriqués :
aws s3 \
  ls "s3://$INPUT_BUCKET/sales/" \
  --recursive
Vous devez voir sales/month=2026-09/orders.csv. Ses montants 1000, 2000 et 500 font 3500 cents. Préservez ce fichier et reference/notes.txt. Lisez October :
cat october.csv
O01/east/700, O02/west/900, O03/east/400 : trois commandes, 2000 cents, avec les mêmes trois colonnes. Chargez dans son propre préfixe :
aws s3 \
  cp october.csv "s3://$INPUT_BUCKET/sales/month=2026-10/orders.csv"
Relisez l’objet réel :
aws s3 \
  cp "s3://$INPUT_BUCKET/sales/month=2026-10/orders.csv" -
Le - final affiche le contenu. AWS View montre deux fichiers S3, mais seulement September dans Glue. Arrivée et enregistrement sont séparés.
Enregistrer October dans le catalogue
Dans cette étape, montrez pourquoi l’arrivée seule ne suffit pas et ajoutez les métadonnées. Une définition associe valeur de clé, emplacement S3 et schéma. month est une clé de partition de type string. Le CSV n’a que order_id, region, total_cents ; la valeur month vient de la définition.
Inspectez la clé :
aws glue \
  get-table \
  --database-name "$DATABASE" \
  --name sales \
  --query 'Table.PartitionKeys'
Elle est month, type string. Interrogez avant l’enregistrement. COUNT(*) compte les correspondances ; le délimiteur heredoc cité préserve le SQL :
cat > october-before.sql <<'EOF'
SELECT COUNT(*) AS orders
FROM sales
WHERE month = '2026-10';
EOF
Soumettez avec la base et la sortie préparées, puis affichez l’ID :
BEFORE_QUERY_ID=$(aws athena \
  start-query-execution \
  --query-string file://october-before.sql \
  --query-execution-context "Database=$DATABASE" \
  --result-configuration "OutputLocation=$RESULT_LOCATION" \
  --query QueryExecutionId \
  --output text)
echo "$BEFORE_QUERY_ID"
Répétez pour QUEUED ou RUNNING, continuez à SUCCEEDED et lisez Reason en cas d’échec :
aws athena \
  get-query-execution \
  --query-execution-id "$BEFORE_QUERY_ID" \
  --query 'QueryExecution.{State:Status.State,Reason:Status.StateChangeReason}'
Lisez le résultat :
aws athena \
  get-query-results \
  --query-execution-id "$BEFORE_QUERY_ID" \
  --query 'ResultSet.Rows[*].Data[*].VarCharValue' \
  --output table
Le compte est 0 malgré le fichier S3. Cette table lit les emplacements enregistrés ; le nom du répertoire ne crée pas ces métadonnées.
Réutilisez le descripteur pour conserver colonnes et format CSV. > écrit le JSON dans un fichier :
aws glue \
  get-table \
  --database-name "$DATABASE" \
  --name sales \
  --query 'Table.StorageDescriptor' \
  --output json > storage-descriptor.json
jq --arg transmet l’emplacement réel comme chaîne ; .Location = $location remplace l’emplacement par October. Values fournit la valeur de l’unique clé :
jq --arg location "${SALES_LOCATION}month=2026-10/" \
  '{Values:["2026-10"],StorageDescriptor:(. | .Location = $location)}' \
  storage-descriptor.json > october-partition.json
Inspectez le JSON ordinaire :
cat october-partition.json
Vérifiez 2026-10 dans Values, les colonnes et le suffixe /sales/month=2026-10/. Les accolades de ${SALES_LOCATION} séparent variable et suffixe. file:// lit le fichier local pour enregistrer :
aws glue \
  create-partition \
  --database-name "$DATABASE" \
  --table-name sales \
  --partition-input file://october-partition.json
Listez les deux partitions :
aws glue \
  get-partitions \
  --database-name "$DATABASE" \
  --table-name sales \
  --query 'Partitions[*].{Month:Values[0],Location:StorageDescriptor.Location}'
Chaque mois pointe vers son préfixe ; AWS View montre les deux associations. Seules les métadonnées changent, aucun CSV n’est copié ni réécrit.
Interroger le nouveau mois et les deux totaux
Dans cette étape, prouvez qu’October est accessible et September correct. WHERE sur la clé sélectionne le mois. Cet exercice vérifie des lignes, pas les frais de scan ni la vitesse en production.
Écrivez la requête October :
cat > october-sales.sql <<'EOF'
SELECT order_id, total_cents
FROM sales
WHERE month = '2026-10'
ORDER BY order_id;
EOF
Soumettez une nouvelle exécution. Enregistrer ne réécrit pas l’ancien résultat nul :
OCTOBER_QUERY_ID=$(aws athena \
  start-query-execution \
  --query-string file://october-sales.sql \
  --query-execution-context "Database=$DATABASE" \
  --result-configuration "OutputLocation=$RESULT_LOCATION" \
  --query QueryExecutionId \
  --output text)
echo "$OCTOBER_QUERY_ID"
Vérifiez le statut, répétez si nécessaire, continuez après succès et examinez les échecs :
aws athena \
  get-query-execution \
  --query-execution-id "$OCTOBER_QUERY_ID" \
  --query 'QueryExecution.{State:Status.State,Reason:Status.StateChangeReason}'
Lisez les lignes :
aws athena \
  get-query-results \
  --query-execution-id "$OCTOBER_QUERY_ID" \
  --query 'ResultSet.Rows[*].Data[*].VarCharValue' \
  --output table
Après l’en-tête : O01/700, O02/900 et O03/400. Le même fichier auparavant invisible fournit trois lignes.
Pour les deux mois, SUM additionne les cents et COUNT(*) compte les commandes de chaque GROUP BY month :
cat > monthly-summary.sql <<'EOF'
SELECT month, SUM(total_cents) AS revenue_cents, COUNT(*) AS orders
FROM sales
GROUP BY month
ORDER BY month;
EOF
Soumettez et affichez l’ID distinct :
MONTHLY_QUERY_ID=$(aws athena \
  start-query-execution \
  --query-string file://monthly-summary.sql \
  --query-execution-context "Database=$DATABASE" \
  --result-configuration "OutputLocation=$RESULT_LOCATION" \
  --query QueryExecutionId \
  --output text)
echo "$MONTHLY_QUERY_ID"
Confirmez le succès, répétez l’état en attente et examinez la raison d’un échec :
aws athena \
  get-query-execution \
  --query-execution-id "$MONTHLY_QUERY_ID" \
  --query 'QueryExecution.{State:Status.State,Reason:Status.StateChangeReason}'
Lisez les groupes :
aws athena \
  get-query-results \
  --query-execution-id "$MONTHLY_QUERY_ID" \
  --query 'ResultSet.Rows[*].Data[*].VarCharValue' \
  --output table
September compte 3500 cents/3 commandes, October 2000/3. Le premier mois reste intact. Comparez emplacements Glue, SQL et lignes dans AWS View.
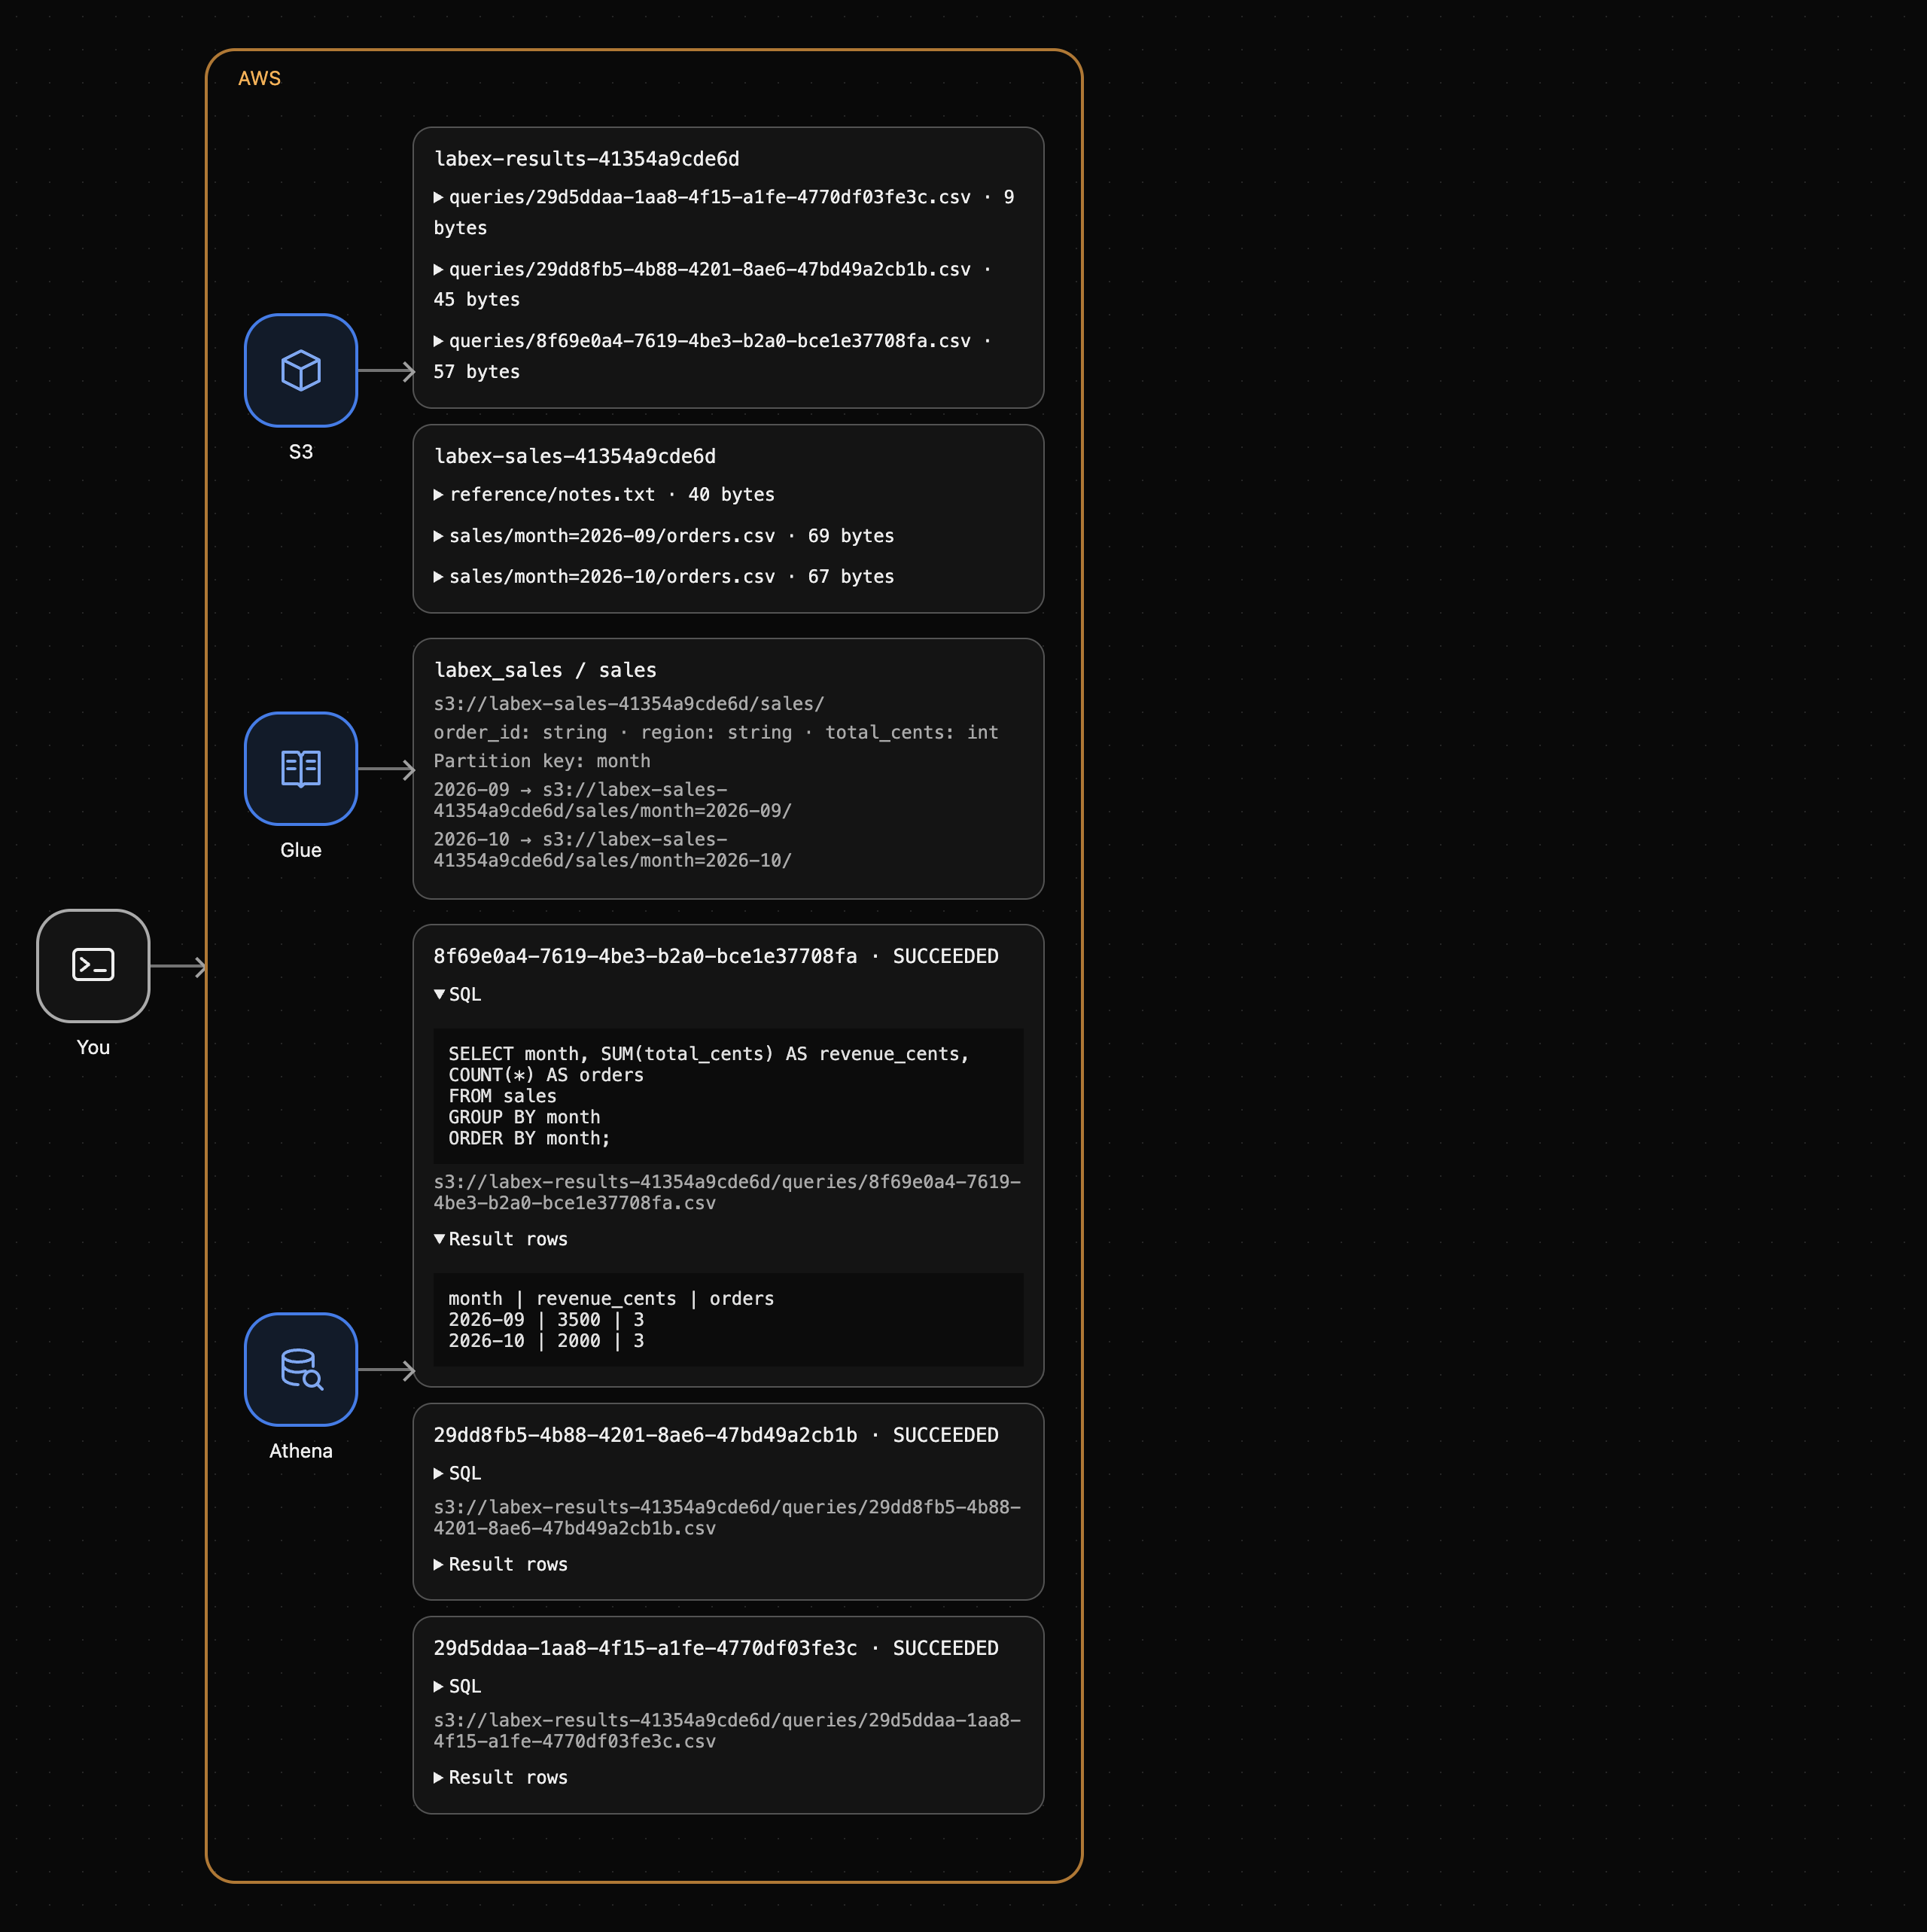
L’ancien résultat nul reste une sortie séparée correspondant à l’ancien catalogue.
Résumé
Vous avez chargé un CSV mensuel, observé l’absence de lignes sans enregistrement, enregistré schéma et emplacement Glue, puis vérifié October et les deux totaux. Fichiers et métadonnées sont distincts ; cette table nécessite l’enregistrement du nouveau préfixe. Le prochain laboratoire crée un fichier de synthèse réutilisable à partir des résultats réels.
Pour approfondir ce sujet, consultez la documentation AWS : Clés, emplacements et enregistrement des partitions.