



Introduction
Les tâches répétées pour la même commande doivent conserver le résultat métier terminé. Vous ajouterez une protection atomique à l'écriture d'un consommateur fourni, testerez des commandes répétées et indépendantes et confirmerez la réussite de l'acquittement.
Terminez d'abord Isoler les tâches échouées avec une file de lettres mortes, Empêcher les commandes en double avec des écritures conditionnelles et Configurer et diagnostiquer une fonction Lambda. Cette VM indépendante fournit le traitement de départ, le rôle et une table de commandes vide.
Lien avec les certifications
Ce laboratoire propose une pratique des sujets d’examen suivants.
- Solutions Architect – Associate (SAA-C03) · Tâche 2.1: Consommateurs idempotents et protection des résultats métier.
- Developer – Associate (DVA-C02) · Tâche 1.1: Consommateurs idempotents et protection des résultats métier.
- DevOps Engineer – Professional (DOP-C02) · Tâche 5.1: Pratique des fondamentaux : Consommateurs idempotents et protection des résultats métier.
- Solutions Architect – Professional (SAP-C02) · Tâche 2.4: Pratique des fondamentaux : Consommateurs idempotents et protection des résultats métier.
Connecter une file vide au traitement
Dans cette étape, créez une file et connectez le consommateur fourni avant d'envoyer des tâches métier.
Utilisez AWS View à côté de Terminal pour comparer les files actuelles, les résultats du traitement et les commandes stockées. Conservez les données de référence indépendantes.
cd /home/labex/project
Créez la file Standard. La substitution de commande, $(...), enregistre l'URL de file renvoyée pour les opérations suivantes :
QUEUE_URL=$(aws sqs create-queue --queue-name labex-q05-jobs --attributes VisibilityTimeout=30 --query QueueUrl --output text)
Sélectionnez son ARN et créez un mappage de source d'événements avec un lot de taille un :
QUEUE_ARN=$(aws sqs get-queue-attributes --queue-url "$QUEUE_URL" --attribute-names QueueArn --query Attributes.QueueArn --output text)
MAPPING_ID=$(aws lambda create-event-source-mapping --function-name labex-q05-worker --event-source-arn "$QUEUE_ARN" --batch-size 1 --enabled --query UUID --output text)
Inspectez la connexion :
aws lambda get-event-source-mapping --uuid "$MAPPING_ID" --query '{Source:EventSourceArn,Function:FunctionArn,Batch:BatchSize,State:State}'
Vous devez obtenir la source labex-q05-jobs, labex-q05-worker, une taille de lot de 1 et l'état Enabled. Le rôle fourni peut interroger et supprimer les messages uniquement de cette file et écrire uniquement dans la table des commandes, en plus des journaux d'exécution. AWS View affiche une file vide, aucune commande et aucune décision d'écriture. N'envoyez pas de tâche avant de déployer la protection à l'étape suivante.
Déployer une protection atomique sur la clé métier
Dans cette étape, remplacez l'écriture inconditionnelle du traitement et prouvez que la première tâche protégée réussit.
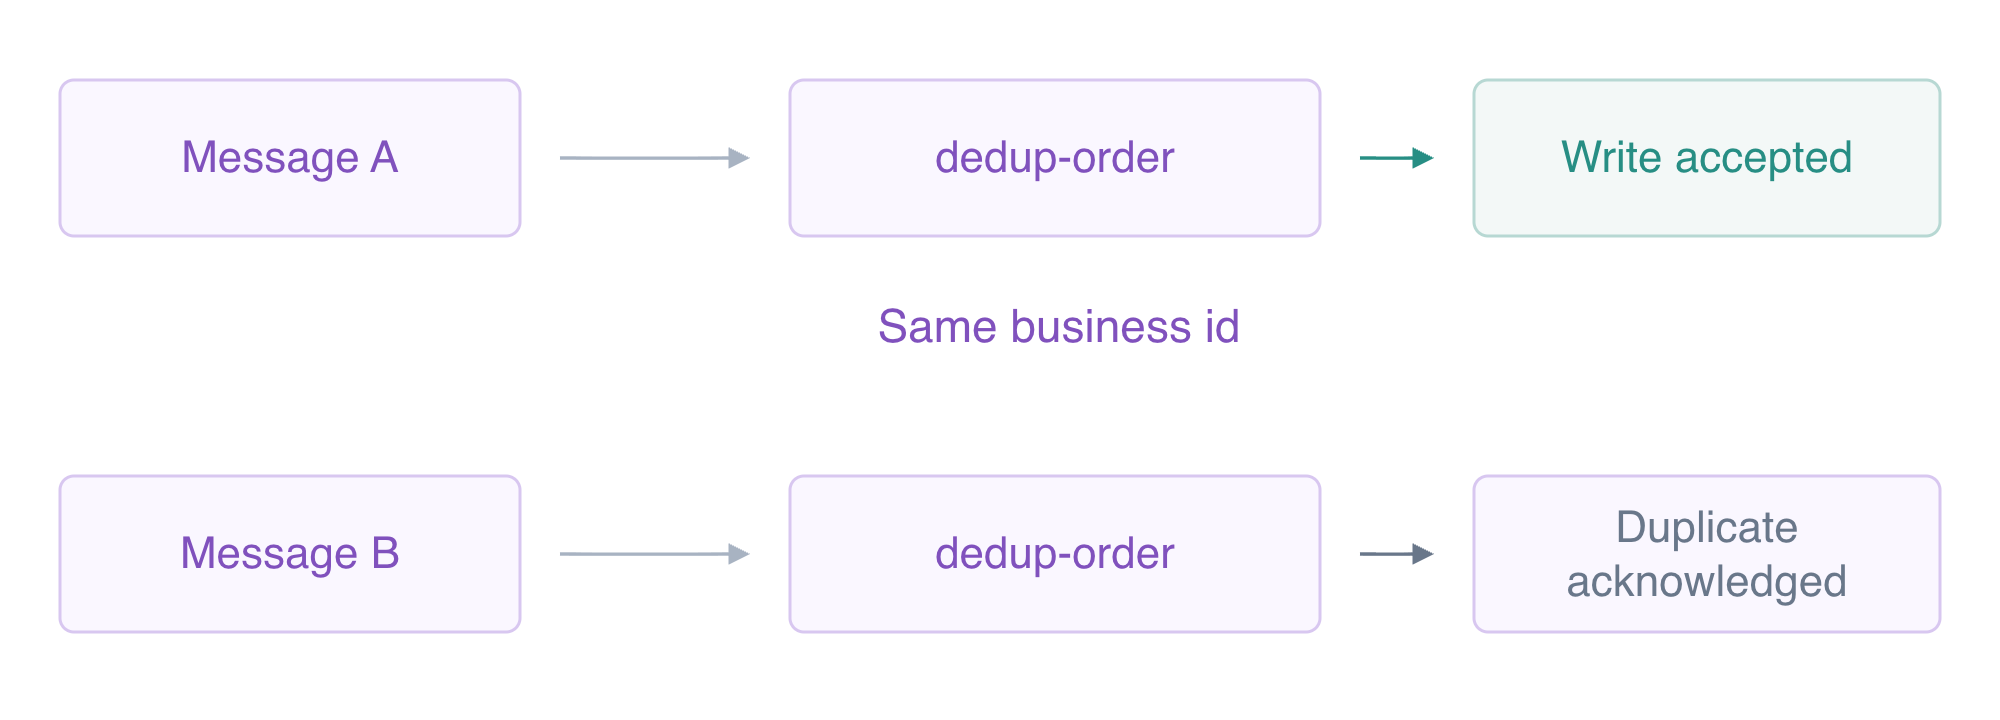
Des messages distincts dans la file peuvent contenir le même identifiant métier. Le traitement acquitte un doublon identique sans réécrire la commande.
Un consommateur idempotent conserve le même résultat métier lorsque du travail répété arrive. DynamoDB évalue ConditionExpression='attribute_not_exists(id)' dans la même opération d'écriture que PutItem. Cela évite une concurrence entre une lecture séparée et l'écriture suivante. Le id métier est la clé ; utiliser le messageId SQS permettrait à une nouvelle copie de la même commande envoyée par le producteur d'écrire de nouveau.
Lorsque la condition échoue, ReturnValuesOnConditionCheckFailure='ALL_OLD' renvoie l'élément existant. Le code intercepte uniquement ConditionalCheckFailedException et compare cet élément à celui demandé. Des détails identiques constituent un doublon déjà terminé ; des détails contradictoires ou une autre erreur provoquent toujours un échec au lieu d'être acquittés silencieusement.
Écrivez le traitement complet ci-dessous. cat > app.py remplace le fichier et le document intégré fournit son contenu jusqu'au terminateur PY. Les guillemets autour de 'PY' empêchent le développement par le shell dans le code Python :
cat > app.py <<'PY'
import json
import os
import boto3
from botocore.exceptions import ClientError


def handler(event, context):
    print('EVENT '+json.dumps(event,sort_keys=True))
    if set(event)!={'Records'} or len(event['Records'])!=1:
        raise ValueError('Expected one SQS record')
    job=json.loads(event['Records'][0]['body'])
    print('JOB '+json.dumps(job,sort_keys=True))
    if set(job)!={'id','quantity'} or not isinstance(job['id'],str):
        raise ValueError('Use an id and quantity')
    quantity=job['quantity']
    if isinstance(quantity,bool) or not isinstance(quantity,int) or not 1<=quantity<=10:
        raise ValueError('Quantity must be an integer from 1 to 10')
    database=boto3.client('dynamodb',endpoint_url='http://127.0.0.1:5000',region_name='us-east-1')
    item={'id':{'S':job['id']},'quantity':{'N':str(quantity)},'total_cents':{'N':str(quantity*250+100)}}
    try:
        database.put_item(TableName=os.environ['TABLE_NAME'],Item=item,
                          ConditionExpression='attribute_not_exists(id)',
                          ReturnValuesOnConditionCheckFailure='ALL_OLD')
        result={'id':job['id'],'quantity':quantity,'processed':True,'duplicate':False}
    except ClientError as error:
        if error.response['Error']['Code']!='ConditionalCheckFailedException':
            raise
        if error.response.get('Item')!=item:
            raise ValueError('Order ID already exists with different details') from error
        result={'id':job['id'],'quantity':quantity,'processed':False,'duplicate':True}
    print('RESULT '+json.dumps(result,sort_keys=True))
    return result
PY
L'analyse de l'événement et les contrôles de quantité sont le contexte fourni. La modification principale est l'unique put_item conditionnel, son échec traité de façon ciblée et le résultat processed/duplicate. Un doublon renvoie un succès pour que le consommateur puisse acquitter sa copie SQS après que le résultat métier a déjà été conservé.
Placez app.py à la racine du ZIP. Le gestionnaire de la fonction existante est app.handler : le nom du fichier du module compte donc :
zip -q function.zip app.py
Chargez le ZIP binaire avec fileb:// :
aws lambda update-function-code --function-name labex-q05-worker --zip-file fileb://function.zip --query CodeSha256 --output text
L'empreinte renvoyée identifie le code déployé ; le traitement réel prouvera son comportement. Envoyez la première commande :
aws sqs send-message --queue-url "$QUEUE_URL" --message-body '{"id":"dedup-order","quantity":4}'
Observez AWS View jusqu'à ce que la file soit vide, que le traitement signale processed: true et que la commande apparaisse. Lisez-la ensuite :
aws dynamodb get-item --table-name labex-q05-orders --key '{"id":{"S":"dedup-order"}}' --consistent-read --query Item
Vous devez obtenir une quantité de 4 et un total de 1100. La décision d'écriture affiche la condition, Accepted, l'absence d'élément précédent et cet élément stocké après l'opération. Une condition configurée ou un fichier chargé ne suffit pas à prouver la réussite du travail.
Consommer les tâches répétées sans répéter l'écriture
Dans cette étape, envoyez deux nouvelles copies de la même commande métier et prouvez qu'une autre commande aboutit toujours indépendamment.
Envoyez deux fois la même charge utile métier. Chaque réponse SendMessage possède un nouvel identifiant de message SQS, mais la clé de commande reste dedup-order :
aws sqs send-message --queue-url "$QUEUE_URL" --message-body '{"id":"dedup-order","quantity":4}'
aws sqs send-message --queue-url "$QUEUE_URL" --message-body '{"id":"dedup-order","quantity":4}'
Envoyez une clé métier indépendante :
aws sqs send-message --queue-url "$QUEUE_URL" --message-body '{"id":"other-order","quantity":1}'
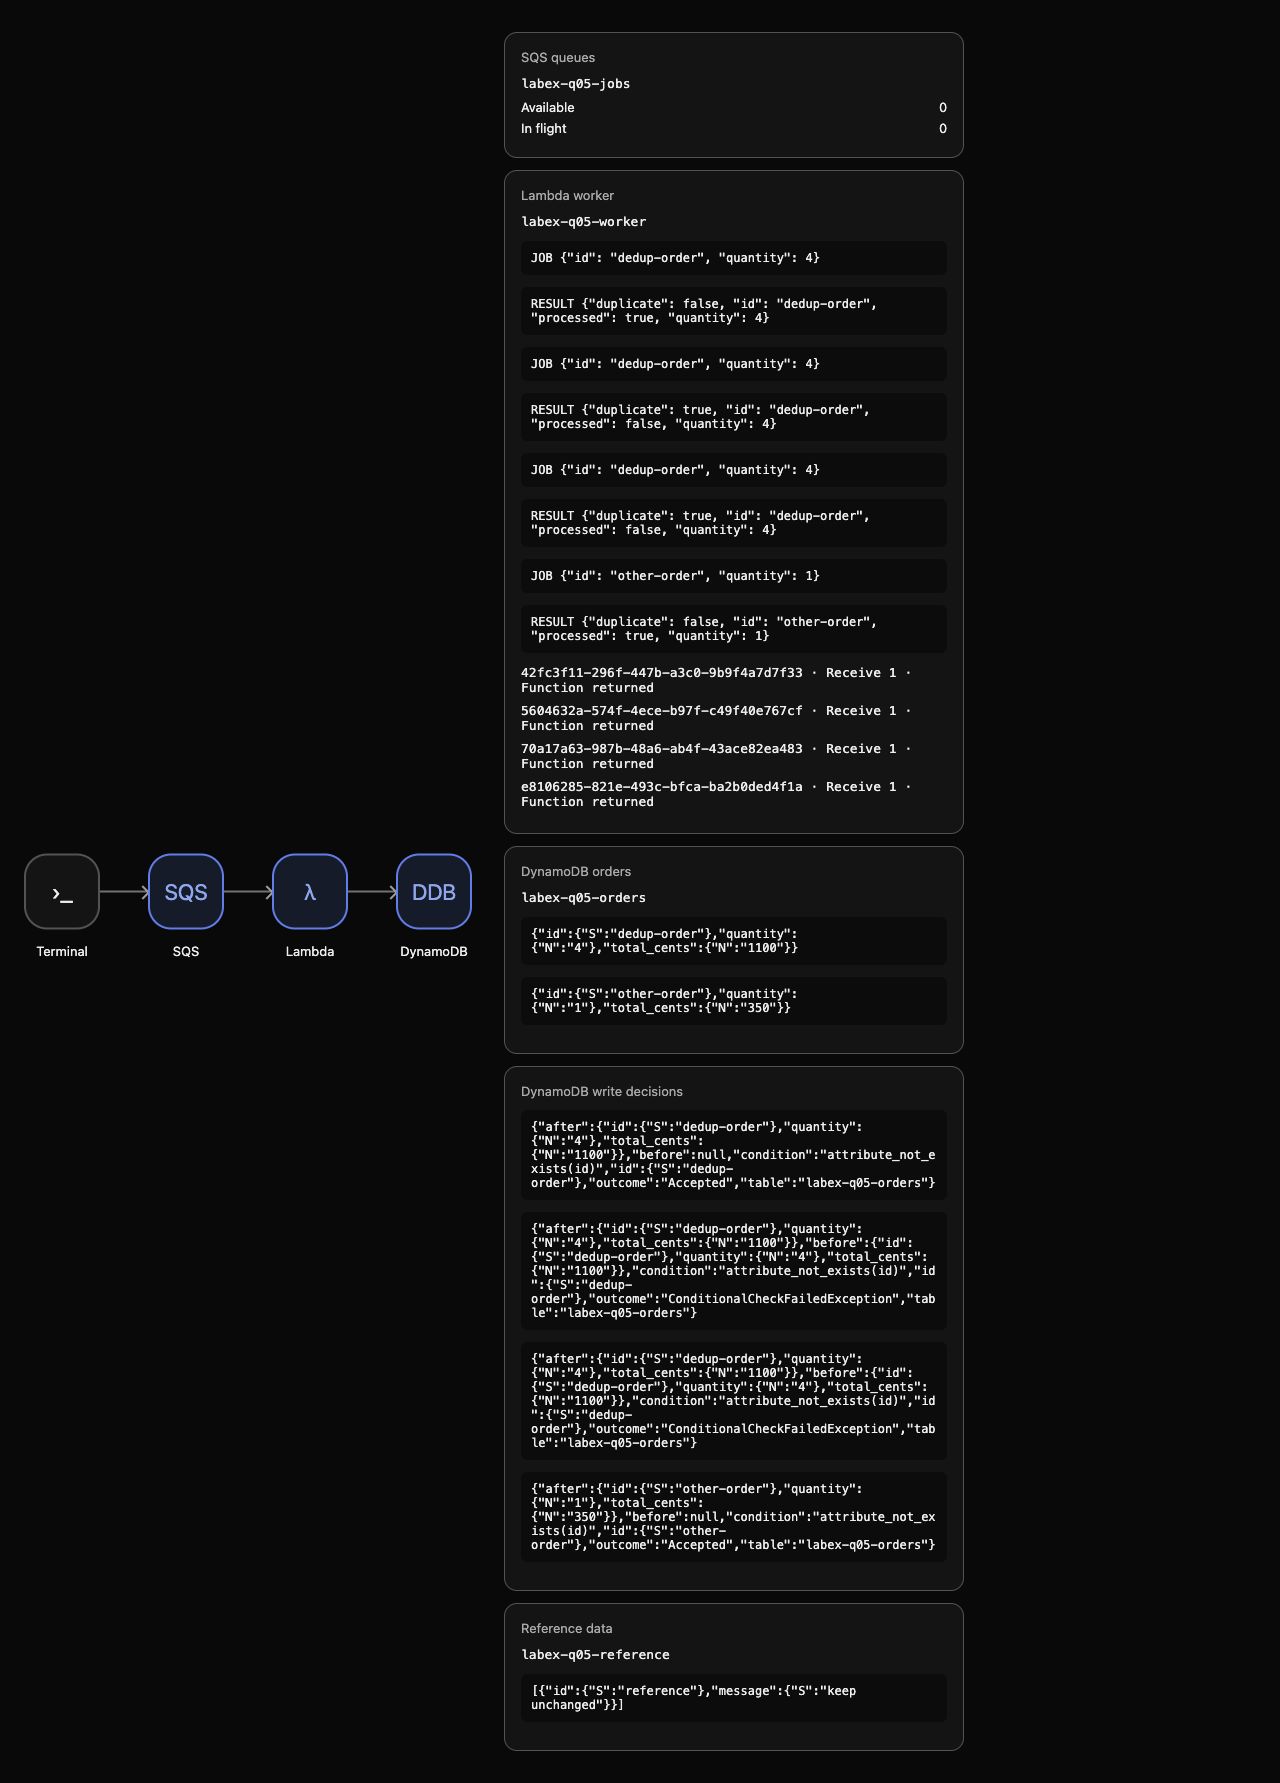
Observez AWS View jusqu'à ce que quatre exécutions réelles aient renvoyé un résultat et que la file soit vide. Les deux exécutions répétées signalent processed: false, duplicate: true. DynamoDB rejette les deux écritures conditionnelles avec ConditionalCheckFailedException ; chaque élément avant et après reste inchangé. La première commande et other-order ont chacune une écriture acceptée. Le consommateur acquitte les copies répétées au lieu de retenter un travail déjà terminé.
Lisez les résultats métier :
aws dynamodb scan --table-name labex-q05-orders --query Items
Vous devez obtenir exactement dedup-order/4/1100 et other-order/1/350 ; l'ordre des éléments peut différer. Inspectez les résultats réels du traitement. Un événement de journal peut contenir plusieurs lignes ; ce pipeline envoie la sortie JSON native à jq -r, découpe chaque événement en lignes et sélectionne uniquement les lignes RESULT, sans identifiants de réception dans les résultats affichés :
aws logs filter-log-events --log-group-name /aws/lambda/labex-q05-worker --filter-pattern '"RESULT"' --output json | jq -r '.events[].message | split("\n")[] | select(startswith("RESULT "))'
Contrôlez l'acquittement :
aws sqs get-queue-attributes --queue-url "$QUEUE_URL" --attribute-names ApproximateNumberOfMessages ApproximateNumberOfMessagesNotVisible
Les deux compteurs sont à zéro. Il y a eu quatre véritables livraisons de messages et exécutions de fonction, deux écritures métier acceptées et deux rejets conditionnels natifs. Compter uniquement les éléments de la table ne révélerait pas les écrasements inconditionnels ; utilisez aussi les décisions réelles et les résultats correspondants du consommateur.
La protection concerne un élément métier. Elle ne fait pas de l'écriture DynamoDB et de l'acquittement SQS une seule opération atomique. L'enregistrement de commande est la protection durable contre les doublons. Le supprimer permet à la même clé de créer de nouveau un élément : la conservation et la conception des clés métier font donc partie de la politique d'un système réel. Ces répétitions fictives démontrent un traitement sûr du même travail métier ; elles n'établissent pas de garantie de concurrence en production ni de traitement exactement une fois de bout en bout.
Supprimer la connexion du consommateur et les résultats métier
Dans cette étape, supprimez votre connexion et vos ressources après avoir confirmé la gestion des doublons.
Arrêtez votre mappage de source d'événements avant de supprimer sa file source :
aws lambda delete-event-source-mapping --uuid "$MAPPING_ID" --query UUID --output text
aws sqs delete-queue --queue-url "$QUEUE_URL"
Supprimez les deux éléments métier fictifs et les journaux d'exécution de ce laboratoire :
aws dynamodb delete-item --table-name labex-q05-orders --key '{"id":{"S":"dedup-order"}}'
aws dynamodb delete-item --table-name labex-q05-orders --key '{"id":{"S":"other-order"}}'
aws logs delete-log-group --log-group-name /aws/lambda/labex-q05-worker
Confirmez l'absence de vos ressources et conservez les données de référence indépendantes :
aws lambda list-event-source-mappings --function-name labex-q05-worker --query EventSourceMappings
aws sqs list-queues
aws dynamodb scan --table-name labex-q05-orders --query Items
aws dynamodb scan --table-name labex-q05-reference --query Items
Les mappages et les commandes sont absents, aucune URL de file ne reste et l'élément de référence indique toujours keep unchanged. La fonction et les structures des tables fournies restent dans l'environnement. Une erreur de réseau ou d'authentification ne peut pas prouver la suppression. AWS View conserve les décisions d'écriture historiques tout en affichant les ressources actuelles vides.
Supprimez vos fichiers ordinaires de code et d'archive :
rm -f app.py function.zip
Exécutez la vérification du nettoyage avant de terminer l'environnement.
Résumé
Vous avez déployé une condition atomique DynamoDB sur une clé métier dans un véritable consommateur de file. La première commande a abouti ; deux copies envoyées séparément ont été consommées et acquittées après que le rejet conditionnel natif a préservé l'élément d'origine. Une clé différente a toujours produit son propre résultat. Les écritures réelles, les résultats du traitement et l'état vide de la file ont prouvé le résultat avant le nettoyage ciblé.
Le défi applique l'isolation des échecs avec un nombre limité de tentatives, puis le projet sans serveur combine la récupération depuis une DLQ avec cette protection sur la clé métier.


