Introduction
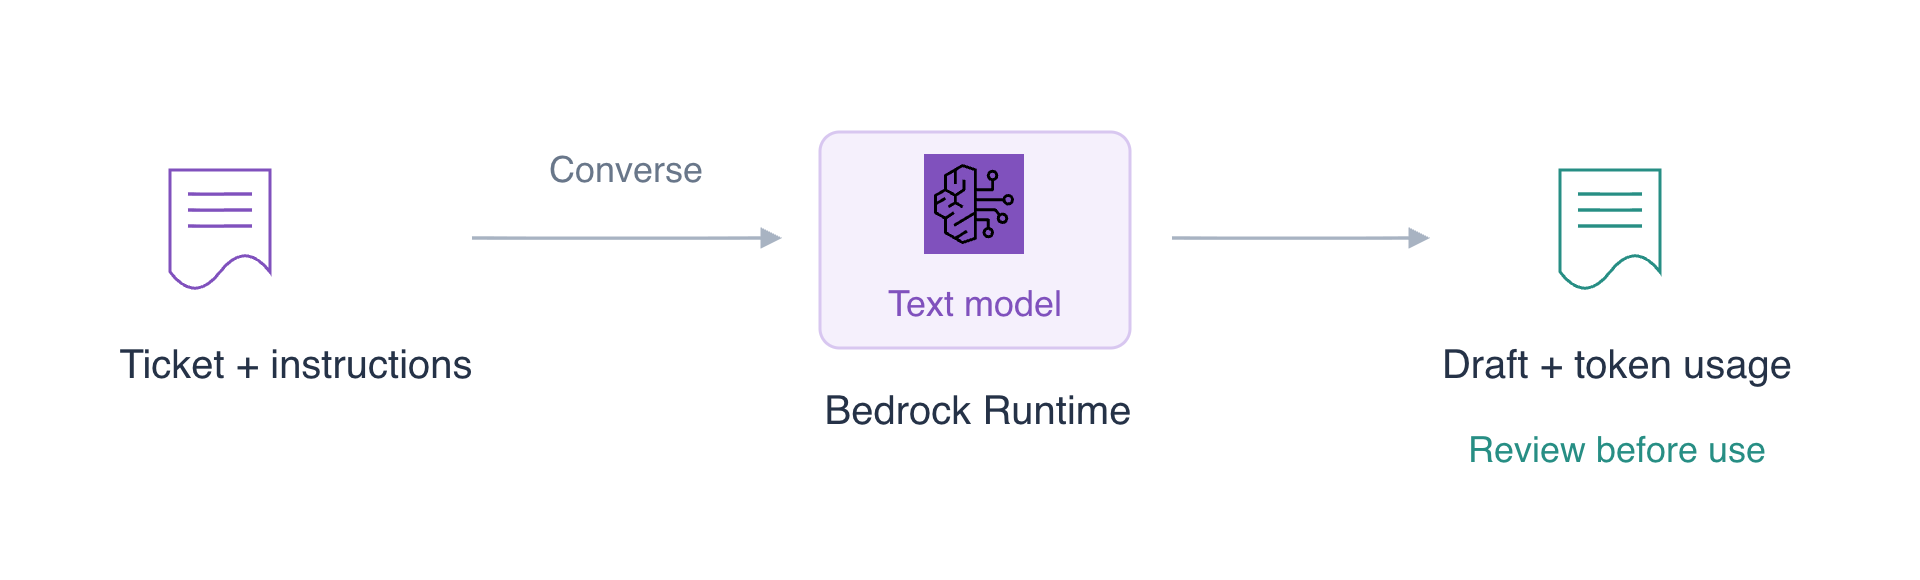
Une équipe de support doit préparer une réponse à un signalement de double prélèvement. Vous enverrez le ticket à Bedrock Runtime, affinerez les instructions, examinerez la réponse générée et comparerez l’utilisation des tokens à une limite de sortie. AWS CLI est déjà configurée dans votre nouvelle VM LabEx ; utilisez uniquement le ticket synthétique fourni.
Vous devez savoir exécuter une commande et lire un fichier texte. Il s’agit de générer et relire un brouillon, pas d’envoyer un message au client ni de modifier la facturation.
Lien avec la certification
| Certification | Tâche d’examen | Pratique |
|---|---|---|
| AI Practitioner (AIF-C01) | Tâches 3.1, 3.2 | Ajuster la longueur de sortie, donner des instructions explicites et relire le texte généré. |
Rédiger une réponse de support
Dans cette étape, vous choisirez un modèle de texte disponible et enverrez un ticket à Bedrock Runtime.
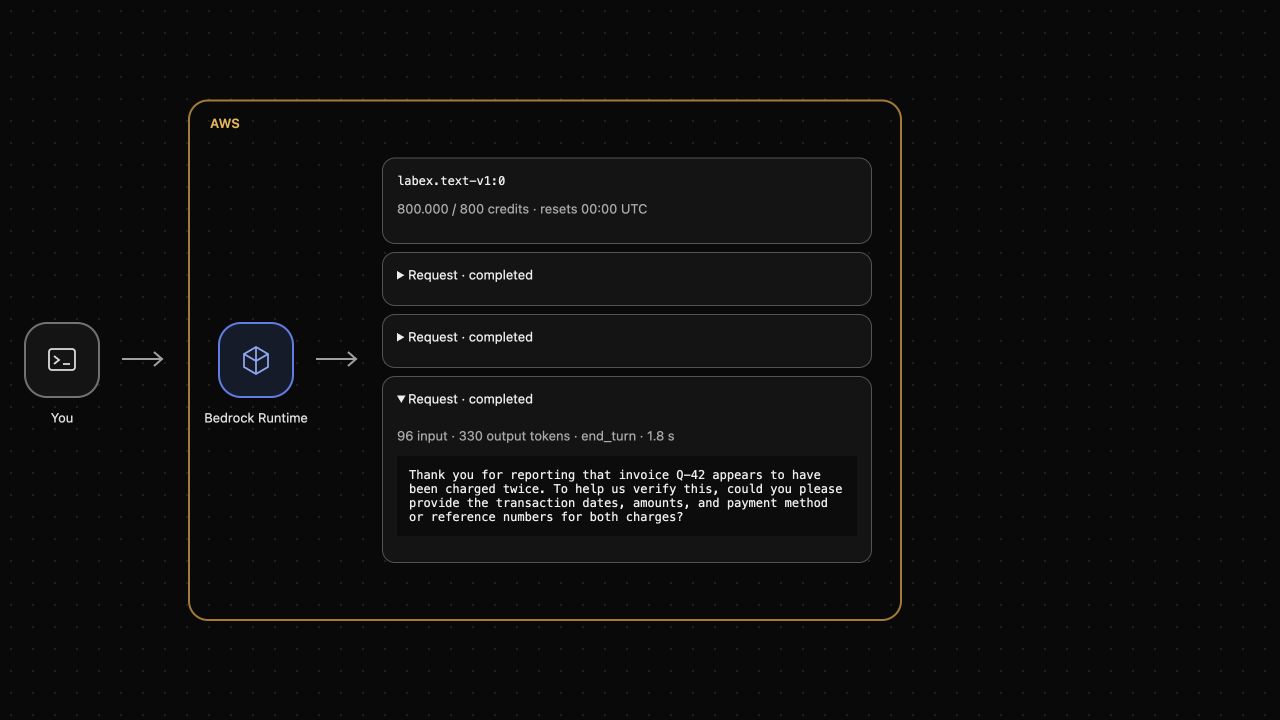
En haut, AWS View montre le modèle et les résultats réels des requêtes. Saisissez les commandes dans Terminal, en dessous. Avant toute requête, la vue n’affiche aucune réponse. Elle montrera une requête en attente, puis sa réponse, son utilisation et le quota restant.
Bedrock donne accès à des modèles de fondation, capables de générer du texte pour de nombreuses tâches. Un identifiant sélectionne le modèle ; Converse est un format de requête commun aux modèles conversationnels compatibles. Vous utiliserez ici le modèle textuel disponible dans cet espace.
Placez-vous dans le répertoire de l’exercice. cd change le répertoire courant de Terminal :
cd /home/labex/project
Listez les modèles produisant du texte. --by-output-modality TEXT filtre le catalogue. --query sélectionne l’identifiant et le nom lisible, et --output table affiche ces champs en tableau :
aws bedrock list-foundation-models \
  --by-output-modality TEXT \
  --query 'modelSummaries[].[modelId,modelName]' \
  --output table
Le tableau contient labex.text-v1:0, utilisé ci-dessous. Une entrée décrit un modèle ; elle ne signifie pas qu’une requête d’inférence a déjà été exécutée.
Une requête Converse comprend un modelId, une liste de messages et des paramètres d’inférence facultatifs. Chaque message possède un role et des blocs de contenu. Un message user contient la question ou la tâche ; un bloc textuel utilise le champ text. maxTokens borne la sortie générée et temperature contrôle la variation de l’échantillonnage. Une valeur basse peut réduire la variation, sans garantir des réponses exactes ou identiques.
Créez la requête JSON. cat > request.json écrit un fichier ; <<'EOF' commence une saisie littérale multiligne et le dernier EOF la termine. Seul le fichier nommé de l’exercice est remplacé :
cat > request.json <<'EOF'
{
  "modelId": "labex.text-v1:0",
  "messages": [
    {
      "role": "user",
      "content": [{"text": "Customer ticket Q-42: the customer reports that invoice Q-42 was charged twice. Draft an English support reply in two sentences."}]
    }
  ],
  "inferenceConfig": {"maxTokens": 512, "temperature": 0}
}
EOF
Envoyez la requête avec bedrock-runtime converse. --cli-input-json file://request.json lit les champs dans ce fichier. Le dernier > reply.json enregistre la réponse JSON au lieu de l’afficher :
aws bedrock-runtime converse \
  --cli-input-json file://request.json \
  > reply.json
Attendez le retour de l’invite de Terminal. La génération prend généralement quelques secondes. Ne lancez aucune autre requête tant que la première est en attente.
Lisez la réponse :
cat reply.json
Cherchez output.message.role: "assistant" et un bloc text non vide. usage indique les tokens traités et metrics.latencyMs le temps en millisecondes. Au-dessus de Terminal, développez la requête terminée dans AWS View et comparez sa réponse au fichier.
Relisez attentivement le brouillon. Affirme-t-il qu’une enquête a commencé, qu’un remboursement a été effectué ou qu’un prélèvement a été confirmé ? Le ticket ne fournit aucun de ces faits. Une réponse fluide peut inventer des détails ; vous préciserez ensuite les instructions. Une phrase générée n’est pas une opération de facturation réalisée.
Affiner les instructions de rédaction
Dans cette étape, vous ajouterez des instructions explicites et produirez un autre brouillon à partir des mêmes faits signalés.
Le champ system donne les instructions de tâche et de style. Gardez le ticket dans le message utilisateur et les contraintes dans le message système. Des instructions précises peuvent réduire les détails indésirables, mais il faut toujours relire la réponse.
Créez une requête distincte afin de conserver le premier brouillon pour comparaison :
cat > revised-request.json <<'EOF'
{
  "modelId": "labex.text-v1:0",
  "system": [
    {"text": "You draft customer-support replies. Use only the facts in the ticket. Write two concise English sentences. Acknowledge the customer's report and ask for information needed to verify it. Do not claim that a charge was confirmed, an investigation started or a refund issued."}
  ],
  "messages": [
    {
      "role": "user",
      "content": [{"text": "Customer ticket Q-42: the customer reports that invoice Q-42 was charged twice. No billing check or refund has been completed. Draft a reply."}]
    }
  ],
  "inferenceConfig": {"maxTokens": 512, "temperature": 0}
}
EOF
Générez le brouillon révisé :
aws bedrock-runtime converse \
  --cli-input-json file://revised-request.json \
  > revised-reply.json
Examinez la réponse enregistrée avec le formateur JSON standard de Python : il vérifie la validité du fichier et le rend lisible :
python3 -m json.tool revised-reply.json
Dans AWS View, développez la nouvelle requête terminée. Comparez les deux brouillons au ticket. La requête révisée doit clarifier vos attentes ; juger si cette réponse les respecte reste une responsabilité humaine. Si elle invente une action, n’utilisez pas cette phrase dans une réponse au client.
Les requêtes sont indépendantes. Réutiliser le même modèle ne transmet pas automatiquement la réponse précédente comme historique. Une conversation ultérieure devrait inclure explicitement ses anciens messages utilisateur et assistant dans messages.
Examiner les tokens et les limites de sortie
Dans cette étape, vous enverrez la même tâche avec un plafond inférieur et examinerez l’utilisation réelle.
Un token est une unité de texte traitée par un modèle, pas nécessairement un mot. Les tokens d’entrée comprennent tâche, instructions système et historique fourni. Les tokens de sortie comprennent ceux générés et signalés par le modèle, éventuellement du raisonnement interne. Le totalTokens retourné additionne entrée et sortie.
maxTokens est un plafond, pas une demande de produire exactement ce nombre. Le modèle peut finir plus tôt. Créez une requête plafonnée à 384 tokens au lieu de 512 :
cat > bounded-request.json <<'EOF'
{
  "modelId": "labex.text-v1:0",
  "system": [
    {"text": "You draft customer-support replies. Use only the facts in the ticket. Write two concise English sentences. Acknowledge the customer's report and ask for information needed to verify it. Do not claim that a charge was confirmed, an investigation started or a refund issued."}
  ],
  "messages": [
    {
      "role": "user",
      "content": [{"text": "Customer ticket Q-42: the customer reports that invoice Q-42 was charged twice. No billing check or refund has been completed. Draft a reply."}]
    }
  ],
  "inferenceConfig": {"maxTokens": 384, "temperature": 0}
}
EOF
Envoyez-la et enregistrez la réponse :
aws bedrock-runtime converse \
  --cli-input-json file://bounded-request.json \
  > bounded-reply.json
Examinez le résultat :
python3 -m json.tool bounded-reply.json
Comparez usage.outputTokens au plafond de 384. stopReason: "end_turn" indique une fin normale ; "max_tokens" indique que la limite a été atteinte et que le texte peut être incomplet. Ne considérez jamais une réponse partielle comme un document terminé.
AWS View montre la même utilisation et les crédits restants. Les crédits suivent une consommation d’entrée/sortie propre au modèle ; compter les tokens ne fixe pas un prix universel. Une requête répétée peut utiliser un résultat en cache : les tokens peuvent être indiqués sans baisse du quota. Un plafond borne la requête, mais le réduire ne garantit pas que cette courte réponse consomme moins que chacune des précédentes.
Si la requête échoue ou son utilisation est incertaine, examinez l’erreur avant de réessayer. Une requête incertaine peut conserver du quota réservé ; une nouvelle requête peut consommer davantage. Le traitement applicatif de ces cas sera enseigné plus loin.
Nettoyer les fichiers de l’exercice
Dans cette étape, vous supprimerez les fichiers locaux de requête et de réponse après relecture.
Converse envoie une requête d’inférence ; il ne crée pas de serveur ou de base à supprimer. Les six fichiers JSON sont des artefacts locaux. Les supprimer n’annule pas les tokens utilisés et ne rembourse pas les crédits consommés.
rm supprime les fichiers nommés. Utilisez exactement les noms suivants et préservez les autres fichiers du projet :
rm request.json reply.json revised-request.json revised-reply.json bounded-request.json bounded-reply.json
Listez les entrées visibles restantes :
ls
Les six fichiers doivent avoir disparu. AWS View conserve les résultats réels des requêtes terminées de cette VM, utilisation comprise. Supprimer un fichier local ne transforme pas un échec en succès et n’efface pas sa consommation.
Résumé
Vous avez envoyé des requêtes textuelles réelles avec Bedrock Converse, affiné les instructions système, examiné réponses et tokens, borné la sortie et supprimé les fichiers locaux. Vous avez aussi distingué un brouillon plausible d’un fait métier vérifié : toute réponse doit être relue avant utilisation.
Pour approfondir ce sujet, consultez la documentation AWS : Messages, instructions et paramètres d’inférence Converse; Contenu, raisons d’arrêt et utilisation des réponses Converse.