Introduction
Le magasin veut une synthèse mensuelle CSV partageable. Calculez avec Athena, récupérez la sortie S3 réelle, corrigez une vente et produisez une nouvelle synthèse. Comparez les sorties pour comprendre leur relation aux données lors de l’exécution.
Terminez Query Partitioned Sales Data. Cet environnement indépendant fournit deux fichiers S3, leurs partitions Glue, une identité AWS et September corrigé localement. Aucun compte personnel ni ressource antérieure n’est nécessaire. Utilisez la CLI officielle dans Terminal et observez fichiers, catalogue et résultats dans AWS View.
Pertinence pour la certification
| Certification | Tâche de l’examen | Pratique |
|---|---|---|
| Cloud Practitioner (CLF-C02) | Task 3.7 | Analyser S3 avec Athena et Glue et récupérer les résultats calculés. |
Calculer la synthèse mensuelle
Dans cette étape, calculez sur les fichiers actuels. Glue décrit schéma et emplacements, Athena lit et groupe par mois. Chaque exécution a son ID et son fichier.
Entrez dans le projet et vérifiez l’identité :
cd /home/labex/project
aws sts \
  get-caller-identity
L’ARN se termine par labex-an04-operator. jq -r extrait les chaînes JSON, $(...) conserve la sortie dans une variable :
INPUT_BUCKET=$(jq -r .input_bucket resources.json)
echo "$INPUT_BUCKET"
DATABASE=$(jq -r .database resources.json)
echo "$DATABASE"
RESULT_LOCATION=$(jq -r .output_location resources.json)
echo "$RESULT_LOCATION"
Vérifiez les emplacements enregistrés :
aws glue \
  get-partitions \
  --database-name "$DATABASE" \
  --table-name sales \
  --query 'Partitions[*].{Month:Values[0],Location:StorageDescriptor.Location}'
Les deux mois sont présents. Additionner des cents entiers dans total_cents évite les arrondis monétaires. COUNT(*) compte, GROUP BY month regroupe, ORDER BY month facilite la comparaison. Le heredoc cité conserve le SQL exact :
cat > monthly-summary.sql <<'EOF'
SELECT month, SUM(total_cents) AS revenue_cents, COUNT(*) AS orders
FROM sales
GROUP BY month
ORDER BY month;
EOF
Soumettez avec base et préfixe S3. file:// lit le SQL ; --query et --output text CLI extraient l’ID :
SUMMARY_QUERY_ID=$(aws athena \
  start-query-execution \
  --query-string file://monthly-summary.sql \
  --query-execution-context "Database=$DATABASE" \
  --result-configuration "OutputLocation=$RESULT_LOCATION" \
  --query QueryExecutionId \
  --output text)
echo "$SUMMARY_QUERY_ID"
Répétez pour QUEUED ou RUNNING, continuez à SUCCEEDED, examinez Reason pour FAILED :
aws athena \
  get-query-execution \
  --query-execution-id "$SUMMARY_QUERY_ID" \
  --query 'QueryExecution.{State:Status.State,Reason:Status.StateChangeReason}'
La projection imbriquée [*] conserve les colonnes de chaque ligne :
aws athena \
  get-query-results \
  --query-execution-id "$SUMMARY_QUERY_ID" \
  --query 'ResultSet.Rows[*].Data[*].VarCharValue' \
  --output table
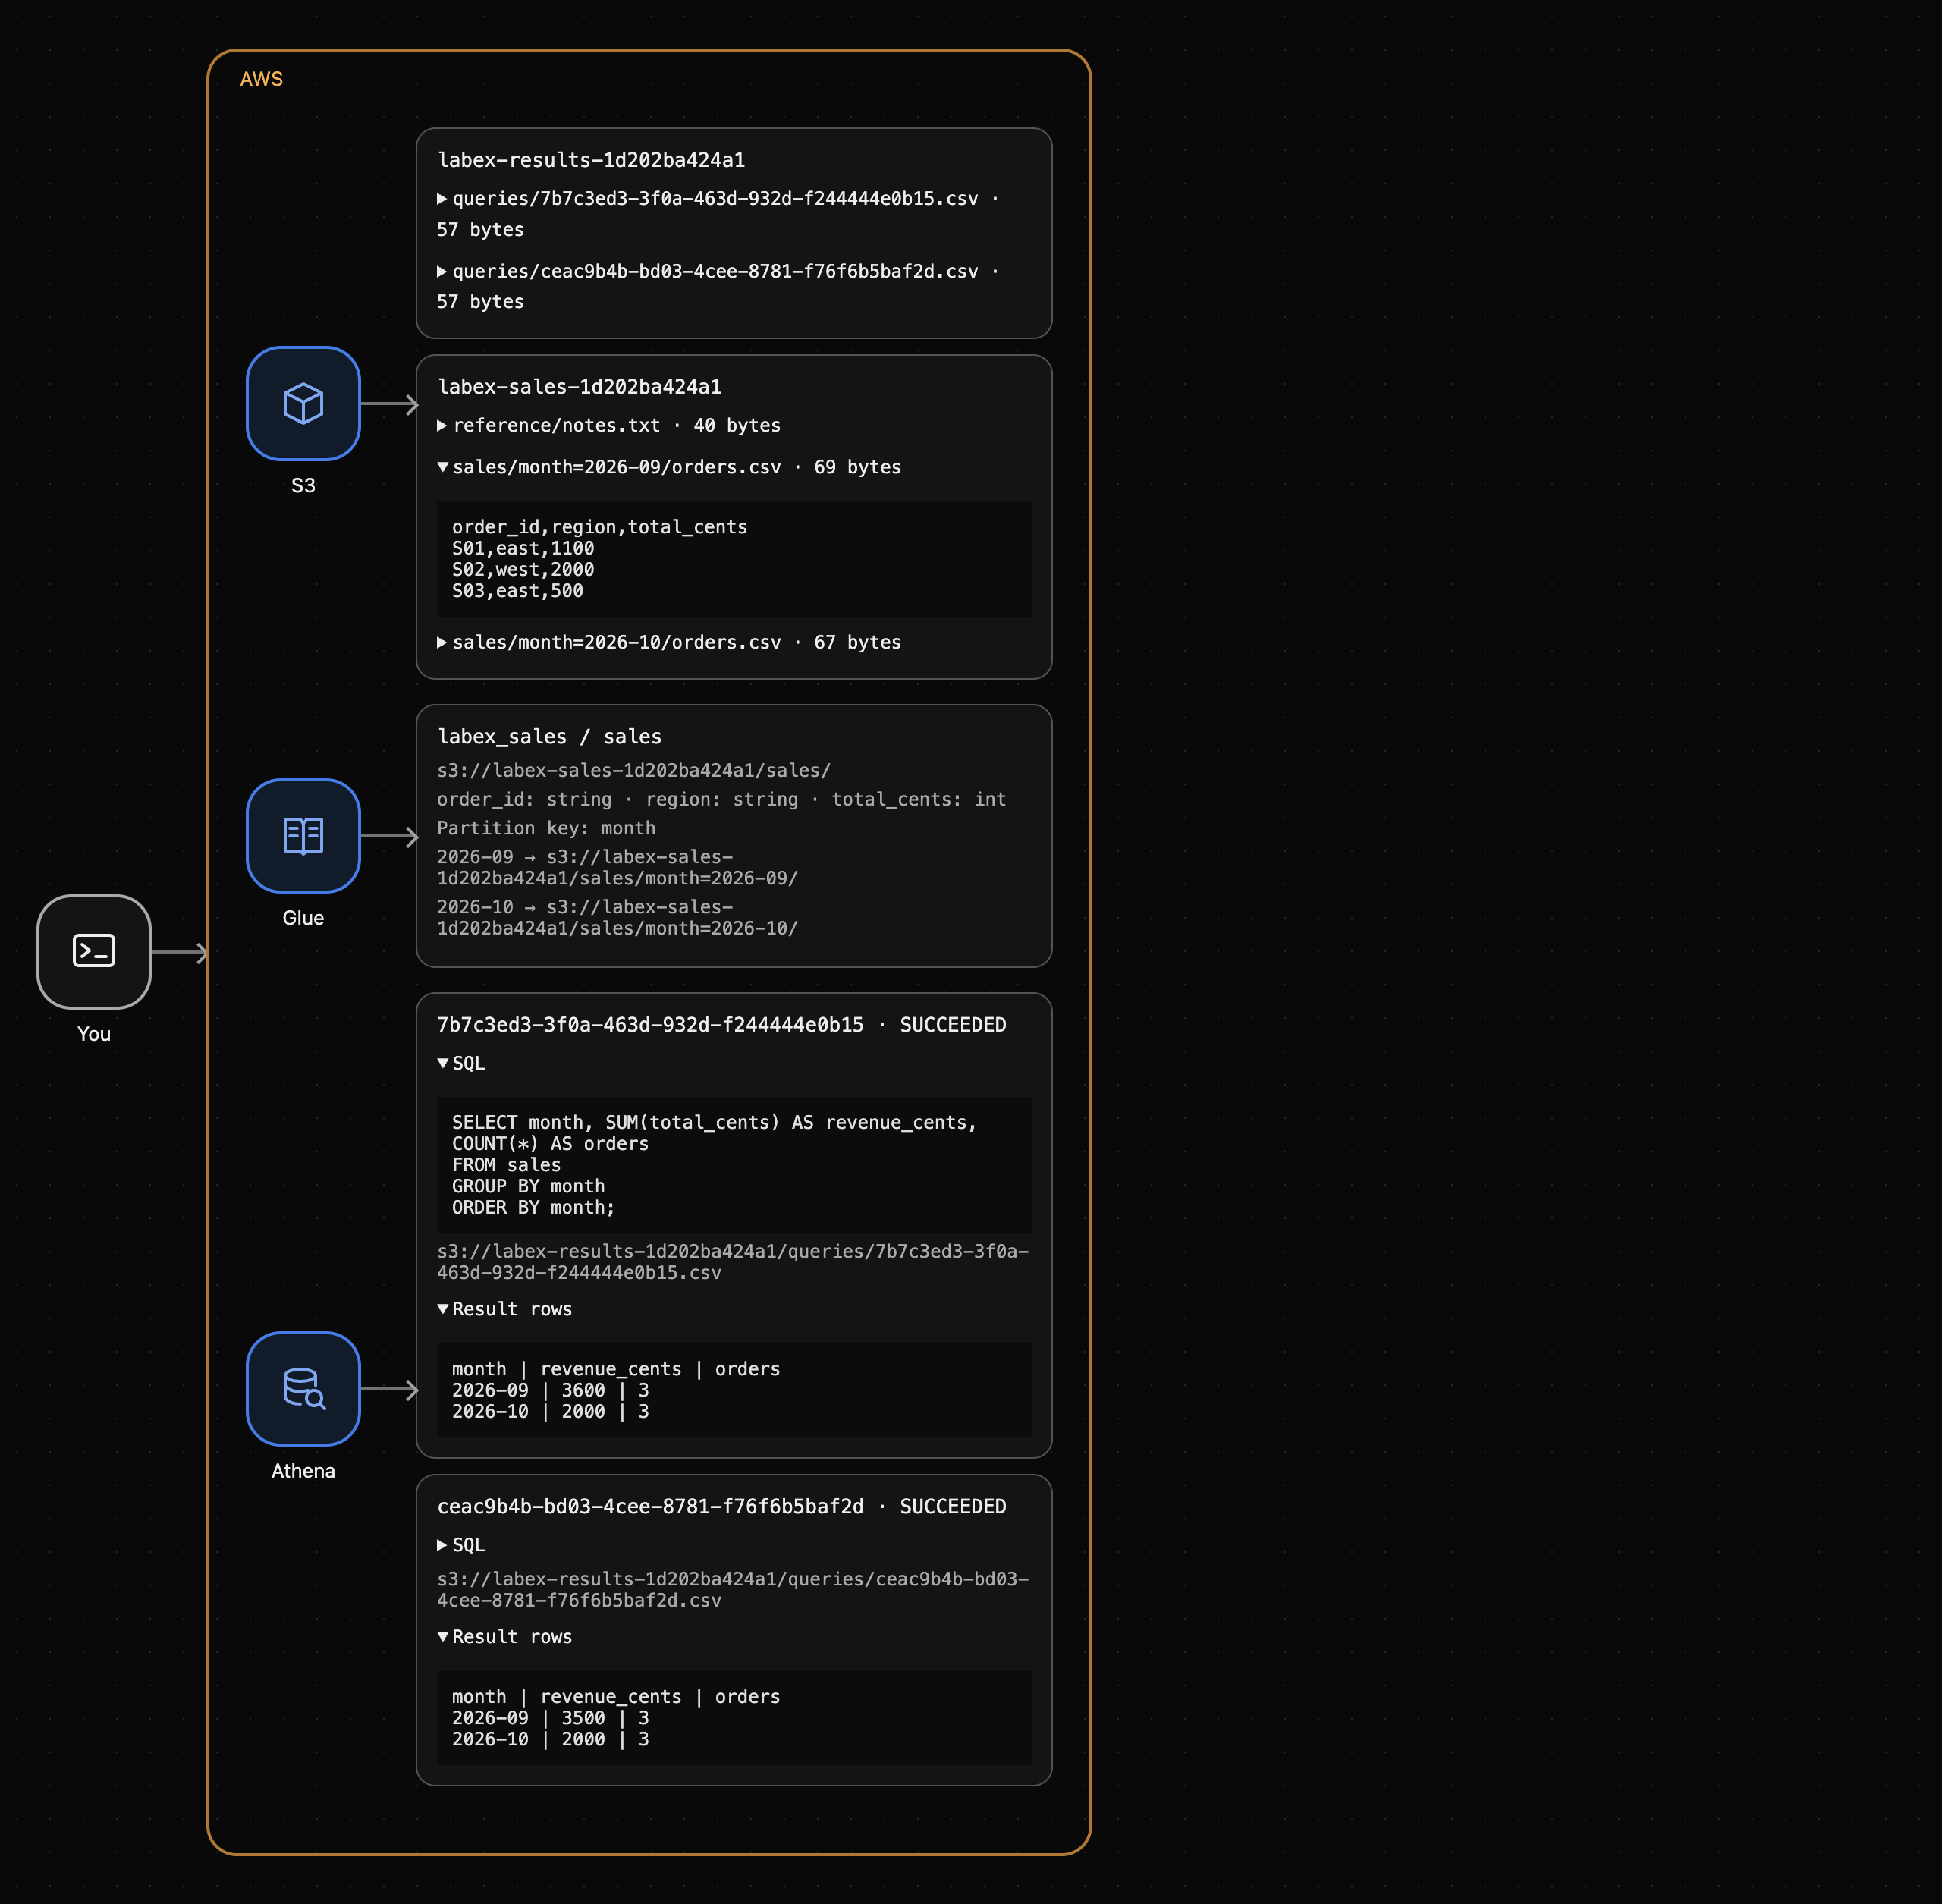
September : 3500 cents/3 commandes ; October : 2000/3. Comparez SQL et lignes dans AWS View aux emplacements mensuels.
Télécharger le vrai résultat S3
Dans cette étape, récupérez le CSV de cette exécution. L’API affiche les lignes, les métadonnées indiquent le chemin S3 exact. Ne devinez pas bucket ou ID.
Extrayez et affichez l’URI :
SUMMARY_OUTPUT=$(aws athena \
  get-query-execution \
  --query-execution-id "$SUMMARY_QUERY_ID" \
  --query QueryExecution.ResultConfiguration.OutputLocation \
  --output text)
echo "$SUMMARY_OUTPUT"
Il finit par /queries/<your-execution-id>.csv ; l’ID relie fichier et requête. Téléchargez dans summary.csv :
aws s3 \
  cp "$SUMMARY_OUTPUT" summary.csv
Inspectez le contenu :
cat summary.csv
En-tête et deux lignes :
month,revenue_cents,orders
2026-09,3500,3
2026-10,2000,3
Les valeurs correspondent à l’API. C’est un vrai fichier téléchargé, pas un rapport saisi manuellement. Conservez summary.csv et la sortie S3 initiale.
Recalculer après correction
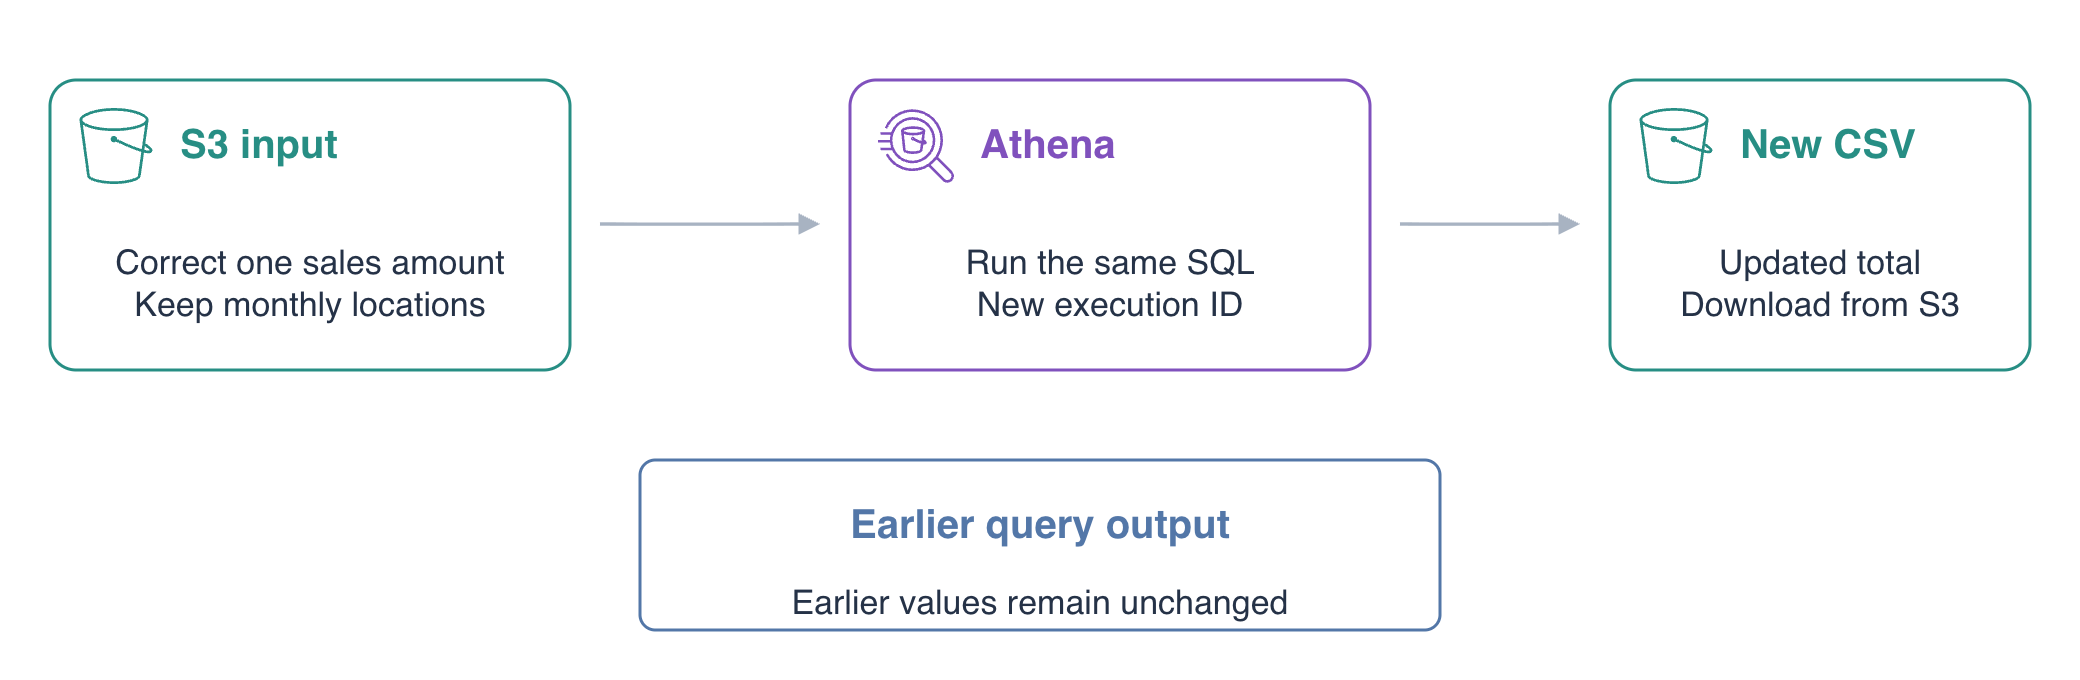
Dans cette étape, corrigez un montant September et relancez le même SQL. L’ancien résultat ne s’actualise pas automatiquement ; une nouvelle exécution doit lire les données actuelles.
Inspectez la correction :
cat september-revised.csv
S01 passe de 1000 à 1100 cents, les autres restent identiques : total 3600. Remplacez l’objet September sans changer October ni reference/notes.txt :
aws s3 \
  cp september-revised.csv "s3://$INPUT_BUCKET/sales/month=2026-09/orders.csv"
Relisez pour confirmer :
aws s3 \
  cp "s3://$INPUT_BUCKET/sales/month=2026-09/orders.csv" -
Le - final affiche l’objet. Schéma et emplacement identiques gardent la partition Glue valable. Relancez le SQL avec un nouvel ID :
REVISED_QUERY_ID=$(aws athena \
  start-query-execution \
  --query-string file://monthly-summary.sql \
  --query-execution-context "Database=$DATABASE" \
  --result-configuration "OutputLocation=$RESULT_LOCATION" \
  --query QueryExecutionId \
  --output text)
echo "$REVISED_QUERY_ID"
Confirmez le succès, répétez si nécessaire et inspectez les échecs :
aws athena \
  get-query-execution \
  --query-execution-id "$REVISED_QUERY_ID" \
  --query 'QueryExecution.{State:Status.State,Reason:Status.StateChangeReason}'
Récupérez les lignes :
aws athena \
  get-query-results \
  --query-execution-id "$REVISED_QUERY_ID" \
  --query 'ResultSet.Rows[*].Data[*].VarCharValue' \
  --output table
September devient 3600/3 ; October reste 2000/3. L’entrée corrigée a changé le calcul.
Obtenez la sortie propre à cette exécution :
REVISED_OUTPUT=$(aws athena \
  get-query-execution \
  --query-execution-id "$REVISED_QUERY_ID" \
  --query QueryExecution.ResultConfiguration.OutputLocation \
  --output text)
echo "$REVISED_OUTPUT"
Téléchargez sans écraser la synthèse locale initiale :
aws s3 \
  cp "$REVISED_OUTPUT" summary-revised.csv
Inspectez le nouveau CSV :
cat summary-revised.csv
Comparez l’ancienne sortie S3 :
aws s3 \
  cp "$SUMMARY_OUTPUT" -
Elle garde September=3500. Deux ID désignent des fichiers distincts, pour anciennes et nouvelles données. AWS View montre source actuelle et deux résultats réels. Cela vérifie la correction, pas les coûts ou performances de production.
Résumé
Vous avez calculé les totaux, téléchargé le CSV exact, corrigé une valeur et recalculé. September passe de 3500 à 3600 cents ; October reste à 2000. Les anciennes sorties gardent leurs valeurs : relancez la synthèse quand l’entrée change.
Pour approfondir ce sujet, consultez la documentation AWS : Localiser les fichiers de sortie par exécution de requête; Filtres, groupes et tri avec SELECT.