Introduction
Une équipe d'exploitation a besoin d'un signal d'erreur qui s'active lorsque les requêtes échouent et revient à la normale après un trafic sain. Vous allez configurer une alarme de métrique, observer les deux transitions à partir de vraies requêtes, comparer zéro avec des données manquantes et supprimer vos alarmes.
Terminez d'abord Mesurer la santé d'une application avec les métriques CloudWatch, notamment les dimensions de métrique et Sum. Ce laboratoire fournit une nouvelle application et de nouvelles séries de métriques.
Lien avec les certifications
| Certification | Tâche de l’examen | Pratique |
|---|---|---|
| CloudOps Engineer – Associate (SOA-C03) | Tâche 1.1 | Évaluation des alarmes CloudWatch, retour à la normale et données manquantes. |
| DevOps Engineer – Professional (DOP-C02) | Tâche 4.2 | Pratique des fondamentaux : Évaluation des alarmes CloudWatch, retour à la normale et données manquantes. |
| Solutions Architect – Professional (SAP-C02) | Tâche 3.1 | Pratique des fondamentaux : Évaluation des alarmes CloudWatch, retour à la normale et données manquantes. |
Vue d’ensemble du lab
Configurer une alarme de métrique
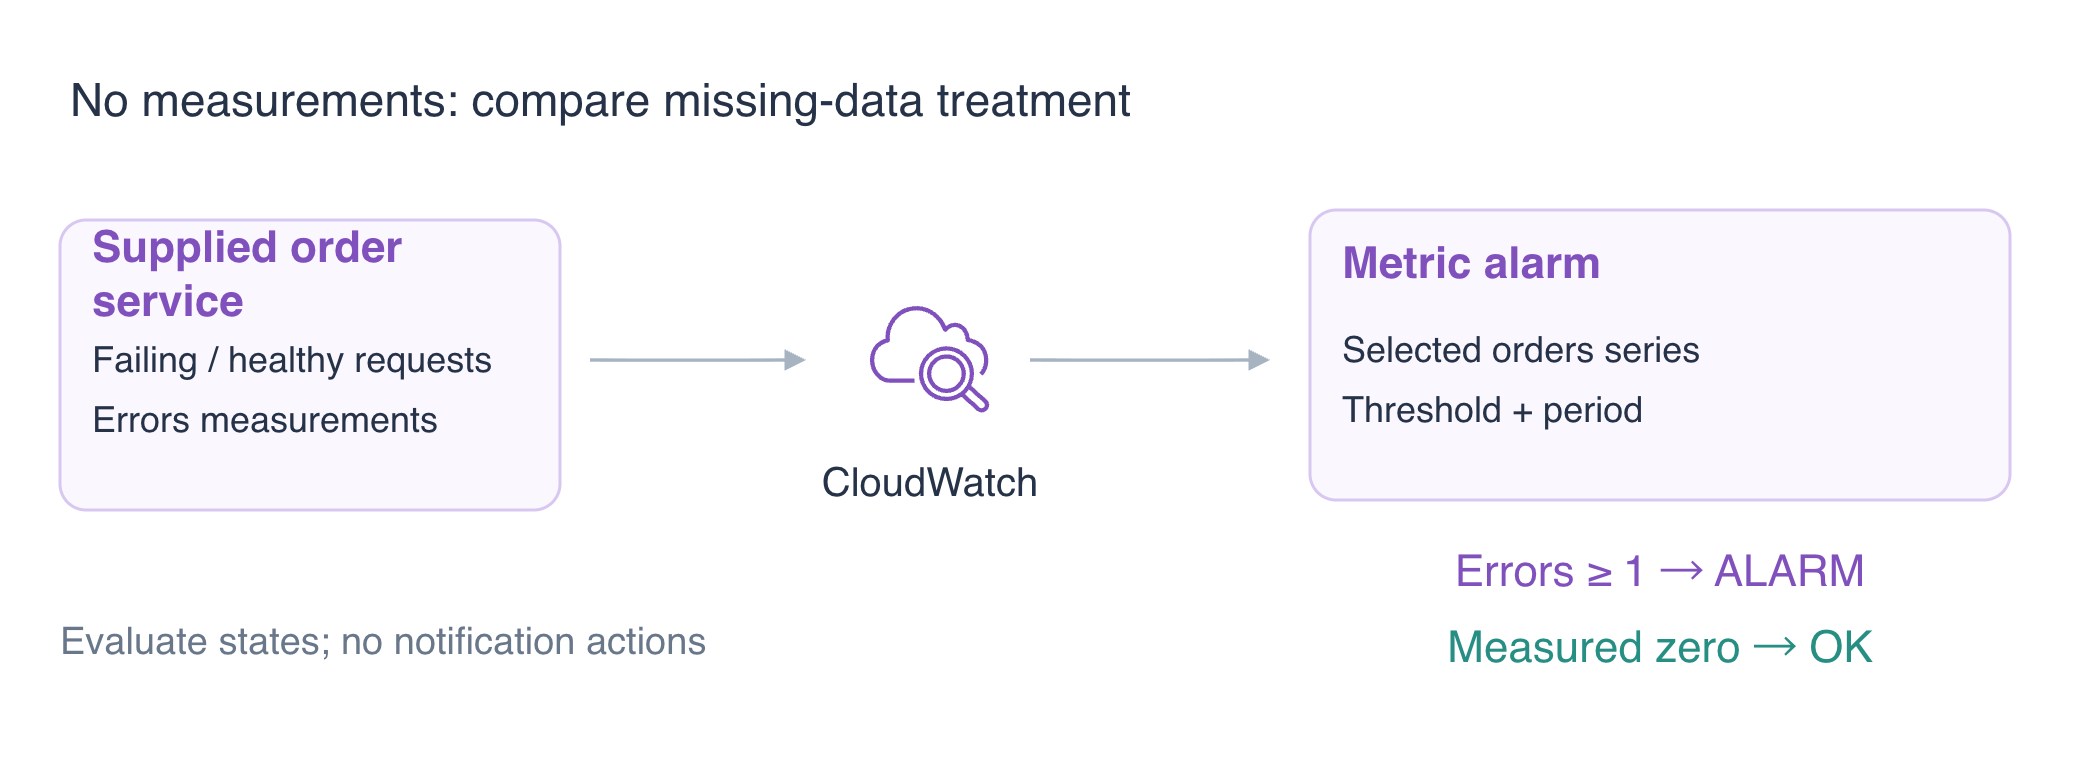
Dans cette étape, vous allez surveiller le nombre d'erreurs serveur de l'application orders. Une alarme évalue une métrique par rapport à un seuil et indique OK, ALARM ou INSUFFICIENT_DATA. Elle n'envoie pas de notification à moins qu'une action soit configurée ; cet exercice se concentre sur l'évaluation.
L'application préparée indépendante publie de vraies métriques de requête. Sa métrique Errors vaut un pour HTTP 5xx et zéro pour une requête saine. La publication haute résolution permet une période de 10 secondes afin d'observer rapidement plusieurs périodes. En production, les périodes et seuils dépendent de la charge de travail et du coût.
cd /home/labex/project
Créez une alarme sur une seule métrique. L'espace de noms, le nom et les dimensions sélectionnent la série ; Sum compte les erreurs dans chaque période terminée.
L'alarme évalue une période terminée de 10 secondes (--period 10, --evaluation-periods 1). Une Sum d'au moins 1 atteint le seuil ; GreaterThanOrEqualToThreshold signifie « supérieur ou égal ». notBreaching considère qu'une période sans mesure ne dépasse pas le seuil. Cela maintient les périodes inactives à OK, sans établir pour autant la santé de l'application.
aws cloudwatch put-metric-alarm \
  --alarm-name labex-o03-orders-errors \
  --namespace LabEx/O03 \
  --metric-name Errors \
  --dimensions Name=Application,Value=orders \
  --statistic Sum \
  --unit Count \
  --period 10 \
  --evaluation-periods 1 \
  --threshold 1 \
  --comparison-operator GreaterThanOrEqualToThreshold \
  --treat-missing-data notBreaching
Lisez l'alarme ci-dessous. Si l'évaluation est encore en attente, attendez quelques secondes et répétez cette commande de lecture jusqu'à ce qu'elle indique OK.
L'état OK initial provient du traitement des données manquantes, pas d'un contrôle de santé réussi. Inspectez la raison évaluée :
aws cloudwatch describe-alarms \
  --alarm-names labex-o03-orders-errors \
  --query 'MetricAlarms[0].[StateValue,StateReason,Dimensions]'
Conservez /labex/o03-reference inchangé. Chaque laboratoire démarre indépendamment ; aucune donnée de métrique antérieure n'est nécessaire.
Déclencher l'alarme avec de vrais échecs
Dans cette étape, vous allez générer de vraies requêtes échouées et attendre l'évaluation automatique. Une période terminée exclut les points de la période actuelle incomplète ; observer la réponse HTTP et l'état de l'alarme constitue deux observations distinctes.
pear est indisponible dans le service fourni. La boucle envoie neuf requêtes espacées de deux secondes pour couvrir plusieurs périodes de 10 secondes. for répète les commandes ; sleep 2 marque une pause entre les requêtes. curl sans -f renvoie le corps de réponse même pour HTTP 503, ce qui rend l'échec observable.
for request in $(seq 1 9); do
  curl -sS -H 'Content-Type: application/json' -d '{"sku":"pear","quantity":1}' http://127.0.0.1:5050/orders
  echo
  sleep 2
done
Lisez l'état évalué. S'il n'a pas encore atteint ALARM, attendez quelques secondes et répétez cette commande. StateReasonData est du JSON stocké sous forme de chaîne : ses guillemets apparaissent donc échappés dans la réponse ; recentDatapoints liste les sommes des périodes évaluées.
aws cloudwatch describe-alarms \
  --alarm-names labex-o03-orders-errors \
  --query 'MetricAlarms[0].[StateValue,StateReason,StateReasonData]'
Attendez-vous à obtenir ALARM et une valeur recentDatapoints d'au moins 1 dans StateReasonData. Si l'évaluation affiche encore la période précédente, attendez quelques secondes et répétez la commande de lecture. L'état suit les points réellement issus des requêtes ; ne définissez pas manuellement l'état de l'alarme. L'alarme surveille uniquement orders : la série d'une autre application n'entre donc pas dans cette évaluation.
Pour l’équipe des commandes, ALARM indique si la période sélectionnée contient des erreurs serveur. Il n’explique pas quelle requête a échoué ni pourquoi le stock était indisponible. La réponse HTTP établit l’échec métier, le point évalué établit la transition de l’alarme et les journaux fournissent les détails du diagnostic. Distingue ces observations pour choisir ce qu’il faut examiner.
Observer le retour à la normale et les données manquantes
Dans cette étape, vous allez distinguer un zéro réel d'une télémétrie absente. Envoyez des requêtes saines pour apple afin que les périodes terminées contiennent des mesures Errors=0. Répéter les requêtes sur plusieurs périodes évite de confondre l'intervalle actuel incomplet avec le retour à la normale.
for request in $(seq 1 9); do
  curl -sS -H 'Content-Type: application/json' -d '{"sku":"apple","quantity":1}' http://127.0.0.1:5050/orders
  echo
  sleep 2
done
Lisez l'état évalué. S'il n'a pas encore atteint OK, attendez quelques secondes et répétez cette commande.
aws cloudwatch describe-alarms \
  --alarm-names labex-o03-orders-errors \
  --query 'MetricAlarms[0].[StateValue,StateReason,StateReasonData]'
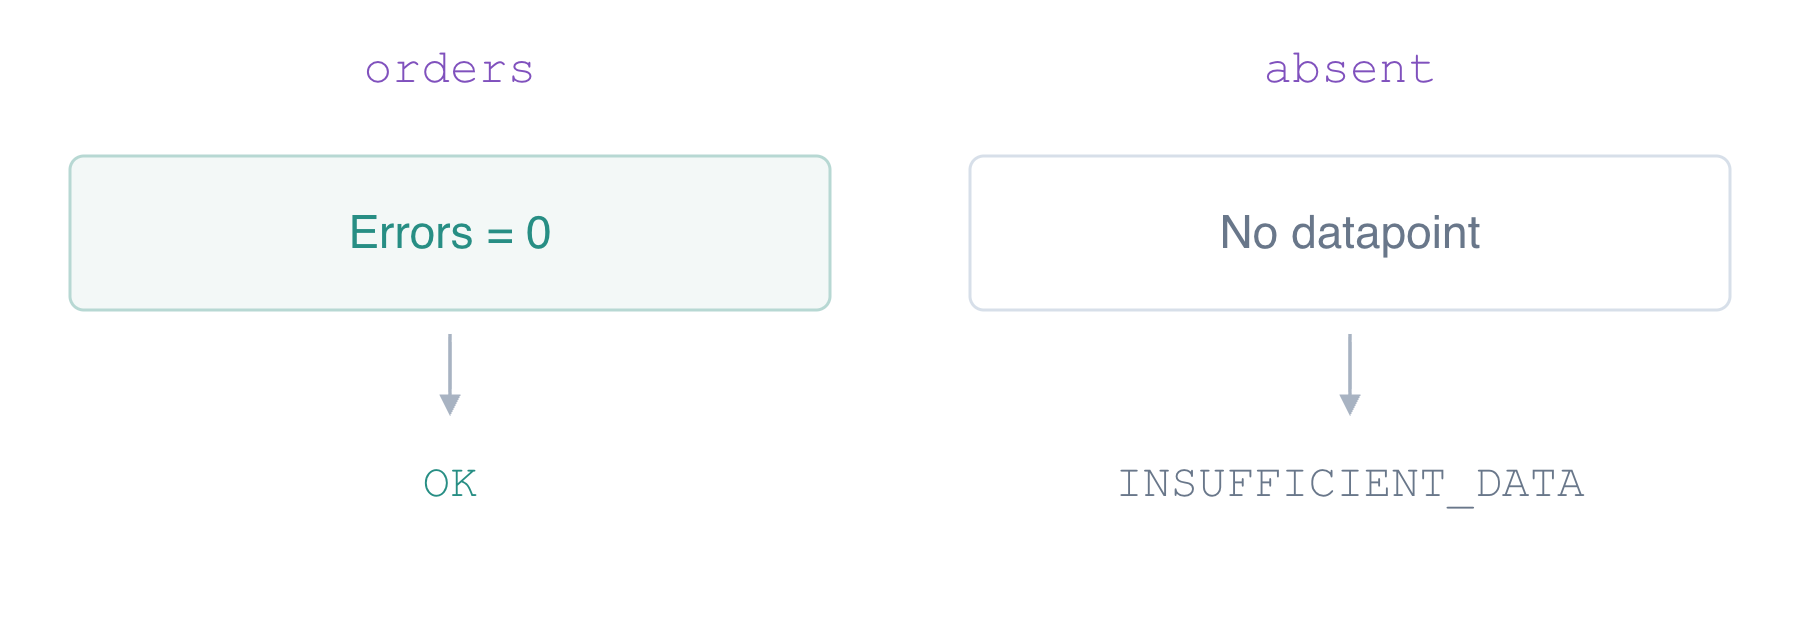
Attendez-vous à obtenir OK avec recentDatapoints: [0]. Une liste vide signifie une télémétrie manquante : confirmez donc le zéro mesuré avant de continuer.
Créez une alarme distincte pour Application=absent, une série que l'application ne publie jamais. Traitez les données manquantes comme manquantes plutôt que comme saines.
aws cloudwatch put-metric-alarm \
  --alarm-name labex-o03-missing \
  --namespace LabEx/O03 \
  --metric-name Errors \
  --dimensions Name=Application,Value=absent \
  --statistic Sum \
  --unit Count \
  --period 10 \
  --evaluation-periods 1 \
  --threshold 1 \
  --comparison-operator GreaterThanOrEqualToThreshold \
  --treat-missing-data missing
La nouvelle alarme doit rester INSUFFICIENT_DATA, car sa série sélectionnée n'a aucune mesure.
aws cloudwatch describe-alarms --query 'MetricAlarms[].[AlarmName,StateValue,StateReason]'
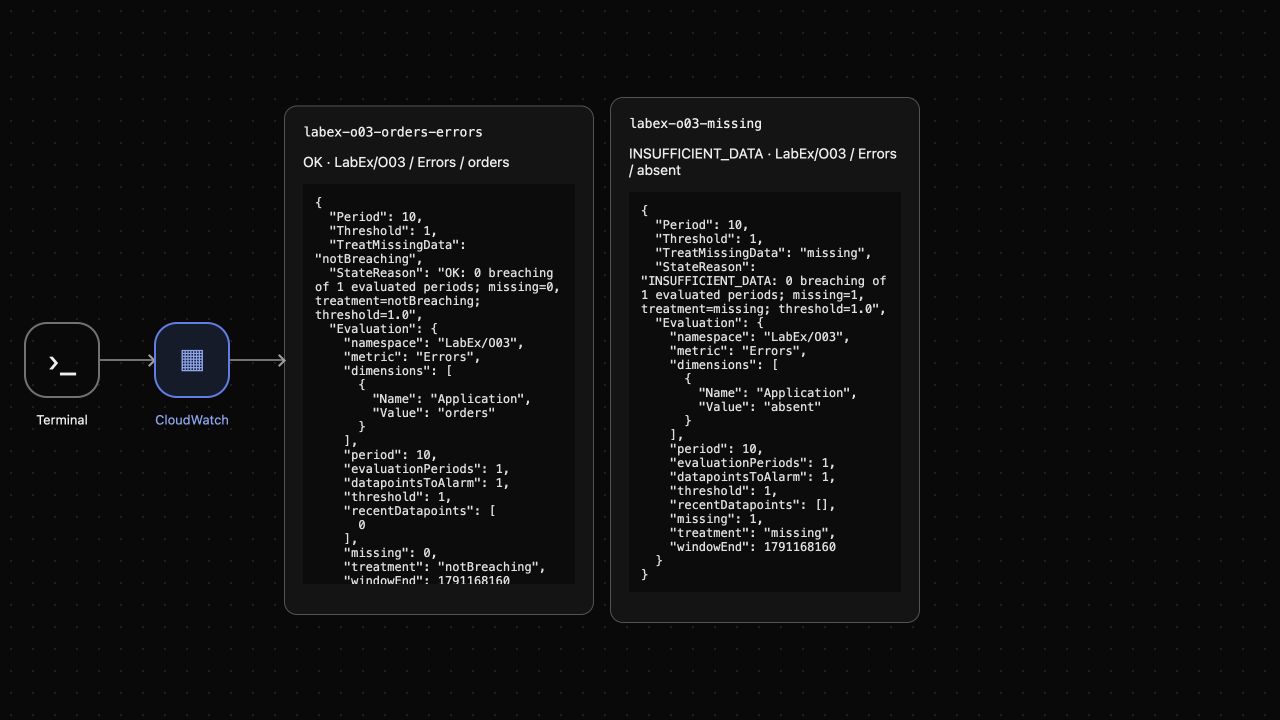
Attendez-vous à obtenir orders OK grâce au zéro mesuré et absent INSUFFICIENT_DATA. Utilisez la raison évaluée pour distinguer un zéro mesuré d'une télémétrie manquante.
AWS View affiche l'état réel du service et les points évalués. Comparez les raisons plutôt que de considérer chaque OK comme une preuve de bonne santé de l'application.
Supprimer les alarmes de l'exercice et arrêter la publication
Dans cette étape, vous allez supprimer uniquement les alarmes de ce laboratoire et conserver les données sans rapport. Désactivez l'instrumentation avant le nettoyage pour que l'application cesse de publier de nouveaux points.
cat > app.json <<'JSON'
{"logging": {"enabled": false, "group": "/labex/o03-orders", "stream": "requests"}, "metrics": {"enabled": false, "namespace": "LabEx/O03"}}
JSON
aws cloudwatch delete-alarms --alarm-names labex-o03-orders-errors labex-o03-missing
aws cloudwatch describe-alarms --query 'MetricAlarms[].AlarmName'
aws logs get-log-events \
  --log-group-name /labex/o03-reference \
  --log-stream-name platform \
  --query 'events[].message'
Attendez-vous à obtenir un inventaire d'alarmes vide et INFO platform reference keep unchanged. Les points de métrique existants sont conservés ; CloudWatch n'a pas d'API explicite pour supprimer une métrique individuelle. Le nettoyage par l'auteur ou la plateforme retire ensuite cet environnement temporaire.
Résumé
Vous avez configuré une alarme d'erreurs, observé son déclenchement automatique et son retour à la normale à partir de vraies requêtes, distingué un zéro mesuré de données manquantes et supprimé les alarmes de l'exercice tout en conservant les journaux de référence.
Pour approfondir ce sujet, consultez la documentation AWS : Alarmes de métriques et actions; Évaluation des alarmes avec des données manquantes.