Introduction
Northline Library permet aux lecteurs de découvrir des livres, consulter leur disponibilité et prévisualiser une réservation. Sa page d’accueil peut sembler saine alors que la recherche ne fonctionne plus. Vous devez surveiller ce résultat client et prévenir l’équipe uniquement si la panne persiste.
Les bases du terminal suffisent. La bibliothèque, Prometheus (échantillons et règles), Blackbox Exporter (sondes HTTP réelles), Alertmanager (livraison des notifications) et une boîte locale sont prêts. Vous modifiez deux courts fichiers YAML : aucune programmation, installation, messagerie ou communication externe n’est nécessaire. Tout fonctionne dans une seule instance pédagogique avec des livres fictifs et des réservations en lecture seule.
Utilisez Library pour les actions du lecteur, Workstation pour les commandes et Monitoring pour les observations et les webhooks réellement reçus. Le site et les libellés restent en anglais. Chaque unité démarre indépendamment.
Surveiller la recherche du lecteur
Dans cette étape, vous sélectionnerez une sonde orientée client. Commencez dans Library, utilisez le service normal, puis choisissez une vérification du besoin réel du lecteur.
Suivre le parcours du lecteur
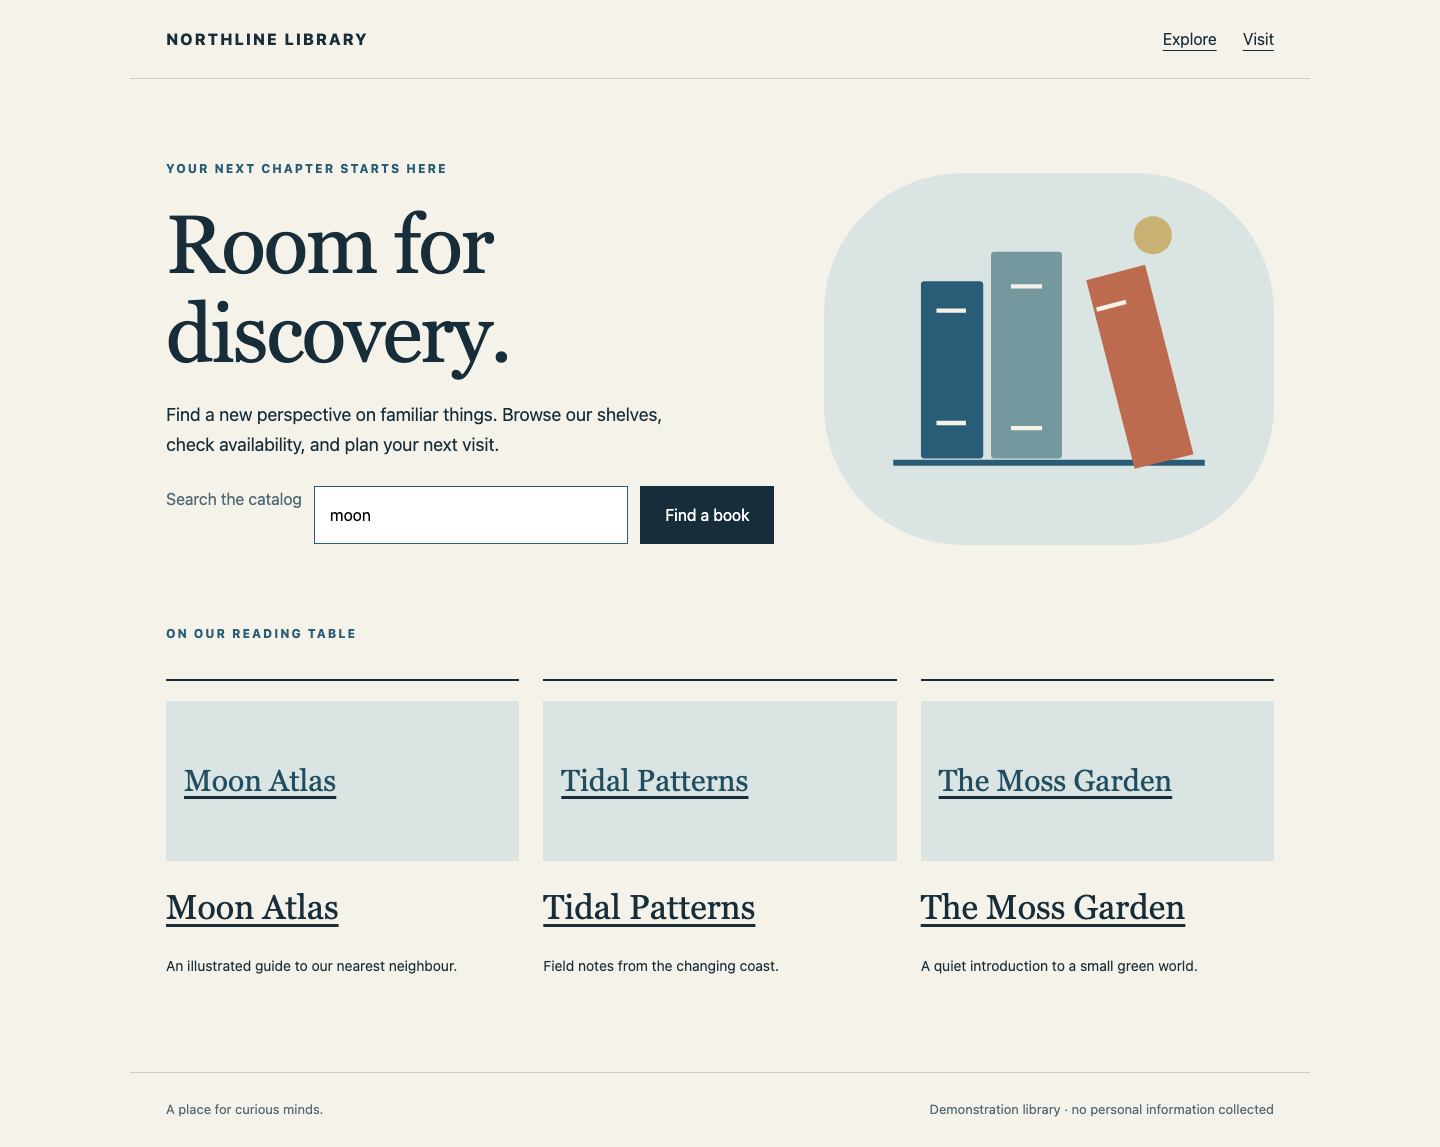
Laissez moon dans Search the catalog et sélectionnez Find a book. Les résultats doivent afficher Moon Atlas, Available et son emplacement. Ouvrez Moon Atlas, puis Check reservation : l’aperçu en lecture seule indique Ready to collect: Moon Atlas. Rien n’est réservé. Sélectionnez Back to book, puis NORTHLINE LIBRARY. Ouvrez Visit, lisez les horaires et revenez par le lien de la marque.
Comprendre la sonde
Passez à Workstation, déjà placé dans /home/labex/project/library-watch. Un chemin désigne un fichier ou un répertoire ; ce chemin absolu part de la racine du système. pwd affiche votre emplacement, ls liste les noms et cat affiche un fichier :
pwd
ls
cat prometheus.yml
Vous disposez de prometheus.yml, alerts.yml et watch.sh. Une configuration décrit le comportement souhaité d’un programme. YAML utilise des espaces pour l’indentation, des paires key: value et un tiret pour les éléments de liste. Conservez les espaces montrés. Aucun éditeur n’est requis : vous remplacerez cette petite configuration par un bloc complet.
HTTP est le protocole requête/réponse du navigateur. Une URL comprend une adresse, un port identifiant un service et un chemin. Dans Workstation, 127.0.0.1 désigne cette instance. Le port 8081 sert la bibliothèque ; /search?q=moon recherche avec le paramètre q égal à moon. Gardez les guillemets autour de l’URL dans le terminal pour que le shell la traite comme un seul argument.
Le job library préparé ne sonde actuellement que l’accueil. Un job est un ensemble nommé de cibles d’échantillonnage. L’exportateur du port 9115 effectue une requête réelle et renvoie probe_success : 1 pour réussite, 0 pour échec. Son module search exige les contenus Moon Atlas et Available, en plus du statut HTTP 200. Prometheus prélève ce résultat toutes les 2 secondes. La métrique distincte up indique seulement si Prometheus a pu collecter auprès de l’exportateur ; elle ne prouve pas la réussite du lecteur.
Choisir le parcours client
cat > prometheus.yml remplace le fichier. <<'YAML' ouvre un here-document littéral : collez le bloc entier, y compris le dernier YAML seul sur sa ligne. global définit les intervalles, rule_files désigne les règles et alerting relie le service de livraison préparé. Conservez ces réglages et changez le module et la cible pour la recherche. L’étiquette journey: search identifie sa portée métier.
cat > prometheus.yml <<'YAML'
global:
  scrape_interval: 2s
  evaluation_interval: 2s
rule_files:
- /home/labex/project/library-watch/alerts.yml
alerting:
  alertmanagers:
  - static_configs:
    - targets: ['127.0.0.1:9093']
scrape_configs:
- job_name: library
  metrics_path: /probe
  params:
    module: [search]
    target: ['http://127.0.0.1:8081/search?q=moon']
  static_configs:
  - targets: ['127.0.0.1:9115']
    labels:
      journey: search
YAML
bash watch.sh reload exécute l’utilitaire fourni : il vérifie la syntaxe avant de demander le rechargement de Prometheus. Il ne change pas la bibliothèque et n’invente aucune observation.
bash watch.sh reload
Attendez Configuration accepted. Après environ 4 secondes, passez à Monitoring. Business probes doit afficher search: healthy. En cas d’erreur YAML, revenez à Workstation, remplacez le fichier par le bloc complet et rechargez. Si les échantillons sont indisponibles, attendez et réessayez : unavailable ne signifie jamais healthy. Ne pointez pas la cible vers Monitoring lui-même.
Comparer accessibilité et réussite
Passez à Workstation. fault search seconds 6 fait échouer uniquement la recherche pendant 6 secondes réelles, puis la rétablit automatiquement. Il ne fixe aucun état d’alerte. curl envoie des requêtes HTTP ; -sS masque la progression mais affiche les erreurs de connexion. Exécutez :
bash watch.sh fault search seconds 6
curl -sS 'http://127.0.0.1:8081/search?q=moon'
Le corps indique Search is taking a break. Le serveur renvoie délibérément HTTP 200 : un contrôle du statut seul manquerait la panne métier. Passez immédiatement à Monitoring : en un intervalle d’échantillonnage, la recherche doit devenir failed, puis retrouver healthy après rétablissement. Si vous manquez cette courte fenêtre, recommencez les mêmes 6 secondes. Aucune alerte n’est encore configurée. Attendez l’état sain avant de vérifier l’étape.
Alerter uniquement sur une panne persistante
Dans cette étape, vous configurerez une alerte client qui attend assez longtemps pour ignorer la panne brève observée. Commencez dans Workstation.
Lire la condition
Prometheus évalue les règles toutes les 2 secondes. probe_success{job="library",journey="search"} == 0 sélectionne les échantillons de recherche en échec du job library. Les accolades contiennent les filtres d’étiquettes ; == 0 sélectionne l’échec plutôt que la réussite. Choisir seulement up surveillerait la collecte, pas les lecteurs. Sans étiquettes, des services sans rapport pourraient être inclus.
for: 20s exige que la condition reste active pendant 20 secondes. pending signifie qu’elle existe, mais attend encore ; firing, qu’elle a duré assez longtemps ; inactive, qu’elle est absente. Ces 20 secondes sont courtes pour l’exercice et ne sont pas une recommandation universelle de production. Les données manquantes apparaissent comme unavailable dans Monitoring : elles ne prouvent ni la santé du service ni un échantillon d’échec métier.
alert nomme la règle. severity est une étiquette de routage et annotations.summary décrit la conséquence client. Écrivez la règle complète :
cat > alerts.yml <<'YAML'
groups:
- name: readers
  rules:
  - alert: CustomerJourneyFailed
    expr: probe_success{job="library",journey="search"} == 0
    for: 20s
    labels:
      severity: page
    annotations:
      summary: Readers cannot complete search
YAML
bash watch.sh reload
Attendez Configuration accepted. Si la validation échoue, corrigez espaces ou ponctuation et rechargez. La dernière configuration valide reste active tant que la nouvelle n’est pas acceptée.
Passez à Monitoring. Quand la recherche est saine, la règle doit indiquer CustomerJourneyFailed: inactive (20 seconds). La boîte locale doit encore être vide.
Montrer qu’une panne brève reste silencieuse
Passez à Workstation et répétez la même panne courte :
bash watch.sh fault search seconds 6
Passez immédiatement à Monitoring. La recherche échoue et la règle peut indiquer pending brièvement. Après rétablissement automatique, la sonde et la règle reviennent à healthy/inactive. La boîte reste vide. Accordez environ 12 secondes à ce cycle. Si vous avez déjà déclenché une panne longue, les anciens avis restent présents : comparez les nouveaux événements sans effacer les preuves.
Une règle firing et une notification livrée sont deux faits distincts. Alertmanager reçoit les alertes firing, les groupe, attend 1 seconde pour un nouveau groupe, puis livre à la boîte webhook locale. Collecte, évaluation et livraison ajoutent chacune un petit délai. Ne supprimez pas for et n’abaissez pas tous les seuils parce que l’avis n’est pas immédiat.
Recevoir la panne puis son rétablissement
Dans cette étape, vous provoquerez une panne persistante et observerez la livraison réelle des avis. Commencez dans Workstation.
Observer une panne persistante
La prochaine panne dure 60 secondes réelles pour laisser observer chaque état. Seule la recherche échoue ; l’accueil continue à fonctionner.
bash watch.sh fault search seconds 60
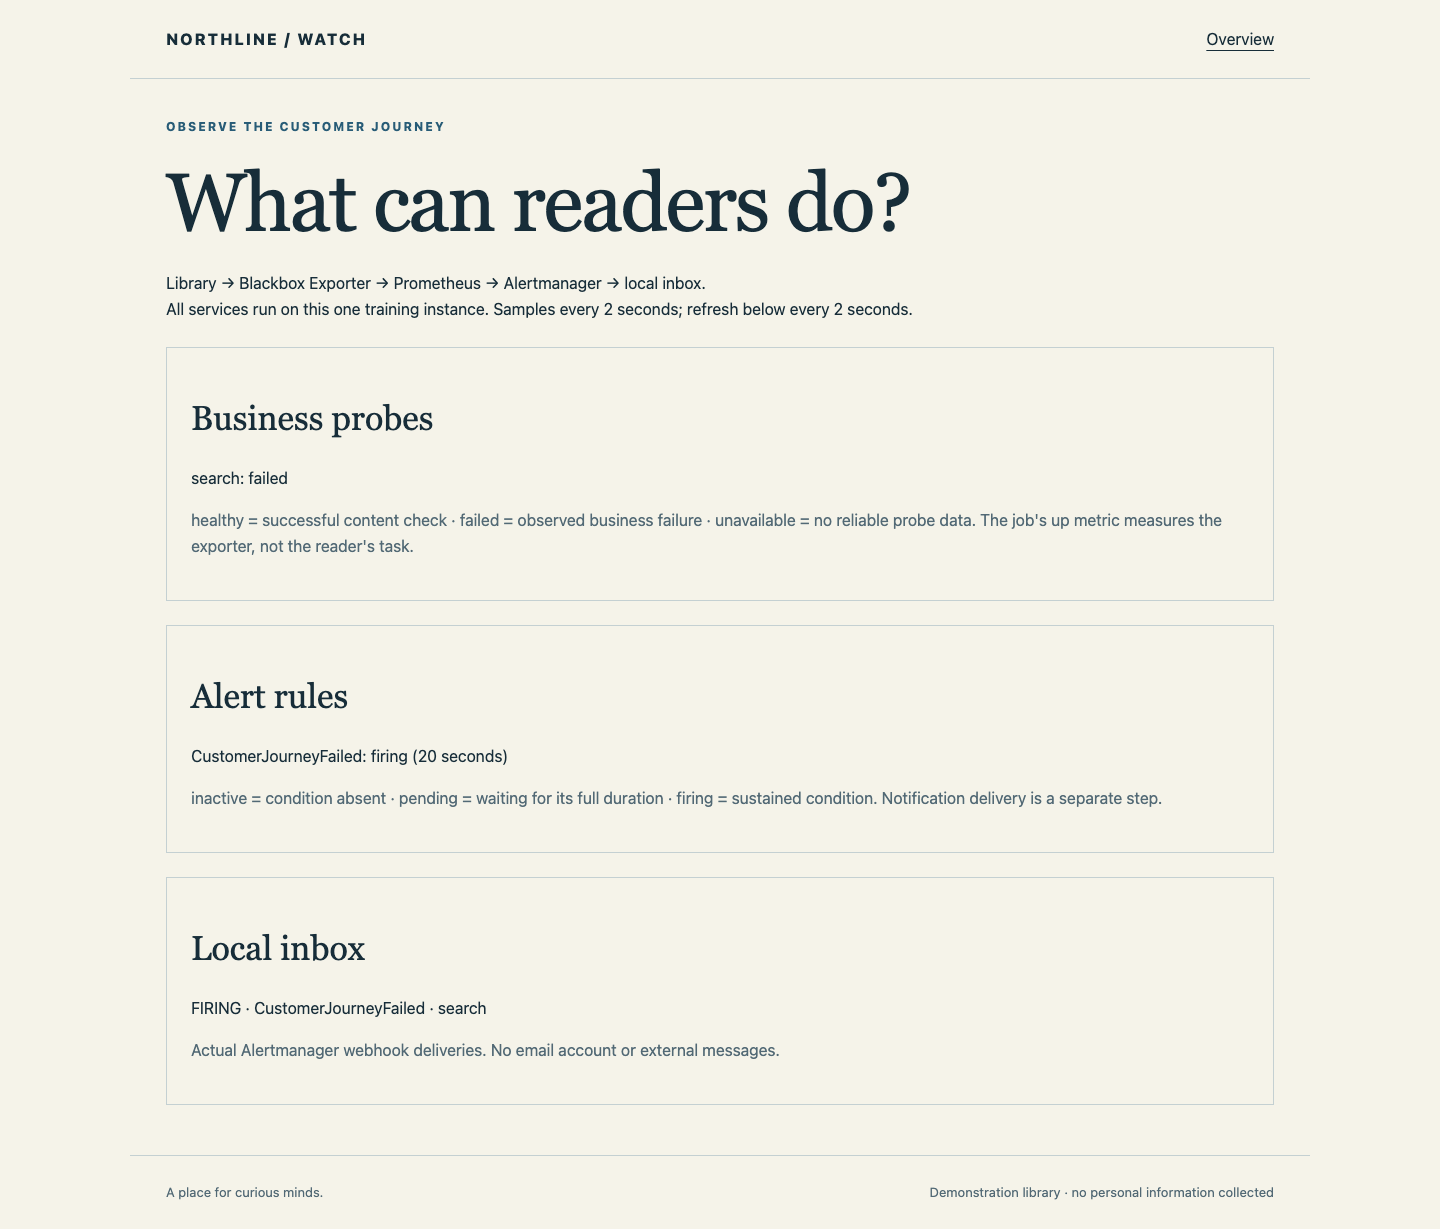
Passez à Library. Revenez à l’accueil par la marque : il paraît normal. Recherchez moon à nouveau. Le message d’échec prouve que le lecteur ne peut pas utiliser le catalogue. Passez à Monitoring. La recherche indique failed et la règle commence par pending. Environ 20 secondes après le premier échantillon en échec, elle devient firing ; la boîte doit alors ajouter FIRING · CustomerJourneyFailed · search. Comptez jusqu’à 35 secondes après le début pour collecte, évaluation et livraison. Ce sont des observations réelles, pas une animation de progression.
Si la boîte est encore vide après 35 secondes, passez à Workstation et utilisez la commande d’état en lecture seule :
bash watch.sh status
Lisez checks et alerts : unavailable indique une collecte absente ; pending, une durée encore insuffisante ; firing sans événement dans la boîte oriente vers la livraison. Relisez la configuration et rechargez si vous la corrigez. Une panne de 60 secondes expirée peut être répétée. Ne fabriquez pas de messages et n’arrêtez pas la surveillance.
Rétablir et confirmer la résolution
Passez à Workstation. Zéro seconde rétablit immédiatement la recherche, même avant l’expiration automatique :
bash watch.sh fault search seconds 0
Passez à Library et recherchez moon depuis l’accueil. Moon Atlas et Available doivent revenir. Ouvrez encore le livre et l’aperçu de réservation ; Visit doit aussi rester accessible.
Passez à Monitoring. En environ 10 secondes, la recherche redevient healthy, l’alerte inactive et la boîte ajoute RESOLVED · CustomerJourneyFailed · search. L’avis firing initial reste visible. resolved signifie que cette panne est terminée, pas que la bibliothèque ne connaîtra plus jamais de panne.
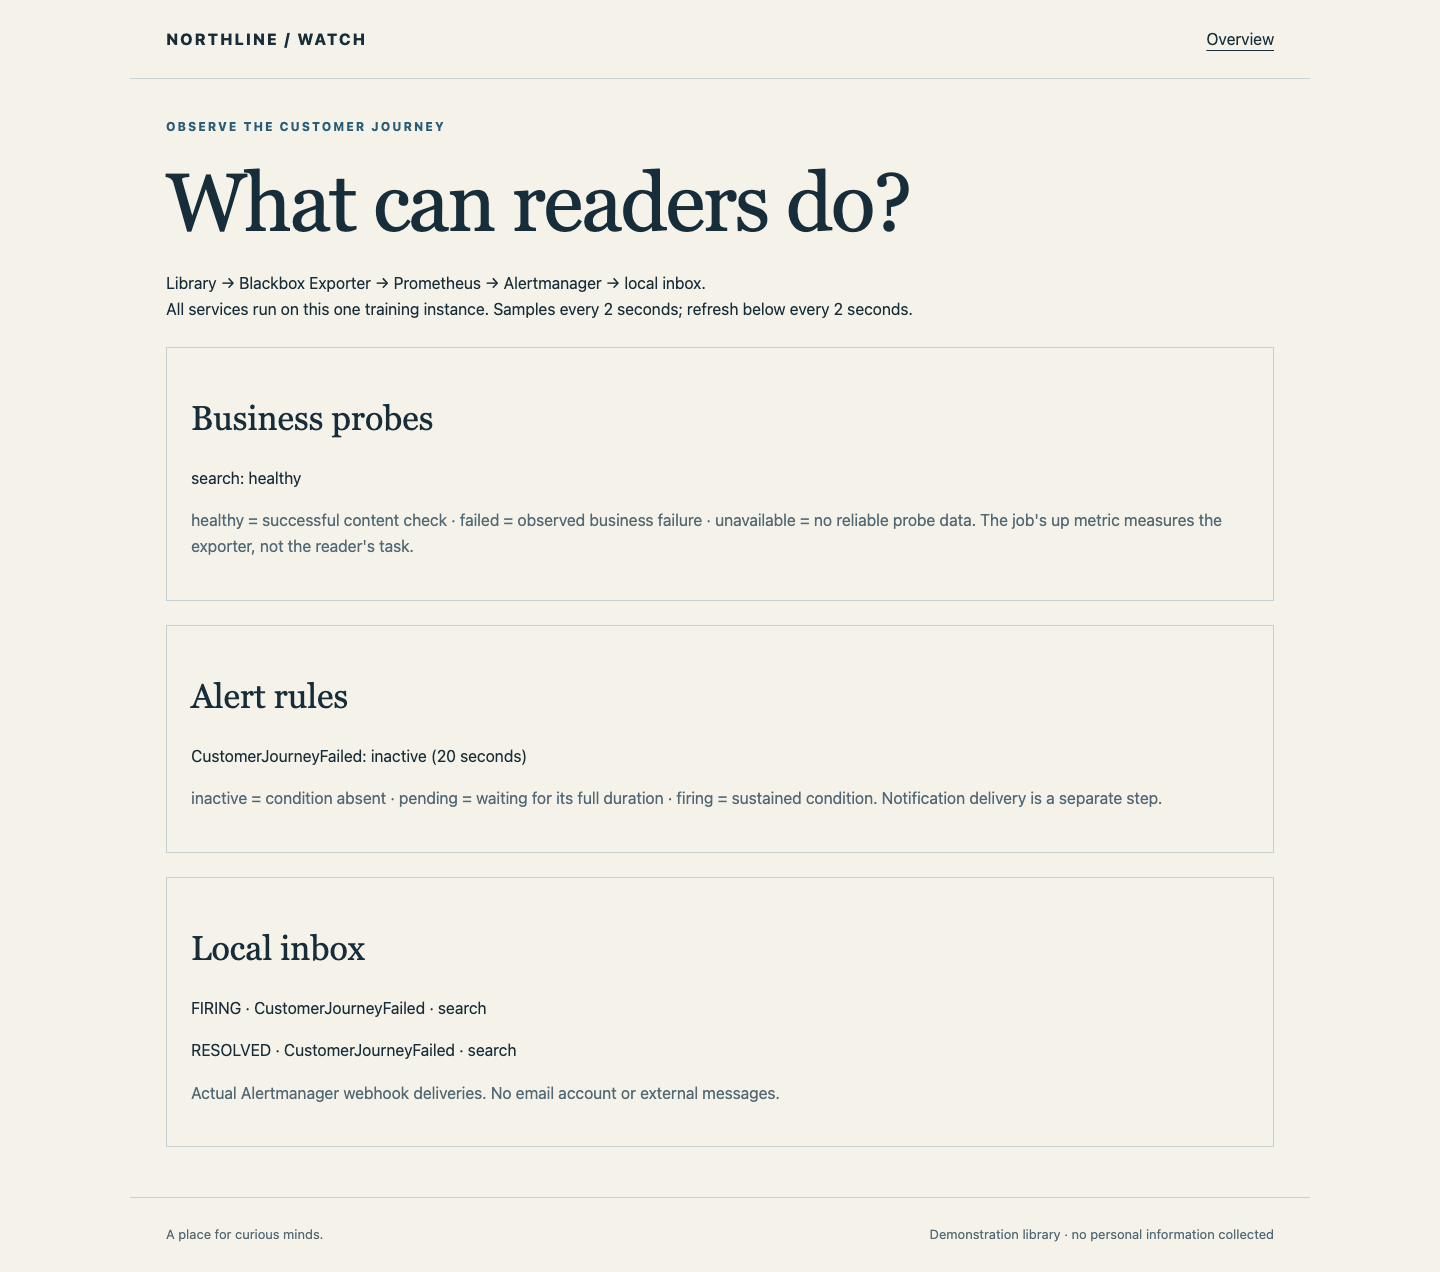
L’étape vérifie la paire firing/resolved réellement livrée et la bibliothèque actuellement utilisable. Elle teste aussi votre règle chargée avec des échantillons isolés : sains, panne brève, panne persistante, rétablissement, absence de données et panne sans rapport. L’évaluation n’injecte aucune panne, ne répare rien et ne change pas votre configuration. Laissez la bibliothèque saine et la règle prête à détecter une future panne.
Résumé
Vous avez choisi une recherche client réelle et une sonde qui vérifie le contenu, limité l’alerte par ses étiquettes, ignoré une panne brève et reçu de vrais webhooks de panne et de rétablissement. Vous distinguez l’exportateur disponible du service utilisable et l’absence de données de la réussite. Le défi indépendant applique ces méthodes aux réservations en excluant un service en panne sans rapport.