Introduction
Un point de terminaison d’IA dépend de bien plus que de votre code JavaScript. Un apprenant peut envoyer une entrée invalide, le modèle sélectionné peut rejeter une requête, un compte peut atteindre un quota ou une limite de débit, la capacité peut être temporairement indisponible ou votre propre code applicatif peut échouer. Ces situations nécessitent des réponses différentes. Les traiter toutes comme une simple « défaillance de l’IA » rend l’application difficile à exploiter et peut encourager des nouvelles tentatives inutiles.
Dans cet atelier, vous allez créer POST /draft-reply. Un modèle Llama hébergé par Cloudflare rédige une courte réponse d’assistance. Votre Worker rejette les entrées invalides avant l’inférence, reconnaît les erreurs documentées du modèle et des limites, réessaie une défaillance temporaire au maximum une fois, valide la réponse du modèle et signale séparément une erreur de l’application. Une nouvelle tentative limitée signifie que le nombre maximal de tentatives supplémentaires est fixé à l’avance ; la boucle ne peut pas continuer jusqu’à épuiser l’allocation gratuite du compte.
Vous vérifierez la plupart des chemins de défaillance avec des fixtures déterministes. Une fixture est un substitut contrôlé qui renvoie un résultat ou une erreur choisi, afin de tester le comportement d’un quota ou d’une panne sans consommer volontairement du quota ni provoquer une panne réelle. Une seule requête locale courte et une seule requête après déploiement utilisent le modèle réel.
Il s’agit du sixième atelier guidé du cours. Si vous y accédez directement, terminez d’abord Connect LabEx to Your Cloudflare Account pour apprendre à utiliser le terminal de la VM, à autoriser Wrangler, à confirmer votre compte d’apprentissage et à configurer son ID de compte.
Le modèle sélectionné @cf/meta/llama-3.3-70b-instruct-fp8-fast est disponible avec l’allocation Workers AI standard. Workers Free inclut actuellement 10 000 Neurons par jour. Cet atelier ne nécessite pas Workers Paid tant que l’allocation gratuite reste disponible. L’exercice visible et la vérification indépendante effectuent chacun une courte requête valide en local puis après le déploiement. L’inférence locale atteint tout de même Cloudflare et consomme l’utilisation du compte ; ne relancez donc pas plusieurs fois une défaillance réelle.
La configuration installe Node.js 22.22.0 et Wrangler 4.132.0 au niveau du projet dans /home/labex/project/resilient-ai-reply. Elle fournit également des fixtures déterministes et des vérifications indépendantes. Elle n’autorise pas Wrangler, ne crée pas le code source du Worker, n’appelle pas de modèle, ne déploie pas le Worker et ne crée pas de ressource cloud.
Autoriser la VM et configurer le Worker résilient
Dans cette étape, vous allez autoriser cette nouvelle VM et configurer un Worker temporaire. Une connexion à Cloudflare dans un navigateur n’autorise pas automatiquement Wrangler dans une nouvelle VM LabEx.
Accédez au projet préparé et vérifiez la version figée de l’interface de ligne de commande :
cd /home/labex/project/resilient-ai-reply
npx wrangler --version
Lancez le processus d’autorisation de l’appareil :
npx wrangler login --device --browser=false --scopes \
  account:read user:read workers_scripts:write workers_kv:write ai:write
Ouvrez dans le navigateur l’URL d’autorisation affichée, confirmez le compte d’apprentissage visé et approuvez les accès indiqués. L’autorisation de compatibilité KV est nécessaire pour cette version de Wrangler lors de la suppression d’un Worker ; cet atelier ne crée ni ne modifie de données KV.
Vérifiez l’autorisation avec une sortie structurée :
npx wrangler whoami --json
La valeur "loggedIn": true doit être présente. Confirmez le nom du compte, puis copiez l’ID réel de ce compte dans la configuration suivante. Générez un nom unique et créez wrangler.jsonc :
RUN="labex-c07-a06-$(openssl rand -hex 6)"
printf 'Worker name: %s\n' "$RUN"
cat > wrangler.jsonc <<EOF
{
  "name": "$RUN",
  "main": "src/index.js",
  "compatibility_date": "2026-09-16",
  "account_id": "PASTE_YOUR_ACCOUNT_ID_HERE",
  "workers_dev": true,
  "preview_urls": false,
  "observability": {
    "enabled": true,
    "head_sampling_rate": 1
  },
  "ai": {
    "binding": "AI",
    "remote": true
  }
}
EOF
Le binding AI fournit au code du Worker une interface env.AI associée au compte. remote: true signifie également que les requêtes locales de Wrangler utilisent le véritable service Workers AI et sont comptabilisées dans l’allocation partagée.
Séparer les catégories de défaillance
Dans cette étape, vous allez transformer plusieurs causes de défaillance très différentes en un petit contrat public avant d’écrire le code de récupération.
Un statut HTTP indique au client le type de résultat obtenu. Il ne doit pas exposer les messages bruts du fournisseur, les informations du compte ni les traces d’exécution. Cet atelier utilise cinq limites :
400 invalid_request: l’entrée de l’apprenant est absente ou dépasse la taille autorisée ; l’inférence ne démarre donc pas.502 model_incompatibleouincompatible_model_response: le modèle sélectionné ou la structure renvoyée ne respecte pas le contrat de l’application. Répéter la même requête ne rétablira pas la compatibilité.503 model_quota_exhaustedoumodel_rate_limited: la limite du compte ou du modèle indique qu’il faut s’arrêter. Une nouvelle tentative automatique immédiate consommerait une requête supplémentaire et augmenterait la charge.503 model_temporarily_unavailable: un délai d’attente ou une capacité temporairement indisponible a échoué deux fois. La réponse inclutRetry-Afterafin qu’un client puisse attendre avant une requête ultérieure.500 application_failure: l’inférence du modèle a renvoyé des données utilisables, mais l’étape de formatage de l’application a échoué.
Cloudflare documente le code interne 3036 pour une allocation gratuite quotidienne épuisée, 3040 pour une capacité temporairement indisponible, 3007 pour un délai d’attente et 5035 pour un modèle qui nécessite Workers Paid. L’application associe les signaux connus à des erreurs publiques stables et consigne uniquement la catégorie, le nombre de tentatives et l’ID de trace.
Générez les déclarations TypeScript et inspectez le binding AI :
npx wrangler types
grep -nE 'interface Env|AI: Ai' worker-configuration.d.ts
La déclaration générée confirme que env.AI est disponible pour le Worker. Elle ne garantit pas qu’un appel de modèle réussira ; l’autorisation, le quota, la compatibilité du modèle et l’état du service sont des conditions d’exécution.
Créer une récupération limitée
Dans cette étape, vous allez implémenter la classification, la limite à une seule nouvelle tentative et la séparation entre la réponse du modèle et les limites de l’application.
Créez le point d’entrée du Worker :
cat > src/index.js <<'WORKER'
const MODEL = "@cf/meta/llama-3.3-70b-instruct-fp8-fast";
const MAX_MESSAGE = 500;
const RETRY_DELAY_MS = 25;
const RETRY_AFTER_SECONDS = 30;

function json(data, status = 200, headers = {}) {
  return Response.json(data, { status, headers });
}

async function readMessage(request) {
  if (request.method !== "POST") return { error: json({ error: "method_not_allowed" }, 405) };
  let body;
  try { body = await request.json(); }
  catch { return { error: json({ error: "invalid_request" }, 400) }; }
  if (typeof body?.message !== "string") return { error: json({ error: "invalid_request" }, 400) };
  const message = body.message.trim();
  if (!message || message.length > MAX_MESSAGE) return { error: json({ error: "invalid_request" }, 400) };
  return { message };
}

function numeric(value) {
  const number = Number(value);
  return Number.isFinite(number) ? number : undefined;
}

export function classifyModelError(error) {
  const code = numeric(error?.code ?? error?.cause?.code);
  const status = numeric(error?.status ?? error?.cause?.status);
  if ([5004, 5005, 5007, 5016, 5018, 5035, 3042].includes(code) ||
      [400, 403, 404, 405, 413].includes(status)) {
    return { kind: "model_incompatible", status: 502, retryable: false };
  }
  if (code === 3036) return { kind: "model_quota_exhausted", status: 503, retryable: false };
  if (code === 3040 || code === 3007 || status >= 500) {
    return { kind: "model_temporarily_unavailable", status: 503, retryable: true };
  }
  if (status === 429) return { kind: "model_rate_limited", status: 503, retryable: false };
  return { kind: "model_unavailable", status: 503, retryable: false };
}

export async function runWithBoundedRecovery(run, input, traceId, sleep) {
  for (let attempt = 1; attempt <= 2; attempt += 1) {
    try {
      return { result: await run(input), attempts: attempt };
    } catch (error) {
      const failure = classifyModelError(error);
      if (failure.retryable && attempt === 1) {
        console.log(JSON.stringify({
          event: "model_retry_scheduled",
          kind: failure.kind,
          attempt,
          traceId
        }));
        await sleep(RETRY_DELAY_MS);
        continue;
      }
      return { failure, attempts: attempt };
    }
  }
}

function formatReply(reply) {
  return reply.trim();
}

export async function handleDraftReply(request, env, options = {}) {
  const parsed = await readMessage(request);
  if (parsed.error) return parsed.error;

  const traceId = crypto.randomUUID();
  const run = options.run ?? (input => env.AI.run(MODEL, input));
  const sleep = options.sleep ?? (ms => new Promise(resolve => setTimeout(resolve, ms)));
  const outcome = await runWithBoundedRecovery(run, {
    messages: [
      { role: "system", content: "Draft one concise support reply under 80 words. Do not invent account actions." },
      { role: "user", content: parsed.message }
    ],
    max_tokens: 120
  }, traceId, sleep);

  if (outcome.failure) {
    console.log(JSON.stringify({
      event: "model_request_failed",
      kind: outcome.failure.kind,
      attempts: outcome.attempts,
      retryable: outcome.failure.retryable,
      traceId
    }));
    const headers = outcome.failure.retryable ? { "retry-after": String(RETRY_AFTER_SECONDS) } : {};
    return json({ error: outcome.failure.kind, retryable: outcome.failure.retryable },
      outcome.failure.status, headers);
  }

  if (typeof outcome.result?.response !== "string" ||
      !outcome.result.response.trim() ||
      outcome.result.response.length > 1200) {
    console.log(JSON.stringify({
      event: "model_response_rejected",
      attempts: outcome.attempts,
      traceId
    }));
    return json({ error: "incompatible_model_response", retryable: false }, 502);
  }

  let reply;
  try {
    reply = (options.format ?? formatReply)(outcome.result.response);
  } catch {
    console.log(JSON.stringify({ event: "application_failure", traceId }));
    return json({ error: "application_failure", retryable: false }, 500);
  }

  console.log(JSON.stringify({
    event: "reply_generated",
    model: MODEL,
    attempts: outcome.attempts,
    traceId
  }));
  return json({ model: MODEL, reply, attempts: outcome.attempts, traceId });
}

export default {
  async fetch(request, env) {
    const url = new URL(request.url);
    if (url.pathname === "/health") return json({ ok: true });
    if (url.pathname === "/draft-reply") return handleDraftReply(request, env);
    return json({ error: "not_found" }, 404);
  }
};
WORKER
La boucle de nouvelles tentatives autorise deux tentatives au total : l’appel initial et un seul appel supplémentaire, uniquement pour une catégorie temporaire connue. Les défaillances liées au quota, à la limite de débit et à la compatibilité arrêtent immédiatement le traitement. Remarquez également que l’appel au modèle, la validation de la réponse et le formatage de l’application sont séparés. Les opérateurs peuvent ainsi distinguer un problème du fournisseur d’une erreur de l’application.
La réponse publique ne contient jamais l’exception brute. Les journaux excluent le message d’assistance et la réponse générée ; ils conservent uniquement les métadonnées du cycle de vie nécessaires pour analyser la catégorie de défaillance.
Vérifier la matrice des défaillances sans consommer de quota
Dans cette étape, vous allez tester chaque catégorie de défaillance avec des fixtures contrôlées avant d’effectuer une requête réelle vers le modèle.
Exécutez la suite déterministe :
node --test test/worker.test.mjs
Les neuf cas utilisent des fixtures plutôt qu’une inférence réelle. Vérifiez que les entrées invalides n’effectuent aucun appel au modèle, que les erreurs de quota et de limite de débit n’effectuent qu’un seul appel, qu’une capacité temporairement indisponible entraîne au plus deux appels, qu’une sortie mal formée devient une erreur de compatibilité et qu’un défaut de formatage devient une erreur de l’application.
Regroupez maintenant le Worker exact :
npx wrangler deploy --dry-run --outdir /tmp/a06-dry-run
L’exécution à blanc vérifie que Wrangler peut regrouper le module et doit répertorier le binding AI. Elle ne déploie pas le Worker et n’appelle pas le modèle.
Tester une inférence valide et examiner les éléments de preuve
Dans cette étape, vous allez effectuer une requête valide en local et une autre après le déploiement, puis relier leurs résultats aux éléments de preuve en lecture seule du Dashboard Cloudflare.
Démarrez Wrangler en local en arrière-plan et attendez la route de santé qui n’utilise pas l’IA. La boucle limitée empêche l’attente infinie :
npx wrangler dev --port 8787 > .labex/dev.log 2>&1 &
echo $! > .labex/dev.pid
for attempt in $(seq 1 30); do
  curl --silent --fail http://127.0.0.1:8787/health >/dev/null && break
  sleep 1
done
curl --silent --show-error http://127.0.0.1:8787/draft-reply \
  -H 'content-type: application/json' \
  --data '{"message":"My keyboard stopped working after the latest update."}'
La réponse doit contenir une valeur reply non vide, le modèle exact, un ID de trace et une valeur attempts égale à 1 dans le cas habituel d’une requête valide. Une valeur de 2 signifie qu’une défaillance temporaire a été récupérée dans la limite prévue.
Exécutez la vérification locale indépendante, arrêtez le processus enregistré, puis déployez :
./.labex/verify.py local
kill "$(cat .labex/dev.pid)"
wait "$(cat .labex/dev.pid)" 2>/dev/null || true
npx wrangler deploy
Copiez l’URL exacte workers.dev affichée par le déploiement et testez le point de terminaison public :
WORKER_URL="https://YOUR_WORKER_URL"
curl --silent --show-error "$WORKER_URL/draft-reply" \
  -H 'content-type: application/json' \
  --data '{"message":"My keyboard stopped working after the latest update."}'
curl --silent --show-error --include "$WORKER_URL/draft-reply" \
  -H 'content-type: application/json' \
  --data '{"message":""}'
./.labex/verify.py deployed
Le message vide doit renvoyer HTTP 400 avant l’inférence. Cela prouve que la protection des entrées fonctionne sans consommer une autre requête du modèle.
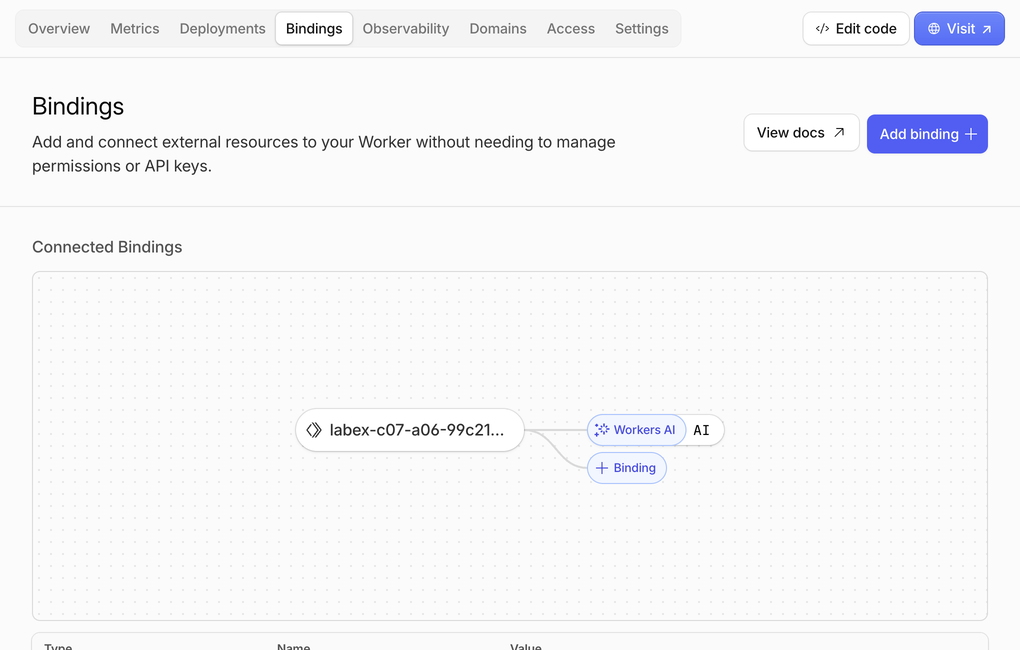
Ouvrez Workers & Pages, sélectionnez le nom exact du Worker et examinez Bindings. Un binding est une connexion nommée qui permet au code du Worker d’accéder à un autre service Cloudflare sans stocker de clé API. Confirmez la présence d’une connexion Workers AI nommée AI ; le nom du Worker affiché dans l’exemple ci-dessous appartient à l’exécution de test, tandis que le vôtre contiendra un suffixe aléatoire différent.
Ouvrez ensuite Observability. L’exécution d’exemple a produit six événements réussis et aucune erreur. Les nombres peuvent différer, car une requête peut créer à la fois un enregistrement d’invocation et un journal d’application, et les journaux enregistrés peuvent arriver après la réponse.
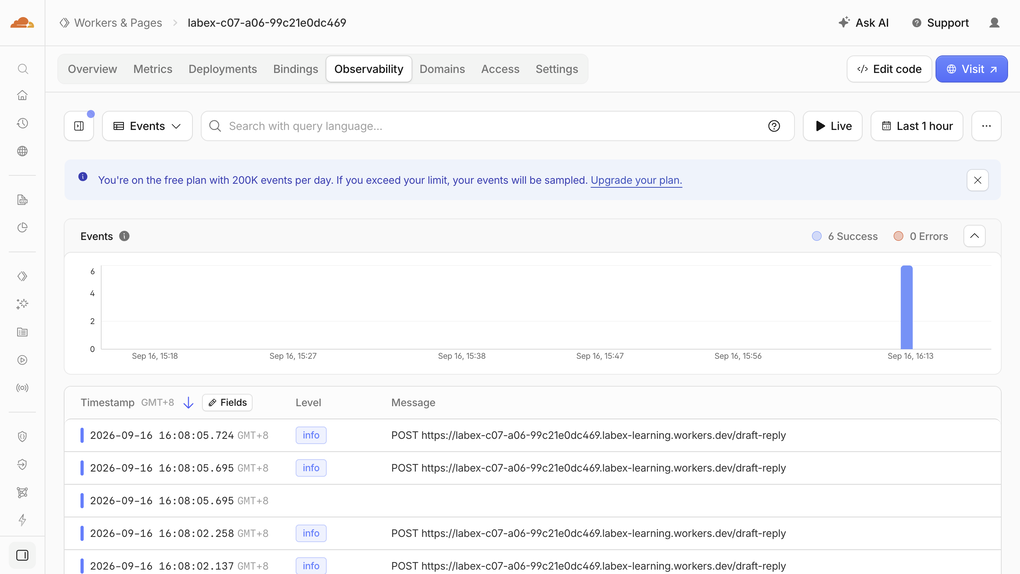
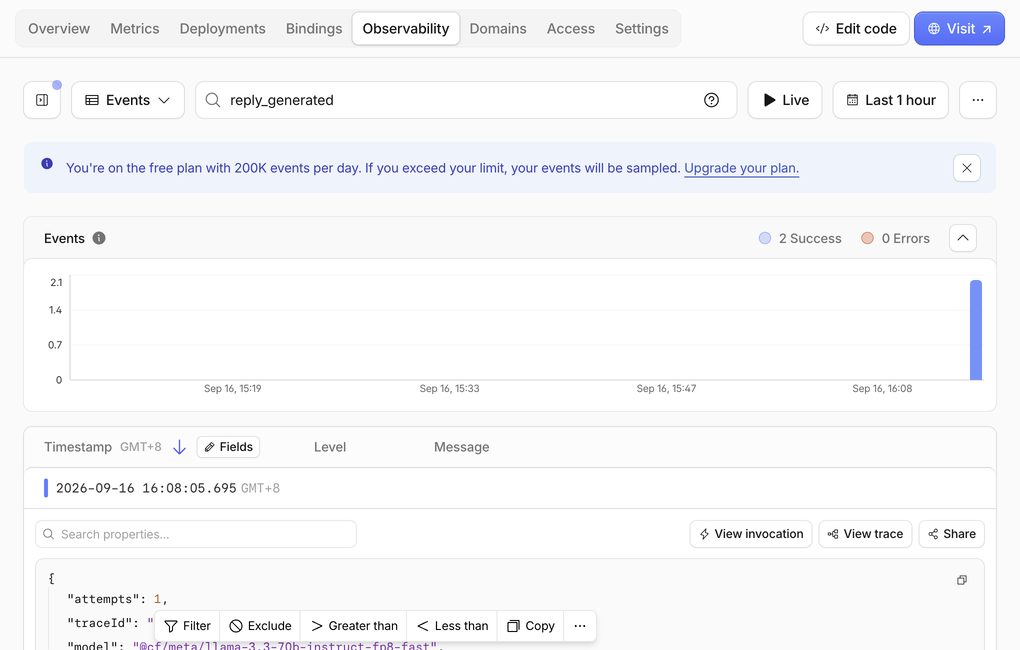
La notification bleue du forfait Free affichée ici décrit l’allocation d’événements Workers Logs, et non l’utilisation de l’inférence AI. Recherchez reply_generated et développez un résultat. L’exemple ciblé affiche deux correspondances réussies et les champs volontairement limités de l’application : une tentative, un ID de trace et le modèle exact. L’événement complet contient également event: "reply_generated", mais l’application ne journalise ni le message d’assistance, ni la réponse générée, ni l’erreur brute du fournisseur.
Enfin, ouvrez AI > Workers AI et laissez l’onglet Neurons sélectionné. Un Neuron est l’unité utilisée par Cloudflare pour mesurer les calculs d’IA. Le compte partagé de l’exemple affichait 428.59/10k Neurons utilisés ce jour-là, dont 427.82 attribués au modèle Llama et 0.77 à un atelier précédent sur les embeddings. Ces totaux incluent d’autres exercices du cours et peuvent être mis à jour avec un délai ; ils ne représentent pas le coût d’une seule requête.
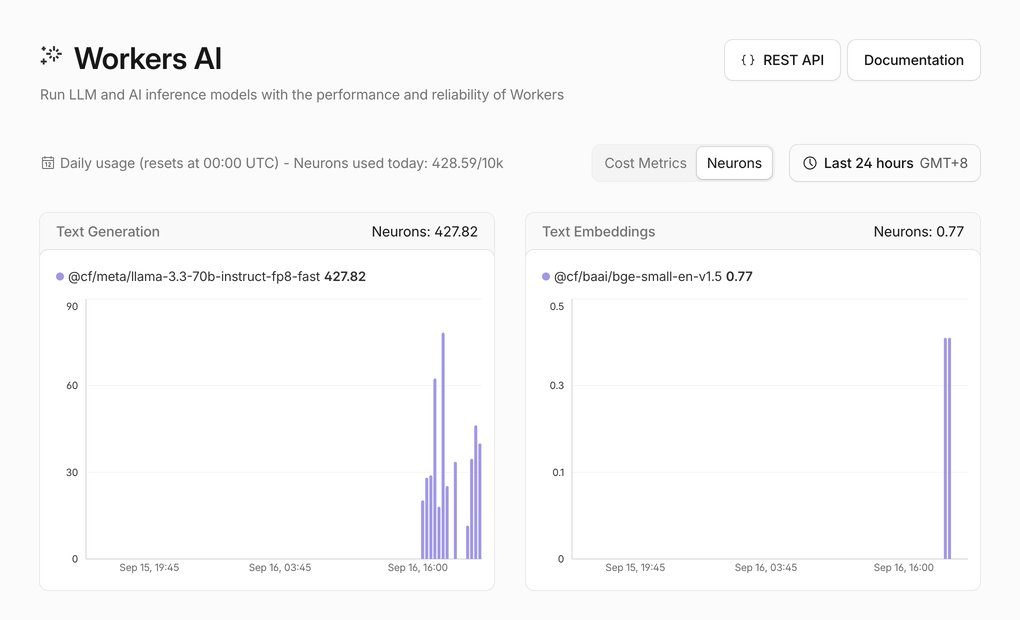
Vérifiez simplement que l’utilisation reste dans l’allocation quotidienne disponible. Les vues du Dashboard permettent de relier la configuration, le trafic et l’utilisation au résultat de la ligne de commande, mais la réponse d’exécution et les vérifications indépendantes restent les références faisant autorité. N’effectuez pas de nouvelles inférences uniquement pour faire évoluer un graphique.
Supprimer le Worker et se déconnecter
Dans cette étape, vous allez supprimer le point de terminaison temporaire tant que l’autorisation est disponible, puis supprimer cette autorisation de la VM.
Supprimez uniquement le Worker temporaire dont le nom est enregistré dans wrangler.jsonc :
npx wrangler delete --force
Confirmez son absence alors que Wrangler est toujours autorisé :
./.labex/verify.py deleted
Supprimez maintenant l’autorisation enregistrée de cette VM :
npx wrangler logout
npx wrangler whoami --json
La valeur "loggedIn": false doit être présente, puis exécutez la vérification finale :
./.labex/verify.py logout
La suppression d’un Worker supprime la ressource cloud ; la déconnexion supprime l’autorisation de cette VM. Il s’agit de deux opérations de nettoyage distinctes.
Résumé
Vous avez créé un point de terminaison Workers AI qui :
- rejette les entrées invalides avant l’inférence ;
- distingue les défaillances de compatibilité, de quota, de limite de débit, temporaires et applicatives ;
- réessaie au maximum une fois une défaillance temporaire connue ;
- valide la sortie du modèle avant le formatage de l’application ;
- renvoie des erreurs publiques stables sans divulguer les détails bruts du fournisseur ;
- enregistre des métadonnées du cycle de vie limitées pour protéger la confidentialité ;
- vérifie le comportement en cas de défaillance avec des fixtures déterministes au lieu de gaspiller du quota ;
- confirme une inférence valide en local et après déploiement avec Workers Free ;
- supprime le Worker temporaire et se déconnecte de la VM.
L’habitude opérationnelle importante n’est pas de « réessayer chaque erreur d’IA ». Il faut identifier la limite concernée, réessayer uniquement une condition réellement temporaire dans une limite fixe et fournir aux clients une réponse exploitable.