Introduction
Une recherche par mots-clés recherche les mêmes mots. Une recherche sémantique tente de trouver des textes qui ont le même sens. Par exemple, « Je ne peux pas me connecter » devrait être proche d’un article expliquant comment réinitialiser un mot de passe, même si les deux phrases ne contiennent pas exactement les mêmes mots.
Un modèle d’embeddings transforme un texte en vecteur : une liste ordonnée de nombres représentant les caractéristiques que le modèle a apprises à partir du langage. Les textes ayant un sens proche pointent généralement dans des directions similaires. Cet atelier compare ces directions avec la similarité cosinus, un calcul qui renvoie un score plus élevé lorsque les vecteurs sont mieux alignés. Un score n’est utile que pour comparer des vecteurs produits avec le même modèle, le même nombre de dimensions et le même choix de pooling ; ce n’est pas un pourcentage universel de vérité.
Vous allez créer POST /search. Le Worker génère l’embedding d’une requête et de trois courts articles d’aide à l’aide du modèle @cf/baai/bge-small-en-v1.5 hébergé par Cloudflare. Le modèle produit 384 nombres par texte. Votre application valide chaque vecteur avant de le comparer, rejette les valeurs incompatibles ou non finies et renvoie les identifiants des articles classés, sans exposer les vecteurs eux-mêmes.
Il s’agit du quatrième atelier du cours. Si vous êtes arrivé directement ici, commencez par Connect LabEx to Your Cloudflare Account afin d’apprendre à utiliser le terminal de la VM, à autoriser Wrangler, à confirmer votre compte d’apprentissage et à configurer son identifiant de compte.
Les comptes Workers Free reçoivent actuellement une allocation quotidienne partagée de 10 000 Neurons. Ce modèle coûte environ 1 841 Neurons par million de jetons d’entrée, et cet atelier n’utilise que quelques courtes phrases synthétiques ; Workers Paid n’est donc pas nécessaire tant que l’allocation gratuite reste disponible. L’inférence locale contacte tout de même Cloudflare et consomme l’usage du compte. Arrêtez-vous au lieu de réessayer plusieurs fois si le modèle ou l’allocation est indisponible.
La configuration installe Node.js 22.22.0 et Wrangler 4.132.0, installé localement dans le projet, dans /home/labex/project/search-embeddings. Elle fournit également des tests déterministes et des vérifications indépendantes. La configuration n’autorise pas Wrangler, n’invoque pas de modèle, ne déploie pas de Worker et ne crée aucune ressource cloud.
Autoriser la VM et configurer le Worker d’embeddings
Dans cette étape, vous allez autoriser cette nouvelle VM et configurer un Worker temporaire. La connexion au Dashboard concerne votre navigateur ; Wrangler, dans cette VM, doit disposer de sa propre autorisation limitée.
Accédez au projet préparé et confirmez la version figée de l’interface en ligne de commande :
cd /home/labex/project/search-embeddings
npx wrangler --version
La sortie attendue est 4.132.0. Demandez les autorisations limitées utilisées dans les ateliers précédents sur Workers AI. L’autorisation KV permet de satisfaire la vérification de dépendance de nettoyage de Wrangler 4.132.0 ; cet atelier ne crée aucune donnée KV.
npx wrangler login --device --browser=false --scopes account:read user:read workers_scripts:write workers_kv:write ai:write
Ouvrez le lien affiché, saisissez le code actuel, vérifiez le compte et les autorisations, puis autorisez votre compte d’apprentissage. Inspectez ensuite les informations d’identité structurées :
npx wrangler whoami --json
Vérifiez la présence de loggedIn: true, puis générez un nom de Worker unique :
RUN="labex-c07-a04-$(openssl rand -hex 6)"
printf '%s\n' "$RUN"
Remplacez YOUR_ACCOUNT_ID par l’identifiant réel du compte ciblé :
cat > wrangler.jsonc <<JSON
{
  "\$schema": "./node_modules/wrangler/config-schema.json",
  "name": "$RUN",
  "account_id": "YOUR_ACCOUNT_ID",
  "main": "src/index.js",
  "compatibility_date": "2026-09-16",
  "workers_dev": true,
  "preview_urls": false,
  "observability": { "enabled": true, "head_sampling_rate": 1 },
  "ai": { "binding": "AI", "remote": true }
}
JSON
env.AI est une liaison disponible dans le processus, et non une clé d’API du modèle écrite dans le code source. remote: true signifie que le développement local appelle toujours le modèle associé au compte.
Comprendre le contrat des vecteurs
Dans cette étape, vous allez relier la configuration du modèle aux nombres que l’application doit valider.
Générez les types d’environnement et confirmez la liaison de la plateforme :
npx wrangler types
grep -A4 'interface __BaseEnv_Env' worker-configuration.d.ts
Recherchez AI: Ai. Le modèle BGE Small sélectionné renvoie un vecteur de 384 dimensions pour chaque texte d’entrée. Dimension désigne le nombre de positions ; un lot de quatre textes doit donc avoir la forme [4, 384]. Chaque position doit contenir un nombre fini : ni NaN, ni l’infini positif, ni l’infini négatif.
Cet atelier demande explicitement le pooling cls. Le pooling est la méthode utilisée par le modèle pour condenser les informations au niveau des tokens en un seul vecteur. Les vecteurs créés avec le pooling cls et ceux créés avec le pooling mean ne sont pas compatibles, même s’ils comportent tous deux 384 positions. L’application enregistre donc ce choix avec le modèle et les dimensions.
Inspectez les jeux de données de test déterministes fournis :
grep -nE 'incompatible|non-finite|cosine similarity' test/worker.test.mjs
Ces jeux de données rendent les tests d’échec reproductibles sans consommer de Neurons. Ils évitent également d’exiger un score de similarité exact en direct, car celui-ci peut varier selon le comportement du modèle.
Construire le point de terminaison de similarité validé
Dans cette étape, vous allez implémenter la demande d’embeddings, la validation des vecteurs et le calcul local de la similarité cosinus. Le Worker renvoie les identifiants et les scores des documents, et non les 1 536 nombres bruts correspondant aux quatre vecteurs.
Créez le point d’entrée :
cat > src/index.js <<'JS'
const MODEL = "@cf/baai/bge-small-en-v1.5";
const DIMENSIONS = 384;
const POOLING = "cls";
const MAX_QUERY = 300;
const DOCUMENTS = [
  { id: "password-reset", text: "Reset a forgotten password and regain account access." },
  { id: "upload-pdf", text: "Troubleshoot a PDF document that will not upload." },
  { id: "billing-receipt", text: "Download a receipt for a completed payment." }
];

export function validateEmbeddingBatch(result, expectedCount) {
  if (!Array.isArray(result?.shape) || result.shape[0] !== expectedCount || result.shape[1] !== DIMENSIONS) {
    throw new Error("incompatible embedding shape");
  }
  if (!Array.isArray(result.data) || result.data.length !== expectedCount) {
    throw new Error("incompatible embedding count");
  }
  for (const vector of result.data) {
    if (!Array.isArray(vector) || vector.length !== DIMENSIONS || !vector.every(Number.isFinite)) {
      throw new Error("invalid embedding vector");
    }
  }
  return result.data;
}

export function cosineSimilarity(left, right) {
  if (left.length !== right.length || left.length === 0) throw new Error("incompatible vectors");
  let dot = 0, leftNorm = 0, rightNorm = 0;
  for (let index = 0; index < left.length; index += 1) {
    dot += left[index] * right[index];
    leftNorm += left[index] ** 2;
    rightNorm += right[index] ** 2;
  }
  if (leftNorm === 0 || rightNorm === 0) throw new Error("zero-length direction");
  return dot / (Math.sqrt(leftNorm) * Math.sqrt(rightNorm));
}

function json(data, status = 200) { return Response.json(data, { status }); }

async function readQuery(request) {
  if (!(request.headers.get("content-type") || "").toLowerCase().includes("application/json")) {
    return { error: json({ error: "json_required" }, 415) };
  }
  let body;
  try { body = await request.json(); } catch { return { error: json({ error: "invalid_json" }, 400) }; }
  const query = typeof body?.query === "string" ? body.query.trim() : "";
  if (!query) return { error: json({ error: "invalid_query" }, 400) };
  if (query.length > MAX_QUERY) return { error: json({ error: "query_too_large" }, 413) };
  return { query };
}

async function search(request, env) {
  const parsed = await readQuery(request);
  if (parsed.error) return parsed.error;
  const requestId = crypto.randomUUID();
  let result;
  try {
    result = await env.AI.run(MODEL, { text: [parsed.query, ...DOCUMENTS.map((item) => item.text)], pooling: POOLING });
  } catch {
    console.error(JSON.stringify({ event: "embedding_failed", requestId, model: MODEL }));
    return json({ error: "model_unavailable", requestId }, 502);
  }
  let vectors;
  try { vectors = validateEmbeddingBatch(result, DOCUMENTS.length + 1); }
  catch {
    console.error(JSON.stringify({ event: "embedding_rejected", requestId, model: MODEL }));
    return json({ error: "invalid_embeddings", requestId }, 502);
  }
  const [queryVector, ...documentVectors] = vectors;
  const matches = DOCUMENTS.map((document, index) => ({ id: document.id, score: cosineSimilarity(queryVector, documentVectors[index]) }))
    .sort((left, right) => right.score - left.score);
  console.log(JSON.stringify({ event: "embedding_compared", requestId, model: MODEL, dimensions: DIMENSIONS, count: vectors.length, pooling: POOLING }));
  return json({ model: MODEL, dimensions: DIMENSIONS, pooling: POOLING, matches, requestId });
}

export default { async fetch(request, env) {
  const url = new URL(request.url);
  if (request.method === "GET" && url.pathname === "/health") return json({ status: "ok" });
  if (request.method === "POST" && url.pathname === "/search") return search(request, env);
  return json({ error: "not_found" }, 404);
} };
JS
La validation s’exécute avant le calcul de la similarité. Elle empêche les troncatures silencieuses, les comparaisons dépourvues de sens entre dimensions différentes et les scores NaN. Les journaux conservent les métadonnées du cycle de vie, mais excluent la requête, le texte des articles et les vecteurs.
Exécutez les cinq tests déterministes, puis créez le bundle sans déployer :
node --test test/worker.test.mjs
npx wrangler deploy --dry-run
Les tests valident les calculs locaux et le comportement de rejet. L’exécution à blanc vérifie que le Worker et la configuration de la liaison sont regroupés correctement.
Effectuer une véritable génération d’embeddings par lot
Dans cette étape, vous allez exécuter le gestionnaire localement pendant que sa liaison AI effectue une véritable demande distante d’embeddings.
Démarrez Wrangler en arrière-plan et attendez que le point de terminaison de santé, qui n’utilise pas l’IA, soit disponible :
npx wrangler dev --port 8787 > .labex/dev.log 2>&1 &
echo $! > .labex/dev.pid
for attempt in $(seq 1 30); do
  if curl --silent --fail http://127.0.0.1:8787/health; then break; fi
  sleep 1
done
Envoyez une courte requête synthétique :
curl --silent --show-error http://127.0.0.1:8787/search \
  --header 'Content-Type: application/json' \
  --data '{"query":"I cannot sign in because I forgot my password"}'
La réponse doit contenir model, dimensions: 384, pooling: "cls", trois identifiants classés et des scores finis. N’exigez pas de scores exacts. Le classement est un résultat lié à cette requête, et non une garantie permanente du modèle.
Rejetez une requête vide avant l’inférence :
curl --silent --show-error --write-out '\nHTTP %{http_code}\n' http://127.0.0.1:8787/search \
  --header 'Content-Type: application/json' --data '{"query":""}'
La réponse attendue est {"error":"invalid_query"} avec le code HTTP 400.
Déployer et examiner les éléments probants des embeddings
Dans cette étape, vous allez déployer le même point de terminaison et relier les éléments d’exécution au Cloudflare Dashboard.
Arrêtez uniquement le processus de développement enregistré, puis déployez :
kill "$(cat .labex/dev.pid)"
wait "$(cat .labex/dev.pid)" 2>/dev/null || true
npx wrangler deploy
Enregistrez l’URL exacte affichée par Wrangler et envoyez une requête publique :
WORKER_URL="https://YOUR_WORKER_URL"
curl --silent --show-error "$WORKER_URL/search" \
  --header 'Content-Type: application/json' \
  --data '{"query":"I cannot sign in because I forgot my password"}'
Vérifiez que la réponse indique le modèle, 384 dimensions et le pooling cls, et qu’elle classe exactement les trois identifiants fournis, avec des scores finis.
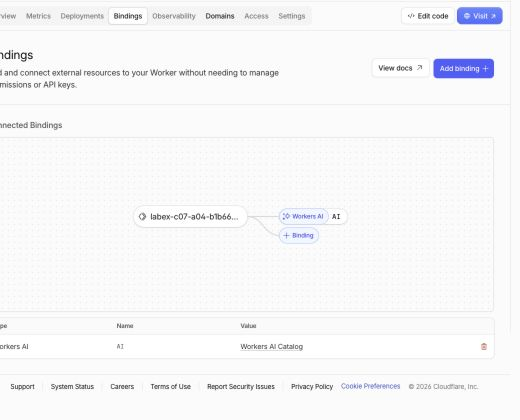
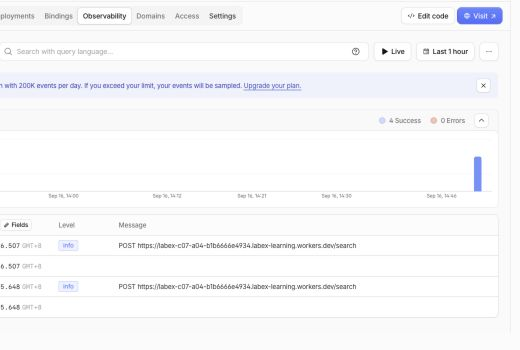
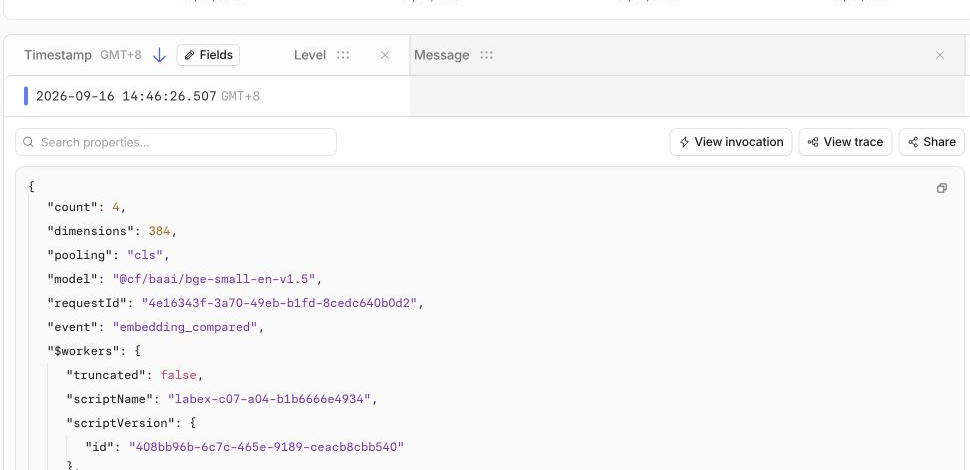
Ouvrez Workers & Pages → Overview → votre Worker labex-c07-a04-.... Dans Bindings, inspectez la liaison AI. Dans Observability → Logs, recherchez embedding_compared et développez l’événement. Vérifiez le modèle exact, dimensions: 384, count: 4, pooling: cls et un identifiant de requête. La requête, les documents et les vecteurs doivent être absents.
La page Bindings rend la connexion visible : le Worker possède une liaison Workers AI nommée AI. Une liaison est l’interface sécurisée utilisée par votre code via env.AI ; vous ne collez pas de clé d’API dans le fichier source.
La vue d’ensemble Observability affiche les requêtes /search réussies et aucune erreur pour cette exécution temporaire. Vos totaux exacts peuvent différer, car chaque requête de test devient un événement.
Développez un événement embedding_compared. Cet exemple ciblé n’enregistre que les informations opérationnelles utiles : quatre textes ont été comparés, chaque vecteur comportait 384 dimensions, le pooling cls a été utilisé et le modèle était @cf/baai/bge-small-en-v1.5. La requête de l’apprenant, le texte des documents et les centaines de nombres des vecteurs ne sont volontairement pas enregistrés.
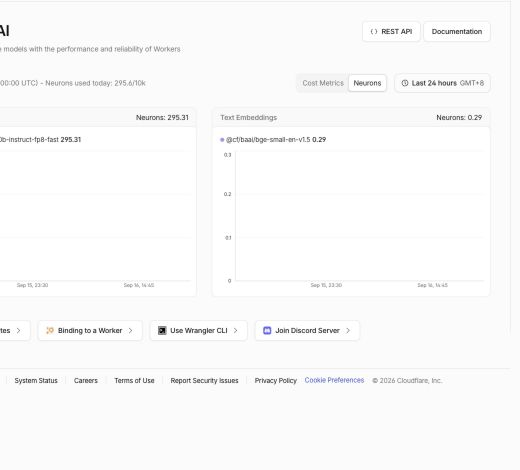
Ouvrez ensuite Workers AI. Dans l’usage du jour, trouvez le modèle BGE Small et vérifiez que cette exécution limitée reste dans l’allocation gratuite partagée de 10 000 Neurons. La mise à jour du Dashboard peut prendre du temps ; attendez brièvement au lieu de répéter l’inférence pour forcer l’actualisation du graphique.
Sur le compte Free testé, le modèle d’embeddings a utilisé seulement 0.29 Neurons, tandis que l’usage total était de 295.6 / 10k. Le total plus élevé inclut d’autres tests du cours effectués le même jour ; considérez donc ces nombres comme un exemple et non comme un résultat obligatoire. Le point de contrôle important est que la ligne BGE Small apparaît et que votre total quotidien reste inférieur à l’allocation Free.
Les graphiques du Dashboard constituent un point de contrôle visuel utile, mais la réponse JSON et le script de vérification indépendant restent les preuves faisant autorité pour confirmer que le Worker déployé fonctionne correctement.
Supprimer le Worker et se déconnecter
Dans cette étape, vous allez supprimer le point de terminaison temporaire, puis retirer l’autorisation de cette VM. L’usage de Workers AI fait partie de l’historique du compte ; supprimer le Worker n’efface donc pas cet enregistrement d’usage.
Supprimez le Worker indiqué dans wrangler.jsonc :
npx wrangler delete
Confirmez uniquement lorsque Wrangler affiche le nom unique de cet atelier, labex-c07-a04-.... Attendez la confirmation Successfully deleted, puis exécutez la vérification indépendante de l’absence dans le cloud pendant que vous êtes encore autorisé :
python3 .labex/verify.py deleted
Attendez l’affichage de PASS: deleted, puis déconnectez-vous et inspectez l’état structuré :
npx wrangler logout
npx wrangler whoami --json
La valeur attendue est loggedIn: false. Fermer un onglet du navigateur ou constater l’absence d’un fichier local ne suffirait pas à prouver le nettoyage dans le cloud.
Résumé
Vous avez généré des embeddings de 384 dimensions avec un modèle hébergé par Cloudflare, enregistré les choix de compatibilité, validé chaque vecteur, comparé les directions sémantiques avec la similarité cosinus et rejeté les données incompatibles avant le classement. Vous avez également vérifié la liaison active et les journaux respectueux de la confidentialité, puis supprimé le Worker temporaire et l’autorisation de la VM.