Introduction
La comparaison des personnes affectées à l’atelier donne à la page B un taux d’inscription plus élevé. L’affectation aléatoire peut-elle, à elle seule, produire des groupes apparemment différents même si la page ne change le résultat de personne ? Un petit échange manuel rend la question concrète avant de générer une distribution de différences réellement aléatoires.
Cet environnement indépendant contient déjà les bonnes fonctions de construction des résultats individuels et de comparaison des taux enseignées auparavant, ainsi que ses propres données originales. Vous devez connaître ces idées, les fonctions Python, les tableaux NumPy élémentaires et les bases de Matplotlib. Aucun fichier d’une VM précédente ni connaissance d’inférence statistique n’est nécessaire. Vous enregistrerez 399 réaffectations exploratoires et leur véritable graphique ; vous ne calculerez pas de valeur p et ne choisirez pas de vainqueur ici. Tous les enregistrements sont des exemples pédagogiques synthétiques originaux. La durée de 55 minutes est une estimation de l’auteur incluant lecture et corrections ordinaires.
Échangez des personnes sans changer les effectifs
Dans cette étape, vous calculerez une différence à six personnes, échangerez deux appartenances aux groupes et verrez pourquoi la comparaison peut changer.
Dans WebIDE, ouvrez Terminal → New Terminal et entrez dans le répertoire de cette unité :
cd /home/labex/project/signup-experiment
cat lit les fichiers sans les modifier. Relisez les fiches de l’exemple et les deux fonctions préparées :
cat warmup-visitors.csv
cat outcomes.py
cat compare.py
Les six fiches ont les résultats binaires [1, 0, 0] dans A et [1, 1, 0] dans B. Chaque 1 ou 0 appartient à une personne affectée ; les événements répétés ne sont pas des observations supplémentaires. A compte 1/3 d’inscrits, B 2/3, et B−A vaut environ +33.33 points de pourcentage.
Imaginez échanger l’appartenance de la deuxième personne de A (résultat 0) avec celle de la première de B (résultat 1). A devient [1, 1, 0], B devient [0, 1, 0] et la différence est proche de −33.33 points de pourcentage. Chaque groupe compte toujours trois personnes et il reste trois résultats positifs au total. Vous avez changé l’affectation, pas les résultats individuels ni la taille de l’échantillon.
Écrivez la fonction de différence. np.mean calcule la moyenne des valeurs binaires d’un tableau NumPy. Soustraire la moyenne de A de celle de B, puis multiplier par 100, donne des points de pourcentage. L’ébauche de sample_null sera complétée ensuite ; définir une fonction ne l’exécute pas.
Le > du shell remplace le fichier. Le here-document entre guillemets <<'PY' copie le bloc complet jusqu’au PY final sans expansion du shell. Vous pouvez aussi enregistrer le même contenu avec File → Save dans WebIDE.
cat > resample.py <<'PY'
import numpy as np


def difference(a, b):
    return float(100 * (np.mean(b) - np.mean(a)))


def sample_null(a, b, draws=399, seed=17):
    raise NotImplementedError("Complete this function in the next step.")
PY
L’étape contrast de l’exécuteur fournit les fiches originales et exactement l’échange décrit, appelle votre fonction deux fois et enregistre les deux résultats réels :
python3 run.py contrast
Le lecteur affiche le résultat enregistré sans le reconstruire :
python3 show_results.py contrast
Attendez original_pp proche de +33.33 et swapped_pp proche de −33.33. Aucun ne prédit ce qui arriverait à une personne réelle sur une autre page. Ils montrent comment la composition des groupes peut modifier la comparaison alors que les mêmes six résultats restent fixes.
Vous pouvez modifier resample.py, puis plot.py, ou ajouter des fichiers auxiliaires Python ordinaires à côté. Conservez les CSV originaux, paramètres, dictionnaire, exécuteur et lecteur. Si le répertoire est incorrect, utilisez pwd et ls, puis répétez le cd précédent. Recopiez un bloc complet pour corriger une erreur d’édition ; setup refuse d’écraser un répertoire de travail existant.
Générez de véritables réaffectations
Dans cette étape, vous remélangerez plusieurs fois les résultats de tous les visiteurs en groupes de leurs effectifs initiaux, et conserverez chaque différence obtenue.
Continuez dans le même terminal WebIDE, à /home/labex/project/signup-experiment. L’échantillon fixe complet compte 12 personnes affectées, six par groupe. La fonction préparée utilise les fenêtres complètes de sept jours. Relisez les entrées réelles complètes pour retrouver les personnes sans événements et les cas de frontière :
cat assignments.csv
cat events.csv
Selon l’hypothèse nulle d’absence d’effet de cet exercice, la page affectée ne change le résultat binaire de personne. Réaffecter ces résultats individuels fixes entre les deux groupes montre donc la variation attendue du seul fait de l’affectation. Cette hypothèse repose sur le plan randomisé représenté par ces données synthétiques. Mélanger un journal d’observation quelconque d’un site ne créerait pas une expérience randomisée.
np.concatenate([a, b]) rassemble les deux tableaux. np.random.default_rng(seed) crée un générateur pseudo-aléatoire à état initial reproductible. Sa méthode permutation renvoie une copie mélangée, en laissant intact le tableau initial réuni. La tranche shuffled[:len(a)] prend la première partie de taille A ; shuffled[len(a):] prend le reste de taille B. Chaque tirage utilise chaque personne une fois et conserve les deux effectifs. Ne mélangez pas les événements bruts qui répètent des personnes.
Remplacez le fichier par les deux fonctions complètes. La boucle for réalise le nombre de tirages demandé ; append conserve chaque différence calculée. Renvoyer un tableau garde l’échantillon entier, plutôt que sa seule moyenne ou un tirage favorable.
cat > resample.py <<'PY'
import numpy as np


def difference(a, b):
    return float(100 * (np.mean(b) - np.mean(a)))


def sample_null(a, b, draws=399, seed=17):
    pooled = np.concatenate([a, b])
    rng = np.random.default_rng(seed)
    differences = []
    for _ in range(draws):
        shuffled = rng.permutation(pooled)
        differences.append(difference(shuffled[:len(a)], shuffled[len(a):]))
    return np.array(differences)
PY
L’exécuteur appelle ces fonctions sur l’échantillon individuel complet et enregistre les effectifs réels, la différence observée et 399 différences mélangées. --seed fournit l’état initial reproductible ; les deux tirets signalent une option nommée.
python3 run.py sample --seed 17
python3 show_results.py sample
Les données complètes ont toujours 1 inscrit sur 6 dans A et 5 sur 6 dans B, soit une différence observée proche de +66.67 points de pourcentage. null_count doit être 399. Pour limiter l’affichage, le lecteur ne présente que les huit premiers tirages sous null_preview ; le tableau complet est enregistré dans output/sample.json.
Générez un deuxième échantillon ordinaire pour comprendre pourquoi une graine ne constitue pas une réponse de référence obligatoire :
python3 run.py sample --seed 42
python3 show_results.py sample
Cela remplace l’échantillon enregistré par l’exécution réelle à graine 42. La séquence change généralement, mais les résultats individuels initiaux, les effectifs et la comparaison observée restent identiques. Réutiliser la même graine doit reproduire la même séquence. Toute graine non négative reproductible et toute implémentation équivalente de tirages indépendants sont admises ; la séquence de l’auteur n’est pas exigée. Ne relancez pas sans cesse pour trouver un échantillon semblant favoriser une page. L’analyse exacte ultérieure utilise toutes les affectations, pas l’échantillon exploratoire le plus séduisant.
Chaque statistique mélangée se situe entre −100 et +100 points de pourcentage, sans que toutes les valeurs de cet intervalle soient atteignables. Pour l’exemple à six personnes, les 20 affectations distinctes de trois contre trois donnent les effectifs 1, 9, 9, 1 aux différences −100, −100/3, +100/3, +100. L’échantillon complet de 12 personnes compte 924 affectations, avec les effectifs 1, 36, 225, 400, 225, 36, 1 aux différences −100, −200/3, −100/3, 0, +100/3, +200/3, +100. Le laboratoire suivant effectue le calcul exact au lieu de vous demander de mémoriser ces nombres.
Pour cette tâche exploratoire, la fréquence échantillonnée de chaque différence possible peut s’écarter de sa fréquence exacte de référence d’au plus 0.15 en proportion absolue. Par exemple, 0.40 et 0.46 diffèrent de 0.06. C’est une tolérance d’acceptation pédagogique volontairement large, pas un intervalle de confiance, un seuil de significativité, une garantie commerciale ou un critère de choix de graine. Elle accepte des échantillons ordinaires et des méthodes indépendantes sans imposer des tableaux identiques. Dans un exemple valide entièrement nul, chaque différence réaffectée vaut zéro ; une dispersion non nulle n’est pas obligatoire.
Le contrat s’applique aux tableaux binaires fournis et aux mêmes variantes bornées du cours : au moins deux personnes par groupe et 14 au plus au total. Les vérifications utilisent des entrées et graines isolées, avec d’autres effectifs, des différences négatives ou nulles et des résultats dégénérés. Elles ne remplacent jamais l’échantillon existant. Aucune valeur p échantillonnée n’est demandée ou évaluée.
Tracez les différences d’affectation enregistrées
Dans cette étape, vous afficherez l’effectif échantillonné réel de chaque différence et marquerez la position de la comparaison observée inchangée.
Continuez dans le même terminal WebIDE, à /home/labex/project/signup-experiment. np.unique(..., return_counts=True) renvoie les différences enregistrées distinctes et leurs effectifs. C’est un graphique de comptages discrets : l’axe vertical indique combien des 399 réaffectations produisent chaque différence. Ce n’est pas un intervalle de confiance de l’effet.
La fonction graphique reçoit votre résultat enregistré et une destination. Le PNG doit mesurer au moins 500 × 250 pixels pour rester lisible. figsize=(9, 4.5) règle la taille en pouces. DPI (points par pouce) définit la résolution matricielle enregistrée : 140 pixels par pouce donnent environ 9 × 140 par 4.5 × 140, soit 1260 × 630 pixels. subplots de Matplotlib crée la figure et les axes. bar trace les effectifs, et axvline marque la différence observée sans la faire passer pour un autre effectif d’affectations. Une étiquette et une légende visible identifient cette marque. Les limites horizontales fixes de −110 à +110 laissent de la place à toute différence possible de taux binaires, même si un extrême n’apparaît pas dans cet échantillon fini. L’axe vertical commence à zéro ; tight_layout réserve la place des étiquettes avant que savefig écrive un véritable PNG.
cat > plot.py <<'PY'
import numpy as np
import matplotlib.pyplot as plt


def make_plot(result, destination):
    differences, counts = np.unique(result["null"], return_counts=True)
    fig, ax = plt.subplots(figsize=(9, 4.5))
    ax.bar(differences, counts, width=8, color="#6374cc", edgecolor="white")
    ax.axvline(result["difference_pp"], color="#cc5b43", linewidth=2,
               label="Observed B − A")
    ax.set_xlabel("B − A (percentage points)")
    ax.set_ylabel("Number of reassignments")
    ax.set_title("Random reassignments of the fixed visitor outcomes")
    ax.set_xlim(-110, 110)
    ax.set_ylim(0, float(max(counts)) * 1.2)
    ax.legend()
    fig.tight_layout()
    fig.savefig(destination, dpi=140)
    plt.close(fig)
PY
Lisez l’échantillon déjà enregistré et dessinez-le avec votre fonction :
python3 run.py plot-sample
Dans l’explorateur de WebIDE, développez signup-experiment/output et ouvrez sample.png. Lisez les deux étiquettes d’axes. La plupart des effectifs devraient se regrouper près d’une différence nulle ; la marque rouge observée reste proche de +66.67 points de pourcentage. Une valeur absente de l’échantillon a un effectif nul ; il ne s’agit pas d’une personne omise. Les 399 tirages et les 12 personnes originales figurent toujours dans les données enregistrées.
L’image ci-dessous utilise l’exemple NumPy à graine 42 que vous venez d’exécuter. Une autre méthode ou graine autorisée peut changer les hauteurs des barres ; votre fichier doit montrer vos propres tirages réels.
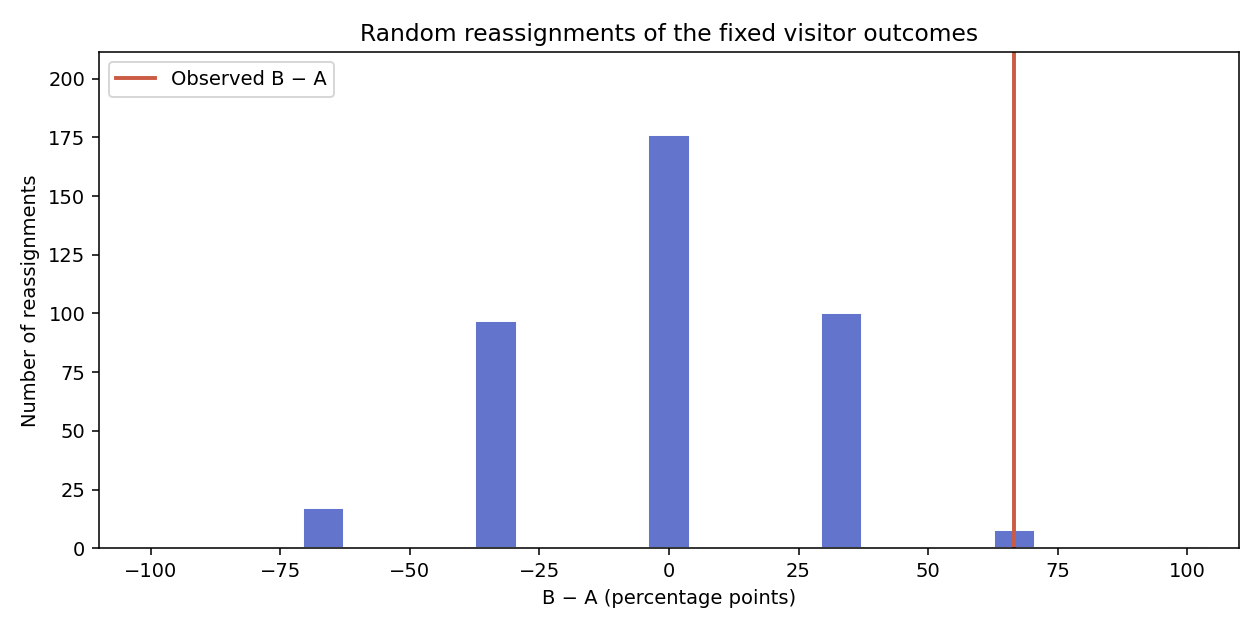
Le PNG enregistré doit être reproductible à partir de votre fonction actuelle et de l’échantillon enregistré. Vous pouvez utiliser des barres lisibles, une ligne de comptages ou des points aux différences réelles, avec une ligne ou un point visible étiqueté Observed à la différence observée. Gardez toutes les différences possibles et cette marque dans les axes, conservez la base zéro et étiquetez les deux axes. Masquer un repère, couper les données, copier une image étrangère ou tracer une densité étiquetée comme effectif ne remplit pas la tâche.
Si le PNG manque, vérifiez d’abord que python3 show_results.py sample lit un échantillon enregistré, puis relancez la commande graphique. Le lecteur ne crée pas les fichiers absents. Dans le prochain laboratoire, vous comparerez une distribution exacte d’affectations au résultat observé et apprendrez ce que ces éléments permettent ou non de conclure.
Résumé
Vous avez échangé manuellement deux appartenances, généré 399 véritables réaffectations de visiteurs à effectifs fixes et tracé leurs différences enregistrées avec la comparaison observée. Une graine reproductible permet de répéter une exécution ; elle ne choisit ni réponse ni page gagnante. Vous avez désormais l’intuition nécessaire pour comprendre l’analyse exacte du laboratoire suivant.