Introduction
Un graphique exploratoire de réaffectations montre comment des résultats individuels fixes peuvent produire différentes comparaisons entre groupes. Ce laboratoire poursuit l’analyse : il compte chaque affectation distincte de ce petit échantillon fixe, définit précisément une valeur p bilatérale et consigne ce que les données étayent.
Les bonnes fonctions individuelles et de comparaison sont déjà préparées dans cet environnement indépendant. Vous devez connaître les fenêtres individuelles, les différences en points de pourcentage et les réaffectations à effectifs fixes des laboratoires précédents, ainsi que les bases de Python, NumPy et Matplotlib. Aucun fichier d’une VM antérieure ni connaissance préalable des valeurs p n’est nécessaire. Ces données pédagogiques synthétiques originales ne constituent pas une expérience commerciale réelle ; ni une grande différence observée ni une petite valeur p ne garantissent un résultat en production. Les 55 minutes sont une estimation de l’auteur incluant lecture et corrections ordinaires.
Comptez chaque affectation distincte
Dans cette étape, vous remplacerez un échantillon aléatoire fini par la distribution complète des affectations et calculerez la valeur p bilatérale explicitement définie.
Dans WebIDE, ouvrez Terminal → New Terminal et entrez dans le répertoire de travail :
cd /home/labex/project/signup-experiment
Lisez les définitions sources et les paramètres avant d’examiner le résultat du test :
cat data-dictionary.md
cat config.json
L’analyse utilise un seul échantillon fixe dont tous les suivis sont achevés et un seul résultat binaire d’inscription par personne. L’interprétation utilisera alpha = 0.05, déjà choisi. Alpha est un seuil de comparaison conventionnel pour cet exercice, pas une probabilité de 95% qu’une page fonctionne. Il n’a pas été choisi après recherche d’un résultat favorable. Ne changez pas les données, l’instant d’analyse, le seuil ou la population après avoir vu la comparaison.
Sous l’hypothèse nulle d’absence d’effet de la page, le résultat de chaque personne serait inchangé quelle que soit la page affectée. Le plan randomisé représenté permet alors de redistribuer ces résultats fixes tout en conservant les effectifs. Cette inférence ne s’applique pas automatiquement à un journal d’observation arbitraire non randomisé.
Une distribution exacte d’affectations inclut chaque manière distincte de répartir les personnes dans les deux groupes. Pour une statistique basée sur les moyennes, l’ordre interne à un groupe ne crée pas d’affectation supplémentaire. math.comb(n, k) de Python compte les choix de k personnes parmi n. Choisir les six personnes de A parmi 12 détermine ici aussi les six de B.
python3 - <<'PY'
from math import comb
print("Distinct allocations:", comb(12, 6))
print("Course maximum:", comb(14, 7))
PY
Cette expérience compte 924 affectations ; tout exemple fourni par le cours en a au plus 3432. L’énumération exacte est praticable à cette petite taille volontaire ; elle ne promet pas d’énumérer n’importe quel grand échantillon de production.
Pour la statistique B−A en points de pourcentage, le cours suit la convention précise two-sided de SciPy :
Calculez d’abord la proportion des différences exactes inférieures ou égales à la différence observée. Calculez séparément la proportion des différences supérieures ou égales à cette observation. Doublez la plus petite de ces deux proportions et plafonnez le résultat à 1.
Les valeurs égales appartiennent aux deux queues respectives. Il s’agit d’une définition précise de valeur p bilatérale ; les définitions ne sont pas universelles. Compter abs(null) >= abs(observed) n’est pas toujours équivalent pour une distribution discrète asymétrique. Par exemple, un groupe A de deux personnes sans inscription et un groupe B de cinq personnes avec deux inscriptions donnent +40 points observés. Leurs 21 affectations donnent −100 une fois, −30 dix fois et +40 dix fois. La valeur p définie vaut 2 * 10 / 21 = 20/21 ; la proportion de queue absolue vaudrait 11/21. Ne changez silencieusement ni les groupes ni la définition pour obtenir un nombre plus petit.
Utilisez l’interface préparée permutation_test de SciPy. permutation_type="independent" redistribue les observations entre groupes indépendants en conservant leurs effectifs ; les visiteurs ne sont pas traités comme des mesures appariées. vectorized=False signifie que la statistique reçoit des tableaux unidimensionnels ordinaires. n_resamples=np.inf demande toute la distribution finie plutôt que 399 tirages aléatoires. alternative="two-sided" sélectionne la convention ci-dessus. L’énumération exacte ne nécessite aucune graine aléatoire.
La sélection DataFrame .loc[mask, "signed_up"] prend cette colonne pour les personnes correspondantes ; .to_numpy() transforme ses valeurs en tableau NumPy unidimensionnel. La fonction interne statistic reprend la formule de différence du laboratoire précédent et est entièrement définie ici : cette unité ne dépend donc pas du resample.py d’une autre VM.
result.statistic, result.pvalue et result.null_distribution sont les résultats effectivement calculés. Gardez leurs valeurs non arrondies ; .tolist() transforme le tableau en liste compatible JSON sans supprimer les différences répétées issues d’affectations distinctes.
Le > du shell remplace un fichier ; le here-document entre guillemets <<'PY' copie le bloc complet jusqu’au dernier PY, sans expansion du shell. Vous pouvez aussi modifier le fichier dans WebIDE puis utiliser File → Save.
cat > inference.py <<'PY'
import numpy as np
from scipy.stats import permutation_test


def analyze(people):
    a = people.loc[people["group"] == "A", "signed_up"].to_numpy()
    b = people.loc[people["group"] == "B", "signed_up"].to_numpy()

    def statistic(x, y):
        return float(100 * (np.mean(y) - np.mean(x)))

    result = permutation_test(
        (a, b), statistic,
        permutation_type="independent",
        vectorized=False,
        n_resamples=np.inf,
        alternative="two-sided",
    )
    return {
        "difference_pp": float(result.statistic),
        "pvalue": float(result.pvalue),
        "null": result.null_distribution.tolist(),
    }
PY
L’étape distribution de l’exécuteur appelle l’analyse et enregistre les vrais résultats sans demander encore de fonction d’interprétation :
python3 run.py distribution
Le lecteur affiche les données existantes et omet le long tableau uniquement dans l’affichage du terminal :
python3 show_results.py exact
Attendez 12 personnes, avec une inscription parmi les six personnes de A et cinq parmi les six de B, une différence proche de +66.67 points, null_count égal à 924 et p proche de 0.08009. La distribution complète reste dans output/analysis.json. Le champ d’interprétation sera ajouté ensuite.
Vous pouvez modifier inference.py et plot.py ou ajouter des fichiers auxiliaires Python ordinaires à côté. Conservez les CSV sources, paramètres, dictionnaire, exécuteur et lecteur. outcomes.py et compare.py implémentent des fonctions déjà enseignées ; les équivalents sont acceptés si leurs contrats publics DataFrame/objet et leurs résultats valides restent intacts. Les vérifications isolées couvrent d’autres effectifs bornés, des directions opposées, des différences nulles et des résultats entièrement nuls. Une valeur p fixe ou une distribution fixe n’est pas une analyse réutilisable.
Pour une erreur ordinaire de chemin ou de fichier, utilisez pwd et ls, répétez le cd de départ et recopiez le bloc complet. Setup n’est pas un outil de récupération d’édition : il refuse délibérément de remplacer un répertoire existant.
Distinguez les éléments de preuve de la certitude
Dans cette étape, vous ajouterez une règle d’interprétation transparente pouvant indiquer l’une ou l’autre direction, ou des éléments insuffisants.
Continuez dans le même terminal WebIDE, à /home/labex/project/signup-experiment. Une valeur p décrit une comparaison sous l’hypothèse nulle et le plan d’affectation choisis. Ce n’est pas la probabilité que l’hypothèse nulle soit vraie, ni la probabilité d’absence d’effet de la page, ni une garantie pour le prochain atelier.
Ici, environ +66.67 points observés semblent importants, mais la valeur p exacte vaut environ 0.08009. Avec ce petit échantillon fixe et alpha 0.05 présélectionné, l’exercice donne un résultat non concluant. Cela ne prouve pas que les pages sont identiques. Ce test et cet échantillon n’apportent pas le niveau d’éléments sélectionné contre l’hypothèse nulle.
Utilisez ces étiquettes explicites :
evidence_for_bsi p <= alpha et la différence est positive ;evidence_for_asi p <= alpha et la différence est négative ;inconclusivesinon, y compris pour une différence nulle.
L’égalité au seuil appartient à la branche d’éléments favorables : p == alpha satisfait <=. N’arrondissez pas p avant la comparaison. Ces étiquettes décrivent une analyse bornée, pas une décision automatique de mise en production commerciale. Une autre expérience valide peut étayer A ou aucune page ; aucune étiquette ne doit obligatoirement favoriser B.
Le >> du shell ajoute au fichier existant au lieu de le remplacer. Le bloc complet suivant ajoute conclude sous analyze ; collez-le une fois. Dans WebIDE, ajoutez la fonction à la fin puis enregistrez. Le and de Python exige que les deux conditions soient satisfaites pour qu’une branche renvoie son étiquette.
cat >> inference.py <<'PY'


def conclude(difference_pp, pvalue, alpha):
    if pvalue <= alpha and difference_pp > 0:
        return "evidence_for_b"
    if pvalue <= alpha and difference_pp < 0:
        return "evidence_for_a"
    return "inconclusive"
PY
Relancez l’analyse exacte par l’étape d’interprétation. Celle-ci remplace volontairement le fichier par une analyse actuelle complète contenant aussi l’étiquette :
python3 run.py exact
python3 show_results.py exact
Pour cet échantillon complet, le résultat doit être inconclusive. La différence observée, la valeur p brute et les 924 différences d’affectation restent identiques. Ne supprimez pas de personnes, ne choisissez pas une date, ne réaffectez pas les vrais groupes et ne substituez pas un échantillon exploratoire pour obtenir l’étiquette souhaitée. Tous les suivis de sept jours exigés sont terminés ; modifier une règle d’arrêt ou ajouter des données sort du cadre de cet exercice.
Enregistrez une vue lisible des résultats exacts
Dans cette étape, vous tracerez toute la distribution d’affectations enregistrée et identifierez la comparaison observée sans masquer son contexte.
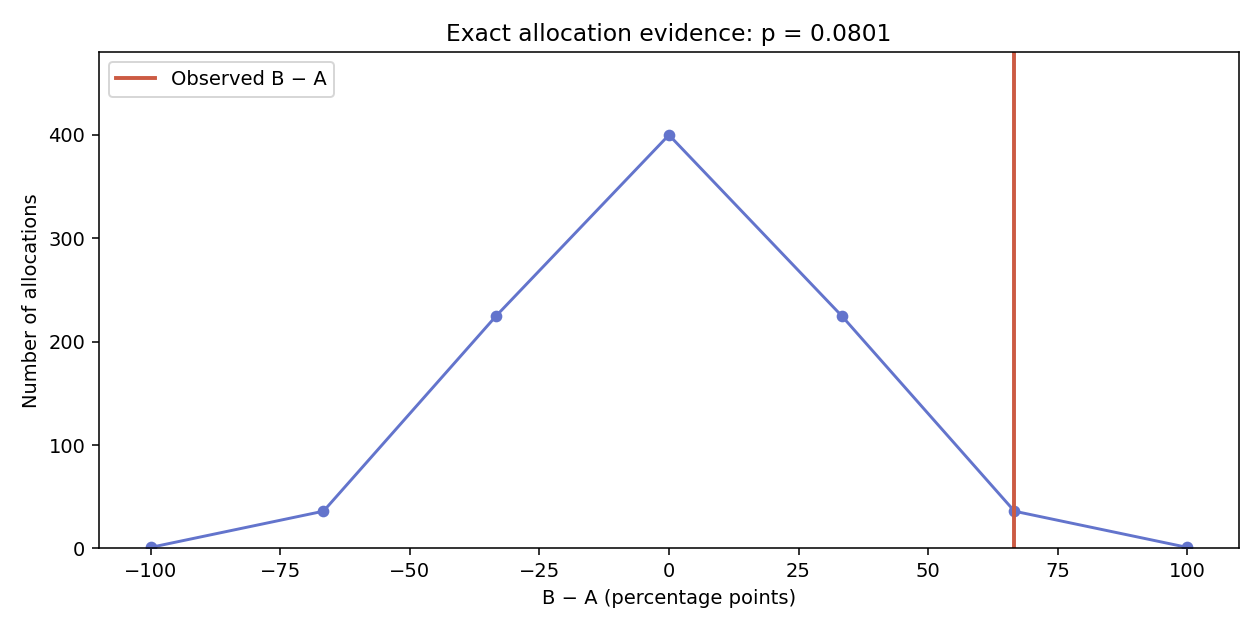
Continuez dans le même terminal WebIDE, à /home/labex/project/signup-experiment. Le graphique utilise la distribution exacte de result["analysis"], pas l’échantillon exploratoire d’une autre unité. np.unique(..., return_counts=True) compte les affectations distinctes produisant chaque différence ; les hauteurs doivent totaliser 924 pour les données actuelles. Les valeurs répétées ont un sens et ne doivent pas être supprimées de la distribution sous-jacente.
Certaines queues exactes comptent une seule affectation. Des marqueurs visibles gardent ces faibles effectifs lisibles au-dessus de la base zéro. La ligne de liaison aide à suivre les points discrets ; elle ne signifie pas que toutes les différences entre eux soient atteignables.
L’horizontale représente B−A en points de pourcentage, la verticale le nombre d’affectations. Le repère visible Observed situe la comparaison réelle. Une valeur p arrondie dans un titre facilite seulement l’affichage ; le nombre enregistré et son interprétation utilisent la valeur non arrondie. Gardez visibles toute l’étendue possible des différences et la base zéro, y compris les zéros légitimes et les valeurs extrêmes.
Enregistrez un PNG d’au moins 500 × 250 pixels. Comme précédemment, une figure de 9 × 4.5 pouces à DPI 140 donne environ 1260 × 630 pixels, assez pour lire les axes et les marqueurs de faibles effectifs.
cat > plot.py <<'PY'
import numpy as np
import matplotlib.pyplot as plt


def make_plot(result, destination):
    analysis = result["analysis"]
    differences, counts = np.unique(analysis["null"], return_counts=True)
    fig, ax = plt.subplots(figsize=(9, 4.5))
    ax.plot(differences, counts, "o-", color="#6374cc", markersize=5)
    ax.axvline(analysis["difference_pp"], color="#cc5b43", linewidth=2,
               label="Observed B − A")
    ax.set_xlabel("B − A (percentage points)")
    ax.set_ylabel("Number of allocations")
    ax.set_title(f"Exact allocation evidence: p = {analysis['pvalue']:.4f}")
    ax.set_xlim(-110, 110)
    ax.set_ylim(0, float(max(counts)) * 1.2)
    ax.legend()
    fig.tight_layout()
    fig.savefig(destination, dpi=140)
    plt.close(fig)
PY
Générez le PNG à partir de l’analyse réellement enregistrée :
python3 run.py plot-exact
Dans l’explorateur de WebIDE, développez signup-experiment/output et ouvrez evidence.png. Repérez la distribution autour de zéro et l’observation proche de +66.67. Lisez aussi output/analysis.json avec le lecteur : les 12 personnes, les deux dénominateurs affectés, la différence brute, p exact, alpha et inconclusive forment ensemble les éléments de l’analyse. Un graphique seul ne prouve pas qu’elle est correcte.
La référence ci-dessous est le graphique réellement enregistré avec ces données guidées et le code fourni. Les points incluent les faibles effectifs des deux queues ; la ligne relie seulement les différences atteignables. Consultez-la avec les résultats numériques enregistrés.
Vous pouvez utiliser des barres lisibles, une ligne de comptages ou des points aux différences réelles. La comparaison observée exige une ligne ou un point visible étiqueté Observed, et les deux axes des libellés significatifs. Gardez visibles toutes les valeurs possibles, l’observation et la base zéro. Le PNG doit être décodable et reproductible à partir des vraies données enregistrées et de la fonction actuelle ; traits invisibles, repères hors axes, figures coupées et images étrangères sont refusés. Si le PNG manque, confirmez le résultat exact enregistré avec python3 show_results.py exact, puis relancez la commande graphique ; le lecteur ne le répare pas.
Vous avez analysé un échantillon synthétique randomisé sous une hypothèse et une convention explicites. Vous n’avez pas mesuré de résultat commercial réel, prouvé que les pages étaient identiques ni établi qu’un effet observé persisterait en production.
Résumé
Vous avez énuméré une distribution exacte bornée, utilisé une valeur p bilatérale définie avec des queues inclusives, appliqué sans arrondi un seuil présélectionné et enregistré le véritable graphique. Une grande différence peut rester non concluante dans un petit échantillon ; un résultat non concluant ne prouve pas l’égalité des pages. Le défi indépendant transfère maintenant ce même processus à une autre affectation et à un autre historique d’événements.