Introduction
Une éditrice de Commonlight a besoin d'un catalogue de photos utilisable, en commençant par un petit échantillon d'une page. Vous effectuerez de vraies requêtes HTTP pour obtenir du JSON, sélectionnerez les enregistrements selon leurs champs et enregistrerez un CSV. Commonlight est une API locale de démonstration originale : ses enregistrements et crédits sont fictifs, et les images proposées sont des illustrations synthétiques, pas des photographies documentaires ni le contenu d'un service photographique externe.
Vous devez connaître les fonctions Python, les collections (listes et dictionnaires, par exemple), les boucles, les exceptions et l'écriture élémentaire de fichiers. HTTP, les URL, JSON et CSV sont présentés ici. Dans WebIDE, choisissez Terminal → New Terminal (sur un écran étroit, le menu Terminal peut se trouver sous More). Exécutez-y toutes les commandes de terminal. Utilisez Web 8080 pour le site préparé. Modifiez uniquement client.py et storage.py ; utilisez la bibliothèque standard et des fonctions auxiliaires définies dans ces fichiers, sans modules ni ressources supplémentaires. Livrez les CSV sous forme de vrais fichiers ordinaires dans l'espace de travail, pas de liens symboliques ; conservez catalog.py et /opt/commonlight intacts. Les 40 minutes de lecture et de pratique sont une estimation de l'auteur, pas une durée mesurée auprès de débutants.
Demander et comprendre une page du catalogue
Dans cette étape, associez trois enregistrements de l'API à trois cartes visibles, puis implémentez la fonction de requête. Passez à Web 8080. L'aperçu Harbor walks contient Morning, market, Blue hour et Window light. Il indique explicitement qu'il montre une page, pas toute la collection. Les images donnent du contexte ; ce cours exporte des métadonnées plutôt que de télécharger des images.
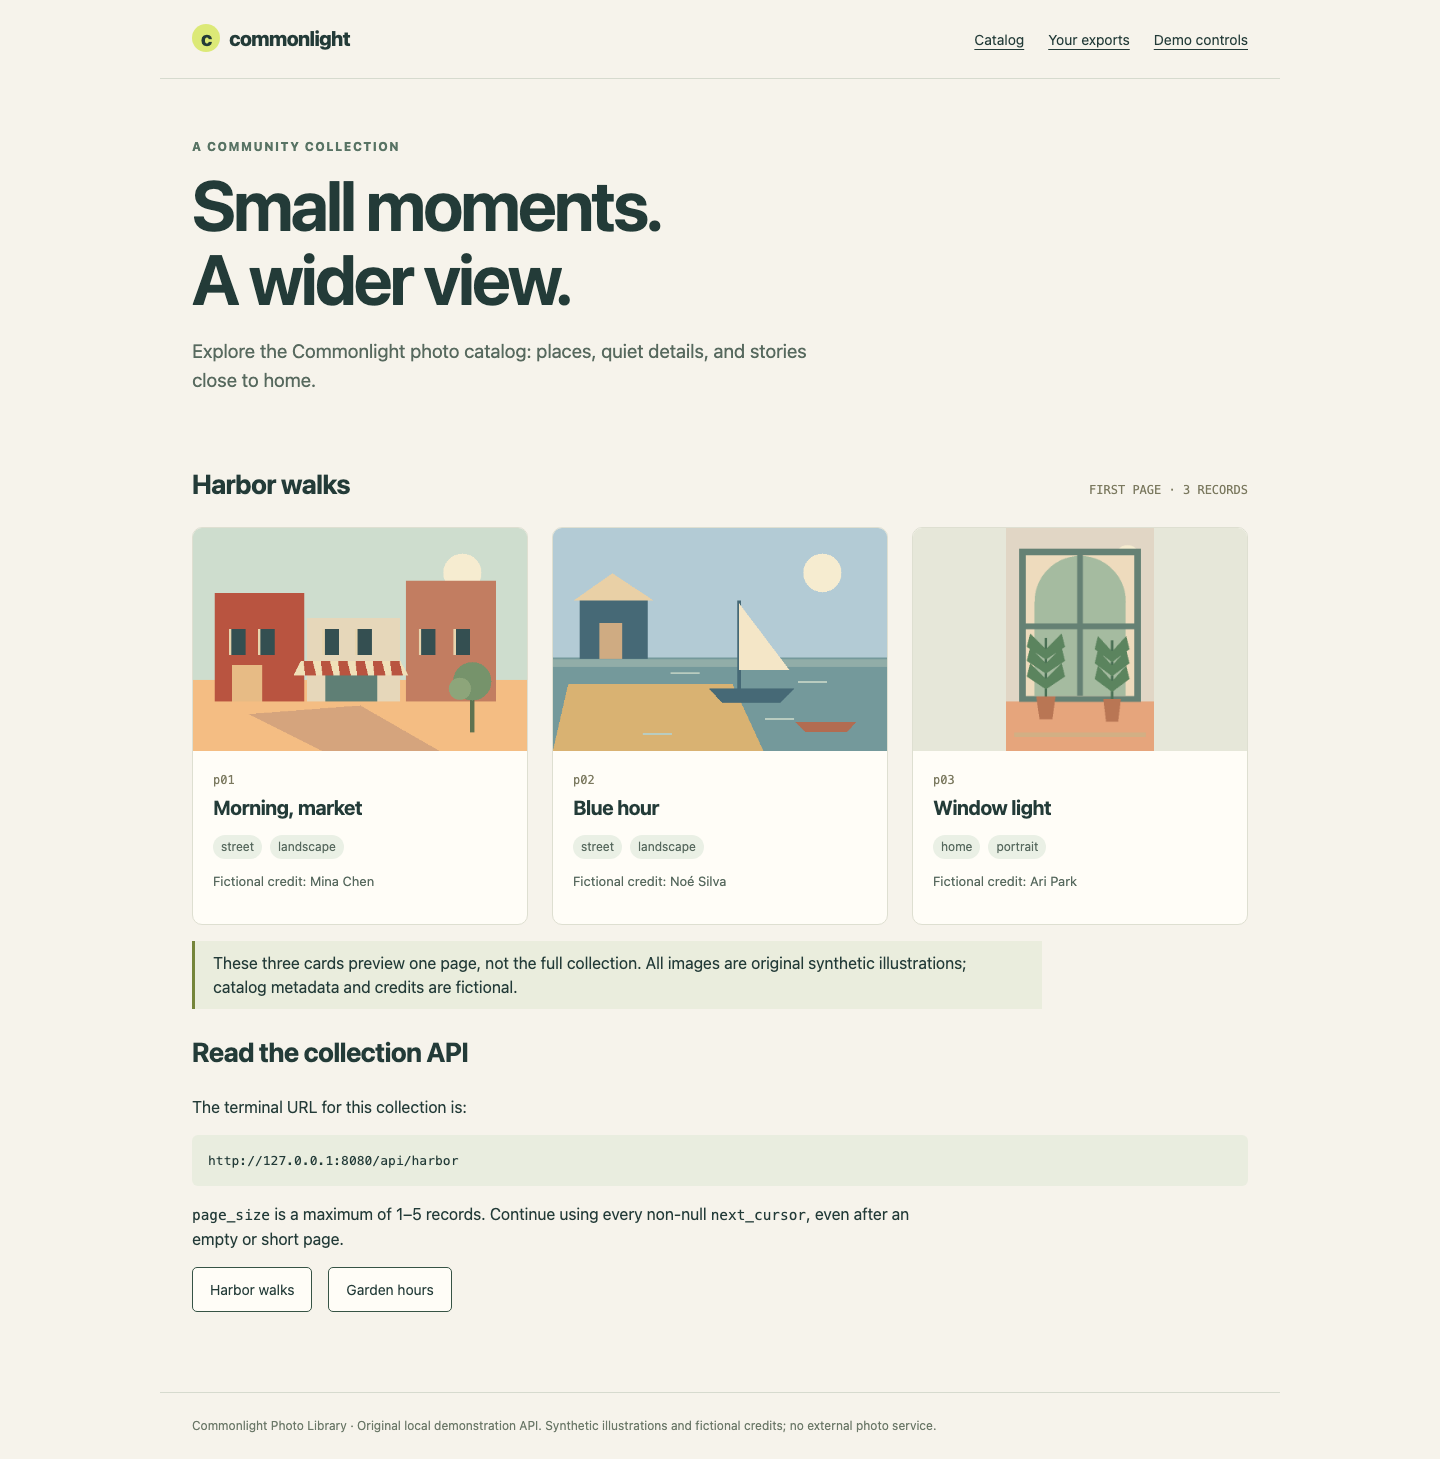
Associez les ID situés sous les illustrations à la réponse que vous allez demander.
Revenez à WebIDE et à son terminal. cd change le répertoire de travail ; python3 exécute Python. Utilisez ce chemin exact :
cd /home/labex/project
HTTP est le protocole de requête et de réponse utilisé par cette API locale. Une URL identifie son adresse : http est le protocole, 127.0.0.1 désigne cet environnement lui-même, 8080 est le port du service et /api/harbor sélectionne une collection. Après ?, la requête page_size=3 demande au plus trois enregistrements. Cette adresse s'utilise dans le terminal ; Web 8080 ouvre l'adresse de navigateur fournie par la plateforme pour le même service.
Le here-document suivant exécute un petit programme Python. <<'PY' transmet les lignes littérales jusqu'au délimiteur final PY à l'entrée standard de Python ; copiez les deux lignes délimitantes. urlopen envoie une véritable requête HTTP. timeout=3 limite les opérations bloquantes, comme une connexion ou l'attente sur une socket, pas la durée de n'importe quel traitement complet. with ferme ensuite la réponse. JSON est un texte structuré ; json.load décode la réponse en données Python.
python3 - <<'PY'
import json
from urllib.request import urlopen
with urlopen('http://127.0.0.1:8080/api/harbor?page_size=3', timeout=3) as response:
    print('HTTP status:', response.status)
    page = json.load(response)
for photo in page['items']:
    print(photo['photo_id'], photo['title'])
print('More pages:', page['next_cursor'] is not None)
PY
HTTP status: 200
p01 Morning, market
p02 Blue hour
p03 Window light
More pages: True
Le statut 200 signifie que la requête a réussi. L'objet JSON extérieur devient un dictionnaire. Sa valeur items est une liste de dictionnaires représentant les enregistrements ; ce n'est pas la réponse entière. Le null JSON devient None en Python. Ici, next_cursor est encore une chaîne : d'autres pages existent. Cette unité exporte volontairement une seule page ; la suivante termine le parcours.
Chaque enregistrement possède photo_id, title, category, orientation et credit. Un ID stable identifie l'enregistrement ; le titre est une étiquette d'affichage que différentes photos peuvent partager. Le contrat préparé est consultable dans /opt/commonlight/api-contract.md. cat affiche un fichier texte :
cat /opt/commonlight/api-contract.md
Ajoutez des fonctions réutilisables de requête et de sélection. urlencode encode un dictionnaire en chaîne de requête. Un curseur est un jeton opaque de continuation : copiez-le exactement, sans deviner un nombre ni interpréter ses caractères. L'argument facultatif cursor=None signifie que la première requête omet ce paramètre. Les pages suivantes peuvent contenir des caractères tels que +, / et =, qui doivent être encodés. Conservez la même URL et la même taille de page pendant un parcours.
La sélection compare exactement la catégorie et l'orientation, en respectant la casse. Une liste vide est valide si rien ne correspond. Dans la compréhension de liste, for photo in photos parcourt chaque enregistrement ; if ne conserve que ceux qui satisfont le filtre ; and exige que les deux comparaisons soient vraies. Le résultat est une nouvelle liste qui ne modifie pas les enregistrements reçus.
Le bloc suivant utilise cat avec > pour remplacer client.py par le texte Python littéral. Exécutez tout le bloc, y compris le dernier PY. Vous pouvez aussi ouvrir le fichier dans WebIDE, remplacer son contenu et l'enregistrer avec Ctrl+S (Cmd+S sur macOS). Ce bloc ne modifie que ce fichier.
cat > client.py <<'PY'
"""The request and selection functions are completed in the first guided lab."""
import json
from urllib.parse import urlencode
from urllib.request import urlopen

def request_page(endpoint, page_size, cursor=None):
    params = {'page_size': page_size}
    if cursor is not None:
        params['cursor'] = cursor
    with urlopen(endpoint + '?' + urlencode(params), timeout=3) as response:
        return json.load(response)

def select_photos(photos, category, orientation):
    return [photo for photo in photos
            if photo['category'] == category and photo['orientation'] == orientation]
def collect(endpoint, page_size):
    return request_page(endpoint, page_size)['items']
PY
L'interface de commande préparée appelle ces fonctions. Pour l'instant, collect est explicitement une version initiale limitée à une page. La vérification teste la requête avec une autre véritable source HTTP locale : la fonction doit donc utiliser l'URL fournie, pas une réponse de catalogue fixe. Elle ne crée pas votre CSV à votre place.
Si une commande indique qu'elle ne peut pas ouvrir un fichier Python, affichez le répertoire actuel avec pwd et les noms de fichiers avec ls, revenez à /home/labex/project avec le cd précédent, corrigez le nom et réessayez. Inutile de réinitialiser la VM.
Filtrer une page et enregistrer un vrai CSV
Dans cette étape, sélectionnez les photos de rue horizontales de la première page et ouvrez un CSV contenant leurs véritables valeurs. CSV signifie valeurs séparées par des virgules, mais une virgule dans un titre fait partie d'un seul champ. Un véritable outil d'écriture CSV l'entoure de guillemets ; concaténer des chaînes ou découper à chaque virgule détruit cette relation. UTF-8 préserve les noms comme Noé et les écritures non latines. newline='' laisse le module csv gérer les fins de ligne du CSV.
FIELDS définit les cinq noms d'en-tête. Chacun apparaît une seule fois ; une solution équivalente peut modifier l'ordre des enregistrements et des colonnes. DictWriter associe chaque valeur du dictionnaire à la colonne nommée. writeheader écrit l'en-tête et writerows les enregistrements sélectionnés, y compris un fichier ne contenant que l'en-tête si la sélection est vide. Le fichier est ouvert avec w, ce qui remplace son contenu. Cette première unité enregistre un échantillon de page ; la publication sûre d'une exportation complète sur plusieurs pages vient ensuite.
Dans le terminal de WebIDE, remplacez seulement storage.py :
cat > storage.py <<'PY'
"""Single-page CSV writer; safe publication is taught in the second guided lab."""
import csv

FIELDS = ['photo_id', 'title', 'category', 'orientation', 'credit']

def save_csv(output, photos):
    with open(output, 'w', encoding='utf-8', newline='') as stream:
        writer = csv.DictWriter(stream, fieldnames=FIELDS)
        writer.writeheader()
        writer.writerows(photos)
PY
Le programme préparé catalog.py accepte cinq arguments positionnels : URL de collection, catégorie, orientation, taille maximale de page et nom du fichier de sortie. --first-page choisit explicitement le mode échantillon. street et landscape sont les deux filtres exacts. Les guillemets du shell gardent ensemble une URL ou un nom de fichier contenant des caractères spéciaux.
python3 catalog.py 'http://127.0.0.1:8080/api/harbor' street landscape 3 page.csv --first-page
Saved 2 photos to page.csv
Lisez le résultat avec DictReader, qui reconstitue les champs entre guillemets. Cette lecture porte sur le fichier réellement enregistré, pas sur l'API :
python3 - <<'PY'
import csv
with open('page.csv', encoding='utf-8', newline='') as stream:
    for photo in csv.DictReader(stream):
        print(photo['photo_id'], '|', photo['title'], '|', photo['credit'])
PY
p01 | Morning, market | Mina Chen
p02 | Blue hour | Noé Silva
p03 est absent parce qu'il s'agit d'une photo verticale de la catégorie maison. La virgule du premier titre et le crédit accentué restent associés à leurs enregistrements.
Observez maintenant un refus HTTP volontaire. L'API accepte des tailles de page de 1–5 : 9 renvoie donc 400, et non une collection vide obtenue correctement. Exécutez le bloc ; la première commande doit échouer. $? contient le statut de sortie de la commande immédiatement précédente, et printf l'affiche avant qu'une autre commande ne le remplace.
python3 catalog.py 'http://127.0.0.1:8080/api/harbor' street landscape 9 rejected.csv --first-page
printf 'Exit status: %s\n' "$?"
HTTP request refused: 400. No complete export published.
Exit status: 1
HTTPError représente ce refus HTTP ; un échec de connexion est signalé séparément par Connection failed. Aucun des deux n'est un résultat valide sans correspondance. La commande préparée intercepte l'exception pour l'expliquer et termine avec un statut non nul. Revenez à une taille autorisée pour reprendre ; ne modifiez pas le service :
python3 catalog.py 'http://127.0.0.1:8080/api/harbor' street landscape 3 page.csv --first-page
Passez à Web 8080, choisissez Your exports, puis page.csv. Le tableau doit afficher les deux véritables enregistrements ci-dessus. Choisissez Download CSV et ouvrez le fichier téléchargé comme texte ou dans un lecteur CSV. Le téléchargement contient les octets du fichier enregistré ; la page ne récupère pas les enregistrements manquants à la source. Revenez à Catalog par la navigation de la page, puis à WebIDE pour la vérification. Vous avez créé un échantillon réutilisable d'une page, et le jeton de continuation non nul indique toujours qu'il ne s'agit pas du catalogue complet.
Résumé
Vous avez envoyé de véritables requêtes HTTP, distingué l'enveloppe d'une page JSON de ses enregistrements, sélectionné des valeurs exactes et écrit un CSV UTF-8 correctement délimité par des guillemets. Un refus HTTP, un échec de connexion et un résultat vide valide ont des significations différentes. Votre échantillon de deux enregistrements est utile ; l'unité suivante suit les curseurs restants pour terminer l'exportation.