Introduction
Un aperçu de trois cartes facilite l'exploration, mais l'éditrice a besoin de tous les enregistrements correspondants. Complétez le client de cette même API locale de démonstration pour suivre les jetons de continuation, préserver les identités entre les pages et publier un CSV seulement après la réussite du lot entier. Une page vide ou courte peut encore être suivie d'autres pages.
Cette unité démarre indépendamment avec les fonctions de requête et de sélection du premier laboratoire guidé. Vous devez avoir suivi celui-ci ou posséder des connaissances équivalentes en HTTP/JSON/CSV. Dans WebIDE, utilisez Terminal → New Terminal ; Web 8080 donne accès à la source, aux exportations enregistrées et aux commandes publiques Demo controls. Modifiez uniquement client.py et storage.py ; utilisez la bibliothèque standard et des fonctions auxiliaires internes à ces fichiers, pas de modules ou ressources supplémentaires. Livrez de vrais fichiers CSV ordinaires dans l'espace de travail, pas des liens symboliques. Préservez catalog.py, /opt/commonlight, les illustrations synthétiques et les enregistrements fictifs d'origine. L'auteur estime 55 minutes de lecture et de pratique ; cette durée n'a pas été mesurée auprès de débutants.
Suivre le protocole jusqu'à son terme
Dans cette étape, récupérez toutes les pages, y compris une page vide et une courte page de données, tout en conservant chaque ID une seule fois. Dans le terminal de WebIDE, entrez dans l'espace préparé indépendamment :
cd /home/labex/project
La fonction de requête gère déjà JSON, les curseurs encodés et un délai de trois secondes pour les opérations bloquantes. Examinez les règles préparées avec cat :
cat client.py
Le collect actuel ne renvoie qu'une page. Un page_size de 3 signifie au plus trois enregistrements, pas obligatoirement trois par page. Prévoyez cette petite séquence : trois enregistrements d'abord, puis aucun mais un autre curseur, puis un enregistrement accompagné d'un autre curseur. La page vide n'ajoute rien, mais ne prouve pas la fin. Exécutez cette séquence en utilisant uniquement les curseurs renvoyés :
python3 - <<'PY'
import client
url = 'http://127.0.0.1:8080/api/harbor'
first = client.request_page(url, 3)
second = client.request_page(url, 3, first['next_cursor'])
third = client.request_page(url, 3, second['next_cursor'])
print('Page 1 items:', len(first['items']))
print('Page 2 items:', len(second['items']))
print('Page 2 finished:', second['next_cursor'] is None)
print('Page 3 items:', len(third['items']))
print('Page 3 finished:', third['next_cursor'] is None)
PY
Page 1 items: 3
Page 2 items: 0
Page 2 finished: False
Page 3 items: 1
Page 3 finished: False
Seul next_cursor is None termine correctement un lot. Ne vous arrêtez pas parce que items est vide, qu'une page est courte ou qu'un nombre supposé de pages a été atteint.
Un même ID de photo peut réapparaître sur plusieurs pages avec des valeurs identiques. Un dictionnaire indexé par photo_id préserve le lien entre identité et ensemble des champs. setdefault(key, value) n'insère une valeur que si la clé est absente. Une seule copie est ainsi conservée ; un titre répété n'est pas un ID dupliqué. Les révisions contradictoires ne font pas partie de ce contrat de démonstration. Les deux ID distincts nommés Blue hour doivent rester présents.
Un ensemble mémorise des valeurs uniques. set() crée un ensemble vide, cursor in seen_cursors vérifie si un jeton est déjà présent et seen_cursors.add(cursor) enregistre un nouveau jeton. Cet ensemble garde les jetons de continuation déjà rencontrés. Après avoir testé la fin null légitime, refusez un jeton répété au lieu de boucler indéfiniment ou de considérer un cycle comme une fin. raise ValueError arrête la collecte avant que la commande puisse enregistrer un résultat incomplet. Les catalogues normaux préparés sont finis ; il n'y a ni plafond fixe de pages, ni nouvelle tentative ou reprise automatiques.
Remplacez client.py par le module complet ci-dessous. Comme précédemment, > remplace ce fichier et le here-document entre guillemets préserve le texte littéral. La requête et le filtre restent identiques ; la partie nouvelle est collect.
cat > client.py <<'PY'
"""The request and selection functions are completed in the first guided lab."""
import json
from urllib.parse import urlencode
from urllib.request import urlopen

def request_page(endpoint, page_size, cursor=None):
    params = {'page_size': page_size}
    if cursor is not None:
        params['cursor'] = cursor
    with urlopen(endpoint + '?' + urlencode(params), timeout=3) as response:
        return json.load(response)

def select_photos(photos, category, orientation):
    return [photo for photo in photos
            if photo['category'] == category and photo['orientation'] == orientation]
def collect(endpoint, page_size):
    photos = {}
    cursor = None
    seen_cursors = set()
    while True:
        page = request_page(endpoint, page_size, cursor)
        for photo in page['items']:
            photos.setdefault(photo['photo_id'], photo)
        cursor = page['next_cursor']
        if cursor is None:
            return list(photos.values())
        if cursor in seen_cursors:
            raise ValueError('Repeated cursor; catalog did not complete')
        seen_cursors.add(cursor)
PY
Lancez une collecte complète. Omettez --first-page, car cette option ne produit volontairement qu'un échantillon.
python3 catalog.py 'http://127.0.0.1:8080/api/harbor' street landscape 3 catalog.csv
Saved 5 photos to catalog.csv
Examinez les identités enregistrées plutôt que de vous fier à un nombre :
python3 - <<'PY'
import csv
with open('catalog.csv', encoding='utf-8', newline='') as stream:
    for photo in csv.DictReader(stream):
        print(photo['photo_id'], '|', photo['title'])
PY
p01 | Morning, market
p02 | Blue hour
p04 | The "quiet" lane
p08 | Blue hour
p09 | Last tram — 帰り道
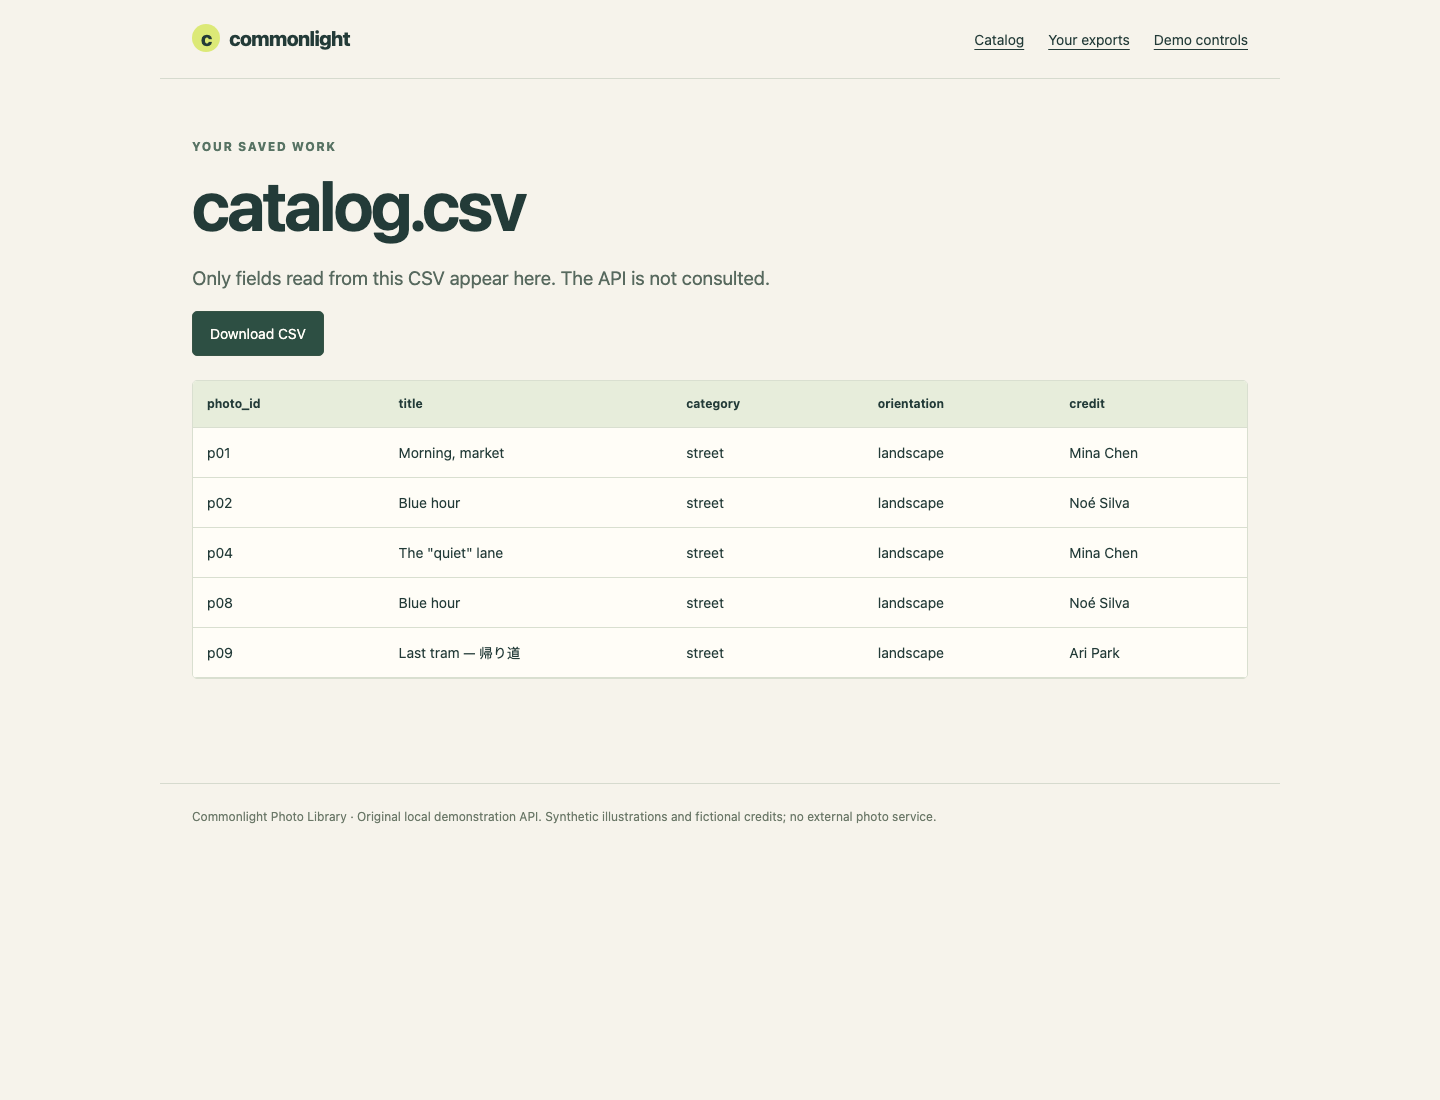
L'enregistrement final p09 est présent, p02 apparaît une fois et p08 conserve le même titre avec un ID différent. Examinez ces mêmes valeurs dans Web 8080 → Your exports → catalog.csv. Ce tableau ne lit que votre CSV : un fichier incomplet y resterait incomplet. Revenez à WebIDE pour la vérification. En cas de mauvais nom ou répertoire, utilisez pwd, ls et le cd précédent pour reprendre avant de réessayer.
Ne publier qu'une exportation complète
Dans cette étape, protégez la dernière exportation réussie lorsqu'une requête suivante, un cycle du protocole ou une écriture échoue. La collecte se termine déjà avant le début de l'enregistrement. L'écriture doit aussi attendre une réussite complète : ouvrir la destination finale avec w peut tronquer un bon fichier avant la fin de la nouvelle écriture.
Path(output) transforme le nom fourni en objet chemin. .parent désigne son répertoire et .name le nom final. NamedTemporaryFile crée un nom nouveau et unique, sans emprunter un voisin prévisible comme catalog.csv.tmp. dir=output.parent le place dans le répertoire cible pour que le remplacement reste sur le même système de fichiers. delete=False conserve le fichier après sa fermeture en vue du remplacement ; stream.name donne le nom alloué, mémorisé comme Path. Le bloc finally s'exécute après une réussite comme après une exception. exists() vérifie si le chemin temporaire existe encore ; unlink() ne supprime que ce nouveau fichier s'il subsiste. Après un remplacement réussi, le chemin temporaire a disparu : rien n'est supprimé. Une exception continue de remonter à la commande et provoque une sortie non nulle. Path.replace publie le fichier terminé après sa fermeture par le bloc with. Un remplacement POSIX réussi est atomique, mais ne promet ni persistance après une coupure de courant, ni transaction sur plusieurs fichiers, ni coordination d'écritures concurrentes. Un voisin .tmp existant et sans rapport ne doit jamais être écrasé ou supprimé.
Dans le terminal de WebIDE, remplacez storage.py. Les cinq champs CSV doivent apparaître chacun exactement une fois dans l'en-tête ; une implémentation équivalente peut utiliser une autre mise entre guillemets valide et un autre ordre de lignes ou de colonnes.
cat > storage.py <<'PY'
import csv
import tempfile
from pathlib import Path

FIELDS = ['photo_id', 'title', 'category', 'orientation', 'credit']

def save_csv(output, photos):
    output = Path(output)
    temporary = None
    try:
        with tempfile.NamedTemporaryFile(
            mode='w', encoding='utf-8', newline='',
            dir=output.parent, prefix='.' + output.name + '.',
            suffix='.tmp', delete=False
        ) as stream:
            temporary = Path(stream.name)
            writer = csv.DictWriter(stream, fieldnames=FIELDS)
            writer.writeheader()
            writer.writerows(photos)
        temporary.replace(output)
    finally:
        if temporary is not None and temporary.exists():
            temporary.unlink()
PY
Exécutez d'abord un lot normal avant de simuler une panne. sha256sum affiche une empreinte du contenu et le nom du fichier. Retenez cette empreinte ou gardez la sortie visible : le prochain lot en échec doit la laisser inchangée. Une écriture ratée doit aussi préserver le dernier fichier complet ; la vérification le teste dans un environnement isolé sans modifier votre espace de travail.
python3 catalog.py 'http://127.0.0.1:8080/api/harbor' street landscape 3 catalog.csv
sha256sum catalog.csv
Passez à Web 8080. Choisissez Demo controls, puis Enable middle-page failure. Vérifiez Middle-page failure ON.
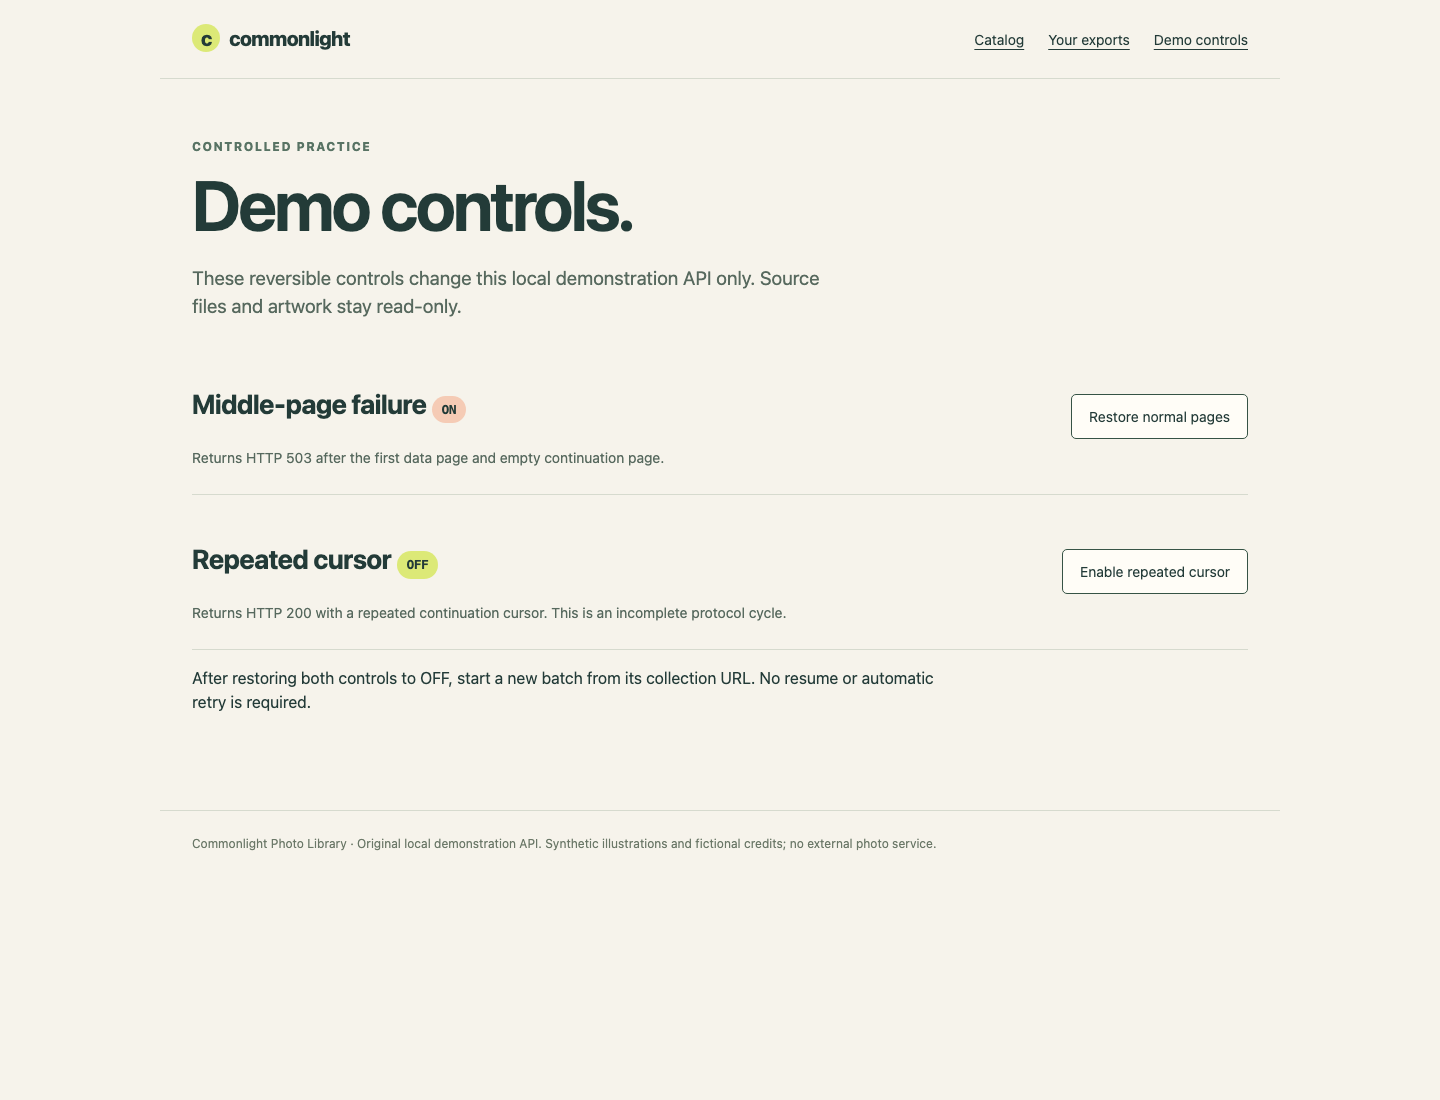
Utilisez la carte correspondant à la panne activée. Ce changement réversible est expressément autorisé et ne touche que la mémoire de l'API de démonstration ; les sources restent en lecture seule. Revenez à WebIDE et déclenchez cet échec volontaire. printf capture immédiatement $? :
python3 catalog.py 'http://127.0.0.1:8080/api/harbor' street landscape 3 catalog.csv
printf 'Exit status: %s\n' "$?"
sha256sum catalog.csv
HTTP request refused: 503. No complete export published.
Exit status: 1
...
Ici, HTTP 503 signifie que l'API de démonstration a refusé une requête de page intermédiaire. Ce n'est ni un échec de connexion ni un résultat vide réussi. L'empreinte doit rester identique et l'ancienne exportation de cinq lignes doit rester consultable. Une sortie non nulle ne suffit pas si le programme a déjà endommagé le fichier.
Dans Web 8080 → Demo controls, choisissez Restore normal pages pour la panne intermédiaire et confirmez OFF. Revenez à WebIDE et commencez un nouveau lot fini depuis l'URL de collection ; ne réutilisez pas un ancien curseur :
python3 catalog.py 'http://127.0.0.1:8080/api/harbor' street landscape 3 catalog.csv
Passez ensuite à Web 8080 → Demo controls et choisissez Enable repeated cursor. Confirmez Repeated cursor ON et le contrôle de panne sur OFF. Revenez à WebIDE :
python3 catalog.py 'http://127.0.0.1:8080/api/harbor' street landscape 3 catalog.csv
printf 'Exit status: %s\n' "$?"
Export failed: Repeated cursor; catalog did not complete
Exit status: 1
Ces réponses ont le statut HTTP 200, mais leur curseur répété est une erreur du protocole, pas une fin. La protection par ensemble empêche une boucle infinie et la publication. Dans Web 8080 → Demo controls, choisissez Restore normal pages dans la carte Repeated cursor, puis confirmez OFF ; les deux contrôles doivent maintenant être sur OFF. Revenez à WebIDE, relancez la commande correcte, puis essayez un filtre valide sans correspondance sous un nouveau nom de sortie :
python3 catalog.py 'http://127.0.0.1:8080/api/harbor' street landscape 3 catalog.csv
python3 catalog.py 'http://127.0.0.1:8080/api/harbor' missing landscape 2 empty.csv
Saved 5 photos to catalog.csv
Saved 0 photos to empty.csv
Le second résultat réussit et ne contient que l'en-tête ; il diffère des deux erreurs précédentes. Dans Web 8080 → Your exports, ouvrez empty.csv pour voir les cinq en-têtes sans ligne de données, puis ouvrez catalog.csv et choisissez Download CSV. Le véritable fichier enregistré de cinq enregistrements est votre livrable. Revenez à WebIDE pour la vérification. Conservez le programme et les sources préparées : la vérification lit le résultat réel et exécute des copies inchangées dans des tests HTTP réels isolés, avec d'autres URL, filtres, tailles et échecs d'écriture.
Résumé
Vous avez suivi des jetons opaques jusqu'à la fin null explicite, préservé des identités distinctes malgré des titres identiques et rejeté un cycle du protocole. Vous avez publié un CSV UTF-8 complet au moyen d'un fichier temporaire unique, tout en préservant le résultat correct précédent après les échecs. Le même programme accepte une autre collection et une autre sélection fournies.