Introduction
L'atelier dispose maintenant d'une frontière de prédiction honnête. Un petit modèle de régression améliore-t-il l'estimation du matériel par rapport à une médiane de fréquentation antérieure ? Vous ajusterez un Pipeline court, comparerez les deux méthodes sur les mêmes séances étiquetées et enregistrerez une véritable image comparative ainsi que des prédictions futures.
Vous devez connaître les fonctions Python, la sélection et les jointures pandas, les bases de la régression et de l'entraînement/test Scikit-learn et les notions initiales de Matplotlib. Le Guided Lab précédent explique l'échéance de sept jours et l'imputation apprise sur le seul entraînement. Ce lab prépare tous les fichiers indépendamment, y compris la séparation par identifiant/date terminée ; aucun fichier de la VM précédente n'est nécessaire. Toutes les données sont du matériel pédagogique synthétique original. Les 60 minutes sont une estimation de l'auteur.
Ajuster un petit Pipeline sur les séances antérieures
Dans cette étape, vous remplacerez un modèle séduisant utilisant des données postérieures à l'événement par un prédicteur réutilisable à sept jours.
Commencez dans WebIDE → Terminal → New Terminal. cd change le répertoire de travail de ce terminal. L'exécutable préparé ./python lance l'environnement du cours ; ./ choisit le lanceur du répertoire courant plutôt qu'un interpréteur système.
cd /home/labex/project/workshop-attendance
cat affiche les fichiers sans les modifier ; plusieurs noms en arguments les affichent à la suite.
cat season.json history.csv labels.csv future.csv
Chaque ligne historique est une séance identifiée par session_id. labels.csv associe actual_attendance par cette clé, dans un ordre indépendant. Les seules caractéristiques numériques autorisées sont booked_7d, un instantané enregistré exactement sept jours avant l'événement, et duration_minutes, déjà annoncée à cette échéance. Une cellule numérique vide indique une information manquante ; chaque caractéristique autorisée possède une observation d'entraînement non vide. Les identifiants et dates servent à l'association et à la séparation, pas aux entrées du modèle. final_bookings et scanned_entries surviennent pendant l'événement et divulguent des informations indisponibles sept jours avant.
La séparation terminée fige l'entraînement le 1er avril 2026 à 00:00 UTC et réserve à l'évaluation les événements historiques à partir du 12 avril. Les étiquettes d'entraînement sont connues à la fin du jour de chaque événement antérieur ; le dernier événement d'entraînement est ici le 8 mars. La première prédiction réservée intervient le 5 avril, avec l'instantané à sept jours de cet événement et le modèle déjà figé. On ne prétend pas que l'entrée du 5 avril soit disponible le 1er avril. Les fichiers d'instantanés ultérieurs rejouent leurs dates de prédiction respectives. future.csv n'a pas d'étiquettes réelles : ses événements de mai reçoivent des prédictions, pas des erreurs mesurées. Aucune ligne historique ne se trouve dans l'intervalle configuré. Le cours n'aborde ni réajustements glissants ni caractéristiques entièrement vides à l'entraînement.
cat split.py
Observez son merge par clé, ses frontières calendaires analysées et son tri chronologique. Il s'agit de la séparation terminée du cours précédent, fournie ici pour l'indépendance du lab. Conservez-la, toutes les entrées CSV/JSON, python, run.py, coursekit.py, show_results.py et les fichiers starter-*.py. Modifiez uniquement model.py, chart.py et vos résultats output/. Le model.py fourni commence par un modèle utilisant les scans : des résultats historiques parfaits en apparence ne rendraient pas valide ce choix d'information.
Un Pipeline enchaîne prétraitement et modèle. Pendant fit, l'imputeur apprend les moyennes des caractéristiques d'entraînement reçues, puis la régression apprend à partir de la matrice remplie. Pendant predict, le même imputeur transforme seulement les entrées ultérieures. Il ne s'ajuste jamais à nouveau sur l'ensemble réservé ou futur. LinearRegression ajuste une constante et des coefficients par moindres carrés ordinaires ; nous gardons ce petit modèle au lieu de régler de nombreuses alternatives.
Écrivez les deux fonctions réutilisables du modèle. FEATURES vaut exactement ['booked_7d', 'duration_minutes']. fit_model renvoie l'estimateur ajusté et la médiane de la cible d'entraînement. predict_events sélectionne les mêmes caractéristiques autorisées pour chaque table. La fonction provisoire evaluate sera complétée à l'étape suivante ; la phase fit ne l'appelle pas.
Le > du shell remplace le fichier. <<'PY' ouvre un here-document protégé : collez jusqu'à la dernière ligne contenant uniquement PY ; le shell enregistre littéralement le code Python. Vous pouvez aussi modifier model.py dans WebIDE Explorer et choisir File → Save.
cat > model.py <<'PY'
import numpy as np
from sklearn.impute import SimpleImputer
from sklearn.linear_model import LinearRegression
from sklearn.pipeline import make_pipeline
from coursekit import FEATURES


def fit_model(train):
    model = make_pipeline(SimpleImputer(strategy="mean"), LinearRegression())
    model.fit(train[FEATURES], train.actual_attendance)
    return model, float(train.actual_attendance.median())


def predict_events(model, events):
    return model.predict(events[FEATURES])


def evaluate(actual, predicted, baseline):
    raise NotImplementedError("Complete the continuous-error comparison")
PY
./python run.py fit
L'aperçu enregistré doit associer W-88 à une prédiction brute proche de 32.718, une fréquentation réelle 46 et une référence 24.5 ; W-09 doit avoir une prédiction proche de 62.236, une valeur réelle 74 et la même référence. Une sortie de régression peut être fractionnaire même si une séance accueille un nombre entier de personnes.
./python show_results.py fit
Ce sont des prédictions avant le résumé des erreurs. Elles ont été ajustées sans les étiquettes ultérieures. Modifier ces étiquettes doit changer les erreurs finales, pas les prédictions ajustées. Une caractéristique dont le coefficient appris est nul peut légitimement n'avoir aucune influence ; changer une entrée arbitraire ne change pas nécessairement une prédiction.
Comparer les erreurs continues sur le même ensemble réservé
Dans cette étape, vous calculerez des erreurs absolues à partir des vraies étiquettes réservées et comparerez leurs moyennes en personnes.
Continuez dans WebIDE, à /home/labex/project/workshop-attendance. Une erreur absolue est la grandeur de actual - predicted. np.abs la calcule élément par élément ; np.mean fait la moyenne du tableau obtenu. Pour une référence équitable, soustrayez la même médiane antérieure de la cible à chacune des mêmes étiquettes réelles réservées. Ne comparez jamais des ensembles d'événements différents et ne remplacez pas un résultat réel par une prédiction.
Utilisez les prédictions continues brutes pour toutes les erreurs et MAE. Arrondir d'abord la prédiction en nombre affiché de personnes modifie l'évaluation. Le programme auxiliaire affiche la MAE avec trois décimales dans la console pour la lecture, tout en enregistrant la valeur numérique non arrondie dans JSON.
Remplacez model.py par la version complète suivante. Elle conserve la logique d'ajustement et de prédiction et complète la fonction auparavant vide evaluate. Celle-ci renvoie les tableaux d'erreurs par événement et leurs moyennes ; le programme auxiliaire conserve les identifiants des mêmes lignes réservées en écrivant output/holdout.csv. Les vecteurs d'erreurs suivent l'ordre des positions des tableaux réels/prédits reçus. Des valeurs équivalentes de type tableau, y compris des Series pandas, sont acceptées dans cet ordre ; leurs index numériques ne sont pas les identifiants des séances.
cat > model.py <<'PY'
import numpy as np
from sklearn.impute import SimpleImputer
from sklearn.linear_model import LinearRegression
from sklearn.pipeline import make_pipeline
from coursekit import FEATURES


def fit_model(train):
    model = make_pipeline(SimpleImputer(strategy="mean"), LinearRegression())
    model.fit(train[FEATURES], train.actual_attendance)
    return model, float(train.actual_attendance.median())


def predict_events(model, events):
    return model.predict(events[FEATURES])


def evaluate(actual, predicted, baseline):
    model_errors = np.abs(actual - predicted)
    baseline_errors = np.abs(actual - baseline)
    return {
        "model_abs_error": model_errors,
        "baseline_abs_error": baseline_errors,
        "model_mae": float(np.mean(model_errors)),
        "baseline_mae": float(np.mean(baseline_errors)),
    }
PY
./python run.py evaluate
Résumé attendu dans la console :
Model MAE (people): 12.523
Baseline MAE (people): 35.500
./python show_results.py evaluate
Pour W-88, l'erreur du modèle est d'environ 13.282 personnes et celle de la référence vaut 21.5. Pour W-09, elles valent environ 11.764 et 49.5. Les moyennes non arrondies sont environ 12.5230751656 et exactement 35.5 personnes. La référence du petit exercice était 18 ; la médiane d'entraînement de cette saison complète est 24,5 car l'échantillon antérieur est différent.
Ici, le petit modèle présente une erreur plus faible sur ces deux événements réservés. C'est une indication concernant ce petit ensemble synthétique, pas une preuve de fiabilité future ni d'un effet causé par les réservations. Si un modèle correct a au contraire une MAE supérieure, la conclusion honnête est qu'il n'améliore pas cette comparaison. L'évaluation n'exige jamais que le modèle batte la référence ; les caractéristiques constantes ou sans information sont légitimes.
Livrer le graphique et les prévisions sans étiquettes
Dans cette étape, vous rendrez la comparaison réservée lisible et exporterez des estimations futures sans inventer de résultats réels.
Continuez dans WebIDE, à /home/labex/project/workshop-attendance. Votre graphique doit tracer une valeur par identifiant réservé pour chacune des séries Actual, Model et Baseline, à partir des valeurs brutes en personnes de la table comparative. Des lignes ou un nuage de points conviennent ; les libellés et identifiants en précisent le sens. Le PNG doit être lisible, mesurer au moins 600 sur 300 pixels et reproduire le même graphique visible lors d'une nouvelle exécution sur les mêmes données. Le style peut varier. L'évaluation vérifie les valeurs réellement tracées et l'image enregistrée, pas un manifeste déclarant le graphique correct. Chaque point métier doit rester dans les limites visibles des axes ; aucune série requise ne doit être cachée ni totalement transparente. Les points exactement sur une limite sont permis ; couleurs et plages peuvent différer.
Le backend Agg de Matplotlib écrit une image sans ouvrir de fenêtre de bureau. subplots crée figure et axes ; plot trace chaque série associée par identifiant. Les marqueurs suivants distinguent les cercles creux des valeurs réelles, les losanges du modèle et les croix en pointillés de la référence, même quand valeurs réelles et référence se superposent. tight_layout réserve de la place aux libellés. savefig écrit le vrai PNG et close libère la figure.
cat > chart.py <<'PY'
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt


def draw_comparison(result, destination):
    fig, ax = plt.subplots(figsize=(9, 5))
    ids = result.session_id
    ax.plot(ids, result.actual_attendance, "o-", color="#2454a6",
            markerfacecolor="white", markersize=8, label="Actual")
    ax.plot(ids, result.model_prediction, "D-", color="#c66a19", label="Model")
    ax.plot(ids, result.baseline_prediction, "+--", color="#24815d",
            markersize=11, label="Baseline")
    ax.set(xlabel="Workshop session", ylabel="People",
           title="Seven days ahead: holdout attendance")
    ax.legend()
    ax.grid(axis="y", alpha=0.2)
    fig.tight_layout()
    fig.savefig(destination, dpi=120)
    plt.close(fig)
PY
Exercez-vous d'abord avec une faute de frappe sans conséquence. La commande suivante utilise volontairement un nom de phase invalide et se termine par une erreur d'argument ; elle ne change pas vos résultats enregistrés.
./python run.py delvier
Le message énumère les choix autorisés. Corrigez l'orthographe et lancez la phase de livraison. Si vous obtenez plutôt une erreur de fichier introuvable, utilisez pwd et ls, revenez avec le cd initial et réessayez avec le bon nom de fichier.
./python run.py deliver
./python show_results.py deliver
Le lecteur charge les CSV/JSON enregistrés et décode le PNG réel ; il ne complète jamais les résultats à partir des entrées. Dans Explorer de WebIDE, développez output et ouvrez comparison.png. Le modèle doit être sous les deux points réels ; la référence reste à 24,5. Des marqueurs différents distinguent les séries de mêmes valeurs. Inspectez holdout.csv à côté de l'image pour relier chaque point à son identifiant et à son erreur réelle.
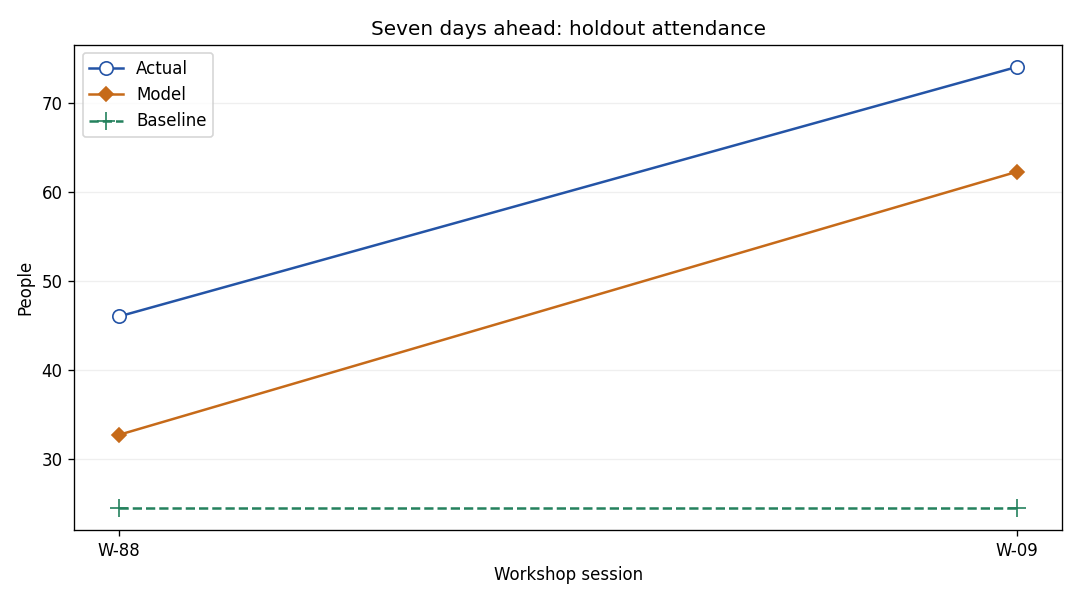
L'exemple fourni montre des fréquentations réelles de 46 et 74 pour W-88 et W-09, des prédictions proches de 32,718 et 62,236 et la référence en pointillés à 24,5. L'écart vertical d'un point réel à sa prédiction représente l'erreur absolue de l'événement. Votre style peut différer ; identifiants et valeurs sous-jacentes doivent correspondre.
forecast.csv contient uniquement session_id, la valeur brute model_prediction et display_people. F-6 a une prédiction proche de 19.119 et un nombre affiché de 19 ; F-101 une prédiction proche de 25.245 et un nombre affiché de 25. Pour le seul affichage, le programme auxiliaire ramène les estimations négatives à zéro puis arrondit les demis vers le haut avec floor(max(raw, 0) + 0.5). C'est une règle pratique de présentation, pas une modification du modèle évalué. La prédiction brute reste conservée, même négative ou fractionnaire.
Aucun effectif réel futur ni MAE future n'est fabriqué. Un modèle peut être figé avant l'arrivée d'un instantané de prédiction ultérieur : à l'échéance de sept jours de chaque événement de mai, réutilisez le modèle existant et les caractéristiques connues enregistrées de cet événement. La petite taille synthétique, les instantanés manquants et les comportements changeants limitent les conclusions. Le Challenge indépendant changera saison et dates tout en conservant cette démarche. Les implémentations numériques équivalentes, les autres ordres de sortie et les styles lignes/points sont acceptés avec une tolérance numérique de 1e-8 et des relations correctes par identifiant.
Résumé
Vous avez entraîné un petit Pipeline d'imputation/régression sur les séances antérieures, comparé ses erreurs réservées brutes à une référence médiane d'entraînement et enregistré un graphique associé par identifiant. Vous avez aussi exporté des estimations futures sans intégrer leurs résultats inconnus à l'évaluation. Une MAE réservée plus faible peut étayer cette comparaison limitée ; un résultat moins bon est tout aussi valable s'il est calculé honnêtement.