



Introduction
EARLY CRUMB prépare le retrait du pain du samedi. Commandes, paiements et annulations sont enregistrés séparément. Deux clients ont le même nom et une commande peut contenir plusieurs produits. Une transmission utile commence par relier les bons enregistrements, pas par deviner à partir des noms.
Dans ce laboratoire, vous préparerez les tables de commandes et de paiements, associerez chaque identifiant à son statut, puis créerez la liste des identifiants payés. Les annulations seront traitées dans le laboratoire indépendant suivant. Une connaissance élémentaire du terminal suffit ; tabulations, champs, tri et commandes sont expliqués avant utilisation. Toutes les personnes et données sont fictives.
Utilisez Workstation pour les commandes et Pickup Preview pour l’accueil préparé. L’aperçu présente les sources et un exemple d’étiquette. Il ne calcule pas vos réponses et ne crée pas vos fichiers.
Préparer les tables à rapprocher
Dans cette étape, vous préparerez des enregistrements sans en-tête et une liste triée des identifiants sans perdre de lignes d’articles. Commencez dans Pickup Preview.
Comprendre la transmission
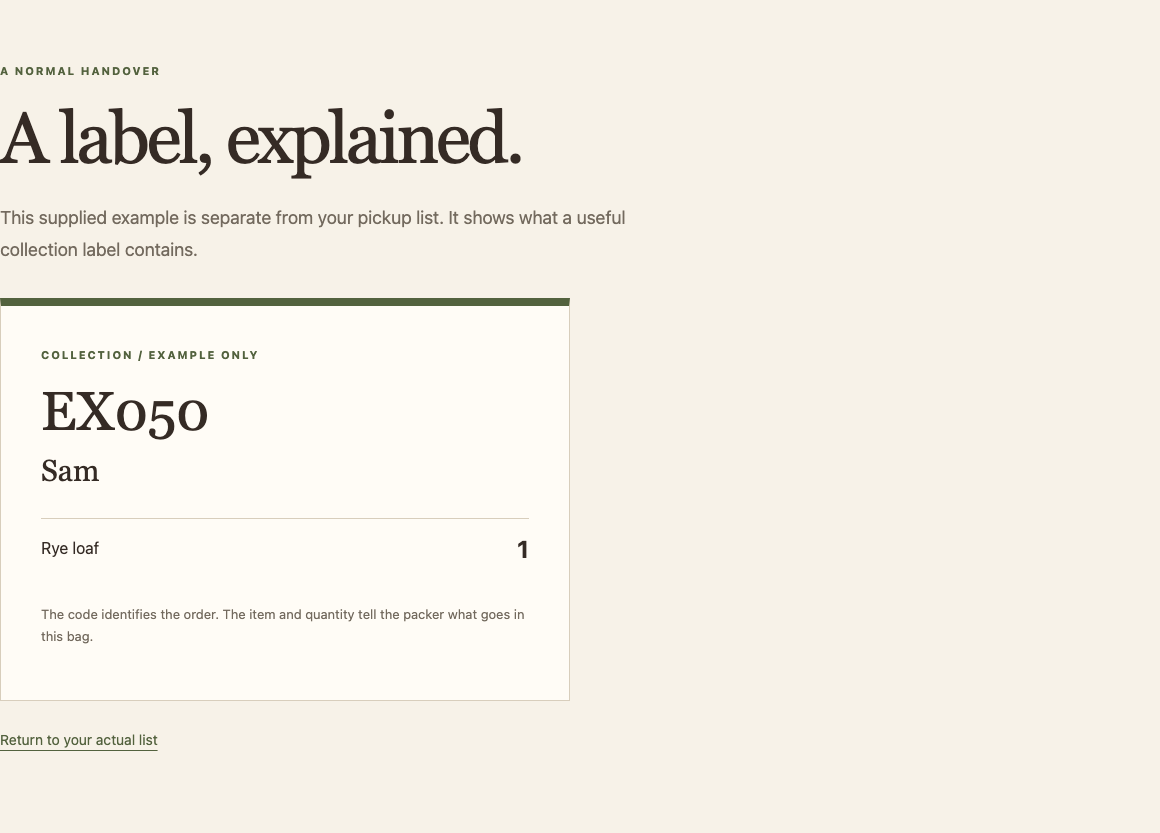
Ouvrez Sample label. EX050 appartient à Sam et contient un pain de seigle. C’est un exemple distinct, pas votre liste achevée. Le code identifie un sac ; le nom aide le client à se reconnaître ; chaque article et sa quantité indiquent quoi mettre dedans.
Ouvrez Records. La légende associe rye à Rye loaf et oat à Oat cookie. Retrouvez P101 dans orders.tsv : Alex a commandé deux pains de seigle et un biscuit à l’avoine. P102 est aussi au nom d’Alex, mais il s’agit d’une autre commande dont le paiement est unpaid. Une association par nom attribuerait le mauvais sac à la mauvaise commande. Utilisez order_id.
Lire les fichiers préparés
Passez à Workstation, qui démarre dans /home/labex/project/pickup. pwd affiche le répertoire courant ; ls liste ses entrées :
pwd
/home/labex/project/pickup
ls
Vous devez voir source et work. Les sources restent intactes ; work/ contient les intermédiaires que vous pouvez recréer. Un chemin comme source/orders.tsv est relatif à ce répertoire. Si vous le quittez, revenez avec :
cd /home/labex/project/pickup
cat affiche un fichier. Lisez les deux tables :
cat source/orders.tsv
cat source/payments.tsv
TSV signifie valeurs séparées par des tabulations. Chaque ligne est un enregistrement ; une tabulation sépare les champs. La première ligne est l’en-tête. Les quatre champs des commandes sont l’identifiant, le client, l’article et la quantité. Une commande peut avoir plusieurs lignes d’articles. Les paiements ont deux champs : identifiant et statut exact paid ou unpaid. Il y a au plus un paiement par commande. Le format fourni n’autorise ni tabulation ni retour à la ligne à l’intérieur d’une valeur.
P106 figure dans les commandes sans avoir de paiement. Une information absente ne signifie pas payé. Vous la garderez visible dans le rapprochement.
Séparer les en-têtes des enregistrements
tail -n +2 affiche à partir de la ligne 2. > enregistre la sortie dans un fichier, remplaçant la destination si elle existe. Cela ne modifie pas la source. N’utilisez jamais le même chemin en entrée et en sortie avec > : le shell viderait le fichier avant sa lecture.
tail -n +2 source/orders.tsv > work/orders.rows
tail -n +2 source/payments.tsv > work/payments.rows
Examinez les lignes d’articles :
cat work/orders.rows
P101 et P105 apparaissent chacun deux fois, car ils ont chacun deux produits. Gardez ces lignes. Un identifiant répété n’est pas automatiquement un doublon de données.
Préparer les clés de rapprochement
Une clé est le champ qui relie les enregistrements. cut -f1 sélectionne le premier champ délimité par des tabulations. Un tube | passe la sortie à la commande suivante. sort -u trie les lignes et ne garde qu’un exemplaire de chaque ligne identique. Ici, nous l’appliquons seulement à la liste d’identifiants, pas à la table d’articles.
Tri et rapprochement doivent employer le même ordre. LC_ALL=C choisit un ordre d’octets prévisible et export transmet ce réglage aux commandes suivantes. Il appartient à ce terminal ; réappliquez-le si vous en ouvrez un autre.
export LC_ALL=C
cut -f1 work/orders.rows | sort -u > work/order-ids.txt
cat work/order-ids.txt
P101
P102
P103
P104
P105
P106
Pour la table de paiement à deux champs, triez sur le premier en gardant le statut. TAB est une variable du shell contenant une tabulation : printf '\t' l’affiche et $(...) capture cette sortie. Les guillemets dans "$TAB" en font un unique argument de séparateur. -t définit le séparateur ; -k1,1 sélectionne seulement le premier champ comme clé de tri.
TAB=$(printf '\t')
sort -t "$TAB" -k1,1 work/payments.rows > work/payments.sorted.tsv
cat work/payments.sorted.tsv
Attendez P101 à P105 dans l’ordre, chacun avec son statut original. P106 n’a pas acquis de paiement. Vous disposez maintenant de six identifiants distincts et des cinq paiements prêts à rapprocher. Si un en-tête ou un statut est incorrect, recréez uniquement l’intermédiaire concerné à partir de sa source ; ne modifiez pas la source pour l’adapter.
Associer chaque commande à son statut de paiement
Dans cette étape, vous joindrez les deux entrées préparées en gardant visibles les commandes sans paiement. Commencez dans Workstation, avec le même terminal qu’à l’étape 1.
Savoir ce que doit signifier la correspondance
P101 doit être associé à paid, P102 à unpaid et P106 à la valeur explicite missing. Les noms ne participent pas à la correspondance. Une commande payée peut encore être annulée : le paiement seul ne décide pas de la liste finale.
join relie par défaut les premiers champs d’entrées triées. Une jointure interne ordinaire omet les identifiants sans correspondance. Ici, nous devons les voir aussi :
-t "$TAB"utilise la tabulation créée à l’étape 1.-a 1inclut également les enregistrements sans correspondance du premier fichier, la liste complète d’identifiants.-e missingremplace un champ de sortie absent par le motmissing.-o 1.1,2.2produit le champ 1 de l’entrée 1, l’identifiant, puis le champ 2 de l’entrée 2, le statut.1et2désignent les fichiers d’entrée, pas des numéros de ligne.
Exécutez cette commande complète sur une seule ligne. Elle produit deux champs :
join -t "$TAB" -a 1 -e missing -o 1.1,2.2 work/order-ids.txt work/payments.sorted.tsv > work/payment-match.tsv
cat work/payment-match.tsv
P101 paid
P102 unpaid
P103 paid
P104 paid
P105 paid
P106 missing
Les espaces visibles représentent des tabulations, pas les caractères littéraux barre oblique inverse et t. Vous devez voir six lignes. P106 reste présent parce que l’entrée de gauche contient tous les identifiants et que -a 1 garde ceux sans correspondance.
Lire le résultat avant de filtrer
P101 et P102 sont tous deux au nom d’Alex, mais leurs statuts diffèrent. P103 est également payé ; une annulation pourra l’exclure ensuite. P106 n’a pas de paiement : missing l’empêche de disparaître silencieusement de la comparaison.
Si join signale une entrée non triée, revenez à l’étape 1 et recréez les deux entrées avec le même LC_ALL=C. Ne masquez pas l’avertissement et ne supprimez pas une commande gênante. Après une reconnexion du terminal, rétablissez le répertoire et les deux réglages du shell de l’étape 1 avant de réessayer.
Une commande exécutée sans erreur ne suffit pas : comparez ces trois lignes importantes aux sources. Vous avez désormais un rapprochement complet permettant la décision suivante.
Sélectionner les commandes payées sans perdre leur identité
Dans cette étape, vous créerez le fichier d’identifiants payés et consulterez exactement ce que vous avez enregistré. Commencez dans Workstation.
Reconnaître un statut complet
paid et unpaid contiennent tous deux les lettres paid. Une recherche trop large inclurait P102 à tort. Il faut une tabulation suivie du statut complet en fin de ligne.
grep sélectionne les lignes correspondantes. Dans $'\tpaid$', la notation externe $'...' transforme \t en tabulation ; le dernier $ à l’intérieur signifie fin de ligne. Le champ de statut doit donc être exactement paid, plutôt que la fin de unpaid. cut -f1 ne conserve ensuite que les identifiants. La sortie est déjà triée puisque la table rapprochée l’est.
grep $'\tpaid$' work/payment-match.tsv | cut -f1 > paid-order-ids.txt
cat paid-order-ids.txt
P101
P103
P104
P105
P102 est impayé et P106 n’a pas de paiement enregistré, donc aucun n’appartient à cette liste. Gardez P103 à ce stade : le fichier représente les commandes payées, pas les commandes finales à préparer. Le retirer avant de considérer les annulations mélangerait deux décisions et donnerait un sens trompeur à l’intermédiaire.
Lire la sélection enregistrée
Passez à Pickup Preview. Sélectionnez Payment IDs dans la navigation. Cette page affiche paid-order-ids.txt sans calculer de réponse. Vous devez voir les quatre identifiants enregistrés. Suivez Compare with source records et contrôlez les paiements correspondants.
La page Pickup list peut encore indiquer qu’aucune liste n’est prête. C’est normal : vous avez sélectionné les paiements, pas produit la liste d’articles finale. Le laboratoire indépendant suivant utilise cette sélection pour exclure les annulations et garder chaque quantité admissible.
Si le fichier est vide ou contient P102, examinez work/payment-match.tsv et le motif de statut exact, puis relancez le filtre. Vous pouvez corriger et recréer ce résultat sans changer les sources.
Résumé
Vous avez préparé des enregistrements délimités par des tabulations, trié sur une clé commune, joint les paiements en conservant les absences et sélectionné des statuts payés exacts. Vous avez distingué identité de commande, nom du client et lignes d’articles. Le laboratoire indépendant suivant transforme cette sélection en une transmission utile pour le retrait.


