Introduction
Meridian Museum aide les visiteurs à trouver des objets par matériau et par histoire. Sa page d’accueil peut répondre avant que la recherche dans les collections soit utilisable. Chaque nouveau conteneur de recherche importe douze fiches fournies dans un index de mots en mémoire. Le flux est volontairement ralenti pour observer le chargement ; chaque conteneur de remplacement reconstruit son propre index depuis le début.
Vous écarterez du Service destiné aux visiteurs les Pods en chargement, accorderez assez de temps au démarrage et mettrez à jour l’importateur pendant que les réplicas existants continuent à fournir des résultats corrects. Vous devez savoir utiliser un terminal et connaître les images et conteneurs en cours d’exécution. Les objets Kubernetes, les correctifs YAML et les sondes sont présentés ici. Le cluster, l’image du musée en cache et le site complet sont préparés : aucune installation, aucun compte externe ni programmation d’application n’est nécessaire.
Utilisez Museum pour le parcours visiteur et Workstation pour les commandes. Travaillez uniquement dans l’espace de noms meridian et l’espace de travail du musée fourni. Ce cluster pédagogique à un seul nœud ne démontre ni la haute disponibilité ni l’absence garantie de requêtes en échec. Chaque lab démarre indépendamment.
Envoyer les visiteurs uniquement vers les Pods capables de rechercher
Vous distinguerez un processus en cours d’exécution d’un index utilisable et ajouterez une vérification de disponibilité adaptée à la tâche réelle du visiteur. Commencez dans Museum.
Essayer le parcours visiteur normal
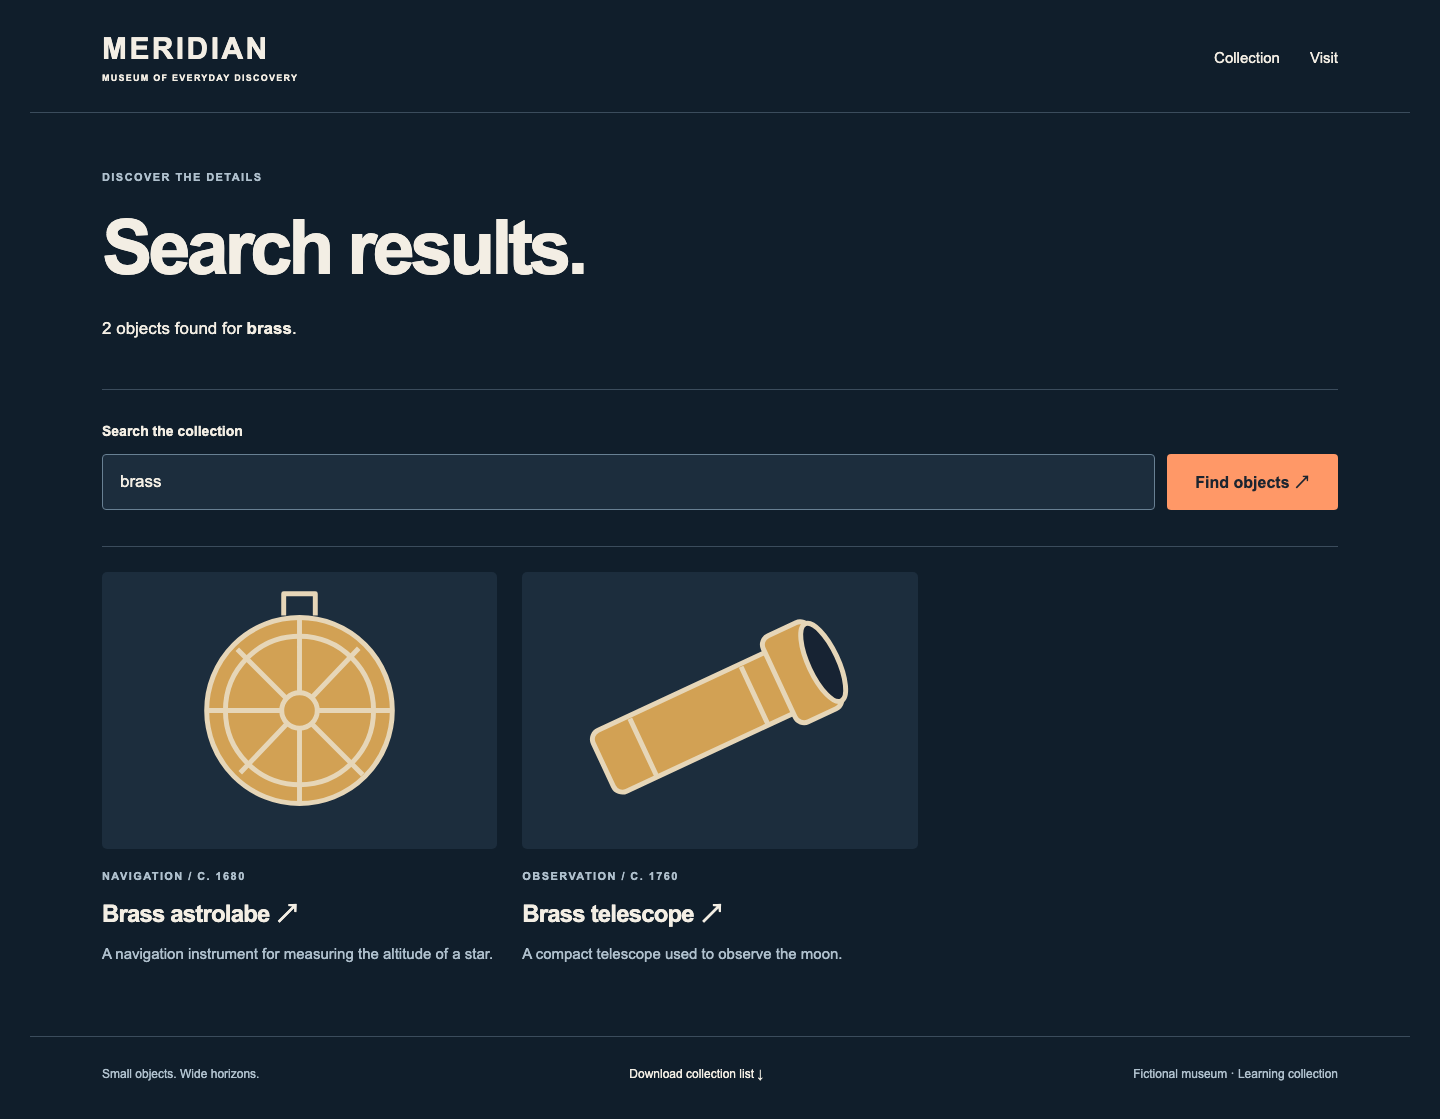
Saisissez brass dans Search the collection, puis sélectionnez Find objects ↗. Les résultats doivent contenir Brass astrolabe et Brass telescope, avec 2 objects found. Ouvrez Brass astrolabe : son histoire, son illustration et son emplacement Gallery 1 s’affichent. Sélectionnez See it at the museum ↗, lisez les horaires et les indications d’accès de plain-pied, puis Download collection list ↓. Ouvrez le CSV téléchargé : il contient douze objets, dont les deux instruments en laiton. Revenez à l’accueil avec MERIDIAN. Ces fonctions doivent rester opérationnelles après vos modifications.
Découvrir les trois objets Kubernetes
Passez dans Workstation. pwd affiche le répertoire courant et ls énumère ses fichiers :
pwd
ls
Le répertoire est /home/labex/project/museum. Un Pod exécute le conteneur du musée. Un Deployment maintient deux Pods réplicas et les remplace lorsque son modèle de conteneur change. Un Service offre aux visiteurs une adresse stable et dirige les requêtes vers les Pods sélectionnés et prêts. Les étiquettes relient ces objets : le Service sélectionne les Pods portant app: search. Un espace de noms regroupe les objets du cours ; chaque commande ci-dessous indique explicitement meridian.
kubectl demande au cluster de lire ou modifier des objets. get les énumère ; -n choisit l’espace de noms. cat affiche un fichier texte pour lire le candidat préparé :
kubectl get deployments,pods,services -n meridian
cat candidate.yaml
YAML utilise key: value, des espaces pour l’indentation et - pour les éléments de liste. Sous spec.template, le conteneur utilise l’image en cache meridian-museum:1. imagePullPolicy: Never impose cette image préparée sans téléchargement depuis un registre. IMPORT_INTERVAL: "2" espace les importations de deux secondes : douze fiches demandent environ 24 secondes. Les réplicas initiaux utilisaient un intervalle court pour permettre d’abord une recherche normale.
La mise à jour progressive préparée conserve replicas: 2, autorise un candidat supplémentaire (maxSurge: 1) et ne permet aucun réplica existant indisponible (maxUnavailable: 0). Ces paramètres reposent sur une disponibilité sincère : sans sonde, un processus peut être admissible avant que la recherche fonctionne. Conservez ces paramètres, images, étiquettes et le Service.
Observer le trafic prématuré dans ce Service pédagogique
Le navigateur utilise HTTP, un protocole de requête et réponse. Le statut 200 indique une réponse réussie ; 503 signifie que le serveur ne peut temporairement pas traiter la requête. Une page d’accueil fonctionnelle ne prouve pas qu’une autre requête, comme une recherche, réussira.
Ce musée n’a pas de vrais clients. Vous allez volontairement montrer la mise à jour risquée avant de l’améliorer. cp copie le candidat dans votre fichier modifiable search.yaml. apply -f soumet le YAML du fichier ; le changement du modèle de Pod déclenche une mise à jour. python3 exécute l’observateur fourni, en lecture seule ; --seconds 30 échantillonne le véritable Service visiteur pendant 30 secondes. Il vérifie que la réponse contient les deux objets en laiton. Lancez ensemble mise à jour et observation :
cp candidate.yaml search.yaml
kubectl apply -f search.yaml
python3 observe.py --seconds 30
Attendez-vous à des lignes HTTP=503 correct_search=false pendant le chargement des nouveaux conteneurs sans protection. Leur nombre varie. L’accueil fonctionne toujours ; la réponse de recherche 503 indique explicitement que la collection est en préparation. C’est une vraie réponse d’un Pod en chargement, pas une animation de succès ou d’échec prédéfinie.
rollout status attend la mise à jour du Deployment ; --timeout limite cette attente :
kubectl rollout status deployment/search -n meridian --timeout=90s
La commande peut annoncer une réussite même si aucune sonde de disponibilité ne protégeait la période de chargement précédente. Attendez les résultats normaux pour brass avant de poursuivre. Si une erreur de connexion remplace le statut HTTP, consultez le tableau des Pods et réessayez ; l’absence de serveur diffère d’un serveur répondant 503.
Ajouter une vérification de disponibilité métier
Une sonde de disponibilité détermine si ce Pod doit recevoir le trafic du Service. Un échec retire son admissibilité sans redémarrer le conteneur. Dans cette image, /health/process indique toujours le processus HTTP, tandis que /ready/search ne renvoie 200 que lorsque les douze fiches sont indexées et que la recherche brass connue fonctionne. L’accueil renvoie aussi 200 pendant l’importation : ni l’accueil ni le point de terminaison du processus ne conviennent ici.
patch modifie certains champs. --patch-file lit votre fichier ; --type=strategic fusionne le conteneur nommé search en conservant ses autres paramètres. La sonde envoie une requête HTTP au port nommé http de ce Pod, vérifie toutes les deux secondes et le marque non prêt après un échec. Écrivez le petit correctif ci-dessous. cat > readiness.yaml remplace ce fichier. <<'YAML' commence un here-document littéral : collez tout le bloc, y compris le délimiteur final YAML seul sur sa ligne. Gardez l’indentation :
cat > readiness.yaml <<'YAML'
spec:
  template:
    spec:
      containers:
        - name: search
          readinessProbe:
            httpGet:
              path: /ready/search
              port: http
            periodSeconds: 2
            failureThreshold: 1
YAML
kubectl patch deployment search -n meridian --type=strategic --patch-file readiness.yaml
python3 observe.py --seconds 30
Les recherches correctes doivent continuer via les réplicas existants pendant l’importation du nouveau réplica.
Un EndpointSlice décrit les adresses réelles des Pods du Service et leur disponibilité. -l filtre par l’étiquette du nom de service ; -o jsonpath extrait les seuls champs d’adresse et ready de la réponse structurée. L’expression fournie parcourt les points de terminaison et affiche ces champs ; elle ne fait que lire l’état. Inspectez Pods et adresses :
kubectl get pods -n meridian
kubectl get endpointslices -n meridian -l kubernetes.io/service-name=museum -o jsonpath='{range .items[].endpoints[*]}{.addresses[0]} ready={.conditions.ready}{"\n"}{end}'
kubectl rollout status deployment/search -n meridian --timeout=90s
kubectl get pods -n meridian
Pendant l’importation, un nouveau Pod peut apparaître 0/1 Running avec une adresse ready=false. Les points de terminaison prêts existants servent toujours les recherches. Une fois le chargement terminé, le candidat devient prêt et le remplacement continue. Si vous manquez cet état bref, les étapes suivantes offrent une fenêtre plus longue.
Terminez avec exactement deux Pods 1/1 Running. Un ancien Pod Terminating peut subsister brièvement après la réussite de la mise à jour ; attendez et répétez get pods jusqu’à sa disparition. Dans Museum, refaites la recherche brass et ouvrez l’astrolabe. En cas d’erreur YAML, corrigez et réappliquez le correctif. Pour un chemin de sonde mal orthographié, remplacez uniquement le chemin dans le même correctif et réappliquez-le. Ne supprimez aucun autre espace de noms et ne raccourcissez pas l’importation pour masquer une erreur.
Accorder assez de temps au démarrage de l’importateur
Vous distinguerez l’attente de disponibilité d’un échec de démarrage et définirez un budget d’après l’importation réelle. Commencez dans Workstation.
Une sonde de démarrage limite le temps d’initialisation d’un nouveau conteneur. Tant qu’elle n’a pas réussi, Kubernetes suspend les vérifications de disponibilité. Lorsque les échecs atteignent le seuil, kubelet redémarre le conteneur. Cette sonde est facultative ; un budget insuffisant peut empêcher une application autrement fonctionnelle de devenir prête. Elle ne remplace pas la disponibilité après le démarrage.
Observer un budget insuffisant
startup-short.yaml est un exemple pédagogique fourni. L’échec de la sonde demande un redémarrage, mais l’arrêt peut retarder l’augmentation du compteur visible. La prochaine attente côté client dure 60 secondes pour observer cette différence. Lisez l’exemple avant de l’appliquer :
cat startup-short.yaml
kubectl patch deployment search -n meridian --type=strategic --patch-file startup-short.yaml
kubectl rollout status deployment/search -n meridian --timeout=60s
La commande de mise à jour doit échouer avec error: timed out waiting for the condition. Son véritable code de sortie est non nul. Continuez dans ce terminal interactif. L’exemple vérifie toutes les deux secondes et ne permet que deux échecs, soit environ quatre secondes de démarrage. Cela ne suffit pas aux 24 secondes d’importation.
Lisez les indices réels. logs affiche la sortie de l’application ; --prefix identifie chaque Pod et --tail=4 limite chaque journal aux quatre dernières lignes. Un sélecteur demande tous les Pods de recherche. get events lit les observations du cluster ; --field-selector reason=Unhealthy les limite aux contrôles de santé en échec :
kubectl get pods -n meridian
kubectl logs -n meridian -l app=search --prefix --tail=4
kubectl get events -n meridian --field-selector reason=Unhealthy
Le nouveau Pod reste non prêt et son compteur RESTARTS devrait augmenter. Il peut afficher CrashLoopBackOff, signe que Kubernetes retarde la prochaine tentative. Si le tableau indique encore zéro malgré des échecs de démarrage enregistrés, attendez puis répétez get pods avant de changer le budget : le tableau est une observation instantanée et l’arrêt prend du temps. Chaque redémarrage détruit l’index en mémoire du conteneur ; son remplaçant réimporte donc les fiches.
Une ligne index_complete tardive provenant d’un conteneur dont la sonde a déjà échoué n’annule pas son redémarrage en attente et n’en fait pas un backend prêt du Service. Lisez ensemble compteur de redémarrages et événements d’échec de démarrage. Les anciens Pods restent 1/1 et servent leurs index complets.
Dans Museum, recherchez brass. Les résultats restent corrects grâce aux réplicas prêts existants du Service. La mise à jour bloquée n’a pas été automatiquement annulée : le Deployment demande toujours le candidat défectueux. Le maintien de l’ancien service ne signifie pas que la mise à jour est terminée.
Calculer et appliquer un budget utile
Revenez dans Workstation. Douze fiches à deux secondes demandent environ 24 secondes. Prenez ici 60 secondes : cela couvre aussi la prochaine importation de 36 secondes et une marge pédagogique de 12 secondes. periodSeconds × failureThreshold est une approximation de planification, pas une garantie de délai ; ordonnancement, expiration des sondes et charge réelle ajoutent des variations. En production, mesurez le démarrage et choisissez une marge réfléchie.
Utilisez la même méthode par fichier de correctif. Gardez le véritable chemin métier et le port nommé :
cat > startup.yaml <<'YAML'
spec:
  template:
    spec:
      containers:
        - name: search
          startupProbe:
            httpGet:
              path: /ready/search
              port: http
            periodSeconds: 2
            failureThreshold: 30
YAML
kubectl patch deployment search -n meridian --type=strategic --patch-file startup.yaml
kubectl rollout status deployment/search -n meridian --timeout=120s
kubectl get pods -n meridian
Cela crée des Pods de remplacement avec les paramètres corrigés. Chacun doit finir son chargement sans redémarrage ; le tableau final doit contenir deux Pods 1/1 Running avec RESTARTS 0. Attendez la disparition des anciens Pods en cours d’arrêt et répétez le tableau si nécessaire. La disponibilité continue à contrôler le trafic après le démarrage.
Si la mise à jour reste bloquée, lisez les mêmes journaux et événements, comparez chemin et budget dans votre fichier, corrigez puis réappliquez. Supprimer les Pods ne corrige pas le modèle du Deployment : ils seraient recréés avec les mêmes paramètres fautifs. Distinguez le budget de sonde de 60 secondes de --timeout=120s, qui limite seulement l’attente du client.
Maintenir la recherche pendant une mise à jour plus lente
Vous appliquerez une importation plus lente et évaluerez la mise à jour avec les réponses du Service et les points de terminaison prêts. Commencez dans Workstation.
kubectl set env change une variable d’environnement dans le modèle de conteneur du Deployment. Cela déclenche des Pods de remplacement, sans modifier l’environnement des conteneurs déjà actifs. Fixez l’intervalle à trois secondes. Les douze fiches demandent désormais environ 36 secondes, dans le budget de démarrage de 60 secondes :
kubectl set env deployment/search -n meridian IMPORT_INTERVAL=3
kubectl get pods -n meridian
kubectl get endpointslices -n meridian -l kubernetes.io/service-name=museum -o jsonpath='{range .items[].endpoints[*]}{.addresses[0]} ready={.conditions.ready}{"\n"}{end}'
python3 observe.py --seconds 45
Le nouveau Pod devrait être 0/1 Running pendant l’importation. Les adresses prêtes existantes continuent à renvoyer les bons résultats brass. L’observateur utilise le même Service NodePort que Museum ; il ne sélectionne jamais un Pod particulier en bon état. Lors de l’exécution observée, les requêtes protégées sont restées correctes. Un échantillon fini ne garantit pas l’absence d’échec dans toutes les conditions réelles du réseau, de l’application ou du cluster.
Attendez la fin de la mise à jour et inspectez l’état final :
kubectl rollout status deployment/search -n meridian --timeout=120s
kubectl get pods -n meridian
kubectl get endpointslices -n meridian -l kubernetes.io/service-name=museum -o jsonpath='{range .items[].endpoints[*]}{.addresses[0]} ready={.conditions.ready}{"\n"}{end}'
Après la disparition de tout ancien Pod Terminating, exactement deux Pods actuels doivent être prêts sans redémarrage, avec leurs deux adresses ready=true. Un ancien réplica sain est utile pendant l’importation, mais la mise à jour finale doit réellement converger vers la nouvelle révision.
Vérifier tout le service visiteur
Dans Museum, revenez à l’accueil avec MERIDIAN et recherchez à nouveau brass. Les deux instruments doivent apparaître ; ouvrez le télescope et suivez son lien de visite. Recherchez volcano : la page doit indiquer qu’aucun objet n’a été trouvé sans échouer. Ouvrez Collection, consultez un objet autre qu’un instrument en laiton et téléchargez la liste depuis Visit. Vérifiez les douze objets ainsi que les illustrations et la navigation conservées.
Dans Workstation, curl demande une URL ; -sS masque la progression mais affiche les erreurs de connexion. 127.0.0.1 désigne cette instance pédagogique et le port 30081 appartient au véritable Service du musée. Les guillemets maintiennent l’URL de recherche dans un seul argument shell :
curl -sS 'http://127.0.0.1:30081/search?q=brass'
Lisez les deux bons titres dans le HTML, pas seulement un code HTTP réussi. Si une vérification arrive pendant l’arrêt des anciens Pods, attendez et réessayez ; ne retirez pas les sondes et ne diminuez pas la durée d’importation. Conservez cluster, image fournie, Service et douze fiches sources. Votre résultat associe une disponibilité métier sincère, un temps de démarrage suffisant et une mise à jour terminée qui préserve l’expérience du musée.
Résumé
Vous avez relié la disponibilité à un véritable index de collection, observé l’échec et le redémarrage d’un candidat avec une sonde de démarrage trop courte, puis calculé un délai utile. Vous avez mis à jour l’importateur cadencé pendant que les réplicas prêts existants servaient les recherches, puis vérifié les Pods actuels, les points de terminaison du Service et le parcours visiteur complet. Processus actif, backend prêt et mise à jour terminée sont des faits distincts ; cet exercice à un seul nœud ne démontre ni la haute disponibilité en production ni l’absence d’échecs.