Introduction
Lorsqu’un modèle d’IA prépare une réponse plus longue, attendre le résultat complet peut donner l’impression que l’application est bloquée. Le streaming permet à l’application de recevoir de petites portions dès qu’elles sont prêtes. C’est comparable à la lecture d’un message pendant que son auteur est encore en train de l’écrire : le travail global reste sensiblement le même, mais le texte utile apparaît plus tôt.
Ce lab utilise les Server-Sent Events (SSE), un format texte permettant d’envoyer une suite d’événements dans une seule réponse HTTP. Chaque événement Workers AI commence par data:. Les événements texte contiennent une partie de la réponse générée et un dernier événement data: [DONE] indique que le flux s’est terminé normalement. Une pause entre deux événements signifie seulement que le modèle travaille encore ; sans signal de fin, l’application ne peut pas distinguer une réponse lente d’une connexion qui ne se terminera jamais.
Vous allez créer POST /help, diffuser une réponse Llama hébergée par Cloudflare vers un client en ligne de commande fourni, puis tester deux modes de fin : la fin normale et l’annulation volontaire après la première portion utile. L’annulation signifie que le client n’a plus besoin du reste de la réponse et ferme le traitement au lieu de laisser une connexion inutilisée ouverte. Vous utiliserez également des tests déterministes pour vérifier qu’un échec au démarrage du modèle devient une erreur limitée dans le temps et qu’un flux interrompu se termine au lieu de rester bloqué.
Il s’agit du deuxième lab du cours. Vous devez savoir qu’un Cloudflare Worker est du code applicatif exécuté sur le réseau Cloudflare et qu’un binding AI expose Workers AI via env.AI. Si vous avez accédé directement à ce lab, terminez d’abord Connect LabEx to Your Cloudflare Account afin d’apprendre à utiliser le terminal de la VM, à autoriser Wrangler, à confirmer votre compte d’apprentissage et à enregistrer son identifiant de compte.
Le lab utilise @cf/meta/llama-3.3-70b-instruct-fp8-fast et de petites questions synthétiques. Les comptes Workers Free disposent actuellement d’une allocation quotidienne partagée de 10 000 Neurons. L’inférence locale contacte également Cloudflare et consomme cette allocation. Si l’allocation est épuisée ou si le modèle manque de capacité, arrêtez-vous au lieu d’envoyer des requêtes répétées ; l’application doit signaler une erreur terminale plutôt que rester bloquée.
La configuration installe Node.js 22.22.0 et Wrangler 4.132.0, installé au niveau du projet, dans /home/labex/project/help-stream. Elle fournit le client SSE, les fixtures déterministes et les vérifications indépendantes. La configuration ne vous connecte pas, n’appelle aucun modèle, ne déploie aucun Worker et ne crée aucune ressource cloud. Gardez cette VM ouverte jusqu’à la suppression du Worker temporaire et à la vérification de la déconnexion.
Autoriser la VM et configurer le Worker de streaming
Dans cette étape, vous allez autoriser cette nouvelle VM et configurer le Worker temporaire de streaming. Votre connexion existante au Dashboard ne donne pas automatiquement aux commandes du terminal l’autorisation de gérer le compte d’apprentissage.
Accédez au projet préparé et vérifiez la version épinglée de Wrangler :
cd /home/labex/project/help-stream
npx wrangler --version
Vous devez obtenir 4.132.0. Demandez uniquement les autorisations nécessaires ici. L’accès en écriture à Workers Scripts permet de gérer le Worker temporaire, l’accès en écriture à Workers AI permet à son binding d’appeler le modèle, et les deux portées de lecture identifient le compte sélectionné. Wrangler 4.132.0 vérifie également les dépendances des bindings KV lors de la suppression d’un Worker ; la portée limitée d’écriture KV permet donc à cette commande de nettoyage d’aller jusqu’au bout, même si ce lab ne crée aucune donnée KV.
npx wrangler login --device --browser=false --scopes account:read user:read workers_scripts:write workers_kv:write ai:write
Ouvrez le lien affiché, saisissez le code de l’appareil actuel, vérifiez le compte et les autorisations, puis autorisez le compte d’apprentissage. Background Access peut également apparaître, car Wrangler continue son exécution après la fermeture du navigateur. Revenez au terminal et attendez le message de réussite, puis affichez les informations d’identité structurées :
npx wrangler whoami --json
Vérifiez loggedIn: true, puis lisez le name et l’id du compte prévu. Générez un nom unique pour le Worker temporaire :
RUN="labex-c07-a02-$(openssl rand -hex 6)"
printf '%s\n' "$RUN"
Remplacez YOUR_ACCOUNT_ID ci-dessous par l’identifiant réel de ce compte :
cat > wrangler.jsonc <<JSON
{
  "\$schema": "./node_modules/wrangler/config-schema.json",
  "name": "$RUN",
  "account_id": "YOUR_ACCOUNT_ID",
  "main": "src/index.js",
  "compatibility_date": "2026-09-16",
  "compatibility_flags": ["enable_request_signal"],
  "workers_dev": true,
  "preview_urls": false,
  "observability": {
    "enabled": true,
    "head_sampling_rate": 1
  },
  "ai": {
    "binding": "AI",
    "remote": true
  }
}
JSON
Le binding AI sera disponible via env.AI. remote: true signifie que le développement local utilise tout de même le modèle cloud réel. enable_request_signal permet à request.signal de signaler la déconnexion du client ; le Worker peut ainsi enregistrer et traiter le signal d’annulation. L’observabilité enregistre les événements du cycle de vie que vous examinerez plus tard. Aucun Worker n’a encore été déployé et aucune inférence n’a encore été exécutée.
Examiner le binding AI et le client SSE
Dans cette étape, vous allez connecter le binding AI au client SSE fourni avant d’écrire le Worker. Le modèle est le producteur, le Worker transfère les octets et client.mjs est le consommateur. La séparation de ces rôles permet de déterminer clairement quel composant doit arrêter le traitement.
Générez les types d’environnement du Worker :
npx wrangler types
grep -A4 'interface __BaseEnv_Env' worker-configuration.d.ts
Recherchez AI: Ai. Cela signifie que le binding configuré sera disponible dans le gestionnaire via env.AI ; il ne s’agit pas d’une clé API enregistrée dans le code source.
Examinez maintenant les résultats terminaux produits par le client fourni :
grep -nE 'chunk:|complete chunks=|cancelled after|stream_error:' client.mjs
Le client lit la réponse portion par portion. Une ligne chunk: affiche le nouveau texte généré. complete apparaît uniquement après data: [DONE]. Le mode d’annulation ferme le lecteur après la première portion non vide. stream_error indique une erreur terminale, notamment un dépassement du délai de 45 secondes ; ce délai constitue une limite de sécurité et ne prédit pas que chaque réponse du modèle prendra aussi longtemps.
Un événement SSE est du texte brut séparé par une ligne vide. Un flux réussi typique ressemble à ceci :
data: {"response":"First piece"}

data: {"response":" and another piece."}

data: [DONE]
Les limites entre les portions sont des détails du transport : un événement peut contenir un mot, une ponctuation ou un fragment plus long. La logique applicative doit combiner les chaînes response et attendre [DONE], sans supposer un nombre ou une taille fixe de portions.
Créer un endpoint de streaming surveillé
Dans cette étape, vous allez créer l’endpoint de streaming et surveiller son cycle de vie. Le Worker demandera au modèle un flux avec stream: true, puis exposera ce même protocole SSE au client. Il ne stockera pas d’abord toute la réponse en mémoire. Un petit wrapper surveille le cycle de vie du flux : la fin normale ferme le flux, l’annulation annule le lecteur en amont et une erreur de flux termine la réponse.
Créez le point d’entrée du Worker :
cat > src/index.js <<'JS'
const MODEL = "@cf/meta/llama-3.3-70b-instruct-fp8-fast";
const MAX_QUESTION = 800;

function json(data, status = 200) {
  return Response.json(data, { status });
}

async function readQuestion(request) {
  const contentType = request.headers.get("content-type") || "";
  if (!contentType.toLowerCase().includes("application/json")) {
    return { error: json({ error: "json_required" }, 415) };
  }

  const raw = await request.text();
  if (raw.length > 2048) {
    return { error: json({ error: "question_too_large" }, 413) };
  }

  let body;
  try {
    body = JSON.parse(raw);
  } catch {
    return { error: json({ error: "invalid_json" }, 400) };
  }

  const question = typeof body?.question === "string" ? body.question.trim() : "";
  if (!question) {
    return { error: json({ error: "invalid_question" }, 400) };
  }
  if (question.length > MAX_QUESTION) {
    return { error: json({ error: "question_too_large" }, 413) };
  }
  return { question };
}

function monitor(upstream, details) {
  const reader = upstream.getReader();
  let terminal = false;

  return new ReadableStream({
    async pull(controller) {
      try {
        const { done, value } = await reader.read();
        if (done) {
          terminal = true;
          console.log(JSON.stringify({ event: "help_stream_completed", ...details }));
          controller.close();
          return;
        }
        controller.enqueue(value);
      } catch {
        terminal = true;
        console.error(JSON.stringify({ event: "help_stream_failed", ...details }));
        controller.error(new Error("model stream interrupted"));
      }
    },
    async cancel(reason) {
      if (!terminal) {
        terminal = true;
        console.log(JSON.stringify({ event: "help_stream_cancelled", ...details }));
      }
      await reader.cancel(reason);
    }
  });
}

async function streamHelp(request, env) {
  const parsed = await readQuestion(request);
  if (parsed.error) return parsed.error;

  const requestId = crypto.randomUUID();
  const details = { requestId, model: MODEL };
  request.signal.addEventListener("abort", () => {
    console.log(JSON.stringify({ event: "help_client_disconnected", ...details }));
  }, { once: true });

  try {
    const upstream = await env.AI.run(MODEL, {
      messages: [
        {
          role: "system",
          content: "Answer the support question in at most four short sentences. Give safe, practical steps and do not invent account details."
        },
        { role: "user", content: parsed.question }
      ],
      stream: true,
      max_tokens: 160,
      temperature: 0.2
    });

    if (!(upstream instanceof ReadableStream)) {
      throw new Error("stream unavailable");
    }

    console.log(JSON.stringify({ event: "help_stream_started", ...details }));
    return new Response(monitor(upstream, details), {
      headers: {
        "content-type": "text/event-stream; charset=utf-8",
        "cache-control": "no-store",
        "x-request-id": requestId
      }
    });
  } catch {
    console.error(JSON.stringify({ event: "help_stream_start_failed", ...details }));
    return json({ error: "model_unavailable", requestId }, 502);
  }
}

export default {
  async fetch(request, env) {
    const url = new URL(request.url);
    if (request.method === "GET" && url.pathname === "/health") {
      return json({ status: "ok" });
    }
    if (request.method === "POST" && url.pathname === "/help") {
      return streamHelp(request, env);
    }
    return json({ error: "not_found" }, 404);
  }
};
JS
Le code enregistre les identifiants de requête et les événements du cycle de vie, mais jamais la question ni la réponse générée. Un identifiant de requête relie une réponse client à une entrée de journal sans copier le contenu d’assistance dans les données d’observabilité. La réponse d’erreur masque également les détails internes du fournisseur ; les opérateurs peuvent utiliser le journal du cycle de vie tandis que les clients reçoivent le contrat stable model_unavailable.
Lancez les tests déterministes. Leur faux binding AI émet des événements contrôlés, échoue avant le streaming, prend en charge l’annulation et interrompt un flux sans consommer de Neurons :
node --test test/worker.test.mjs
Vous devez obtenir six tests réussis. Créez ensuite le bundle du Worker réel sans le déployer :
npx wrangler deploy --dry-run
Les tests démontrent le comportement de l’application avec un timing contrôlé. L’exécution à blanc vérifie que le code source et la configuration sont correctement regroupés. Aucun des deux ne prouve que le modèle cloud est actuellement disponible ; l’étape suivante utilise un flux réel.
Observer un flux local réel
Dans cette étape, vous allez observer un flux réel via un processus Worker exécuté depuis la VM. « Local » décrit le gestionnaire de requêtes ; l’inférence du modèle s’effectue toujours dans le compte sélectionné et compte dans son allocation quotidienne.
Démarrez Wrangler en arrière-plan et enregistrez son identifiant de processus :
npx wrangler dev --port 8787 > .labex/dev.log 2>&1 &
echo $! > .labex/dev.pid
Attendez que la route de vérification, qui n’utilise pas l’IA, soit disponible :
for attempt in $(seq 1 30); do
  if curl --silent --fail http://127.0.0.1:8787/health; then
    break
  fi
  sleep 1
done
Utilisez maintenant le client fourni avec une petite question synthétique :
node client.mjs http://127.0.0.1:8787 \
  "How can I safely retry an invoice upload without creating a duplicate ticket?"
Vous devez voir une ou plusieurs lignes chunk:, suivies d’une ligne terminale semblable à celle-ci :
complete chunks=18 chars=238
Votre texte, le nombre de portions et le nombre de caractères seront différents. L’élément important est la présence d’un contenu incrémental non vide, suivie de [DONE], que le client transforme en complete. Si vous voyez stream_error, examinez .labex/dev.log. Un problème de quota, d’autorisation ou de capacité est un échec d’inférence, pas une raison d’attendre indéfiniment.
Vérifiez enfin que la validation de l’application a toujours lieu avant l’inférence :
curl --silent --show-error --write-out '\nHTTP %{http_code}\n' \
  http://127.0.0.1:8787/help \
  --header 'Content-Type: application/json' \
  --data '{"question":""}'
Vous devez obtenir {"error":"invalid_question"} et HTTP 400. Un flux n’est utile qu’après le passage des contrôles ordinaires de la requête.
Déployer, terminer et annuler un flux
Dans cette étape, vous allez déployer le Worker, terminer un flux et en annuler un autre après sa première portion utile. Commencez par arrêter uniquement le processus de développement enregistré et attendez sa fin :
kill "$(cat .labex/dev.pid)"
wait "$(cat .labex/dev.pid)" 2>/dev/null || true
Déployez le même code Worker :
npx wrangler deploy
Enregistrez l’URL workers.dev exacte affichée par Wrangler :
WORKER_URL="https://YOUR_WORKER_URL"
Observez d’abord la fin normale :
node client.mjs "$WORKER_URL" \
  "How can I safely retry an invoice upload without creating a duplicate ticket?"
La ligne finale complete signifie que le modèle a envoyé [DONE] ; recevoir seulement la première portion ne prouverait pas que la réponse est complète.
Démarrez maintenant un second flux et arrêtez-le volontairement après sa première portion non vide :
node client.mjs "$WORKER_URL" \
  "Explain four checks to make before retrying a failed file upload." \
  --cancel-after-first
Vous devez obtenir une ligne chunk: suivie de cancelled after 1 chunk. L’annulation n’est pas une erreur du modèle : le client a volontairement décidé qu’il n’avait plus besoin du reste. La fermeture du lecteur propage l’annulation au flux en amont, tandis que le signal de la requête entrante permet au Worker d’enregistrer la déconnexion.
Ouvrez le Cloudflare Dashboard et accédez à Workers & Pages → Overview → votre Worker labex-c07-a02-... → Observability → Logs. Recherchez les requêtes récentes. L’aperçu ci-dessous provient d’une exécution d’acceptation temporaire : 14 Success et 0 Errors montrent que le Worker a traité ses vérifications de santé, ses flux terminés et ses déconnexions volontaires sans invocation en échec. Vos totaux et vos horodatages seront différents.
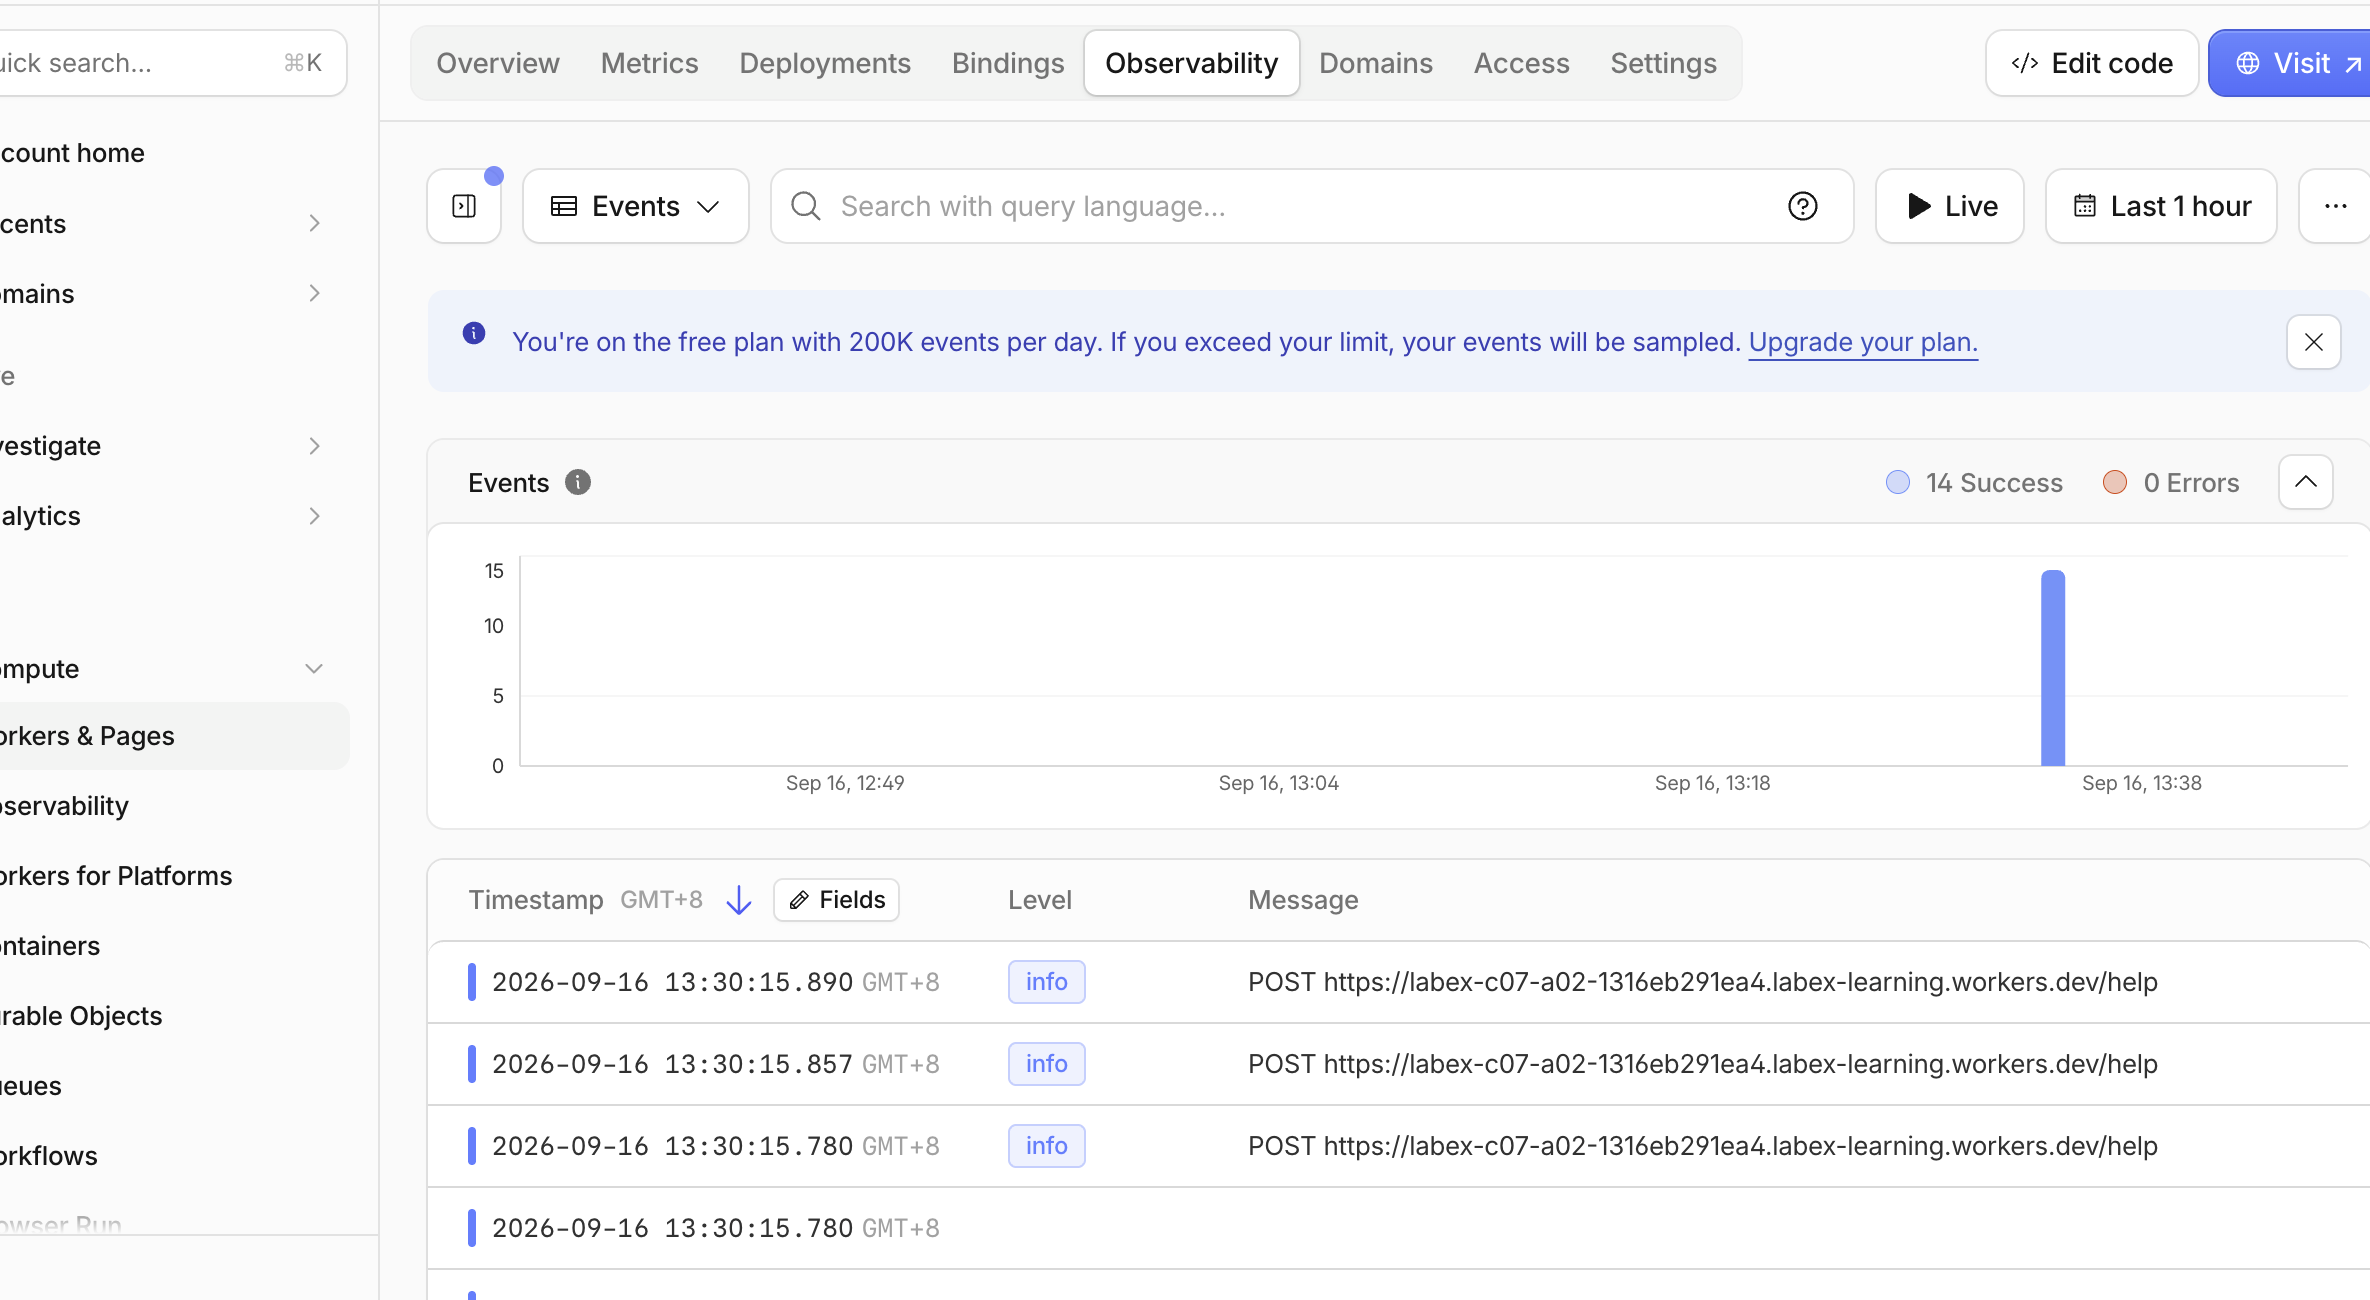
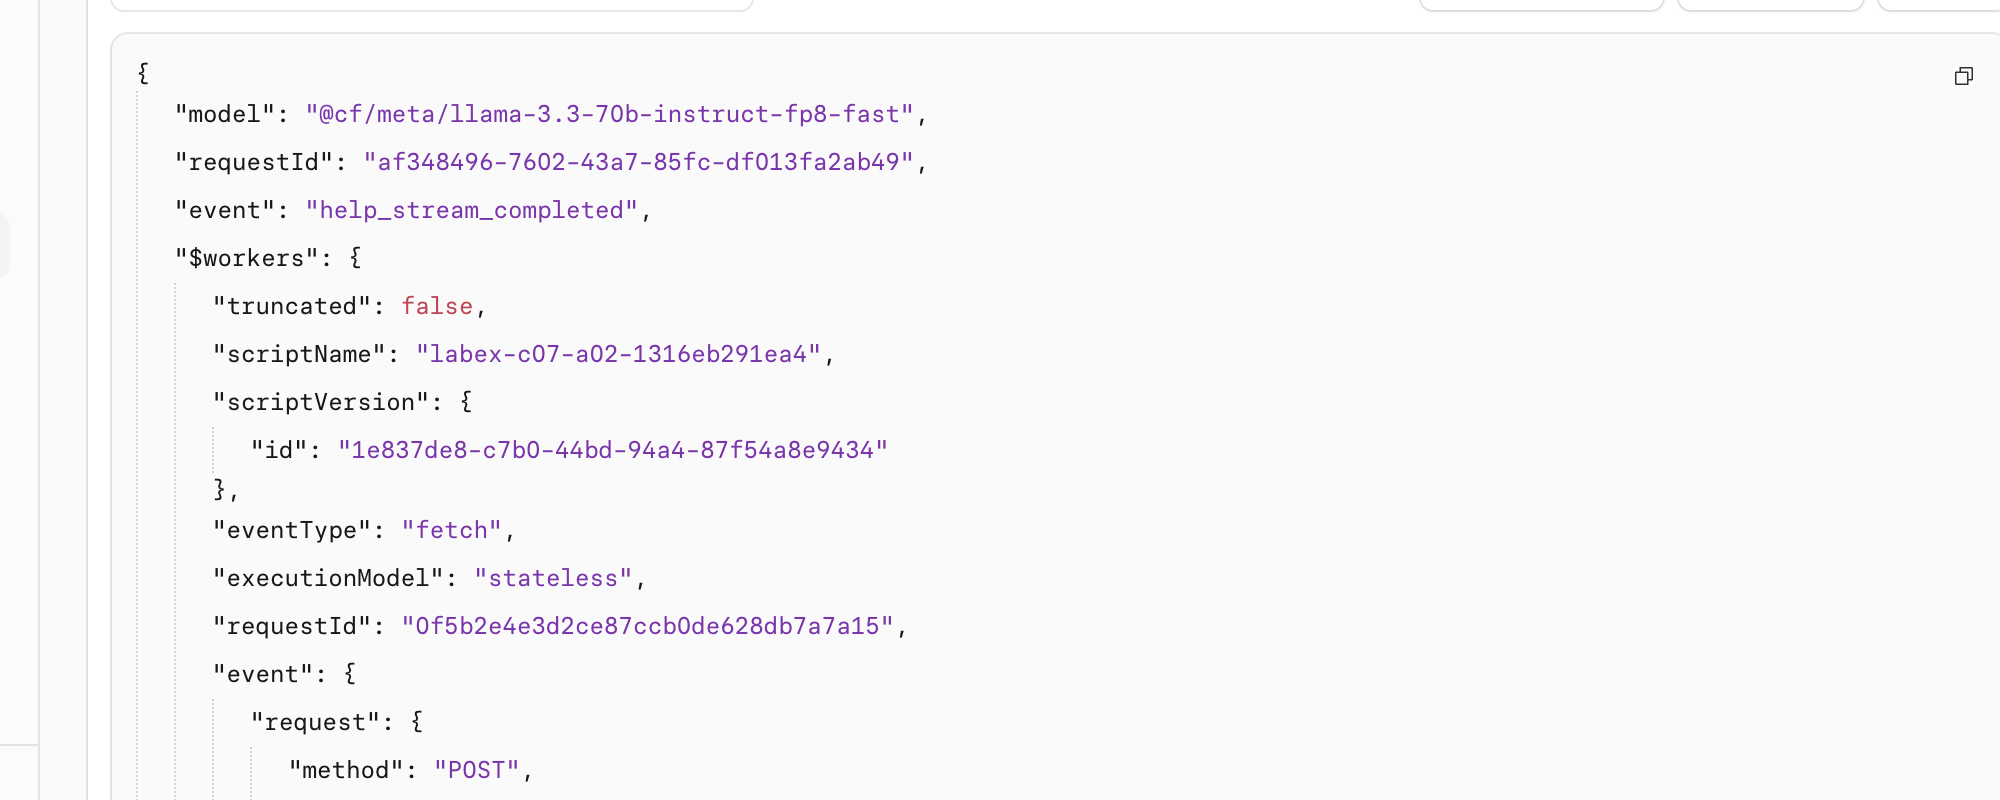
Recherchez help_stream_completed, développez un résultat et vérifiez son model, son requestId et son event. L’identifiant de requête est une valeur de corrélation sûre : il permet à un opérateur de relier les enregistrements du cycle de vie sans enregistrer la question de l’apprenant ni la réponse générée.
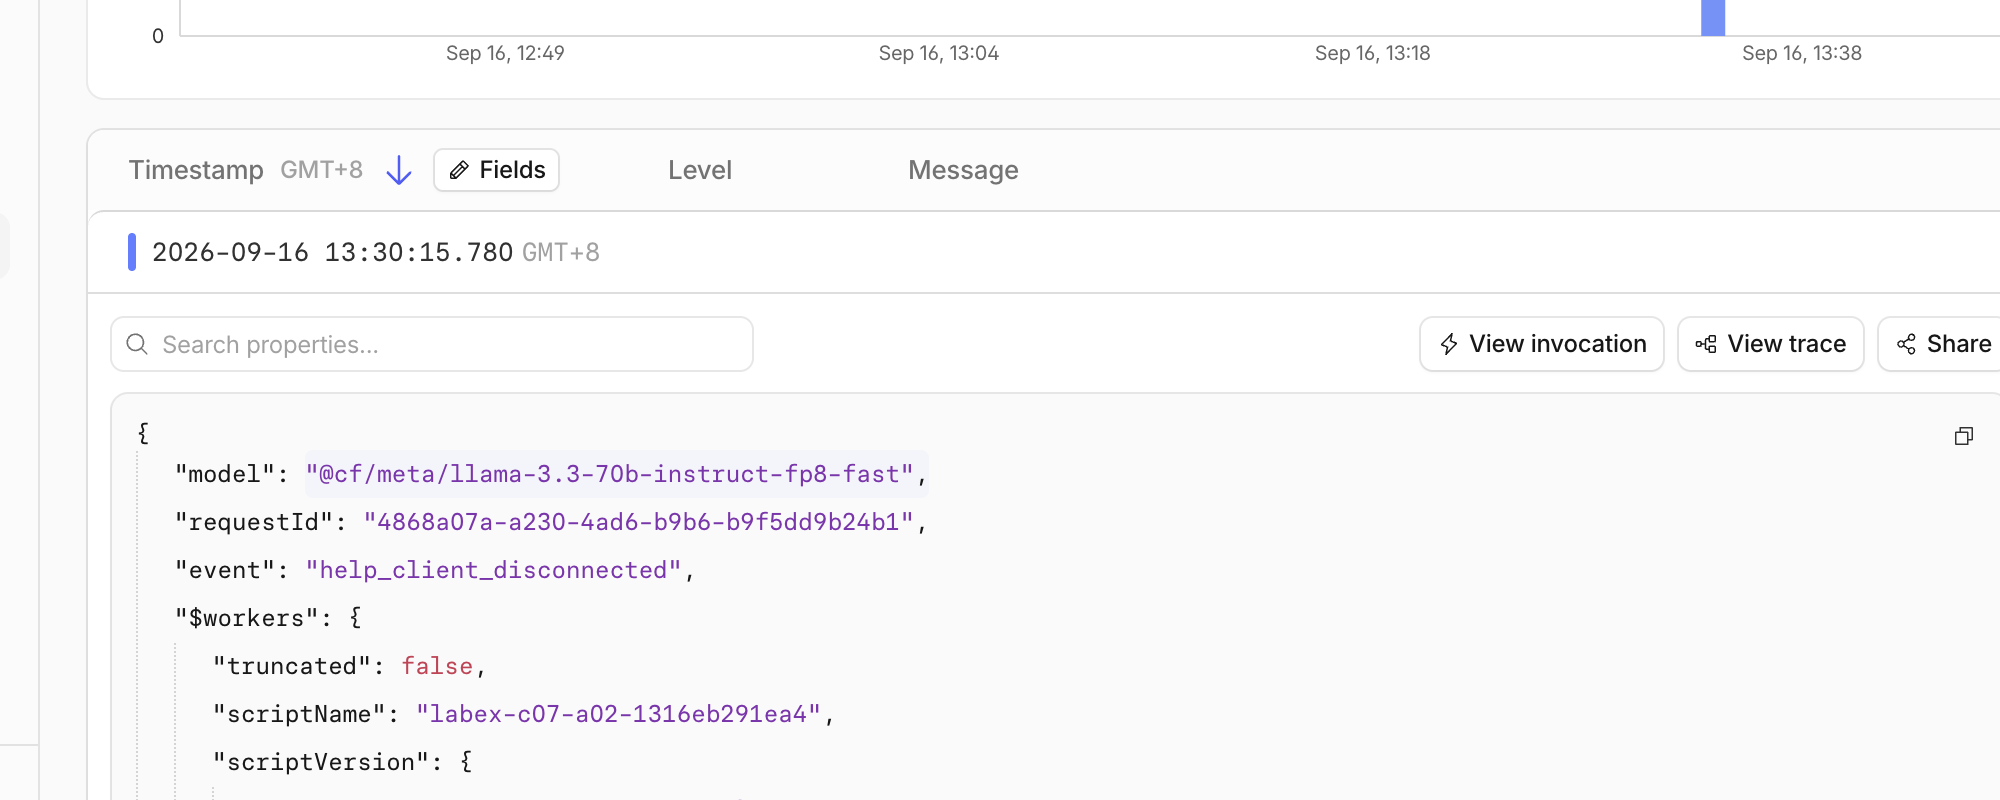
Pour la requête publique volontairement annulée, recherchez help_client_disconnected. Avec enable_request_signal, cet événement constitue la preuve directe que le client entrant s’est déconnecté. Le test déterministe de l’étape 4 prouve séparément que cancel() en aval atteint la fixture du modèle et enregistre help_stream_cancelled ; le timing réel du réseau peut toutefois faire de l’événement du signal de requête l’enregistrement cloud visible. Les journaux enregistrés peuvent apparaître après la réponse ; attendez brièvement et effectuez au maximum une requête d’annulation supplémentaire et limitée si nécessaire.
Ouvrez ensuite Workers AI et examinez l’utilisation du modèle aujourd’hui. Recherchez le modèle Llama 3.3 et vérifiez que les petits exercices restent dans l’allocation Free de 10 000 Neurons. Dans l’exemple ci-dessous, tout le travail effectué sur le compte d’apprentissage a utilisé 158.03/10k Neurons ; cela inclut d’autres exercices réalisés avec ce compte, votre valeur sera donc différente. Un forfait Workers Paid n’est pas nécessaire pour ce lab tant que le compte reste dans l’allocation Free. L’utilisation peut être mise à jour avec retard ; ne relancez donc pas l’inférence uniquement pour forcer l’actualisation d’un graphique.
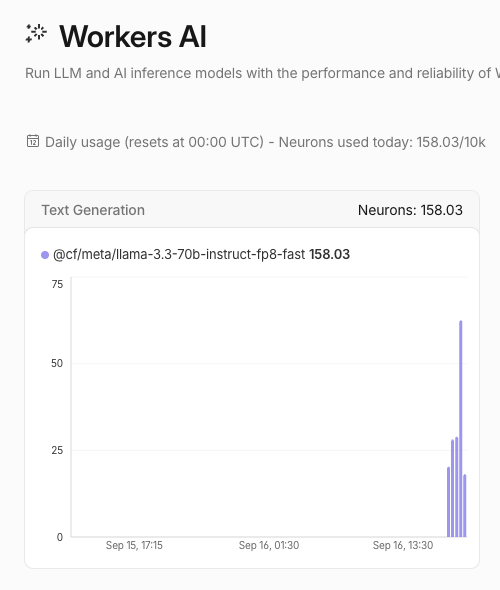
Le nom du Worker, les identifiants de requête, les horodatages et l’utilisation présentés dans ces captures sont des exemples issus d’une exécution temporaire. Les objectifs pédagogiques sont les noms des événements et leur relation dans le cycle de vie, et non les valeurs exactes.
Supprimer le Worker et se déconnecter
Dans cette étape, vous allez supprimer le Worker temporaire, puis déconnecter cette VM. Les enregistrements d’utilisation de Workers AI sont conservés au niveau du compte ; la suppression du Worker retire donc son endpoint public, mais n’efface pas ces données historiques et ne modifie pas le forfait du compte.
Supprimez précisément le Worker nommé dans wrangler.jsonc :
npx wrangler delete
Confirmez uniquement lorsque Wrangler affiche le nom unique labex-c07-a02-... de ce lab. La commande doit se terminer par Successfully deleted. Dans le Dashboard, actualisez Workers & Pages → Overview et vérifiez que ce nom exact n’apparaît plus.
Tant que la VM est encore autorisée, exécutez la vérification indépendante de gestion :
python3 .labex/verify.py deleted
Attendez le message PASS: deleted, puis supprimez l’autorisation enregistrée sur cette VM :
npx wrangler logout
npx wrangler whoami --json
Vous devez obtenir loggedIn: false. L’absence d’un fichier local, la fermeture d’un onglet du navigateur ou une erreur réseau ne prouverait ni la suppression cloud ni la déconnexion.
Résumé
Vous avez créé un endpoint Workers AI qui transmet progressivement une sortie SSE au lieu de mettre en mémoire tampon une réponse complète. Vous avez appris pourquoi un client a besoin d’un signal explicite [DONE], comment un délai d’expiration empêche une attente indéfinie, en quoi une annulation volontaire diffère d’un échec et comment les erreurs de flux se terminent proprement. Vous avez vérifié une inférence locale et une inférence déployée réelles, relié les événements du cycle de vie à l’observabilité du Dashboard, supprimé le Worker temporaire et déconnecté la nouvelle VM.