Introduction
La collection Riverside a besoin d’un index consultable de six documents HTML d’histoire orale. L’outil en conteneur fourni analyse réellement leur HTML et compte les mots Unicode, mais son lot à quatre workers dépasse un budget mémoire de 160 MiB. Diagnostiquez cet échec avec des preuves liées au conteneur exact, puis produisez l’index complet sans relever la limite ni retirer de documents.
Vous devez connaître les bases de docker run, les chemins dans le terminal et le rôle des montages liés. Ce TP explique avant leur emploi les options mémoire, les identifiants utilisateur réels, les chemins entre guillemets, la substitution de commande et le petit pipeline de lecture de preuves. La programmation Python, l’écriture HTML et l’implémentation d’un algorithme de recherche ne sont pas requises. Docker, l’image d’indexation et Search Desk en lecture seule sont préparés.
Le corpus est explicitement synthétique : chaque document contient 10 000 extraits pédagogiques développés pour rendre observable une véritable pression mémoire de l’analyseur. Le résultat est un véritable index de ces octets, pas une allocation simulée ni une garantie de capacité en production. Prévoyez environ 60 minutes, lecture et erreurs ordinaires comprises ; il s’agit d’une estimation de l’auteur.
Construire l’index complet dans son budget
Dans cette étape, vous allez observer un résultat de recherche normal, reproduire un échec en mémoire limitée, relier les preuves natives et traiter la collection complète avec un lot borné.
Utiliser d’abord un petit index normal
Commencez dans Search Desk et sélectionnez Explore sample. Cet exemple préparé distinct contient deux petits documents. Recherchez café avec Search one word et Search. Les deux fiches partagent le titre Riverside memories, mais ont des identifiants distincts commençant par sample-oral-. Ouvrez chaque fiche et examinez son empreinte source et les comptes de mots sélectionnés, puis utilisez Back to collection. Utilisez Download index pour examiner le véritable fichier JSON d’exemple, puis Back to Search Desk.
Les deux panneaux séparent l’exemple préparé de votre collection à traiter. Votre index est indisponible au départ :
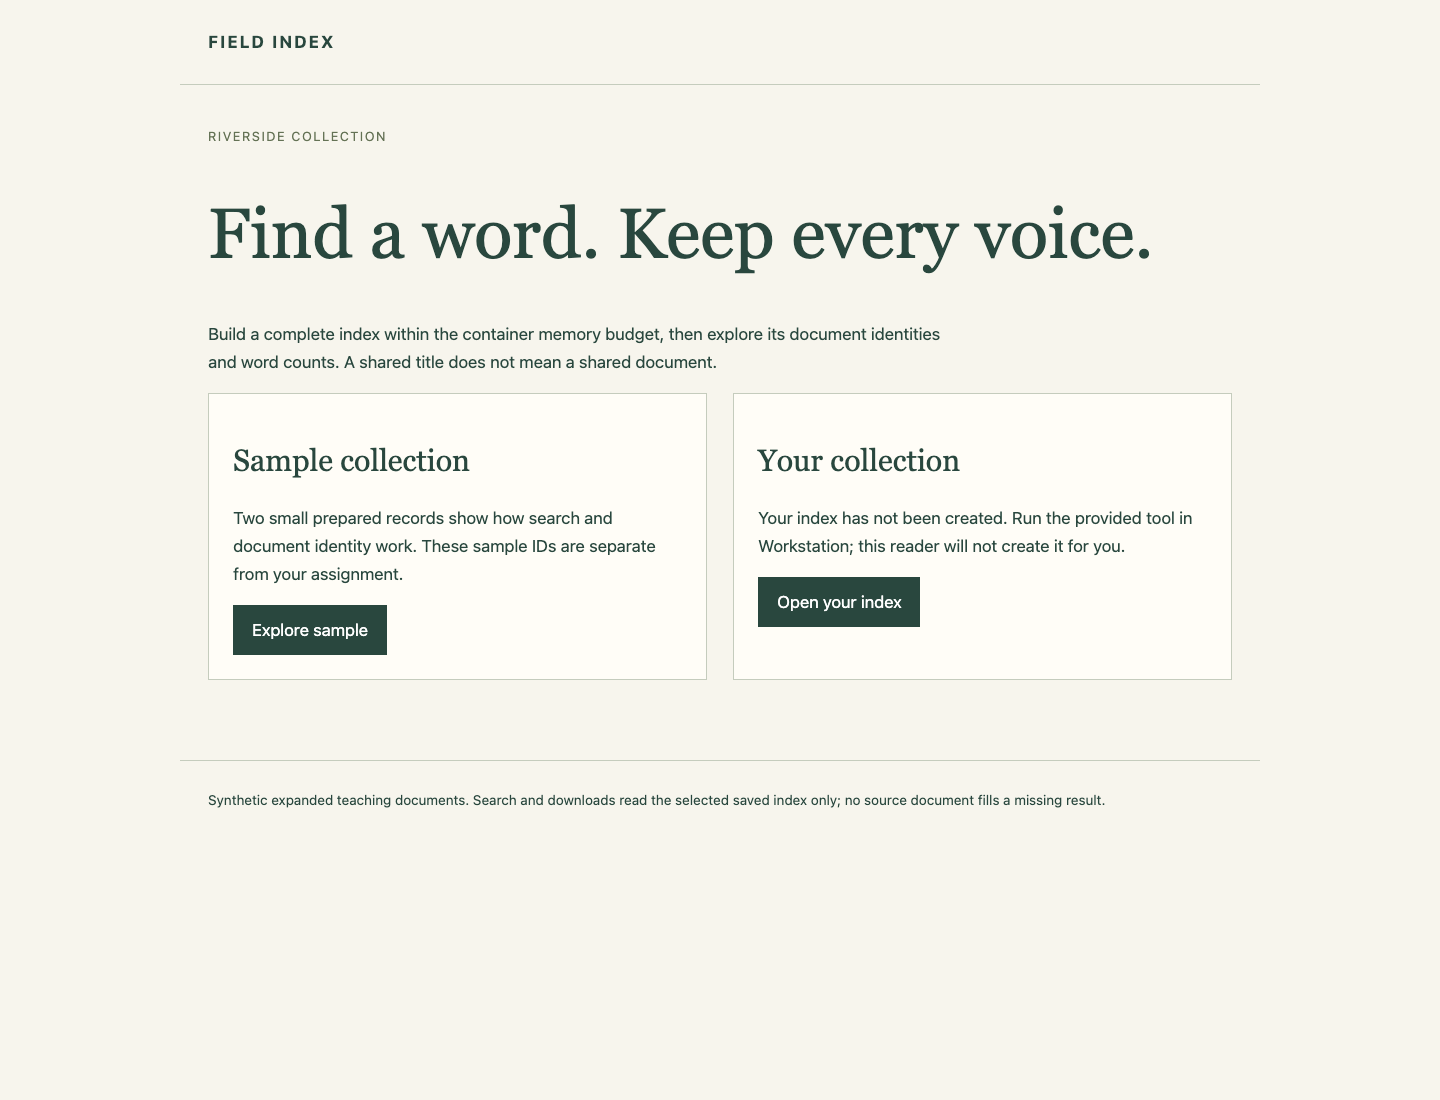
Un index inversé relie un mot à des identifiants de documents et à des nombres d’occurrences. Ses métadonnées documents enregistrent chaque identifiant, titre et SHA-256 source, une empreinte des octets d’origine. Deux fiches de même titre ne doivent pas être fusionnées en une identité unique. Le lecteur utilise uniquement l’index enregistré sélectionné ; il ne complète jamais un travail absent à partir du HTML source.
Sélectionnez Open your index. Il indique actuellement Collection not indexed avec HTTP 503. Le petit exemple n’est pas votre résultat à six documents.
Comprendre les chemins et la frontière mémoire
Passez à Workstation, qui démarre dans /home/labex/project/collection-index. cd permet d’y revenir et ls liste les fichiers :
cd /home/labex/project/collection-index
ls source output
source/ contient six fichiers HTML d’origine. output/ est votre répertoire de livraison modifiable. Préservez les originaux, l’image préparée dk06-indexer:1 et le lecteur d’exemple distinct. Vous créerez uniquement les conteneurs du cours et la sortie d’index.
Le point d’entrée de l’image exécute déjà son programme d’indexation. --source /input, --output /output/attempt.json et --workers 4 après le nom d’image sont des arguments du programme, pas des options Docker. Les workers analysent le HTML réel en arbres de documents. Un lot conserve les arbres sélectionnés pendant l’extraction des mots, puis les libère. Davantage de workers peuvent nécessiter plus de mémoire ; ils ne garantissent pas une vitesse supérieure.
Les options Docker avant le nom d’image fixent les contraintes d’exécution :
| Option | Signification ici |
|---|---|
--name |
Conserver un conteneur clairement nommé pour l’inspection native |
--memory 160m |
Imposer un budget RAM de 160 MiB |
--memory-swap 160m |
Fixer le total RAM plus swap au même montant, sans allocation de swap supplémentaire |
--network none |
Le traitement de fichiers n’a pas besoin de réseau |
--user |
Écrire la sortie sous votre compte normal réel |
Deux options --mount |
Lire uniquement l’entrée d’origine ; écrire dans le dossier de sortie distinct |
id -u et id -g affichent vos identifiants numériques réels d’utilisateur et de groupe ; ne supposez pas 1000. $(...) substitue la sortie d’une commande dans cette commande. Les guillemets doubles gardent la combinaison utilisateur/groupe et chaque valeur complète de montage dans un seul argument tout en permettant le développement de $PWD, le répertoire courant. Une barre oblique inverse finale joint la ligne physique suivante à la même commande.
L’entrée hôte source/ apparaît comme /input dans le conteneur ; output/ sur l’hôte apparaît comme /output. readonly protège l’entrée à travers ce montage. N’ajoutez pas un autre alias modifiable de la source. Gardez les deux options mémoire inchangées, ne désactivez pas le mécanisme de terminaison OOM et ne changez pas les paramètres de la plateforme.
Reproduire l’échec et en attribuer la cause
Exécutez l’essai fourni à quatre workers. Il doit volontairement se terminer avec le code natif 137 avant de terminer son index :
docker run --name index-attempt \
  --memory 160m --memory-swap 160m --network none \
  --user "$(id -u):$(id -g)" \
  --mount "type=bind,src=$PWD/source,dst=/input,readonly" \
  --mount "type=bind,src=$PWD/output,dst=/output" \
  dk06-indexer:1 --source /input --output /output/attempt.json --workers 4
Vous pouvez ne voir qu’une première ligne Parsing batch avant l’arrêt. Conservez le conteneur arrêté : il n’y a pas de --rm, car son identité et ses paramètres effectifs comptent.
docker inspect lit les champs natifs du conteneur. Les apostrophes gardent chaque petit modèle de format littéral. Lisez d’abord le code de sortie et l’indicateur OOM de Docker, puis les deux limites en octets :
docker inspect index-attempt --format '{{.State.ExitCode}} {{.State.OOMKilled}}'
docker inspect index-attempt --format '{{.HostConfig.Memory}} {{.HostConfig.MemorySwap}}'
docker logs index-attempt
Les valeurs configurées des limites sont toutes deux 167772160, soit 160 × 1024 × 1024 octets. Le code 137 seul ne distingue pas cet échec mémoire d’une terminaison forcée. L’indicateur OOMKilled de Docker doit être relevé, mais le moteur testé de ce TP peut parfois le laisser à false même si le noyau signale une véritable terminaison par groupe de contrôle mémoire. Recoupez avec les preuves réelles du noyau plutôt que de prendre l’un ou l’autre champ seul comme explication.
Lisez l’identifiant complet du conteneur dans une variable shell. L’affectation ne comporte pas d’espaces autour de = ; la substitution de commande capture le résultat d’inspect :
container_id=$(docker inspect --format '{{.Id}}' index-attempt)
La variable appartient à ce shell Workstation. Changer d’onglet de navigateur ne la change pas ; si vous ouvrez un nouveau shell, répétez l’affectation. sudo dmesg lit le journal protégé du noyau sans l’effacer. Un tube | transmet cette sortie à grep ; -F sélectionne les lignes contenant l’identifiant exact comme texte ordinaire, et les guillemets préservent sa valeur dans un argument unique :
sudo dmesg | grep -F "$container_id"
Repérez la ligne contenant CONSTRAINT_MEMCG et un chemin oom_memcg nommant cet identifiant complet de conteneur Docker. Elle identifie une action par manque de mémoire dans le groupe de contrôle mémoire de ce conteneur, plutôt qu’un processus indépendant ou une pénurie à l’échelle de la plateforme. Comparez-la à l’essai arrêté et à ses limites réelles. Ne créez pas de faux journaux et ne remplacez pas cet essai par un processus tué manuellement.
Réduire le lot et conserver tout le travail
Le budget est fixe. Réduire le lot à un worker conserve un seul véritable arbre de document analysé à la fois, tout en préservant les six documents et le même algorithme de comptage des mots. Ce choix est réalisable pour ce corpus ; cela ne signifie pas qu’un worker est toujours optimal. D’autres nombres de workers réalisables sont acceptés si le travail complet se termine réellement sous les mêmes limites.
Créez un conteneur de livraison distinct à conserver. Gardez les deux montages, le point d’entrée préparé et les options mémoire ; changez le nom du fichier de sortie et le nombre de workers :
docker run --name index-delivery \
  --memory 160m --memory-swap 160m --network none \
  --user "$(id -u):$(id -g)" \
  --mount "type=bind,src=$PWD/source,dst=/input,readonly" \
  --mount "type=bind,src=$PWD/output,dst=/output" \
  dk06-indexer:1 --source /input --output /output/index.json --workers 1
Vous devez obtenir tous les lots suivis de Indexed 6 documents and ... terms, et le code de sortie normal 0. Le total des termes est une observation, pas une preuve à lui seul :
docker inspect index-delivery --format '{{.State.ExitCode}}'
ls -l output/index.json
La sortie appartient à votre utilisateur/groupe normal et reste modifiable après la fin du conteneur. Conservez les deux conteneurs arrêtés. Si un chemin d’entrée est mal orthographié, Docker signale une source de montage absente avant le traitement : revenez au répertoire de travail indiqué, examinez ls source output, corrigez le chemin entre guillemets et recommencez. Ne créez pas d’entrée de remplacement pour masquer l’erreur.
Utiliser l’index réellement livré
Passez à Search Desk, sélectionnez Back to Search Desk si nécessaire, puis Open your index. Il doit afficher six documents indexés, pas les deux identifiants d’exemple. Recherchez café : les six documents doivent apparaître avec 10 000 occurrences chacun. Ouvrez les deux fiches Riverside memories par leurs identifiants distincts oral-0 et oral-1. Leurs empreintes sources et relations de mots doivent rester séparées.
La collection livrée contient les six identifiants d’origine, dont les deux fiches ayant le même titre :
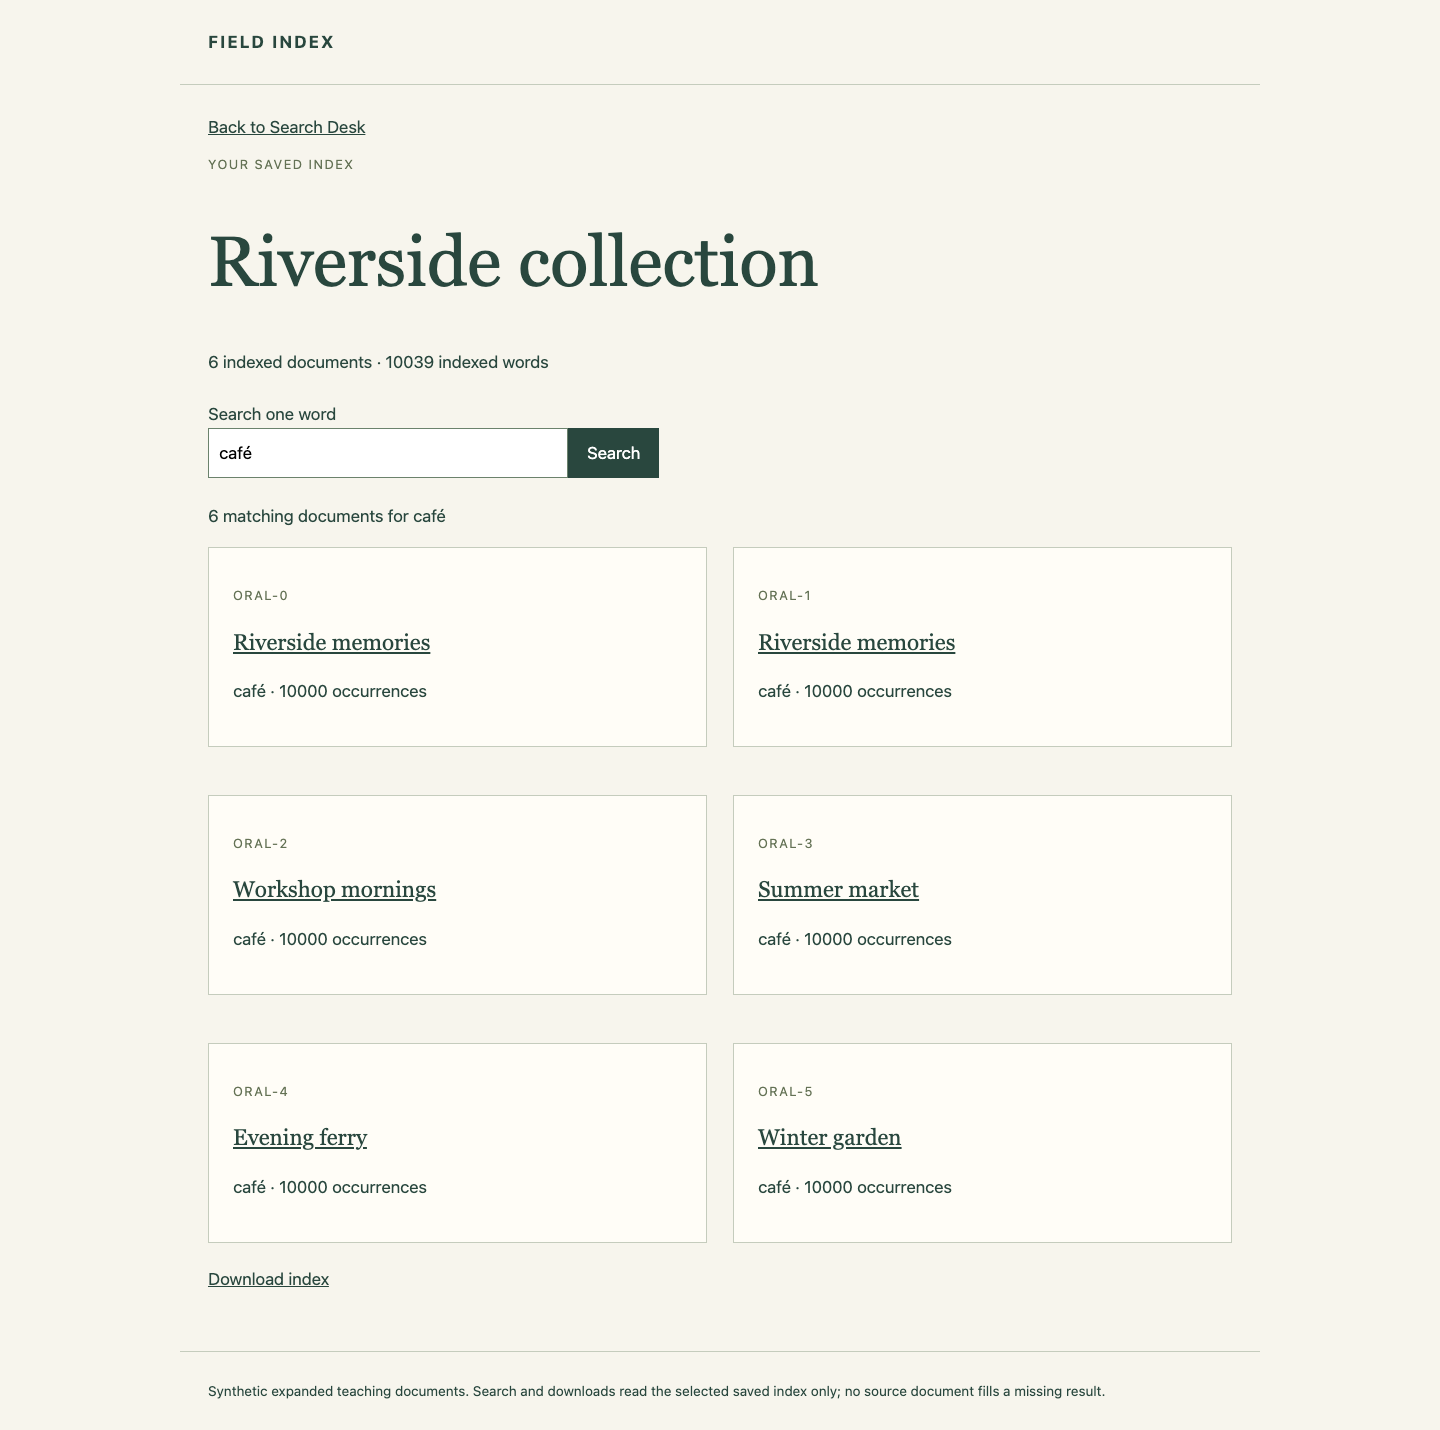
Revenez avec Back to collection, recherchez résumé puis naïve, et confirmez que les six fiches restent consultables avec leurs comptes réels. Recherchez notawordinthiscollection : aucun document ne doit correspondre. Utilisez Download index et examinez le véritable JSON livré ; ses documents, empreintes sources et listes d’occurrences appartiennent à toutes les entrées d’origine. Le lecteur ne régénère pas les résultats manquants.
Les vérifications relient l’événement précis de groupe de contrôle mémoire de cette exécution à son conteneur, examinent le budget effectif et les montages de la livraison réussie, et lisent indépendamment en flux chaque octet HTML d’origine pour vérifier tous les comptes Unicode par mot et document. Elles ne réexécutent pas votre tâche réelle et n’écrivent pas l’index pour vous.
Récupérer uniquement après une livraison infructueuse
Si votre tentative de livraison manque aussi de mémoire, examinez son état arrêté et ses journaux, choisissez un lot réalisable et supprimez uniquement ce conteneur index-delivery infructueux avec docker rm index-delivery avant de réessayer la commande de livraison affichée. Conservez index-attempt et tous les fichiers HTML d’origine comme preuves. Une réexécution réussie remplace sa propre sortie par un index complet ; ne modifiez pas les comptes à la main et ne copiez pas le petit exemple dans la livraison.
Résumé
Vous avez relié une véritable action OOM de groupe de contrôle mémoire à son conteneur précis et à ses limites effectives, puis réduit la concurrence réelle des lots HTML pour terminer l’index complet dans le même budget de 160 MiB. L’index enregistré préserve les six identités, les titres dupliqués, les empreintes sources d’origine et les comptes de mots Unicode, et reste utilisable après la fin de son conteneur.