



Introduction
Une API de support renvoie une exception peu utile lorsqu’une dépendance est lente. Vous allez reproduire le symptôme, le corréler à un identifiant de requête, puis réparer le gestionnaire afin que les appelants reçoivent un échec limité et explicite, tout en conservant le bon fonctionnement des requêtes saines. Vous vérifierez ensuite les réponses réelles dans le cloud ainsi qu’un flux de journaux en direct distinct.
Commencez dans cette VM fraîche avec votre propre compte d’apprentissage. Les prérequis sont un déploiement Wrangler classique, les liaisons de services et les tests locaux ; aucun Worker ni aucune VM précédente n’est réutilisé. La configuration installe Node.js 22.22.0, Wrangler 4.131.1 et Miniflare 4.20260730.0, et fournit l’appelant défectueux ainsi qu’un service amont synthétique. Le service amont renvoie des données synthétiques, une erreur 503 contrôlée ou un délai de 2,5 secondes. Aucune base de données, aucun domaine acheté et aucune expérience à forte charge ne sont nécessaires.
Une exception d’exécution, une réponse HTTP 504 délibérée et un échec dû à une limite d’exécution sont trois observations différentes. Vous examinerez chaque type d’élément sans considérer toute réponse 5xx comme un échec de la plateforme.
Reproduire et corréler le dépassement de délai
Dans cette étape, reproduisez localement une exception due à une dépendance lente. Lisez l’appelant et le service amont fourni. L’appelant impose une limite de 400 ms, mais ne capture pas le rejet de fetch ; le mode lent du service amont attend 2,5 secondes.
cd /home/labex/project/failure-diagnostics
cat src/index.js
cat upstream/index.js
Générez un nom de ressource unique. Le premier délimiteur EOF, non placé entre guillemets, remplace cette variable dans les deux configurations. La liaison de service UPSTREAM maintient le fixture privé ; le nom d’hôte présent dans l’URL de la requête ne sélectionne pas un service public.
WORKER_NAME="labex-diagnose-$(node -p "require('node:crypto').randomBytes(6).toString('hex')")"
cat > wrangler.jsonc <<EOF
{
  "name": "$WORKER_NAME",
  "main": "src/index.js",
  "compatibility_date": "2026-07-30",
  "workers_dev": true,
  "preview_urls": false,
  "services": [{"binding": "UPSTREAM", "service": "$WORKER_NAME-upstream"}]
}
EOF
cat > upstream/wrangler.jsonc <<EOF
{
  "name": "$WORKER_NAME-upstream",
  "main": "index.js",
  "compatibility_date": "2026-07-30",
  "workers_dev": false,
  "preview_urls": false
}
EOF
Lancez les deux configurations dans un même processus de développement local. Le processus en arrière-plan laisse le terminal disponible ; > et 2>&1 redirigent la sortie et les erreurs vers dev.log. Attendez l’état Ready avant d’envoyer des requêtes.
npx wrangler dev -c wrangler.jsonc -c upstream/wrangler.jsonc --ip 0.0.0.0 --port 8080 > dev.log 2>&1 &
cat dev.log
Utilisez -H pour ajouter un petit identifiant de requête synthétique. Le gestionnaire n’accepte qu’un format d’identifiant limité ; sinon, il en génère un. --max-time limite l’attente côté client curl ; cette limite est distincte de celle du gestionnaire.
curl -i --max-time 6 -H "X-Request-ID: healthy-one" "http://127.0.0.1:8080/api/check?mode=healthy"
curl -i --max-time 6 -H "X-Request-ID: slow-one" "http://127.0.0.1:8080/api/check?mode=slow"
cat dev.log
La requête saine renvoie 200 avec les données synthétiques du service amont. Le mode lent doit renvoyer une erreur locale 500 et afficher l’enregistrement request_started pour slow-one, suivi d’une exception de délai non capturée. La page d’erreur locale exacte et la trace peuvent varier. Cela prouve que la limite de délai provoque un rejet ; cela ne prouve pas qu’une réponse d’erreur utile existe. Exécutez la vérification avant de modifier l’appelant.
Réparer la réponse d’échec et les diagnostics
Dans cette étape, capturez l’échec limité du service amont et conservez des diagnostics utiles sans journaliser les en-têtes ni les identifiants d’authentification. Arrêtez le processus actuel en utilisant son numéro réel.
jobs
kill %1
Remplacez l’appelant par le gestionnaire réparé complet ci-dessous. Le délimiteur entre guillemets conserve littéralement le code JavaScript. Une réponse 504 identifie le dépassement de délai de la dépendance de l’appelant ; une réponse 502 identifie une réponse amont en échec ou un problème de protocole. Les appels réussis conservent le résultat du service amont. elapsed_ms mesure le temps écoulé sur l’horloge, et non l’utilisation du processeur. Le journal et la réponse partagent un identifiant de requête afin que vous puissiez suivre une même requête dans tout le système.
cat > src/index.js <<'JS'
export default {
  async fetch(request, env) {
    const url = new URL(request.url);
    if (url.pathname === '/health') return Response.json({status: 'ok'});
    if (url.pathname !== '/api/check') return Response.json({error: 'not_found'}, {status: 404});
    if (request.method !== 'GET') return Response.json({error: 'method_not_allowed'}, {status: 405});
    const mode = url.searchParams.get('mode') || 'healthy';
    if (!['healthy', 'slow', 'fail'].includes(mode)) {
      return Response.json({error: 'invalid_mode'}, {status: 400});
    }
    const suppliedId = request.headers.get('X-Request-ID') || '';
    const requestId = /^[a-z0-9-]{1,64}$/.test(suppliedId) ? suppliedId : crypto.randomUUID();
    const headers = {'X-Request-ID': requestId, 'Cache-Control': 'no-store'};
    const started = Date.now();
    console.log(JSON.stringify({event: 'request_started', request_id: requestId, mode}));
    const upstreamUrl = new URL('https://diagnostic.internal/check');
    upstreamUrl.searchParams.set('mode', mode);
    upstreamUrl.searchParams.set('probe', requestId);
    const signal = AbortSignal.timeout(400);
    const failure = (event, status, detail = {}) => {
      console.error(JSON.stringify({event, request_id: requestId, mode, status,
        elapsed_ms: Date.now() - started, ...detail}));
      return Response.json({error: event, requestId}, {status, headers});
    };
    try {
      const response = await env.UPSTREAM.fetch(upstreamUrl, {signal});
      if (!response.ok) return failure('upstream_status', 502, {upstream_status: response.status});
      const data = await response.json();
      if (data.service !== 'labex-diagnostic-fixture' || data.status !== 'ok' || data.probe !== requestId) {
        return failure('upstream_protocol', 502);
      }
      console.log(JSON.stringify({event: 'request_complete', request_id: requestId,
        mode, status: 200, elapsed_ms: Date.now() - started}));
      return Response.json({status: 'ok', requestId, upstream: data}, {headers});
    } catch {
      return signal.aborted ? failure('upstream_timeout', 504) : failure('upstream_exception', 502);
    }
  }
};
JS
npx wrangler dev -c wrangler.jsonc -c upstream/wrangler.jsonc --ip 0.0.0.0 --port 8080 > dev.log 2>&1 &
cat dev.log
Après l’état Ready, comparez les trois modes ainsi que la route de santé, qui n’a pas été modifiée. Chaque échec doit se terminer rapidement ; attendre plus longtemps pour le mode lent ne constitue pas une réparation.
curl -i --max-time 6 -H "X-Request-ID: healthy-two" "http://127.0.0.1:8080/api/check?mode=healthy"
curl -i --max-time 6 -H "X-Request-ID: slow-two" "http://127.0.0.1:8080/api/check?mode=slow"
curl -i --max-time 6 -H "X-Request-ID: fail-two" "http://127.0.0.1:8080/api/check?mode=fail"
curl -i http://127.0.0.1:8080/health
cat dev.log
Attendez-vous à obtenir 200/504/502 pour les modes healthy/slow/fail. Chaque réponse contient son identifiant de requête dans le JSON et dans X-Request-ID. Les journaux associent request_started à request_complete, upstream_timeout ou upstream_status. Cette dernière catégorie enregistre séparément le 503 du service amont et le 502 de l’appelant. Un échec capturé peut avoir un résultat d’exécution réussi, car le gestionnaire s’est terminé normalement, même si son statut HTTP est 504 ou 502.
Comparez ce résultat avec l’exemple fourni de limite d’exécution :
cat evidence/execution-limit.json
Ce fichier est explicitement un élément d’enseignement synthétique, et non une capture provenant de votre Worker. Son résultat exceededCpu identifie un échec dû à une limite d’exécution ; après l’arrêt de l’exécution par le runtime, aucun gestionnaire d’application n’est assuré de s’exécuter. Attendre le service amont asynchrone de ce lab n’équivaut pas à consommer du temps processeur. Recherchez une computation coûteuse ou un travail de requête excessif avant d’envisager les limites ; ne supprimez pas la limite de délai et ne générez pas de charge pour imiter cet exemple. La référence officielle des erreurs explique les catégories d’exceptions et de limites, tandis que la documentation sur les résultats d’exécution distingue le résultat d’exécution du statut HTTP.
Exécutez la vérification. Elle démarre un runtime isolé avec son propre fixture et ses propres identifiants de requête, vérifie les contrats de succès et d’échec, puis confirme qu’un en-tête Authorization synthétique n’apparaît pas dans les journaux capturés de l’application. Les fichiers journaux de l’apprenant ne constituent pas une preuve indépendante.
Vérifier les requêtes, les journaux et les métriques en direct
Dans cette étape, vérifiez le comportement réparé dans votre compte d’apprentissage. Arrêtez le développement local et autorisez cette VM fraîche avec le même flux d’appareil limité présenté précédemment.
jobs
kill %1
npx wrangler login --device --browser=false --scopes account:read user:read workers_scripts:write workers_tail:read
Ouvrez le lien affiché, saisissez le code et approuvez dans votre navigateur le compte d’apprentissage prévu. Confirmez le nom et l’identifiant réels du compte dans la sortie standard de Wrangler.
npx wrangler whoami --json
Remplacez YOUR_ACCOUNT_ID par cet identifiant réel. Cette commande Node classique l’enregistre dans les deux configurations du projet afin que chaque déploiement indique explicitement son propriétaire.
node -e 'const fs=require("node:fs");for(const p of ["wrangler.jsonc","upstream/wrangler.jsonc"]){const c=JSON.parse(fs.readFileSync(p));c.account_id="YOUR_ACCOUNT_ID";fs.writeFileSync(p,JSON.stringify(c,null,2)+"\n");}'
cat wrangler.jsonc upstream/wrangler.jsonc
npx wrangler deploy -c upstream/wrangler.jsonc
npx wrangler deploy
Le fixture ne possède aucun point de terminaison public. Copiez ci-dessous l’URL workers.dev réelle de l’appelant. Si le compte nécessite l’enregistrement initial d’un sous-domaine, suivez la procédure de Deploy Your First Cloudflare Worker avant de continuer.
APP_URL="https://YOUR_WORKER.YOUR_SUBDOMAIN.workers.dev"
Démarrez un flux en direct lisible. Attendez que events.log affiche Connected avant d’envoyer les requêtes ; la seule existence du fichier ne signifie pas que le flux est prêt.
npx wrangler tail --format pretty > events.log 2> tail-errors.log &
cat events.log
curl -i --max-time 6 -H "X-Request-ID: cloud-healthy" "$APP_URL/api/check?mode=healthy"
curl -i --max-time 6 -H "X-Request-ID: cloud-slow" "$APP_URL/api/check?mode=slow"
curl -i --max-time 6 -H "X-Request-ID: cloud-fail" "$APP_URL/api/check?mode=fail"
cat events.log
Recherchez les réponses 200/504/502 attendues ainsi que les identifiants correspondants dans les journaux de l’application en direct. Si un événement n’est pas encore arrivé, consultez de nouveau le même journal après quelques secondes ; ne modifiez pas l’application pour le provoquer artificiellement. Si le flux s’est arrêté, arrêtez-le et consultez tail-errors.log. La sortie lisible peut marquer l’invocation 504 capturée comme Ok : cela signifie que le runtime s’est terminé, et non que le service amont était sain.
Dans le Dashboard, ouvrez l’appelant exact dans le compte sélectionné, confirmez que sa liaison UPSTREAM cible ce fixture, puis consultez Metrics. Les graphiques disponibles agrègent les requêtes et les erreurs d’invocation et peuvent prendre du retard après un test court ; consignez ce qui est réellement visible au lieu d’exiger immédiatement un total différent de zéro. Utilisez les journaux en direct et les réponses HTTP comme preuves pour chaque requête. Une réponse 504 capturée peut apparaître dans les données de statut des réponses HTTP sans être comptabilisée comme une exception d’exécution non capturée. La référence des métriques explique l’agrégation et les catégories d’invocation.
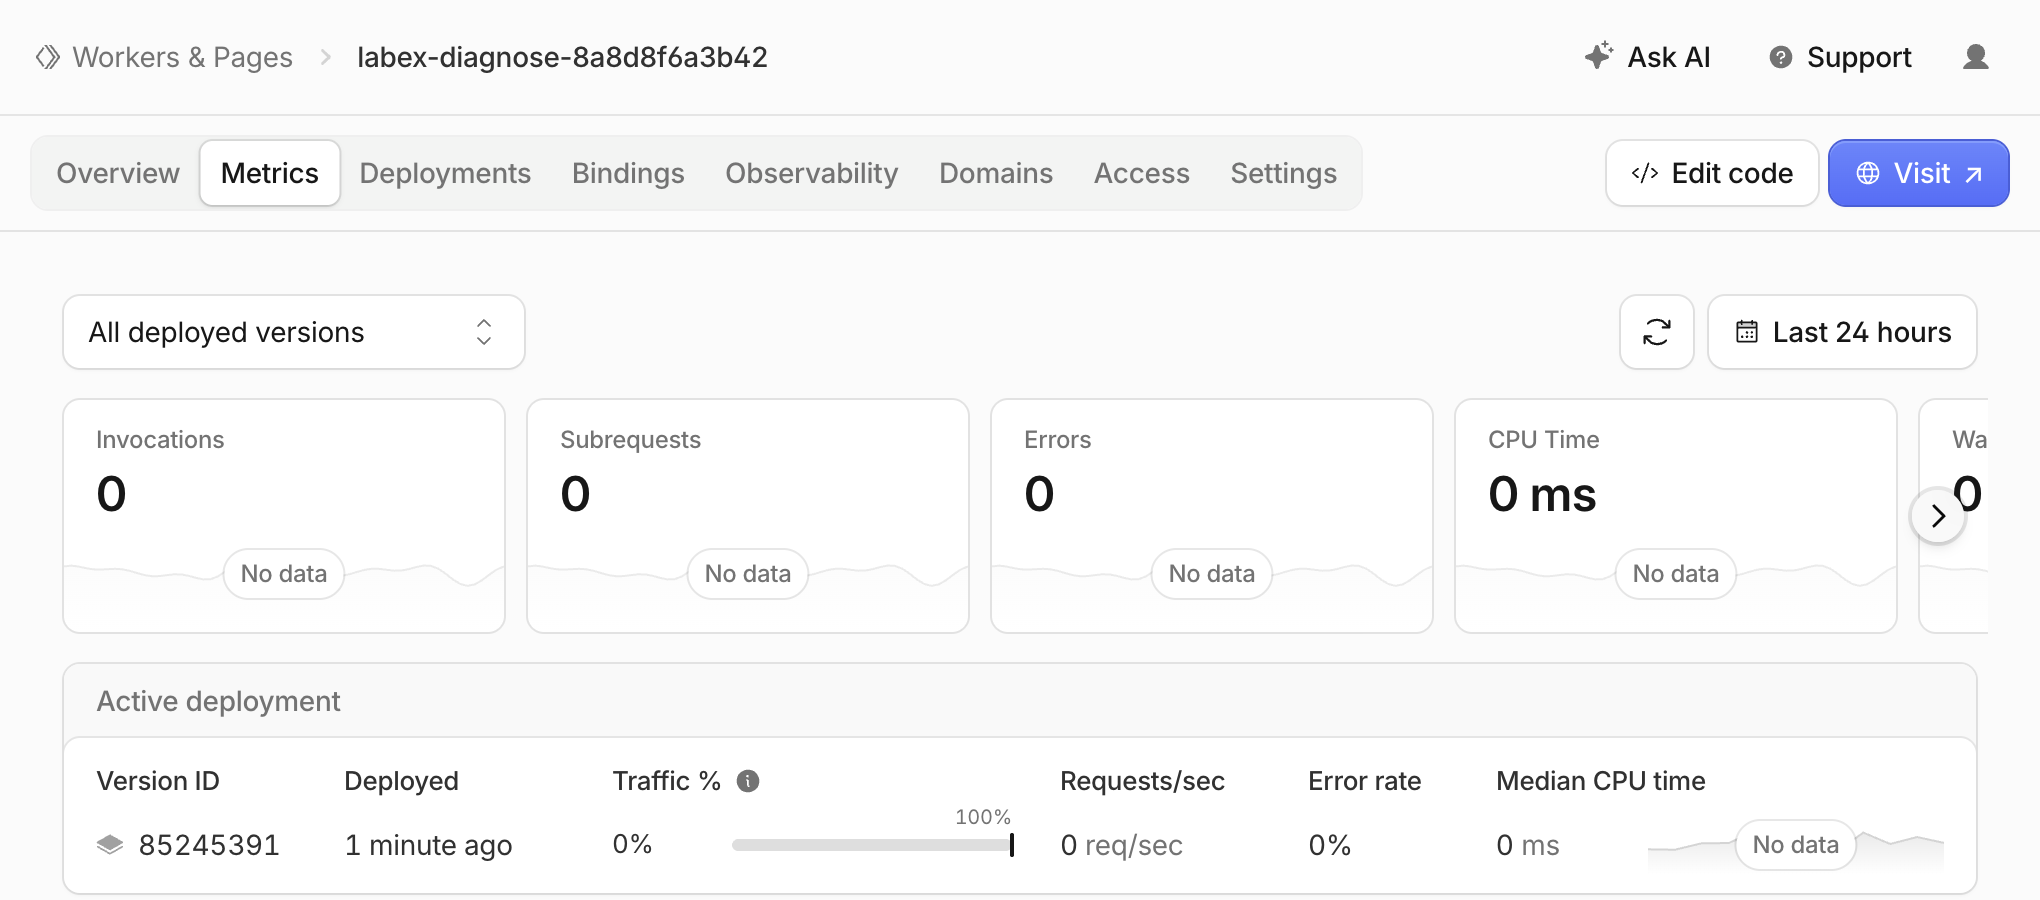
Dans Compute → Workers & Pages, ouvrez votre appelant exact et sélectionnez Metrics. Vérifiez le fil d’Ariane du Worker, le filtre de version déployée et une période couvrant vos requêtes. Le bouton d’actualisation se trouve à côté du sélecteur de période. La capture ci-dessous a été prise peu après les requêtes synthétiques healthy, slow et fail ; les cartes affichaient encore No data. Il s’agit d’une observation valide d’analyses retardées, et non de la preuve qu’aucune requête n’a été exécutée ou que la réparation a échoué. Votre nom, votre identifiant de version et vos totaux seront différents. Ne générez pas de charge supplémentaire uniquement pour reproduire l’image.
Exécutez la vérification pendant que vous êtes autorisé. Elle interroge la propriété et l’état des liaisons, envoie de nouvelles requêtes indépendantes et capture un flux en direct distinct. Prévoyez environ une minute. Un flux indisponible ou incomplet ne permet aucune conclusion ; vérifiez que la connexion est prête et réessayez, mais ne considérez jamais l’absence de journaux comme une réussite. Une fois la vérification réussie, arrêtez le flux tail de l’apprenant en utilisant son numéro de processus actuel.
jobs
kill %1
Supprimer les Workers de diagnostic
Dans cette étape, supprimez uniquement l’appelant et le fixture de ce lab, tout en restant autorisé. Vérifiez les deux noms ainsi que leur compte avant de supprimer d’abord l’appelant.
cat wrangler.jsonc upstream/wrangler.jsonc
npx wrangler delete
npx wrangler delete -c upstream/wrangler.jsonc
À chaque invite correspondant à un nom, appuyez sur la seule touche y. Le CLI épinglé peut signaler un diagnostic d’authentification lié au nettoyage d’un ancien KV après la suppression d’un Worker ; n’élargissez pas les autorisations pour cette raison et ne supposez pas que des erreurs arbitraires prouvent la suppression. Actualisez le Dashboard et exécutez la vérification. Les deux noms doivent être absents d’un inventaire authentifié réussi. Conservez le compte, le sous-domaine et les ressources sans rapport avec ce lab.
Déconnecter la VM
Dans cette étape, déconnectez la VM après avoir vérifié la suppression des ressources. Fermer le terminal ou se déconnecter ne supprimerait pas les ressources cloud.
npx wrangler logout
npx wrangler whoami --json
Attendez-vous à obtenir loggedIn=false ; la commande peut se terminer avec un code différent de zéro dans cet état non authentifié. Exécutez la vérification finale. Votre connexion au navigateur et votre compte d’apprentissage pourront être réutilisés par un prochain lab dans une nouvelle VM.
Résumé
Vous avez reproduit un dépassement de délai non géré, réparé les échecs limités d’une dépendance et corrélé les identifiants de requête entre les réponses et les journaux structurés. Le comportement sain a été préservé. Vous avez distingué les échecs HTTP de l’application des résultats d’exécution et des éléments synthétiques liés à une limite CPU, vérifié le comportement réel dans le cloud, puis supprimé les deux Workers et déconnecté la VM.
