



Introduction
Un modèle d’IA génère normalement une nouvelle réponse chaque fois qu’une application l’appelle. Cette opération prend du temps et consomme des ressources du modèle, même lorsque la requête est exactement identique à celle à laquelle le modèle vient de répondre. Un cache conserve une réponse réutilisable pendant une durée limitée, afin de répondre à une requête identique sans effectuer un nouvel appel au modèle.
La mise en cache n’est utile que lorsque la réutilisation est sûre. Une question de FAQ publique et fixe est un bon candidat, car tous les appelants peuvent recevoir la même réponse. En revanche, ce n’est pas le cas d’une invite d’assistance personnalisée : deux clients ne doivent jamais être regroupés sous une clé de cache commune uniquement pour améliorer la rapidité. La clé de cache par défaut d’AI Gateway protège cet atelier en incluant le fournisseur, le point de terminaison, le modèle, les identifiants du fournisseur et le corps complet de la requête. Toute modification du corps crée une entrée différente.
Vous allez créer une passerelle authentifiée temporaire avec une durée de vie du cache de cinq minutes. Vous enverrez une petite question publique à Workers AI et observerez un MISS, répéterez exactement la même requête pour prouver l’obtention d’un HIT, puis modifierez la question pour observer un autre MISS. Enfin, vous contournerez la réponse déjà mise en cache lorsque la fraîcheur sera importante et confirmerez dans les journaux de la passerelle que la requête a atteint le modèle.
Si vous avez accédé directement à ce cours, terminez d’abord Connect LabEx to Your Cloudflare Account. Ce module vous apprend à utiliser le terminal de la machine virtuelle LabEx, l’autorisation de l’appareil Wrangler, la confirmation du compte d’apprentissage et les identifiants de compte explicites. Terminez également Route Inference Through a Gateway avant cet atelier, car celui-ci réutilise les limites distinctes de sa passerelle et de l’autorisation en amont.
L’atelier utilise le modèle hébergé par Cloudflare @cf/meta/llama-3.3-70b-instruct-fp8-fast avec la facturation Workers AI Standard. Workers Paid, Unified Billing et un compte de fournisseur externe ne sont pas nécessaires. Seules trois requêtes doivent atteindre le modèle ; la répétition exacte doit provenir du cache. Arrêtez-vous au lieu d’effectuer des tentatives répétées si l’allocation quotidienne partagée de Workers AI n’est pas disponible.
La configuration installe Node.js 22.22.0 et Wrangler 4.132.0, installé localement dans le projet /home/labex/project/ai-gateway-cache. Elle prépare des évaluations indépendantes en lecture seule, mais n’autorise pas Wrangler, ne crée pas de ressources cloud et n’envoie pas de trafic au modèle. LabEx détruit la machine virtuelle temporaire à la fin de l’atelier ; vous devez tout de même supprimer la passerelle et le jeton avant la déconnexion, car la destruction de la machine virtuelle ne peut pas supprimer les ressources cloud.
Autoriser la machine virtuelle et nommer l’expérience de cache
Dans cette étape, vous allez connecter la nouvelle machine virtuelle à votre compte d’apprentissage et générer les noms d’une passerelle et d’un jeton temporaires.
Un cache est une infrastructure partagée : sa portée doit donc être définie délibérément. Cet atelier utilise une passerelle dont le nom est unique et uniquement des questions publiques synthétiques. Le suffixe aléatoire empêche votre expérience d’entrer en conflit avec une autre passerelle du même compte d’apprentissage.
Accédez au projet préparé, vérifiez la version figée de l’interface en ligne de commande, puis autorisez cette machine virtuelle :
cd /home/labex/project/ai-gateway-cache
npx wrangler --version
npx wrangler login --device --browser=false --scopes account:read user:read ai:write
Ouvrez le lien affiché, saisissez le code et autorisez le compte d’apprentissage prévu. Vérifiez ensuite l’identité structurée :
npx wrangler whoami --json
Vous devez obtenir Wrangler 4.132.0 et loggedIn: true. Remplacez YOUR_ACCOUNT_ID ci-dessous par l’identifiant réel de 32 caractères affiché pour le compte prévu :
GATEWAY_ID="labex-c09-g03-$(openssl rand -hex 6)"
TOKEN_NAME="$GATEWAY_ID-token"
cat > .labex/state.json <<JSON
{
  "accountId": "YOUR_ACCOUNT_ID",
  "gatewayId": "$GATEWAY_ID",
  "tokenName": "$TOKEN_NAME"
}
JSON
cat .labex/state.json
Ces identifiants non secrets restent dans un inventaire local afin que toutes les opérations de lecture, de vérification et de nettoyage ultérieures ciblent uniquement les ressources de cet atelier.
Créer une passerelle authentifiée avec un cache de courte durée
Dans cette étape, vous allez créer la passerelle et attribuer aux réponses mises en cache une durée de vie, ou TTL, de cinq minutes. Le TTL correspond à la durée maximale pendant laquelle une entrée peut être réutilisée avant de devenir obsolète et de devoir être actualisée depuis le modèle.
Ouvrez le tableau de bord Cloudflare et choisissez AI → AI Gateway → Create gateway → Custom gateway. Utilisez la valeur enregistrée de gatewayId comme nom de la passerelle. Laissez la journalisation des requêtes et l’authentification de la passerelle activées, activez Cache responses et définissez son TTL sur exactement 300 secondes. Laissez les limites de débit, les limites de dépenses et les nouvelles tentatives désactivées, et conservez la facturation Workers AI sur Standard.
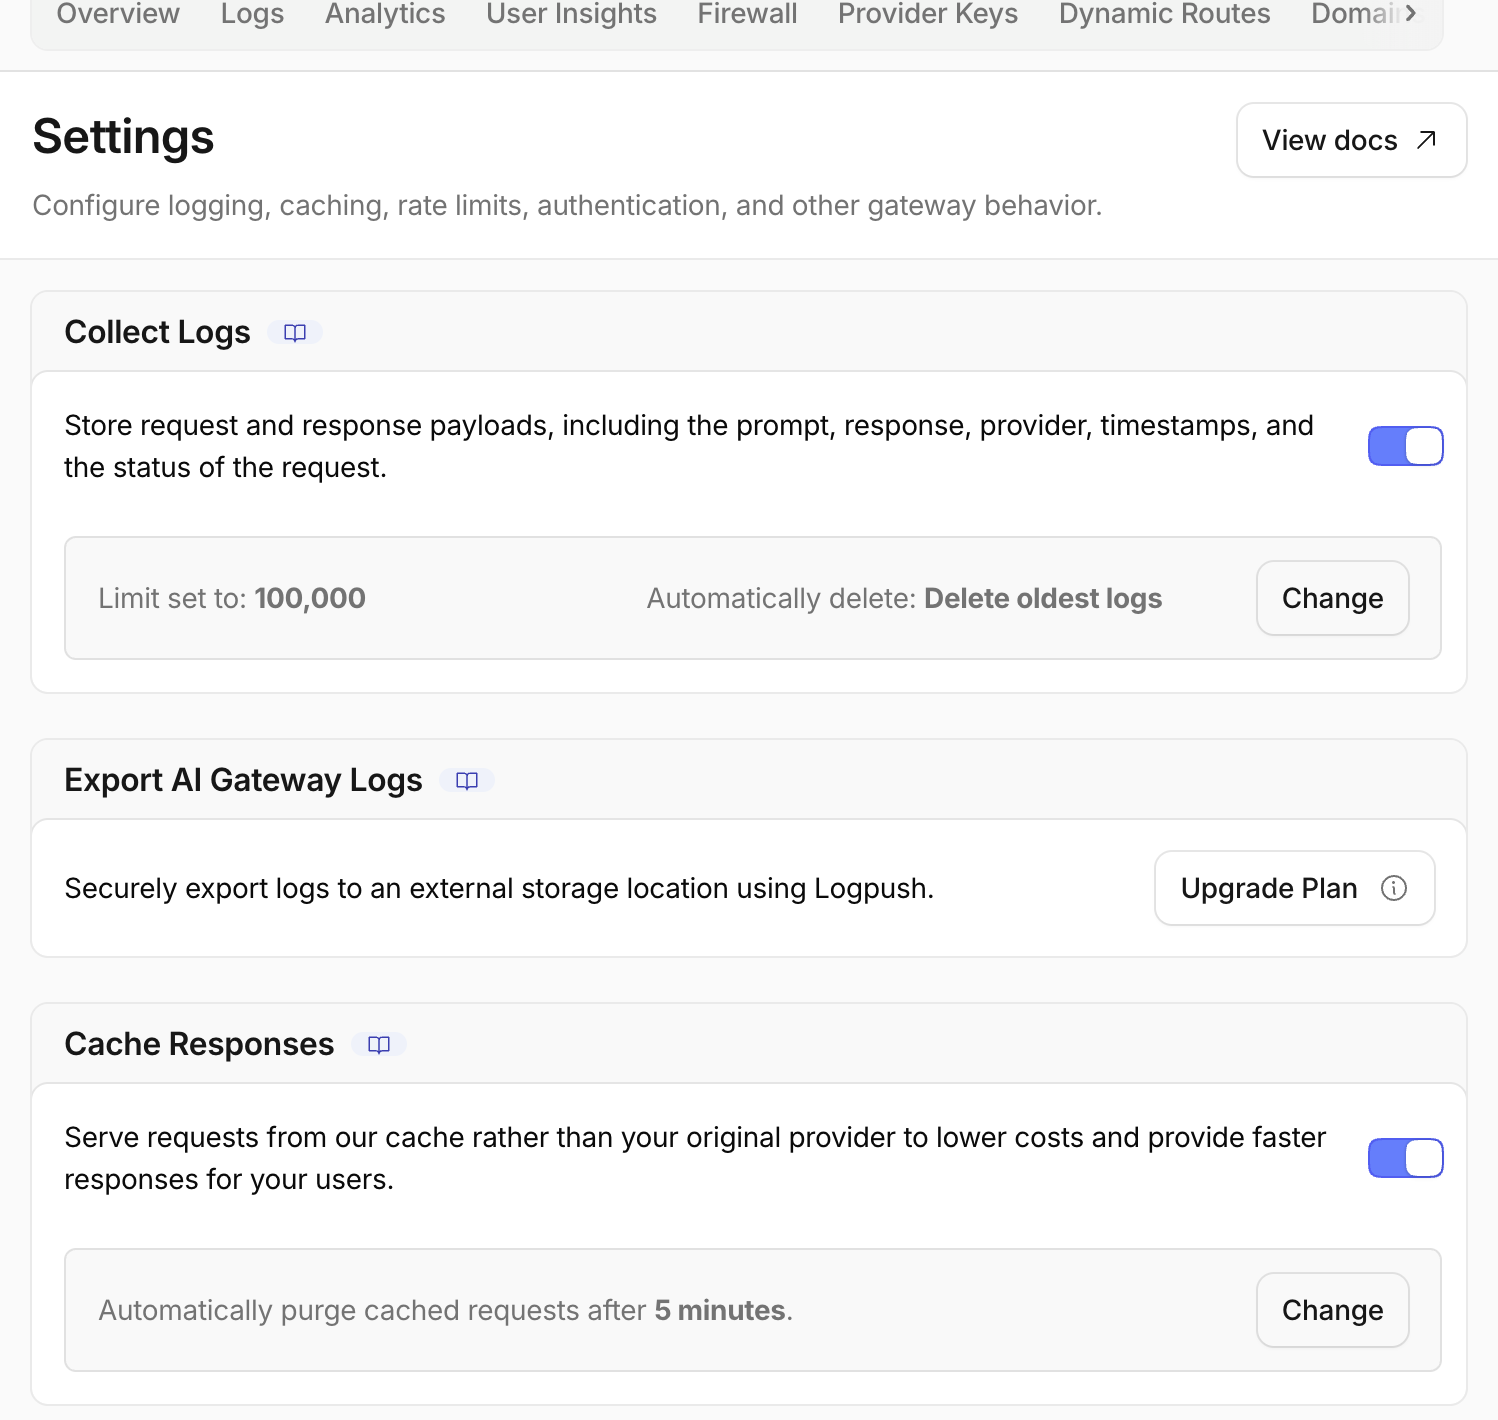
Après la création, vérifiez l’identifiant unique de la passerelle dans le fil d’Ariane. Ce TTL court est suffisamment long pour répéter l’expérience, tout en évitant que l’exemple de réponse ne reste inutilement disponible.
Choisissez Create an AI Gateway authentication token. Utilisez la valeur enregistrée de tokenName, incluez uniquement le compte d’apprentissage prévu et définissez exactement les autorisations suivantes :
- AI Gateway — Run pour accéder à la passerelle authentifiée ;
- AI Gateway — Edit pour lire les informations du cache et supprimer cette passerelle temporaire.
N’ajoutez pas l’autorisation Workers AI. Wrangler fournit l’identifiant distinct et de courte durée utilisé en amont. Créez le jeton après avoir vérifié le compte et les autorisations, puis enregistrez sa valeur utilisable une seule fois sans l’afficher :
bash -c '
while :; do
  read -ersp "Paste the AI Gateway token: " GATEWAY_TOKEN
  printf "\n"
  [ -n "$GATEWAY_TOKEN" ] && break
  printf "Token cannot be empty; paste it again.\n" >&2
done
umask 077
printf "%s" "$GATEWAY_TOKEN" > .labex/gateway-token
unset GATEWAY_TOKEN
chmod 600 .labex/gateway-token
'
Vérifiez la configuration exacte du cache via l’API de gestion authentifiée :
ACCOUNT_ID=$(node -p 'JSON.parse(require("fs").readFileSync(".labex/state.json")).accountId')
GATEWAY_ID=$(node -p 'JSON.parse(require("fs").readFileSync(".labex/state.json")).gatewayId')
GATEWAY_TOKEN=$(cat .labex/gateway-token)
curl --http1.1 -fsS \
  -H "Authorization: Bearer $GATEWAY_TOKEN" \
  "https://api.cloudflare.com/client/v4/accounts/$ACCOUNT_ID/ai-gateway/gateways/$GATEWAY_ID" \
  | node -e 'let s="";process.stdin.on("data",d=>s+=d).on("end",()=>{const b=JSON.parse(s),g=b.result||{};console.log(JSON.stringify({success:b.success,id:g.id,collect_logs:g.collect_logs,authentication:g.authentication,cache_ttl:g.cache_ttl},null,2))})'
unset GATEWAY_TOKEN
Vous devez obtenir l’identifiant enregistré, collect_logs: true, authentication: true et cache_ttl: 300.
Envoyer la première requête de FAQ publique
Dans cette étape, vous allez envoyer une petite question publique que chaque apprenant peut réutiliser sans risque. La première requête éligible ne peut pas déjà avoir une entrée sous cette nouvelle passerelle ; elle doit donc produire un MISS du cache. Un miss signifie qu’AI Gateway transmet la requête à Workers AI, puis stocke la réponse obtenue.
La clé de cache par défaut inclut les identifiants du fournisseur en amont. Enregistrez de manière privée l’identifiant Wrangler actuel de cette machine virtuelle afin que les quatre requêtes utilisent une seule clé contrôlée. Il s’agit d’un fichier temporaire pour l’atelier, et non d’un modèle destiné aux secrets de production :
umask 077
npx wrangler auth token --json \
  | node -e 'let s="";process.stdin.on("data",d=>s+=d).on("end",()=>process.stdout.write(JSON.parse(s).token))' \
  > .labex/upstream-token
chmod 600 .labex/upstream-token
Envoyez la première requête et enregistrez les en-têtes de réponse, le corps et le code d’état HTTP sans afficher l’un ou l’autre des identifiants :
ACCOUNT_ID=$(node -p 'JSON.parse(require("fs").readFileSync(".labex/state.json")).accountId')
GATEWAY_ID=$(node -p 'JSON.parse(require("fs").readFileSync(".labex/state.json")).gatewayId')
MODEL='@cf/meta/llama-3.3-70b-instruct-fp8-fast'
METADATA='{"lab":"g03-cache","case":"public-faq","synthetic":true}'
GATEWAY_TOKEN=$(cat .labex/gateway-token)
UPSTREAM_TOKEN=$(cat .labex/upstream-token)
STATUS=$(curl --http1.1 -sS -D .labex/first-headers.txt \
  -o .labex/first-response.json -w '%{http_code}' \
  -H "cf-aig-authorization: Bearer $GATEWAY_TOKEN" \
  -H "Authorization: Bearer $UPSTREAM_TOKEN" \
  -H "cf-aig-metadata: $METADATA" \
  -H 'Content-Type: application/json' \
  --data '{"prompt":"In one short sentence, what does an AI gateway do?","max_tokens":32}' \
  "https://gateway.ai.cloudflare.com/v1/$ACCOUNT_ID/$GATEWAY_ID/workers-ai/$MODEL")
unset GATEWAY_TOKEN UPSTREAM_TOKEN METADATA
printf '%s\n' "$STATUS" | tee .labex/first-status.txt
awk 'BEGIN{IGNORECASE=1} /^cf-aig-cache-status:/ {gsub("\r","",$2); print toupper($2)}' .labex/first-headers.txt \
  | tail -1 | tee .labex/first-cache-status.txt
node -e 'const b=require("./.labex/first-response.json"); console.log(b.result?.response ?? b.result)'
Vous devez obtenir HTTP 200, le statut de cache MISS et une courte réponse générée. Le corps de la requête ne contient aucune donnée client ; la réutilisation temporaire de cette réponse est donc sûre.
Répéter exactement la requête et prouver l’obtention d’un cache hit
Dans cette étape, vous allez envoyer exactement le même fournisseur, le même point de terminaison, le même modèle, les mêmes identifiants et le même corps de requête. AI Gateway peut donc réutiliser l’entrée créée à l’étape précédente. Un HIT du cache signifie que la réponse provient du cache de la passerelle, sans nouvelle génération par le modèle.
Le stockage du cache est asynchrone. Attendez donc quelques secondes après la première réponse réussie afin de laisser le temps à l’entrée d’être enregistrée avant de répéter la requête :
sleep 5
GATEWAY_TOKEN=$(cat .labex/gateway-token)
UPSTREAM_TOKEN=$(cat .labex/upstream-token)
METADATA='{"lab":"g03-cache","case":"public-faq","synthetic":true}'
STATUS=$(curl --http1.1 -sS -D .labex/repeat-headers.txt \
  -o .labex/repeat-response.json -w '%{http_code}' \
  -H "cf-aig-authorization: Bearer $GATEWAY_TOKEN" \
  -H "Authorization: Bearer $UPSTREAM_TOKEN" \
  -H "cf-aig-metadata: $METADATA" \
  -H 'Content-Type: application/json' \
  --data '{"prompt":"In one short sentence, what does an AI gateway do?","max_tokens":32}' \
  "https://gateway.ai.cloudflare.com/v1/$ACCOUNT_ID/$GATEWAY_ID/workers-ai/$MODEL")
unset GATEWAY_TOKEN UPSTREAM_TOKEN METADATA
printf '%s\n' "$STATUS" | tee .labex/repeat-status.txt
awk 'BEGIN{IGNORECASE=1} /^cf-aig-cache-status:/ {gsub("\r","",$2); print toupper($2)}' .labex/repeat-headers.txt \
  | tail -1 | tee .labex/repeat-cache-status.txt
cmp -s .labex/first-response.json .labex/repeat-response.json \
  && echo 'response bytes match the cached source'
Vous devez obtenir HTTP 200 et HIT. L’identité des octets est une observation complémentaire utile, tandis que l’en-tête de réponse HIT et le journal mis en cache dans le tableau de bord constituent les preuves faisant foi. Le stockage du cache d’AI Gateway est asynchrone et volatil ; n’envoyez donc pas les deux requêtes simultanément. Si la répétition séquentielle produit encore un miss, attendez quelques secondes et réexécutez une seule fois ce bloc exact.
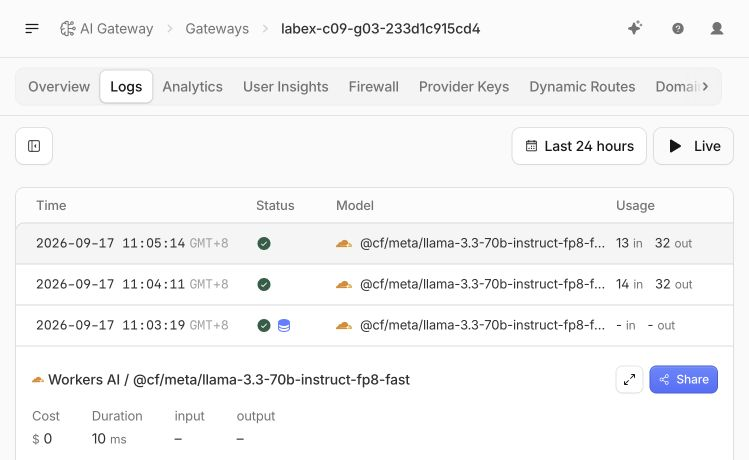
Ouvrez la vue Logs de la passerelle dans le tableau de bord. Repérez les deux requêtes public-faq et comparez leurs indicateurs de cache, leur durée et leur consommation de jetons. Une ligne doit afficher le miss associé au modèle et l’autre le hit provenant du cache.
Modifier la question et observer un nouveau miss
Dans cette étape, vous allez modifier uniquement l’invite. Le corps complet de la requête participe à la clé de cache par défaut ; cette nouvelle question ne doit donc pas recevoir la réponse précédente.
GATEWAY_TOKEN=$(cat .labex/gateway-token)
UPSTREAM_TOKEN=$(cat .labex/upstream-token)
METADATA='{"lab":"g03-cache","case":"changed-question","synthetic":true}'
STATUS=$(curl --http1.1 -sS -D .labex/changed-headers.txt \
  -o .labex/changed-response.json -w '%{http_code}' \
  -H "cf-aig-authorization: Bearer $GATEWAY_TOKEN" \
  -H "Authorization: Bearer $UPSTREAM_TOKEN" \
  -H "cf-aig-metadata: $METADATA" \
  -H 'Content-Type: application/json' \
  --data '{"prompt":"In one short sentence, name one benefit of an AI gateway.","max_tokens":32}' \
  "https://gateway.ai.cloudflare.com/v1/$ACCOUNT_ID/$GATEWAY_ID/workers-ai/$MODEL")
unset GATEWAY_TOKEN UPSTREAM_TOKEN METADATA
printf '%s\n' "$STATUS" | tee .labex/changed-status.txt
awk 'BEGIN{IGNORECASE=1} /^cf-aig-cache-status:/ {gsub("\r","",$2); print toupper($2)}' .labex/changed-headers.txt \
  | tail -1 | tee .labex/changed-cache-status.txt
node -e 'const b=require("./.labex/changed-response.json"); console.log(b.result?.response ?? b.result)'
Vous devez obtenir HTTP 200 et MISS. Ce comportement fondé sur l’identité exacte est volontairement plus strict que la similarité sémantique : deux questions qui semblent liées ont malgré tout des corps différents et des entrées de cache différentes.
Ne remplacez pas la clé par défaut par une clé commune telle que support-answer pour des invites personnalisées. Une clé personnalisée n’est sûre que lorsque chaque requête regroupée sous cette clé est autorisée à recevoir la même réponse.
Contourner le cache lorsque la fraîcheur est importante
Dans cette étape, vous allez revenir à la question d’origine, mais ignorer explicitement sa réponse mise en cache. Contourner le cache signifie « interroger le fournisseur maintenant », même si une entrée de cache valide existe. Cette fonction est utile lorsqu’une application a besoin d’une réponse fraîche pour une requête particulière.
L’en-tête cf-aig-skip-cache: true ne contrôle que cette requête. Il ne désactive pas le cache de la passerelle pour les autres appelants :
GATEWAY_TOKEN=$(cat .labex/gateway-token)
UPSTREAM_TOKEN=$(cat .labex/upstream-token)
METADATA='{"lab":"g03-cache","case":"fresh-bypass","synthetic":true}'
STATUS=$(curl --http1.1 -sS -D .labex/bypass-headers.txt \
  -o .labex/bypass-response.json -w '%{http_code}' \
  -H "cf-aig-authorization: Bearer $GATEWAY_TOKEN" \
  -H "Authorization: Bearer $UPSTREAM_TOKEN" \
  -H "cf-aig-metadata: $METADATA" \
  -H 'cf-aig-skip-cache: true' \
  -H 'Content-Type: application/json' \
  --data '{"prompt":"In one short sentence, what does an AI gateway do?","max_tokens":32}' \
  "https://gateway.ai.cloudflare.com/v1/$ACCOUNT_ID/$GATEWAY_ID/workers-ai/$MODEL")
unset GATEWAY_TOKEN UPSTREAM_TOKEN METADATA
printf '%s\n' "$STATUS" | tee .labex/bypass-status.txt
awk 'BEGIN{IGNORECASE=1} /^cf-aig-cache-status:/ {gsub("\r","",$2); print toupper($2)}' .labex/bypass-headers.txt \
  | tail -1 | tee .labex/bypass-cache-status.txt
node -e 'const b=require("./.labex/bypass-response.json"); console.log(b.result?.response ?? b.result)'
Vous devez obtenir HTTP 200 et aucun HIT. Selon la réponse actuelle de la passerelle, l’en-tête peut indiquer un contournement ou rester simplement différent d’un hit ; le journal de la passerelle fait foi et doit afficher cached: false pour fresh-bypass.
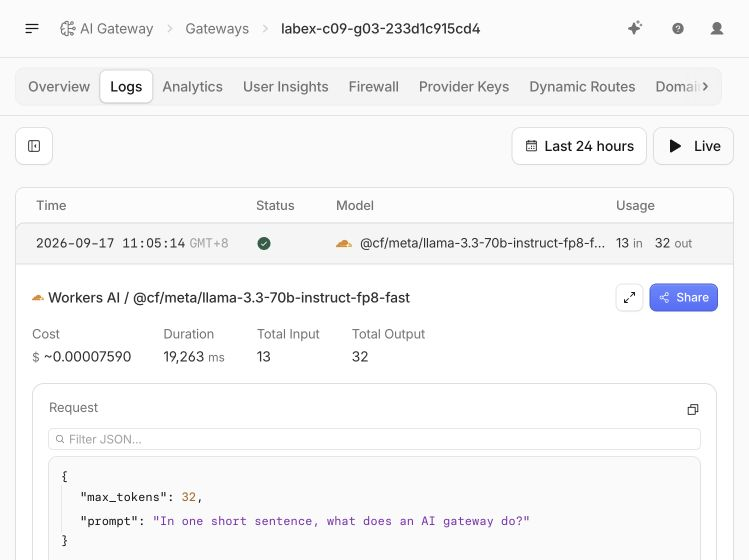
Retournez dans Logs du tableau de bord et ouvrez la requête fresh-bypass. Comparez-la à la ligne public-faq mise en cache. La même question a atteint Workers AI, car le contournement appliqué à cette requête a remplacé le comportement par défaut de la passerelle.
Supprimer la passerelle temporaire
Dans cette étape, vous allez supprimer la passerelle alors que l’identifiant de gestion peut encore prouver sa disparition. La suppression de cette passerelle dont vous êtes propriétaire supprime également son espace de noms de cache temporaire et ses journaux.
ACCOUNT_ID=$(node -p 'JSON.parse(require("fs").readFileSync(".labex/state.json")).accountId')
GATEWAY_ID=$(node -p 'JSON.parse(require("fs").readFileSync(".labex/state.json")).gatewayId')
GATEWAY_TOKEN=$(cat .labex/gateway-token)
curl --http1.1 -fsS -X DELETE \
  -H "Authorization: Bearer $GATEWAY_TOKEN" \
  "https://api.cloudflare.com/client/v4/accounts/$ACCOUNT_ID/ai-gateway/gateways/$GATEWAY_ID" \
  | node -e 'let s="";process.stdin.on("data",d=>s+=d).on("end",()=>{const b=JSON.parse(s);if(!b.success)process.exit(1);console.log("gateway deletion accepted")})'
unset GATEWAY_TOKEN

GATEWAY_TOKEN=$(cat .labex/gateway-token)
curl --http1.1 -fsS \
  -H "Authorization: Bearer $GATEWAY_TOKEN" \
  "https://api.cloudflare.com/client/v4/accounts/$ACCOUNT_ID/ai-gateway/gateways" \
  > .labex/gateways-after-delete.json
unset GATEWAY_TOKEN
node -e 'const b=require("./.labex/gateways-after-delete.json"),id=process.argv[1],found=(b.result||[]).some(g=>g.id===id);console.log("gateway absent:",!found);if(found)process.exit(1)' "$GATEWAY_ID"
Vous devez obtenir gateway absent: true. Cet inventaire authentifié permet de distinguer une suppression réelle d’une page absente en raison d’une déconnexion ou d’un problème réseau.
Supprimer le jeton et se déconnecter
Dans cette étape, vous allez révoquer l’identifiant cloud restant, supprimer les deux copies temporaires du jeton et déconnecter la machine virtuelle.
Dans le tableau de bord Cloudflare, ouvrez My Profile → API Tokens. Recherchez la valeur exacte enregistrée dans tokenName, ouvrez Actions, choisissez Delete, vérifiez la confirmation et supprimez uniquement ce jeton. Vous pouvez le révoquer maintenant sans risque, car la suppression de la passerelle est déjà confirmée.
Supprimez les fichiers contenant les jetons de la passerelle et du fournisseur en amont, puis mettez fin à l’autorisation distincte de Wrangler :
shred -u .labex/gateway-token .labex/upstream-token
npx wrangler logout
npx wrangler whoami --json || true
test ! -e .labex/gateway-token -a ! -e .labex/upstream-token \
  && echo "local token files removed"
Vous devez obtenir loggedIn: false et local token files removed. La session du tableau de bord est distincte et reste ouverte. À la fin de l’atelier, LabEx détruira cette machine virtuelle temporaire au lieu de l’enregistrer.
Résumé
Vous avez configuré un cache de réponses AI Gateway de courte durée pour une question publique sûre. La première requête a produit un MISS, la répétition exacte est devenue un HIT et la modification de l’entrée a créé une entrée distincte. Vous avez ensuite utilisé un contournement par requête lorsque la fraîcheur était importante et confirmé dans les journaux que la requête avait été traitée par le modèle, et non par la copie mise en cache.
Le prochain atelier ajoute des contrôles du trafic. Vous apprendrez la différence entre limiter la fréquence d’arrivée des requêtes et limiter la quantité de ressources du modèle qu’une passerelle peut dépenser, tout en conservant un volume et un coût de test volontairement faibles.


