はじめに
サポートチームは二重請求の報告に対する返信の下書きを必要としています。チケットを Bedrock Runtime に送り、指示を改善し、生成された返信を確認して、トークン使用量と出力上限を比較します。新しい LabEx VM の AWS CLI は設定済みです。ここで提供される合成チケットのみを使ってください。
コマンドの実行とテキストファイルの読み取りを理解している必要があります。目的は下書きの生成と確認であり、顧客への送信や請求記録の変更ではありません。
認定試験との関連
| 認定 | 試験タスク | 演習 |
|---|---|---|
| AI Practitioner (AIF-C01) | タスク 3.1、3.2 | 出力長を調整し、明確な執筆指示を与え、生成テキストを確認する。 |
サポート返信の下書きを作る
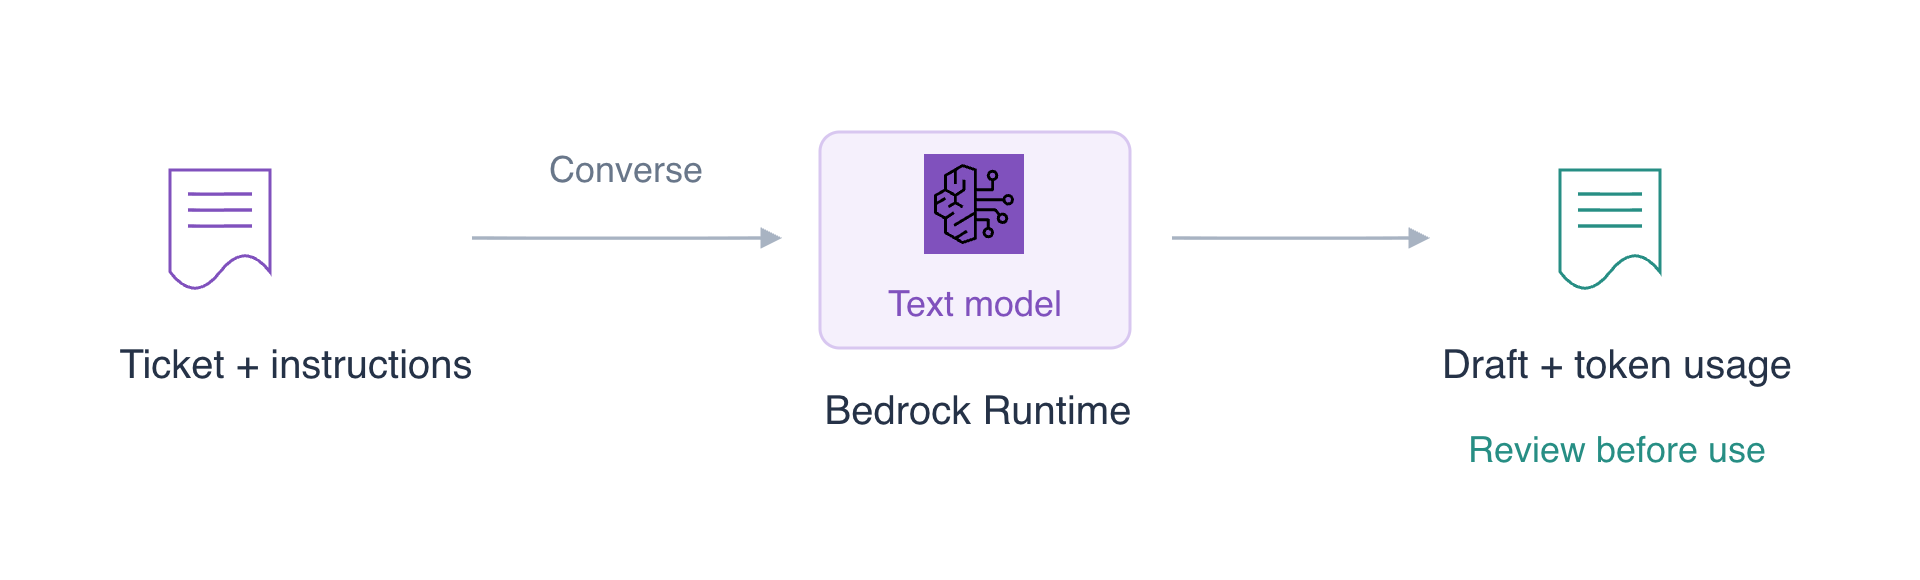
このステップでは利用可能なテキストモデルを選び、サポートチケットを Bedrock Runtime に送ります。
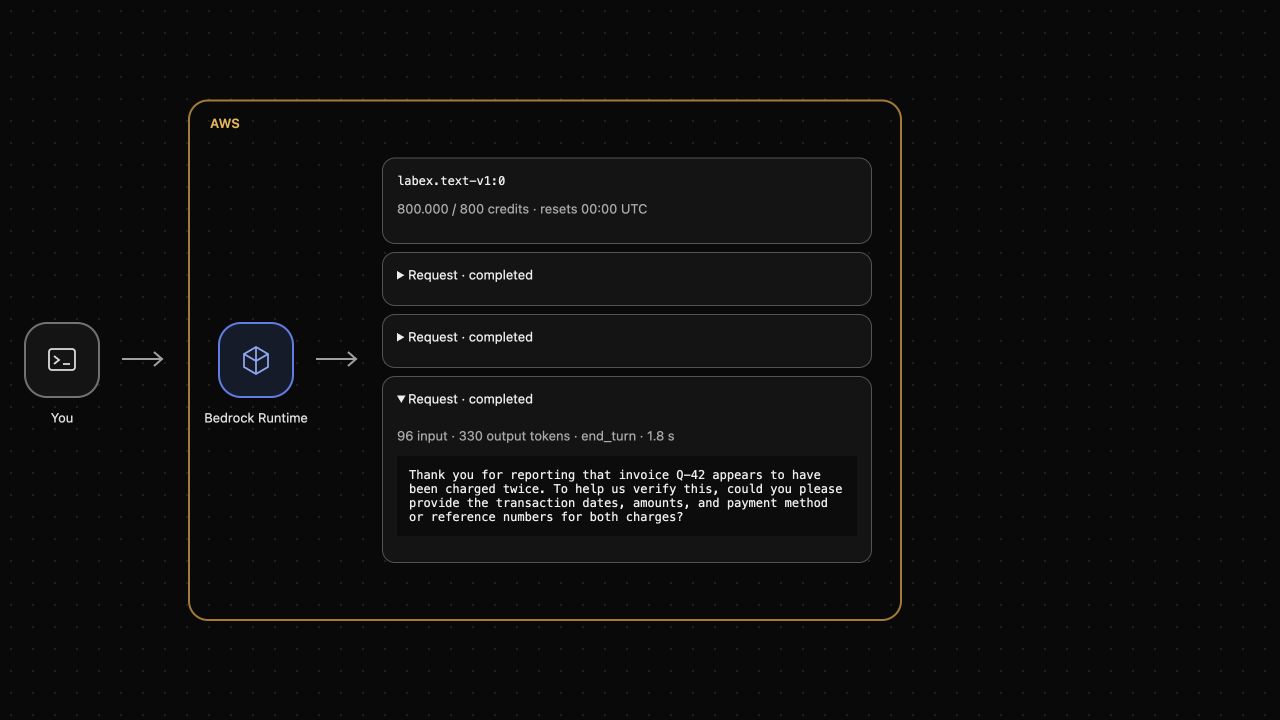
上部の AWS View はモデルと実際のリクエスト結果を表示します。下部の Terminal でコマンドを入力します。送信前は返信がありません。送信後は処理中のリクエスト、続いて応答、使用量、残り枠が表示されます。
Bedrock は、多様なタスクの文章を生成できる基盤モデルへのアクセスを提供します。モデル識別子でモデルを選びます。Converse は対応する対話モデルの共通リクエスト形式です。このワークスペースで利用できるテキストモデルを使います。
演習ディレクトリに移動します。cd は Terminal の現在のディレクトリを変更します:
cd /home/labex/project
テキストを出力するモデルを一覧表示します。--by-output-modality TEXT はカタログを絞り込み、--query は識別子と読みやすい名前を選択し、--output table は表で表示します:
aws bedrock list-foundation-models \
  --by-output-modality TEXT \
  --query 'modelSummaries[].[modelId,modelName]' \
  --output table
表には、この後使う labex.text-v1:0 が含まれます。カタログ項目はモデルの説明であり、推論リクエストが既に実行されたことを意味しません。
Converse リクエストには modelId、messages のリスト、任意の推論設定が含まれます。各メッセージには role とコンテンツブロックがあります。user メッセージは質問やタスクを含み、テキストブロックは text フィールドを使います。maxTokens は生成出力の上限、temperature はサンプリングの変動を制御します。低い値で変動を減らせても、正確さや同じ返信は保証されません。
JSON リクエストを作ります。cat > request.json はファイルに書き込み、<<'EOF' は複数行をそのまま入力する開始マーカー、最後の EOF は終了マーカーです。指定された演習ファイルのみを置き換えます:
cat > request.json <<'EOF'
{
  "modelId": "labex.text-v1:0",
  "messages": [
    {
      "role": "user",
      "content": [{"text": "Customer ticket Q-42: the customer reports that invoice Q-42 was charged twice. Draft an English support reply in two sentences."}]
    }
  ],
  "inferenceConfig": {"maxTokens": 512, "temperature": 0}
}
EOF
bedrock-runtime converse で送信します。--cli-input-json file://request.json はファイルからリクエスト項目を読みます。最後の > reply.json は JSON 応答を画面に表示せず保存します:
aws bedrock-runtime converse \
  --cli-input-json file://request.json \
  > reply.json
Terminal のプロンプトが戻るまで待ちます。文章生成には通常数秒かかります。最初のリクエストが処理中の間は、別のリクエストを実行しないでください。
応答を読みます:
cat reply.json
output.message.role: "assistant" と空でない text ブロックを探します。usage は処理されたトークン、metrics.latencyMs はミリ秒単位の応答時間を示します。Terminal 上部の AWS View で完了したリクエストを展開し、返信をファイルと比較します。
下書きを注意深く読みます。調査開始、返金済み、請求確認済みなどと述べていませんか?チケットにはそれらの事実はありません。流暢な文章にも作られた詳細が含まれる場合があります。次に指示を具体化します。生成された文章を、実施済みの請求操作とみなさないでください。
執筆指示を改善する
このステップでは明確な指示を追加し、同じ報告事実から新しい下書きを生成します。
system フィールドはタスクと文体の指示を与えます。チケットはユーザーメッセージに残し、制約をシステムメッセージに入れます。具体的な指示で不要な詳細を減らせても、応答の確認は必要です。
元の下書きを比較用に残すため、別のリクエストを作ります:
cat > revised-request.json <<'EOF'
{
  "modelId": "labex.text-v1:0",
  "system": [
    {"text": "You draft customer-support replies. Use only the facts in the ticket. Write two concise English sentences. Acknowledge the customer's report and ask for information needed to verify it. Do not claim that a charge was confirmed, an investigation started or a refund issued."}
  ],
  "messages": [
    {
      "role": "user",
      "content": [{"text": "Customer ticket Q-42: the customer reports that invoice Q-42 was charged twice. No billing check or refund has been completed. Draft a reply."}]
    }
  ],
  "inferenceConfig": {"maxTokens": 512, "temperature": 0}
}
EOF
修正版の下書きを生成します:
aws bedrock-runtime converse \
  --cli-input-json file://revised-request.json \
  > revised-reply.json
Python 標準の JSON 整形ツールで保存された応答を確認します。このツールは有効な JSON かを確認し、読みやすく整形します:
python3 -m json.tool revised-reply.json
上部の AWS View で新しい完了リクエストを展開します。両方の下書きをチケットと比較します。修正版の指示で期待を明確にしても、この応答が従ったかは人が判断します。実施していない操作を作り出した文章は顧客への返信に使わないでください。
各リクエストは独立しています。同じモデルを使っても、前の応答が自動的に会話履歴として送られるわけではありません。会話を続ける場合、前のユーザーとアシスタントのメッセージを messages に明示的に含める必要があります。
トークン使用量と出力上限を確認する
このステップでは同じ執筆タスクを小さい出力上限で送り、実際の使用量を確認します。
トークン はモデルが処理するテキストの単位で、必ずしも単語 1 つではありません。入力トークンにはタスク、システム指示、提供された履歴が含まれます。出力トークンはモデルが報告する生成トークンで、内部推論を含む場合があります。返された totalTokens は入力と出力の合計です。
maxTokens は上限であり、その数だけ生成する要求ではありません。モデルは早く終了する場合があります。512 ではなく 384 トークンを上限とするリクエストを作ります:
cat > bounded-request.json <<'EOF'
{
  "modelId": "labex.text-v1:0",
  "system": [
    {"text": "You draft customer-support replies. Use only the facts in the ticket. Write two concise English sentences. Acknowledge the customer's report and ask for information needed to verify it. Do not claim that a charge was confirmed, an investigation started or a refund issued."}
  ],
  "messages": [
    {
      "role": "user",
      "content": [{"text": "Customer ticket Q-42: the customer reports that invoice Q-42 was charged twice. No billing check or refund has been completed. Draft a reply."}]
    }
  ],
  "inferenceConfig": {"maxTokens": 384, "temperature": 0}
}
EOF
送信して応答を保存します:
aws bedrock-runtime converse \
  --cli-input-json file://bounded-request.json \
  > bounded-reply.json
結果を確認します:
python3 -m json.tool bounded-reply.json
usage.outputTokens を 384 の上限と比較します。stopReason: "end_turn" は正常終了、"max_tokens" は上限到達を示し、文章が未完の場合があります。部分的な返信を完成した文書と決めつけないでください。
上部の AWS View は同じ使用量と残り credits を示します。Credits はモデル固有の入力と出力の消費に従い、トークン数だけで共通価格は決まりません。繰り返しリクエストはキャッシュされた結果を使う場合があり、トークン使用量があっても credits が減らないことがあります。上限はリクエストを制限しますが、小さくしても今回の短い返信が過去のすべての返信より少ないトークンを使うとは限りません。
失敗や使用量の不確実性がある場合、再試行前にエラーを確認してください。不確実なリクエストは予約枠を保持する場合があり、別の送信で消費が増える可能性があります。これらのアプリケーション処理は後の単元で学びます。
演習ファイルを削除する
このステップでは下書きの確認後にローカルのリクエストと応答ファイルを削除します。
Converse は推論リクエストを送り、削除すべきサーバーやデータベースを作りません。6 つの JSON ファイルはローカルの演習成果物です。削除してもトークン使用量は取り消されず、消費済み credits は戻りません。
rm は指定ファイルを削除します。次の名前を正確に使い、他のプロジェクトファイルを残します:
rm request.json reply.json revised-request.json revised-reply.json bounded-request.json bounded-reply.json
残った表示可能な項目を一覧にします:
ls
6 つのファイルは存在しないはずです。AWS View はこの VM の実際の完了結果と使用量を保持します。ローカルファイルを消しても、失敗が成功になったり、消費が消えたりはしません。
まとめ
Bedrock Converse で実際のテキストリクエストを送り、システム指示を改善し、返信と使用量を確認し、出力を制限してローカルファイルを削除しました。また、もっともらしい下書きと検証済みの業務事実を区別しました。応答は使用前に確認する必要があります。
詳しくは、AWS 公式ドキュメントを参照してください:Converse のメッセージ、指示、推論設定; Converse の応答内容、停止理由、使用量。