介绍
Northline Library 帮助读者发现图书、查询可借状态和预览预约。首页看起来正常时,读者仍可能无法查询。你的任务是监控这项用户结果,并仅在故障持续时通知团队。
具备基本终端操作能力即可。图书馆、Prometheus(采样与规则)、Blackbox Exporter(真实 HTTP 探测)、Alertmanager(通知投递)及本地收件箱均已准备好。你只需编辑两个简短 YAML 配置文件,无需开发应用、安装软件、邮件账号或外部通信。所有服务运行于一台训练实例,图书为合成数据,预约预览只读。
在 Library 操作读者页面,在 Workstation 输入命令,在 Monitoring 查看真实观测和 webhook 投递。网站与界面标签保留英文。课程各单元均独立开始。
监控读者的查询
本步骤选择面向顾客的探测。从 Library 开始,先使用正常业务,再选择检查读者实际需求的探测。
体验读者路径
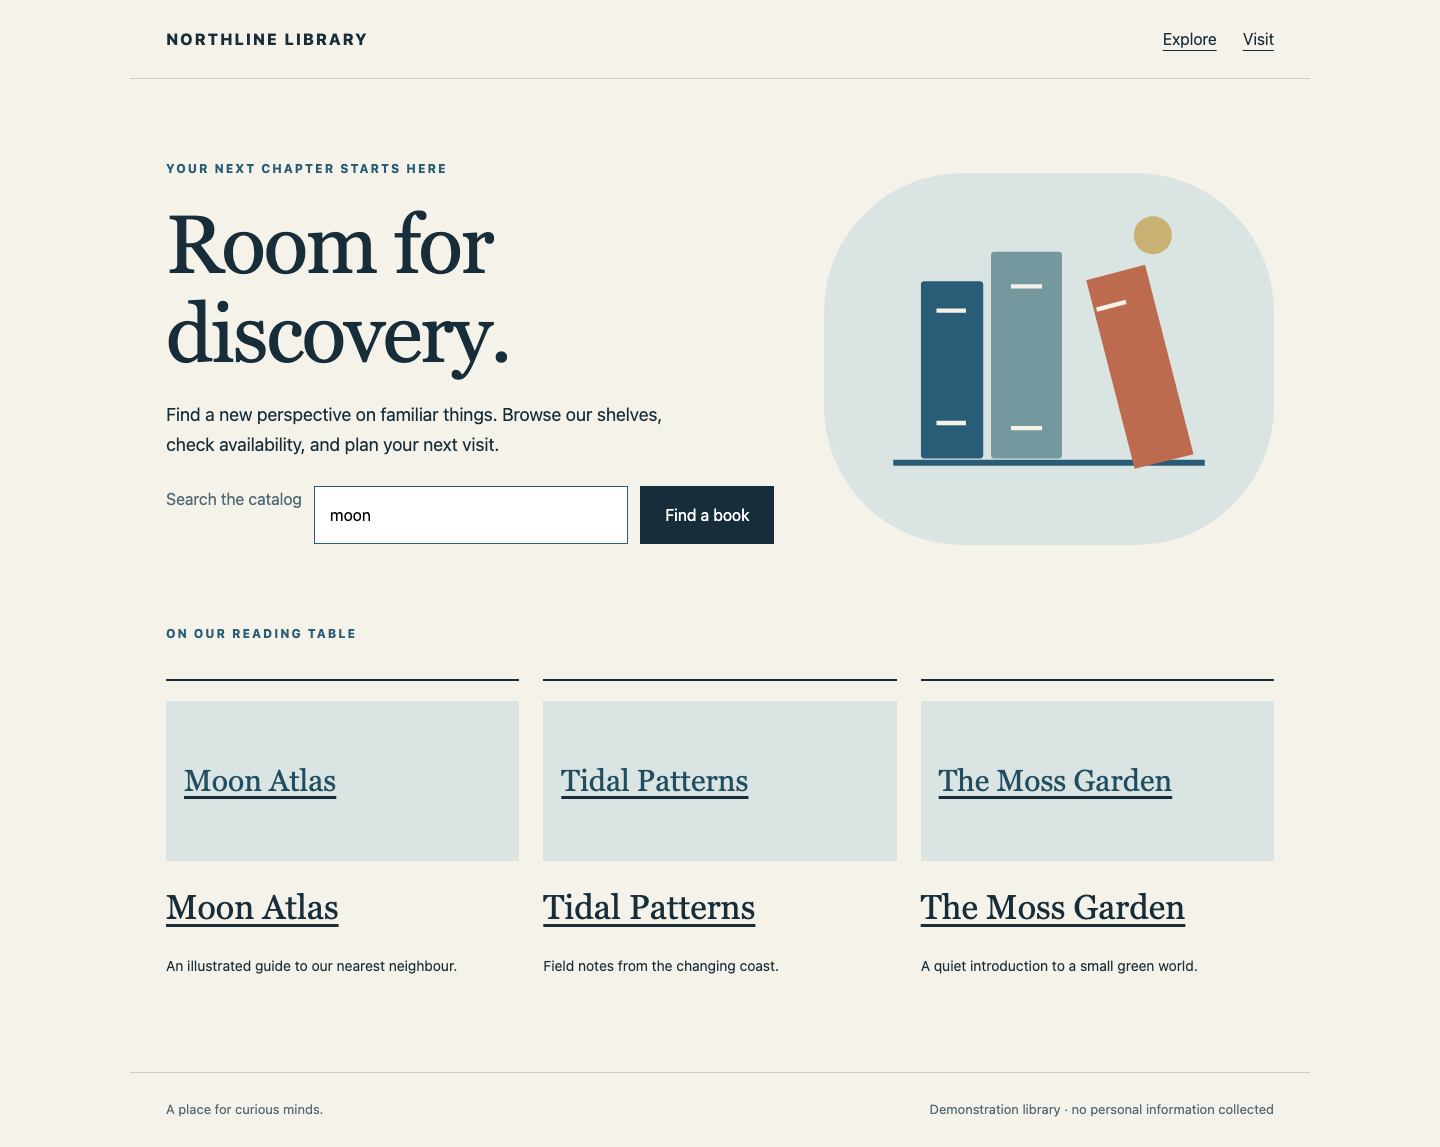
保留 Search the catalog 中的 moon,选择 Find a book。结果应包含 Moon Atlas、Available 和书架位置。打开 Moon Atlas,再选择 Check reservation:只读预览显示 Ready to collect: Moon Atlas,不会真的预约。选择 Back to book,再选择 NORTHLINE LIBRARY。打开 Visit 阅读开放时间,再用品牌链接返回。
理解探测
切换到 Workstation,终端已位于 /home/labex/project/library-watch。路径指向文件或目录;这个绝对路径从系统根目录开始。pwd 显示当前位置,ls 列出名称,cat 打印文件:
pwd
ls
cat prometheus.yml
这里有 prometheus.yml、alerts.yml 和 watch.sh。配置描述程序应如何运行。YAML 使用空格缩进、key: value 键值对和表示列表项的短横线,请保留下方缩进。无需使用编辑器:你将用完整文本块替换这个小配置。
HTTP 是浏览器使用的请求与响应协议。URL 包含地址、标识服务的端口和路径。在 Workstation 使用时,127.0.0.1 指本实验实例。端口 8081 提供图书馆;/search?q=moon 表示以查询参数 q 的值 moon 发起查询。终端中的 URL 保留引号,让 Shell 把它当成一个参数。
预设的 library job 目前只探测首页。job 是一组有名称的采样目标。端口 9115 上的 exporter 发起真实请求并返回 probe_success:1 表示成功,0 表示失败。其 search 模块要求正文含 Moon Atlas 和 Available,而不只是 HTTP 200。Prometheus 每 2 秒采样一次。另一个指标 up 只说明 Prometheus 能否从 exporter 采集,不能证明读者操作成功。
选择用户路径
cat > prometheus.yml 会替换文件。<<'YAML' 开始保留字面内容的 here-document:粘贴完整文本块,包括最后独占一行的 YAML。global 定义时间间隔,rule_files 指定规则,alerting 连接已准备的投递服务。保留这些支持设置,将探测模块与目标改为查询路径。journey: search 标签标识业务范围。
cat > prometheus.yml <<'YAML'
global:
  scrape_interval: 2s
  evaluation_interval: 2s
rule_files:
- /home/labex/project/library-watch/alerts.yml
alerting:
  alertmanagers:
  - static_configs:
    - targets: ['127.0.0.1:9093']
scrape_configs:
- job_name: library
  metrics_path: /probe
  params:
    module: [search]
    target: ['http://127.0.0.1:8081/search?q=moon']
  static_configs:
  - targets: ['127.0.0.1:9115']
    labels:
      journey: search
YAML
bash watch.sh reload 运行提供的辅助程序:先检查语法,再让 Prometheus 重新加载。它不会修改图书馆或伪造观测。
bash watch.sh reload
应看到 Configuration accepted。等待约 4 秒,切换到 Monitoring。Business probes 应显示 search: healthy。若重新加载报告 YAML 错误,返回 Workstation,用完整文本块替换文件,再重新加载。若采样 unavailable,等待后重试;不可用绝不表示健康。不要将目标指向 Monitoring 自身。
对比可访问与业务成功
切换到 Workstation。辅助程序的 fault search seconds 6 只让查询故障持续 6 个真实秒,然后自动恢复,不直接设置告警状态。curl 发送 HTTP 请求;-sS 隐藏进度但显示连接错误。运行:
bash watch.sh fault search seconds 6
curl -sS 'http://127.0.0.1:8081/search?q=moon'
正文显示 **Search is taking a break.**。服务器刻意仍返回 HTTP 200,仅检查状态码就会漏掉业务失败。立即切换到 Monitoring:一个采样间隔内,查询应变为 failed,恢复后回到 healthy。若错过短暂窗口,重复同样的 6 秒演练。此时尚未配置告警。等到健康后再检查本步骤。
仅在故障持续时告警
本步骤配置一条用户告警,通过等待过滤刚才的短暂故障。从 Workstation 开始。
读懂条件
Prometheus 每 2 秒计算规则。表达式 probe_success{job="library",journey="search"} == 0 选择 library job 中失败的查询采样。花括号内是标签筛选;== 0 选择失败而非成功。仅选择 up 会监控采集而非读者。省略标签则可能包含无关服务。
for: 20s 表示条件必须持续成立 20 秒。pending 表示条件已出现、仍在等待;firing 表示持续时间已满足;inactive 表示条件不存在。20 秒是本练习的短时设置,不是通用生产建议。Monitoring 将缺失的探测数据显示为 unavailable;它既不是服务健康证据,也不是业务失败采样。
alert 命名规则。severity 是路由标签,annotations.summary 说明对顾客的影响。写入完整规则:
cat > alerts.yml <<'YAML'
groups:
- name: readers
  rules:
  - alert: CustomerJourneyFailed
    expr: probe_success{job="library",journey="search"} == 0
    for: 20s
    labels:
      severity: page
    annotations:
      summary: Readers cannot complete search
YAML
bash watch.sh reload
应看到 Configuration accepted。若验证失败,修正空格或标点后重新加载;新配置被接受前,上一份有效配置继续生效。
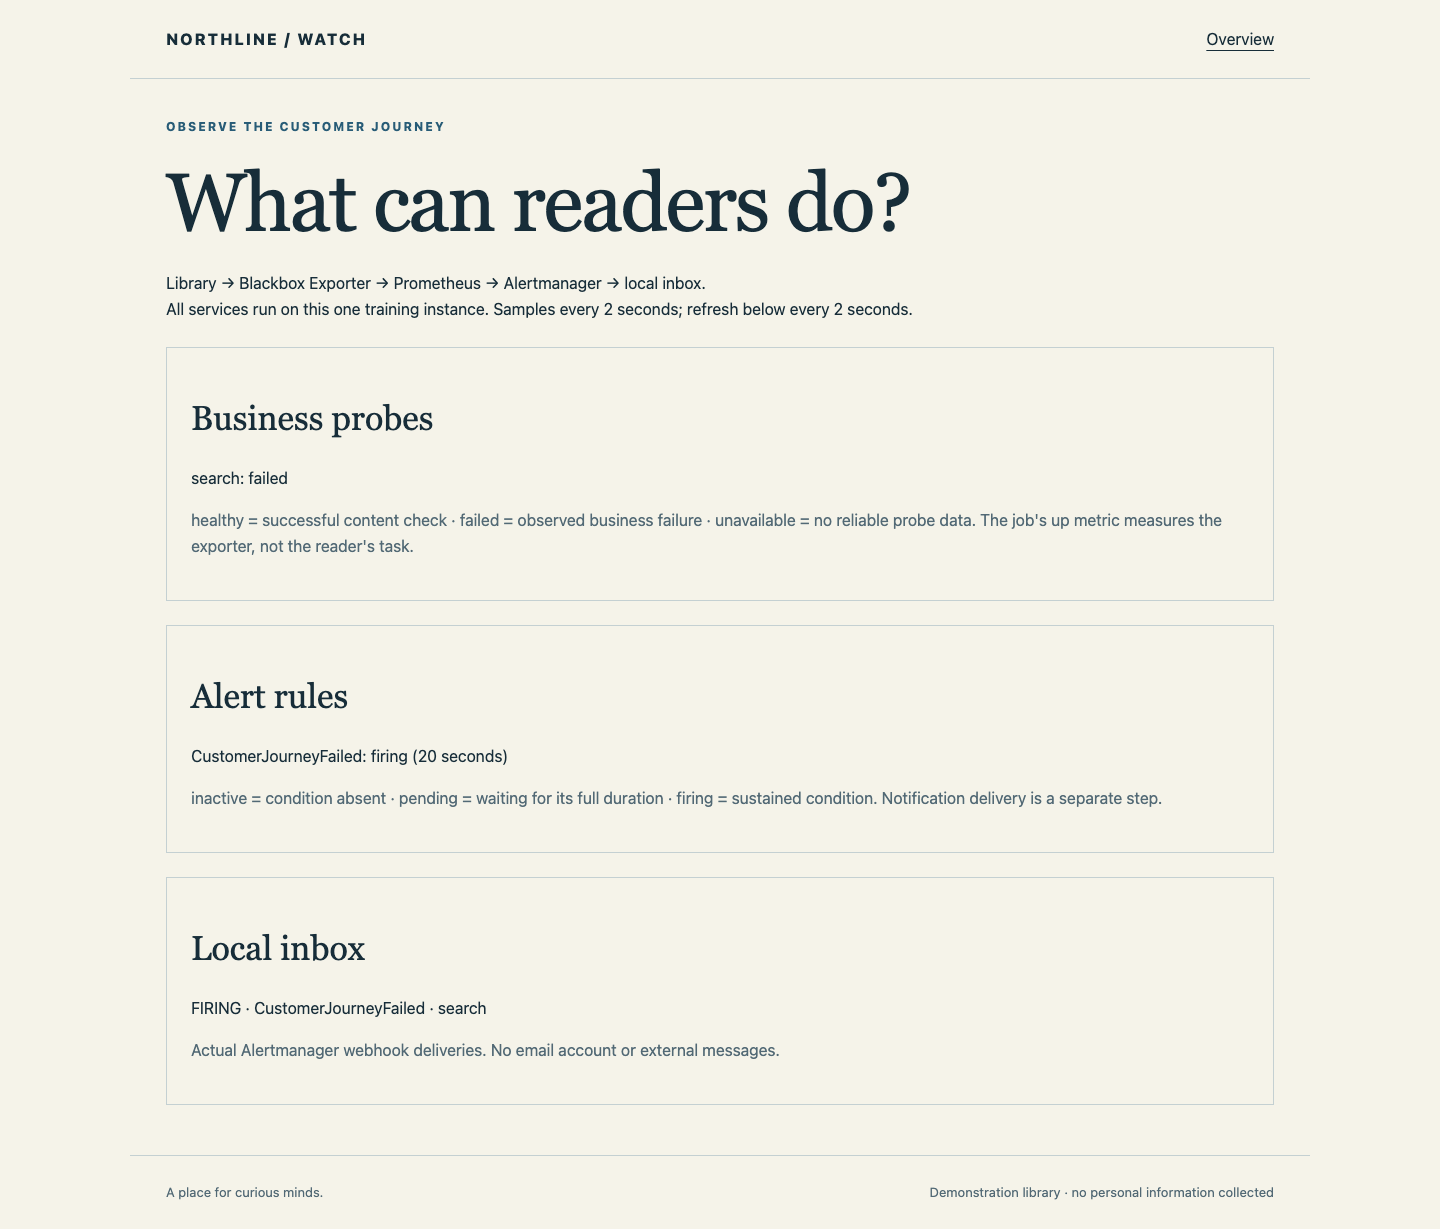
切换到 Monitoring。查询健康时,规则应显示 **CustomerJourneyFailed: inactive (20 seconds)**。本地收件箱仍应为空。
证明短故障不打扰
切换到 Workstation,重复同样的短暂业务故障:
bash watch.sh fault search seconds 6
立即切换到 Monitoring。查询变为 failed;规则可能短暂显示 pending。自动恢复后,探测与规则分别回到 healthy/inactive,收件箱保持为空。完整短演练约需 12 秒。若此前执行过长故障,旧通知会保留在收件箱:对比新增事件,不要删除证据。
规则 firing 与通知送达是不同事实。Alertmanager 接收 firing 告警、分组,对新组等待 1 秒,再投递到本地 webhook 收件箱。采样、规则计算和投递分别增加少量延迟。不要仅因通知没有立即出现就删除 for 或降低所有阈值。
接收故障及恢复通知
本步骤演练持续故障并观察真实通知投递。从 Workstation 开始。
观察持续故障
下一次故障持续 60 个真实秒,留出观察各状态的时间。只有读者查询失败,首页仍正常。
bash watch.sh fault search seconds 60
切换到 Library,用品牌链接返回首页:看起来仍正常。再次查询 moon,故障消息证明读者无法使用目录。切换到 Monitoring。查询显示 failed,规则先进入 pending。首次失败采样后约 20 秒变为 firing;随后本地收件箱应新增 FIRING · CustomerJourneyFailed · search。从故障开始算,允许最多 35 秒完成采集、计算与投递。这些是真实观测,不是进度动画。
若 35 秒后收件箱仍为空,切换到 Workstation,使用辅助程序的只读状态命令:
bash watch.sh status
查看 checks 与 alerts:unavailable 表示采集缺失;pending 表示持续时间未到;firing 却没有收件箱事件则应关注投递。重新阅读配置;如有修改,再重新加载。60 秒故障到期后可以重复。不要伪造收件箱消息或停止监控。
恢复并确认解除
切换到 Workstation。零秒可立即恢复查询,不必等待自动到期:
bash watch.sh fault search seconds 0
切换到 Library,从首页再次查询 moon。Moon Atlas 和 Available 必须重新出现。再次打开图书及预约预览,Visit 也必须继续可用。
切换到 Monitoring。约 10 秒内,查询恢复 healthy,告警变为 inactive,收件箱新增 RESOLVED · CustomerJourneyFailed · search。原 firing 通知仍保留;resolved 表示本次故障解除,不保证图书馆以后永不失败。
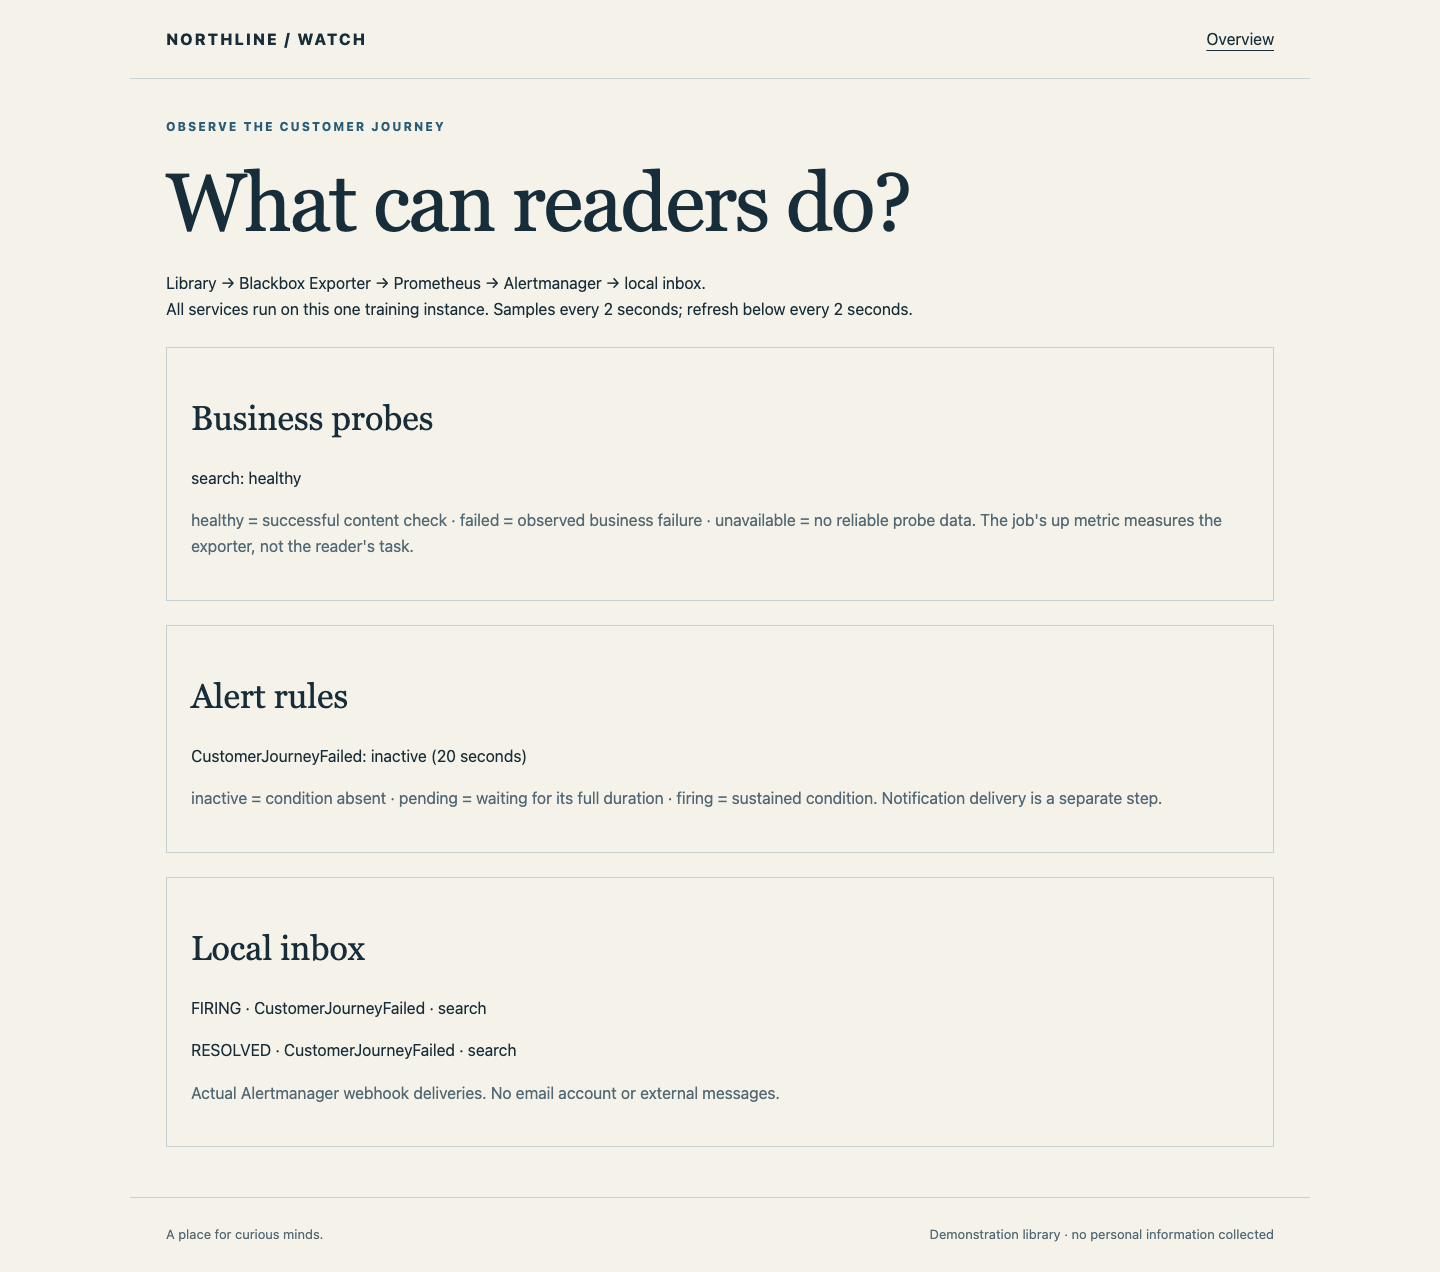
本步骤检查真实送达的 firing/resolved 事件对和当前可用的图书馆,还以隔离的健康、短故障、持续故障、恢复、缺数据和无关失败采样测试已加载规则。评分不会注入故障、恢复服务或修改配置。保持图书馆健康,并让规则继续等待未来故障。
总结
你选择了真实用户查询及检查正文的探测,用标签限定告警范围,忽略短故障,并接收了实际失败与恢复 webhook。你区分了 exporter 可用与业务可用,也区分了缺数据与成功。独立挑战会把这些方法应用到预约确认,并排除无关的故障服务。