介绍
按已分组人数比较,工作坊的 B 页面报名率更高。如果页面分配并未改变任何人的结果,仅凭随机分配,是否也可能产生看起来不同的两组?在生成真实随机差值的分布之前,先手动交换两个人的组别,可以把这个问题具体化。
这个独立环境已包含上一实验教过的正确个人结果构建函数和报名率比较函数,也有自己的原始数据。你需要理解这些概念,并掌握 Python 函数、基本 NumPy 数组和入门级 Matplotlib。不需要上一 VM 的文件,也不要求统计推断知识。你将保存 399 次探索性重新分配及其实际图表;本实验不计算 p 值,也不选择胜者。所有记录均为原创合成教学示例。55 分钟为作者估计,包含阅读和普通错误的修正时间。
交换组员并保持两组人数不变
本步骤中,你将计算六人的差值,交换两人的组别,观察比较结果为何会变化。
从 WebIDE 开始,打开 Terminal → New Terminal,进入本单元工作目录:
cd /home/labex/project/signup-experiment
cat 读取文件而不修改它。回顾示例访客卡片和两个准备好的函数:
cat warmup-visitors.csv
cat outcomes.py
cat compare.py
六张卡片中,A 的二元结果为 [1, 0, 0],B 为 [1, 1, 0]。每个 1 或 0 属于一位已分组的人;重复事件行不是额外的观察对象。A 有 1/3 的人报名,B 有 2/3,B−A 约为 +33.33 个百分点。
现在设想交换 A 的第二个人(结果为 0)与 B 的第一个人(结果为 1)的组别。A 变为 [1, 1, 0],B 变为 [0, 1, 0],差值约为 −33.33 个百分点。每组仍有三人,总正结果仍有三个。你改变的是分配,而非个人结果或样本量。
编写差值函数。np.mean 计算 NumPy 数组中二元值的平均数。B 的均值减去 A 的均值,再乘以 100,得到百分点差。sample_null 的占位实现会在下一步完成;定义函数并不会执行它。
Shell 的 > 会替换文件。带引号的 here-document <<'PY' 将整个块复制到结尾 PY 之前,不进行 Shell 展开。也可以在 WebIDE 中用 File → Save 保存相同内容。
cat > resample.py <<'PY'
import numpy as np


def difference(a, b):
    return float(100 * (np.mean(b) - np.mean(a)))


def sample_null(a, b, draws=399, seed=17):
    raise NotImplementedError("Complete this function in the next step.")
PY
运行器的 contrast 阶段提供原始卡片及刚才描述的那次交换,调用函数两次,并保存两个真实结果:
python3 run.py contrast
读取器显示已保存产物,不重新构建它:
python3 show_results.py contrast
预期 original_pp 接近 +33.33,swapped_pp 接近 −33.33。它们都不是对真实的人换用另一个页面后会发生什么的预测。它们表明,即使六个人的结果固定不变,组别组成仍能改变比较结果。
可以编辑 resample.py,随后编辑 plot.py,或在旁边添加普通 Python 辅助文件。保留原始 CSV、设置、数据字典、运行器和读取器。如果目录有误,用 pwd 和 ls 查看,再重复上面的 cd。重新复制完整函数块可以修复编辑错误;setup 会拒绝覆盖已有工作目录。
生成真实的重新分配
本步骤中,你将反复把完整访客结果重新打乱,按原人数分成两组,并保存每次产生的差值。
继续使用同一个 WebIDE 终端,工作目录为 /home/labex/project/signup-experiment。完整固定样本有 12 位已分组的人,每组六人。准备好的结果函数使用完整七天窗口。若想再次定位边界事件和无事件人员,可以阅读完整原始输入:
cat assignments.csv
cat events.csv
本练习使用的无效应零假设认为,页面分配不改变任何人的二元结果。因此,在两组间重新分配这些固定的个人结果,可以展示仅由分配产生的波动。这个假设依赖于合成记录所表示的随机实验设计。把任意观察性网站日志打乱,并不能创造一个随机实验。
np.concatenate([a, b]) 合并两个数组。np.random.default_rng(seed) 创建具有可复现起始状态的伪随机数生成器。它的 permutation 方法返回打乱后的副本,不会修改合并后的原数组。切片 shuffled[:len(a)] 取出与 A 组原人数相同的前一段;shuffled[len(a):] 取出 B 组大小的剩余部分。每次抽取都恰好使用每个人一次,并保留两组人数。不要打乱存在重复人员的原始事件行。
用两个完整函数替换文件。for 循环执行所要求次数的抽取;append 保留每个计算出的差值。返回数组会保留完整样本,而不只是其均值或某次有利的抽取。
cat > resample.py <<'PY'
import numpy as np


def difference(a, b):
    return float(100 * (np.mean(b) - np.mean(a)))


def sample_null(a, b, draws=399, seed=17):
    pooled = np.concatenate([a, b])
    rng = np.random.default_rng(seed)
    differences = []
    for _ in range(draws):
        shuffled = rng.permutation(pooled)
        differences.append(difference(shuffled[:len(a)], shuffled[len(a):]))
    return np.array(differences)
PY
运行器在完整个人级样本上调用这些函数,保存实际组别人数、观测差值和 399 个打乱后的差值。--seed 提供可复现的起始状态;两个连字符表示具名命令选项。
python3 run.py sample --seed 17
python3 show_results.py sample
完整数据仍是 A 的六人中一人报名、B 的六人中五人报名,观测差值接近 +66.67 个百分点。null_count 必须为 399。为便于显示,读取器仅在 null_preview 中列出前八次抽取;完整数组保存在 output/sample.json。
再生成一次普通样本,观察为什么某个 seed 不是权威答案:
python3 run.py sample --seed 42
python3 show_results.py sample
这会用实际 seed-42 运行替换保存的样本。序列通常会变化,但原个人结果、组别人数和观测比较不变。再次使用相同 seed 必须重现相同序列。允许任意非负且可复现的 seed,以及等效的独立采样实现;不要求作者的特定序列。不要反复运行以挑出看起来支持某页面的样本。后续精确分析使用全部分配,而非看起来最好的探索样本。
每个打乱后的统计量都在 −100 到 +100 个百分点之间,但并非区间内每个数都能取到。六人热身示例的全部 20 种三对三不同分配,在差值 −100, −100/3, +100/3, +100 处分别有 1, 9, 9, 1 次。完整 12 人样本有 924 种分配:差值 −100, −200/3, −100/3, 0, +100/3, +200/3, +100 处的次数分别为 1, 36, 225, 400, 225, 36, 1。下一实验会精确计算,而不是要求你记住这些次数。
在本探索性训练任务中,每个可取差值的样本频率与精确参考频率的绝对比例差至多为 0.15。例如,0.40 与 0.46 相差 0.06。这是特意放宽的训练验收容差,不是置信区间、显著性阈值、业务保证,也不是选择 seed 的标准。它允许普通样本和独立方法,不要求数组完全一致。在有效的全零示例中,每次重新分配的差值都为零;无需产生非零离散程度。
函数契约适用于提供的二元数组及同一有界课程范围内的变体:每组至少两人、总人数至多 14。检查使用隔离输入和 seed,覆盖其他组别人数、负差值与零差值以及退化结果。它们不会替换现场样本。本实验既不要求,也不评分抽样 p 值。
绘制已保存的分配差值
本步骤中,你将显示每个差值对应的真实抽样次数,并标出不变的观测比较位置。
继续使用同一个 WebIDE 终端,工作目录为 /home/labex/project/signup-experiment。np.unique(..., return_counts=True) 返回已保存差值中的不同取值及其出现次数。这是一张离散计数图:纵轴表示 399 次重新分配中,各差值出现了多少次。它不是效应的置信区间。
绘图函数接收保存的结果与输出路径。为保持可读,PNG 至少为 500 × 250 像素。figsize=(9, 4.5) 以英寸设置画布大小。DPI(每英寸点数)设置保存的栅格分辨率:每英寸 140 像素,对应约 9 × 140 乘 4.5 × 140,即 1260 × 630 像素。Matplotlib 的 subplots 创建画布与坐标轴。bar 绘制次数,axvline 标记观测差值,并不把它当成另一个分配次数。标签与可见图例标明该记号的含义。固定横轴范围 −110 到 +110 为每个可能的二元报名率差留出空间,即使有限样本中没有出现某个极端值。纵轴从零开始;tight_layout 为标签留出空间,随后 savefig 写出真实 PNG。
cat > plot.py <<'PY'
import numpy as np
import matplotlib.pyplot as plt


def make_plot(result, destination):
    differences, counts = np.unique(result["null"], return_counts=True)
    fig, ax = plt.subplots(figsize=(9, 4.5))
    ax.bar(differences, counts, width=8, color="#6374cc", edgecolor="white")
    ax.axvline(result["difference_pp"], color="#cc5b43", linewidth=2,
               label="Observed B − A")
    ax.set_xlabel("B − A (percentage points)")
    ax.set_ylabel("Number of reassignments")
    ax.set_title("Random reassignments of the fixed visitor outcomes")
    ax.set_xlim(-110, 110)
    ax.set_ylim(0, float(max(counts)) * 1.2)
    ax.legend()
    fig.tight_layout()
    fig.savefig(destination, dpi=140)
    plt.close(fig)
PY
读取已经保存的样本,并用你的函数绘图:
python3 run.py plot-sample
在 WebIDE 的文件浏览器中展开 signup-experiment/output,打开 sample.png。阅读两个坐标轴标签。多数次数应集中在接近零的差值附近;红色观测记号仍接近 +66.67 个百分点。样本未出现的取值,其次数为零,不表示遗漏了某个人。保存的数据仍代表全部 399 次抽取和原来的 12 个人。
下方参考图使用刚才运行的 NumPy seed-42 示例。其他允许的采样器或 seed 可能改变柱高;你保存的文件必须展示自己真实的抽取结果。
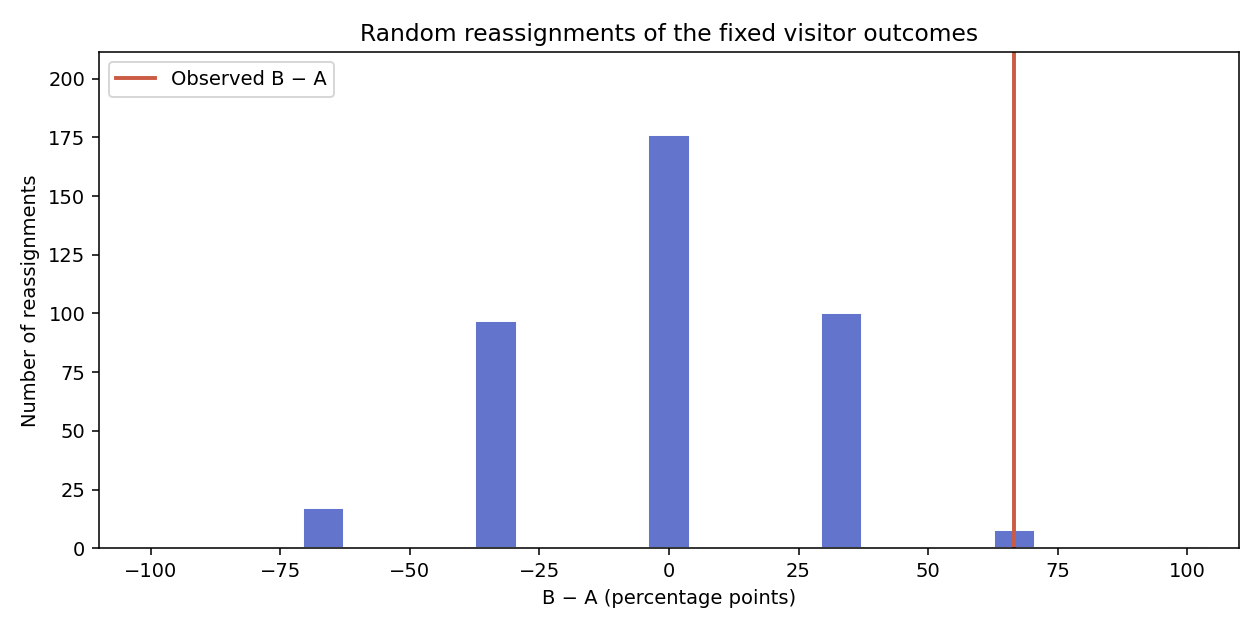
保存的 PNG 必须能由当前绘图函数和保存的样本复现。可以在真实差值位置使用可读的柱、计数折线或计数点,并在观测差值处绘制标有 Observed 的可见线或点。把所有可能差值及观测记号保留在显示范围内,保留零次数基线,并标注两个坐标轴。隐藏记号、裁掉数据、复制无关图片,或画密度却标成次数,都不算完成任务。
如果 PNG 缺失,先确认 python3 show_results.py sample 能读取已保存样本,再重新执行绘图命令。读取器本身不会生成缺失文件。下一实验会把精确分配分布与观测结果比较,并学习这些证据能说明什么、不能说明什么。
总结
你手动交换了两人的组别,生成了 399 次真实且保持组别人数的访客重新分配,并把保存的差值与观测比较一起绘图。可复现 seed 使一次运行能够重复,但它不负责选择答案或胜出页面。你现在已具备阅读下一实验精确证据所需的直觉。