介绍
探索性重新分配图说明,即使访客结果固定,也能得到不同的组别比较。本实验继续向前:数出这个固定小样本中每一种不同分配,定义一个精确的双侧 p 值,并记录证据支持什么。
这个独立环境已准备好正确的个人结果构建函数与比较函数。你需要理解前面实验中的个人级窗口、百分点差和保持组别人数的重新分配,并掌握基本 Python、NumPy 和 Matplotlib。不需要先前 VM 的文件,也不要求预先了解 p 值。这些记录是原创合成教学示例,不是真实业务实验;较大的观测差值或较小的 p 值都不能提供生产保证。55 分钟为作者估计,包含阅读和普通错误的修正时间。
统计每一种不同分配
本步骤中,你将用完整分配分布替代有限随机样本,并计算按明确定义得到的双侧 p 值。
从 WebIDE 开始,打开 Terminal → New Terminal,进入工作目录:
cd /home/labex/project/signup-experiment
查看检验结果之前,先阅读源数据定义与设置:
cat data-dictionary.md
cat config.json
分析使用一个固定且所有随访均已结束的样本,每个人只有一个二元报名结果。后续解释使用事先选定的 alpha = 0.05。Alpha 是本练习约定的比较阈值,不表示页面有效的概率为 95%。它并非搜索到有利结果后才选定。看到比较结果后,不要改变数据、分析时刻、阈值或总体。
在本练习的无页面效应零假设下,无论被分配哪个页面,每个人的结果都不变。因此,记录所代表的随机设计允许在保持两组人数的同时,重新分配这些固定结果。这种推断不会自动适用于任意非随机观察日志。
精确分配分布包含把这些人分进两组的每一种不同方式。对基于均值的统计量而言,组内顺序不增加新的分配。Python 的 math.comb(n, k) 计算从 n 人中选择 k 人的方法数。这里从 12 人中选出 A 的六人,也就确定了 B 的六人。
python3 - <<'PY'
from math import comb
print("Distinct allocations:", comb(12, 6))
print("Course maximum:", comb(14, 7))
PY
本实验有 924 种分配;任何提供的课程示例都至多有 3432 种。在特意限定的小规模下,精确枚举是可行的;这不表示该方法承诺能枚举任意大的生产样本。
对于以百分点表示的 B−A 统计量,本课程采用 SciPy 明确的 two-sided 约定:
先求精确分配差值中小于或等于观测差值的比例,再单独求大于或等于它的比例。取两个比例中较小的一个,乘以二,并将结果上限设为 1。
相等值分别计入两侧尾部。这是一种明确的双侧 p 值定义,并非所有定义都相同。对不对称离散分布,统计 abs(null) >= abs(observed) 并不总是等效。例如,A 有两人且无人报名,B 有五人且两人报名,观测差值为 +40 个百分点。21 种分配得到差值 −100 一次、−30 十次、+40 十次。按本定义,p 值为 2 * 10 / 21 = 20/21;按绝对值尾部计数则为 11/21。不能悄悄改变分组或定义,以获得更小的数值。
使用已准备好的 SciPy permutation_test 接口。permutation_type="independent" 在独立组之间重新分配观察值,同时保持组别人数;它不把访客当成配对测量。vectorized=False 表示统计函数接收普通一维数组。n_resamples=np.inf 请求完整有限分布,而非 399 次随机抽取。alternative="two-sided" 选择上述约定。这种精确枚举不需要随机 seed。
DataFrame 选择操作 .loc[mask, "signed_up"] 取出匹配人员的该列;.to_numpy() 将其值变为一维 NumPy 数组。内部的 statistic 函数使用与上一实验相同的差值公式,并在这里完整定义,因此本单元不依赖另一 VM 的 resample.py。
result.statistic、result.pvalue 和 result.null_distribution 是实际计算结果。保留未舍入数值;.tolist() 把数组转换为可用于 JSON 的列表,不会移除不同分配所产生的重复差值。
Shell 的 > 替换文件;带引号的 here-document <<'PY' 复制完整内容直到最后的 PY,不进行 Shell 展开。也可以在 WebIDE 中编辑文件,再使用 File → Save 保存。
cat > inference.py <<'PY'
import numpy as np
from scipy.stats import permutation_test


def analyze(people):
    a = people.loc[people["group"] == "A", "signed_up"].to_numpy()
    b = people.loc[people["group"] == "B", "signed_up"].to_numpy()

    def statistic(x, y):
        return float(100 * (np.mean(y) - np.mean(x)))

    result = permutation_test(
        (a, b), statistic,
        permutation_type="independent",
        vectorized=False,
        n_resamples=np.inf,
        alternative="two-sided",
    )
    return {
        "difference_pp": float(result.statistic),
        "pvalue": float(result.pvalue),
        "null": result.null_distribution.tolist(),
    }
PY
运行器的 distribution 阶段调用分析并保存实际结果,此时还不要求解释函数:
python3 run.py distribution
读取器显示现有数据,仅在终端显示时省略长数组:
python3 show_results.py exact
预期有 12 人,A、B 的报名人数比例分别为 1/6 和 5/6,观测差值接近 +66.67 个百分点,null_count 为 924,p 值接近 0.08009。完整分布仍在 output/analysis.json 中。下一步会添加解释字段。
可以编辑 inference.py、plot.py,或在旁边添加普通 Python 辅助文件。保留源 CSV、设置、数据字典、运行器和读取器。准备好的 outcomes.py、compare.py 实现了前面教过的函数;只要保持公开的 DataFrame/对象契约及有效结果,也接受等效实现。隔离检查覆盖有界范围内的其他组别人数、相反方向、零差值和全零结果。固定 p 值或固定分布不是可复用分析。
遇到普通路径或文件名错误时,用 pwd、ls 查看,再重复起始 cd 并重新复制完整代码块。Setup 不是编辑恢复工具:它会明确拒绝覆盖已有工作目录。
区分证据与确定结论
本步骤中,你将添加透明的解释规则,使结果能支持任一方向,也能报告证据不足。
继续使用同一个 WebIDE 终端,工作目录为 /home/labex/project/signup-experiment。p 值描述的是在选定零假设和分配设计下的一种比较。它不是零假设为真的概率,不是没有页面效应的概率,也不是对下一场工作坊的保证。
这里约 +66.67 个百分点的观测差值看似很大,但精确 p 值约为 0.08009。在这个固定小样本和事先选定的 alpha0.05 下,练习报告证据不足以作出明确结论。这并不能证明两个页面相同。它表示这个检验和样本没有达到所选定的、反对零假设的证据水平。
使用以下明确的输出标签:
- p <= alpha 且差值为正时,返回
evidence_for_b; - p <= alpha 且差值为负时,返回
evidence_for_a; - 其他情况返回
inconclusive,包括差值为零。
等于阈值时属于证据分支:p == alpha 满足 <=。比较前不要舍入 p 值。这些标签只解释有界分析结果,并不是自动的业务上线决策。另一个有效实验可能支持 A,也可能两个页面都不支持;不要求任何标签偏向 B。
Shell 的 >> 会向已有文件追加内容,而非替换。下面的完整代码块把 conclude 加在 analyze 后面;只粘贴一次。如果使用 WebIDE 编辑,在文件末尾添加函数并保存。Python 的 and 要求两个条件同时满足,分支才返回标签。
cat >> inference.py <<'PY'


def conclude(difference_pp, pvalue, alpha):
    if pvalue <= alpha and difference_pp > 0:
        return "evidence_for_b"
    if pvalue <= alpha and difference_pp < 0:
        return "evidence_for_a"
    return "inconclusive"
PY
通过解释阶段再次运行精确分析。这会有意把结果文件替换为当前完整分析,并加入标签:
python3 run.py exact
python3 show_results.py exact
对这个完整样本,结果必须为 inconclusive。观测差值、原始 p 值和 924 个分配差值保持不变。不要通过删除人员、选择某个日期、重新分配真实组别或替换为探索性随机样本来得到偏好的标签。所有要求的七天随访均已结束;更改停止规则或添加数据不在本练习范围内。
保存清晰可读的精确证据图
本步骤中,你将绘制保存的完整分配分布,标出观测比较,并保留其上下文。
继续使用同一个 WebIDE 终端,工作目录为 /home/labex/project/signup-experiment。本图使用 result["analysis"] 中的精确分布,而非其他单元的探索样本。np.unique(..., return_counts=True) 统计每个差值由多少种不同分配产生;对当前数据,各高度之和必须为 924。重复值有实际含义,不能从底层分布中去重。
某些精确尾部次数仅为一次分配。可见的点标记能让这些罕见次数在零基线上方保持可读。连接线帮助你沿离散点阅读,并不表示点之间的每个差值都能取到。
横坐标是 B−A 的百分点差,纵坐标是分配次数。可见的 Observed 标记定位实际比较。标题中舍入的 p 值仅便于显示;保存的数值与解释使用未舍入值。完整可能差值范围与零次数基线均应可见,包括有效的零值和边缘值。
保存至少 500 × 250 像素的 PNG。与上一实验一样,9 × 4.5 英寸的画布以 DPI 140 保存,约为 1260 × 630 像素;该分辨率为可读坐标轴及罕见次数标记留出空间。
cat > plot.py <<'PY'
import numpy as np
import matplotlib.pyplot as plt


def make_plot(result, destination):
    analysis = result["analysis"]
    differences, counts = np.unique(analysis["null"], return_counts=True)
    fig, ax = plt.subplots(figsize=(9, 4.5))
    ax.plot(differences, counts, "o-", color="#6374cc", markersize=5)
    ax.axvline(analysis["difference_pp"], color="#cc5b43", linewidth=2,
               label="Observed B − A")
    ax.set_xlabel("B − A (percentage points)")
    ax.set_ylabel("Number of allocations")
    ax.set_title(f"Exact allocation evidence: p = {analysis['pvalue']:.4f}")
    ax.set_xlim(-110, 110)
    ax.set_ylim(0, float(max(counts)) * 1.2)
    ax.legend()
    fig.tight_layout()
    fig.savefig(destination, dpi=140)
    plt.close(fig)
PY
从真实保存的分析生成 PNG:
python3 run.py plot-exact
在 WebIDE 的文件浏览器中展开 signup-experiment/output,打开 evidence.png。查看零附近的分布及接近 +66.67 的观测记号。同时通过读取器阅读 output/analysis.json:12 个人、两组已分配人数分母、原始差值、精确 p 值、alpha 与 inconclusive 标签共同构成证据。单独一张图不能证明分析正确。
下面的参考图是使用本引导实验数据集和提供的绘图代码实际保存的图表。点标记包含两侧尾部的罕见分配次数;线只连接可取差值。请结合保存的数值结果阅读。
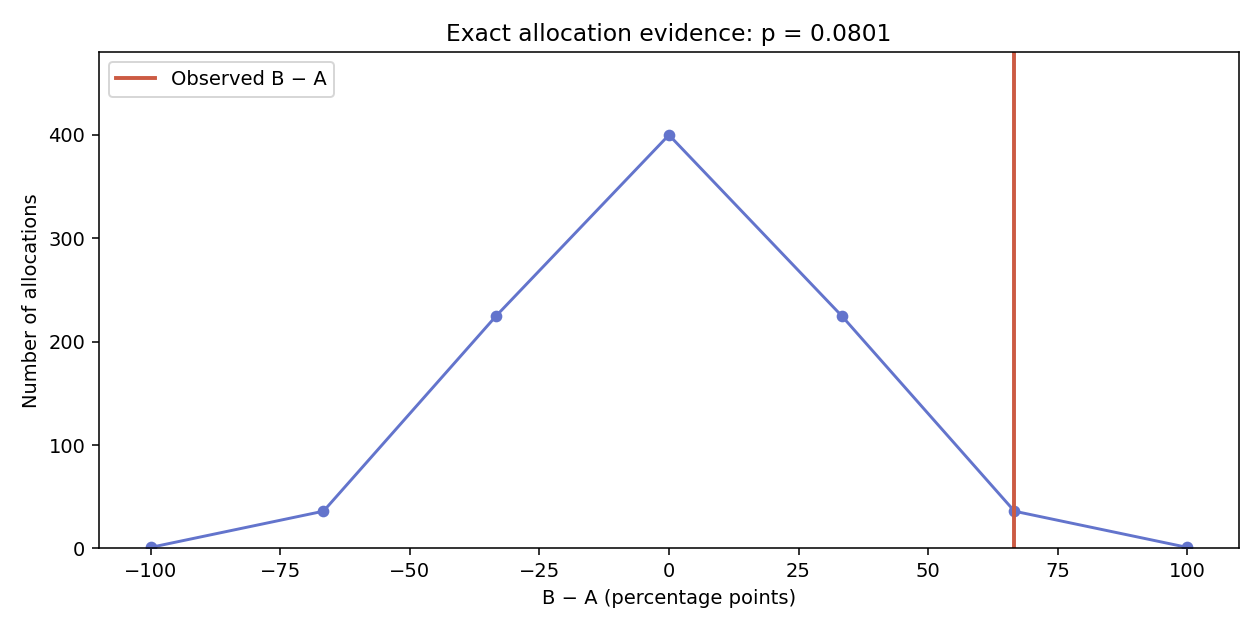
可以在真实差值处使用可读柱、计数折线或计数点。观测比较需要一条标有 Observed 的可见线或一个可见点,两个坐标轴都要有明确标签。完整可能取值范围、观测记号和零基线都必须可见。PNG 必须能解码,并能由实际保存的数据和当前绘图函数复现;不可见笔画、坐标轴外的记号、被裁切的图和无关图片均不通过。如果 PNG 缺失,先确认 python3 show_results.py exact 能读取已保存的精确结果,再执行绘图命令;读取器不会修复它。
你在一个明确假设和约定下,分析了一个合成随机实验样本。你没有测量真实业务结果、证明两个页面相同,也没有确定观察到的效应会在生产环境持续存在。
总结
你枚举了有界范围内的精确分配分布,使用了明确且包含相等值的双侧 p 值,未舍入就应用事先选定的阈值,并保存真实证据图。在小样本中,即使差值很大,证据仍可能不足以作出明确结论;这并不证明页面相同。独立挑战接下来会把同一流程迁移到另一组分配与事件历史。