介绍
社区晚餐需要为每位来宾准备邀请函。你将使用 CSV 来宾名单、JSON 活动资料和现成的 HTML 设计,生成一个新的个性化邀请函文件批次。同名来宾仍须拥有独立文件,Zoë, "Z" & <Friends> 这样的姓名必须显示为文字。
你需要掌握 Python 字符串、字典、循环和函数,以及基本终端操作。本实验会解释文件读取、CSV 记录、模板、HTML 文本转义和新输出目录。命令行入口和页面设计已经提供;你负责字段映射、完整校验和逐人生成。无需编写 CSS、发送邮件或制作 PDF。作者估计用时 55~75 分钟,包含阅读与普通错误处理。
打开第一份邀请函
本步骤中,你将生成一份正常邀请函,并把页面内容与输入字段对应起来。先进入 WebIDE,打开 Terminal → New Terminal,等待出现 labex shell 提示符。在较窄的窗口中,Terminal 可能位于 More(...)内。所有命令都在这个终端中执行。准备好的工作区独立于先前实验。
cd 用于切换当前目录。绝对路径以 / 开头;相对路径从当前目录解析。如果切换目录后,后续命令找不到文件,请用同一条命令回到这里:
cd /home/labex/project/invitations
cat 显示文本文件。读取活动资料:
cat event.json
JSON 用花括号表示对象,用双引号包围字符串键和值。这四项活动资料会成为邀请函的标题、日期、时间和地点。可直接运行的 one.py 示例已经把它们与一位来宾映射到现成设计中。python3 运行 Python 文件。把示例生成到新的 batches/first 目录:
python3 one.py
预期输出:
Created batch: batches/first
从平台的 WebIDE Tab 切换到 Web 8080。环境准备过程已启动邀请函浏览器,无需点击 Go Live。刷新预览并找到 first/g001.html。点击 Open invitation,实际 HTML 文件将在新的浏览器标签页打开。阅读 Maya Patel、The Long Table、时间和地点。关闭该浏览器标签页即可回到 Web 8080。Download HTML 会保存同一文件,供你在实验之外使用。
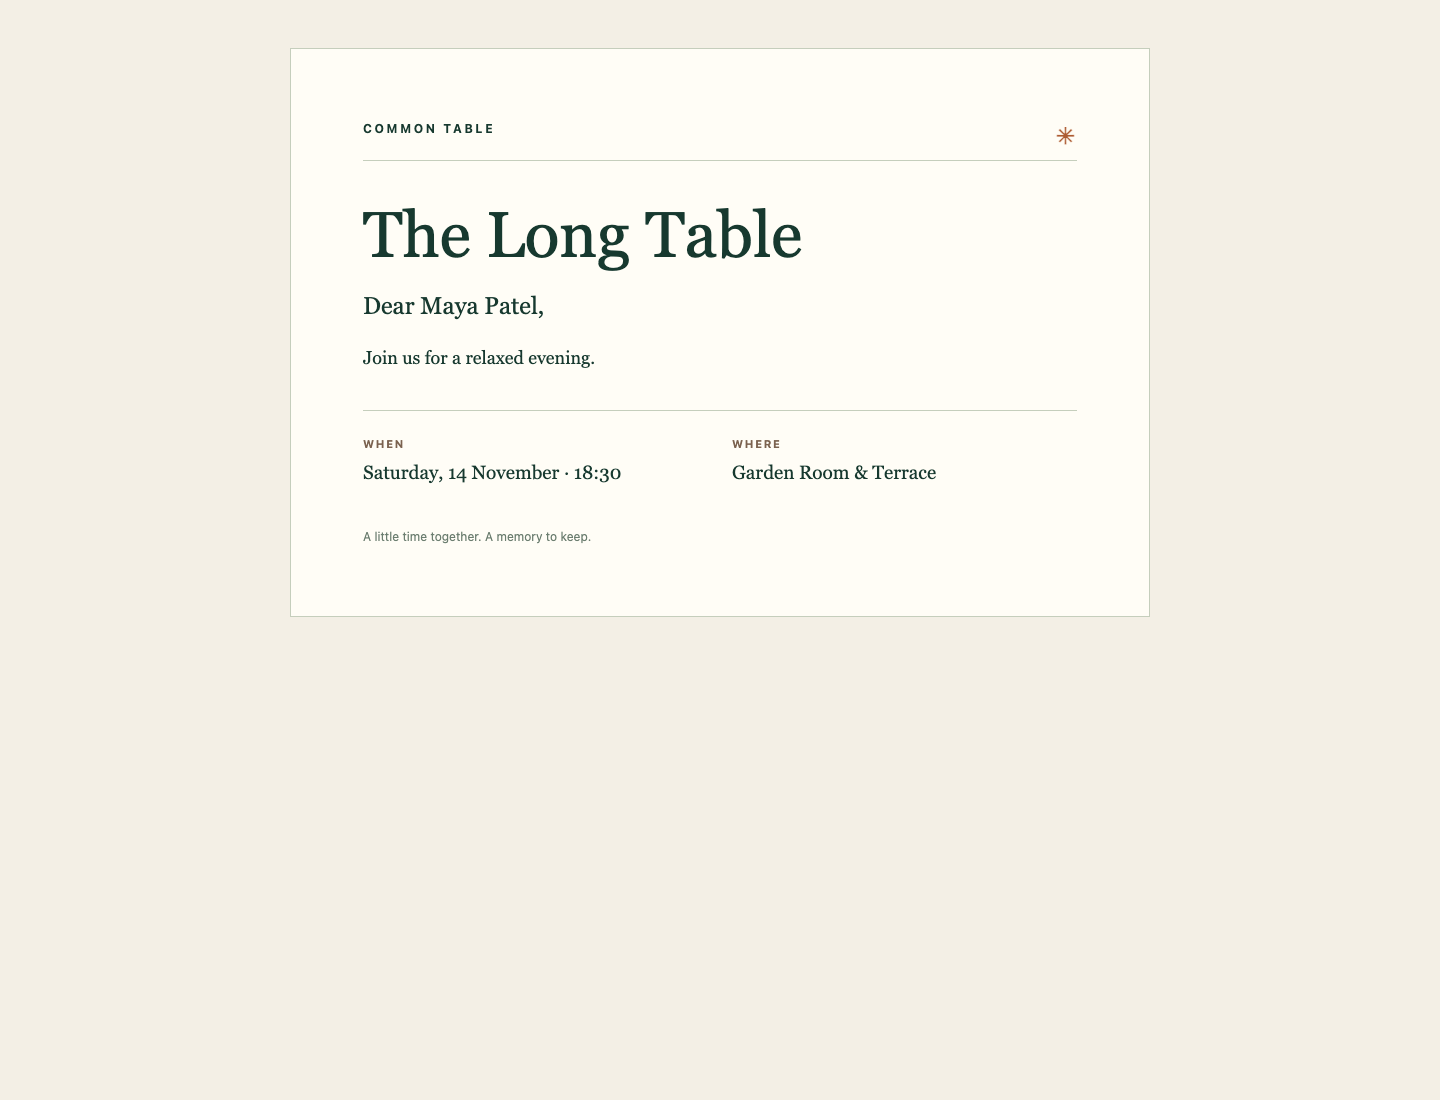
称呼部分标明来宾;下方两个区域显示活动时间和地点。
预览只读取 batches 中实际存在的文件,不会生成缺失的邀请函。先前的 batches/archive 作为旧成果保留。最终程序将创建新批次,同时保留这些文件和所有输入。切回 WebIDE 继续下一步。
将 CSV 记录映射为 HTML 文本
本步骤中,你将让可复用的渲染函数把每位来宾的值放入正确文本位置。回到同一个 WebIDE 终端和工作区;下方相对路径均以 /home/labex/project/invitations 为起点。
按记录读取,不要按逗号拆分
CSV 是一种表格格式,第一行包含字段名。逗号通常分隔字段,但引号字段内部的逗号除外;引号字段内部的双引号会写成两个双引号。因此,split(",") 无法正确读取所有记录。读取提供的名单:
cat guests.csv
其中有两条 Alex Chen 记录,guest_id 不同。最后一位来宾的姓名包含逗号、引号、& 和尖括号,它们都是合法的姓名字符。稳定 ID 标识一个人,显示姓名不能承担这一职责。
现成的 generate.py 负责读取这些记录。修改渲染函数前,先阅读它:
cat generate.py
with ... as source 打开文件,并在缩进代码块结束后关闭它。encoding="utf-8" 保留 Unicode 字符。newline="" 让 CSV 读取器自行处理记录边界。csv.DictReader(source) 使用表头为每条记录建立字典;list(...) 将记录读入列表。例如,guest["name"] 是一个完整姓名,其中属于姓名的逗号也会保留。json.loads(...) 把 JSON 活动文本转换为字典。这些读取器和命令行入口已经实现。
区分 CSV 引号与 HTML 转义
HTML 页面用 <...> 表示标签,用 &...; 表示字符引用。CSV 引号保护表格结构,却不能防止 <Friends> 这样的姓名被当成 HTML。html.escape(value, quote=True) 将特殊字符转换为字符引用,浏览器会把它们显示为原始文字。这里提供的每个值都进入 HTML 文本位置;这不是向任意 JavaScript、CSS 或 URL 插入数据的通用方法。
Template 使用 invitation.html 中的 $name、$title 和其他 $field 占位符。substitute(mapping) 用字典中对应的值替换各占位符,并拒绝缺失的映射。模板正文中的六个标记 data-field="name"、message、title、date、time 和 venue 标识语义文本位置。每个位置保留一个,并填写对应文字。提供的输入模板必须保持不变。生成结果可以使用等效标签、布局和实体写法;仅在页面 <title> 中出现姓名,不能代替正文中的姓名位置。
创建下方渲染函数。cat > rendering.py 写入文件,替换该文件原来的内容。带引号的 here-document 标记 <<'PYCODE' 会把直到结束标记 PYCODE 为止的内容当作原样文本;结束标记必须独占一行。此操作只替换你的渲染函数,不改变输入文件。
字典显式映射来宾与活动字段。values.items() 产生键值对。字典推导式 {key: ... for key, value in values.items()} 对每个值转义,同时保留其键。from html import escape 导入标准库函数。
cat > rendering.py <<'PYCODE'
from html import escape


def render_guest(guest, event, template):
    values = {"name": guest["name"], "message": guest["message"],
              "title": event["title"], "date": event["date"],
              "time": event["time"], "venue": event["venue"]}
    return template.substitute({key: escape(value, quote=True)
                                for key, value in values.items()})
PYCODE
该函数返回 HTML 文本,不创建文件。本地辅助模块可以是与 generate.py 同目录的顶层 .py 文件;包子目录不属于本练习范围。转义只在替换前进行一次,因此浏览器显示的是 &,而不是可见的 &。现在,邀请函设计与个性化文字已经分开。
创建批次前校验所有来宾
本步骤中,你将按 ID 为每人生成一个文件,同时保护先前成果。继续使用同一个 WebIDE 终端。
原来的 batch.py 把姓名作为文件名,并允许使用已存在的目录。两位都叫 Alex Chen 的来宾可能互相覆盖文件。阅读这个小函数:
cat batch.py
你的契约是创建一个新的批次目录,为每条记录生成 <guest_id>.html。ID 只允许小写 ASCII 字母、数字和连字符;姓名与留言仍为不受此字符限制的 UTF-8 文本。来宾必填字段是 guest_id、name、message,活动必填字段是 title、date、time、venue。必填值为空或只含空白、ID 重复或输出目录已存在时,程序都必须给出有用的错误并拒绝生成。保持 CSV、两份活动文件、模板和 batches/archive 不变。
将准备与写入分开
先校验每条记录并渲染每个页面,全部成功后再创建输出目录、写入文件。否则,最后一条记录出错时可能留下误导性的半批结果。这能保护本课涉及的输入错误,但不保证磁盘故障或突然断电时的事务一致性。
isinstance(value, str) 判断值是否为文本。键不存在时,event.get(field) 返回 None,让你能够报告有用的错误。strip() 判断文本是否包含空白之外的内容,不改变随后渲染的原始文字。raise ValueError(...) 报告无效输入;现成的命令行入口会捕获它,打印 Cannot generate invitations: ... 并以失败状态退出。
set() 保存已出现的 ID。in 判断成员关系;seen.add(...) 记住一个 ID。all(...) 检查每个字符是否符合公开的允许字符规则。pages.append((guest_id, page)) 保存 ID 与页面组成的二元组。最后,for guest_id, page in pages 解包这些二元组。
Path(output) 表示目标目录。mkdir() 创建目录;由于没有传入 exist_ok=True,已存在的路径会被拒绝。/ 运算符连接路径。f"{guest_id}.html" 这样的 f-string 把 ID 插入文件名。write_text(..., encoding="utf-8") 将完整 HTML 文本以 UTF-8 写入。
只用下方核心实现替换 batch.py:
cat > batch.py <<'PYCODE'
from pathlib import Path
from rendering import render_guest


def write_batch(guests, event, template, output):
    for field in ("title", "date", "time", "venue"):
        if not isinstance(event.get(field), str) or not event[field].strip():
            raise ValueError(f"Missing event field: {field}")
    if not guests:
        raise ValueError("The guest list is empty")
    seen = set()
    pages = []
    for guest in guests:
        for field in ("guest_id", "name", "message"):
            if not isinstance(guest.get(field), str) or not guest[field].strip():
                raise ValueError(f"Missing guest field: {field}")
        guest_id = guest["guest_id"]
        if not all(character in "abcdefghijklmnopqrstuvwxyz0123456789-" for character in guest_id):
            raise ValueError("Guest IDs must use lowercase letters, digits, or hyphens")
        if guest_id in seen:
            raise ValueError(f"Duplicate guest ID: {guest_id}")
        seen.add(guest_id)
        pages.append((guest_id, render_guest(guest, event, template)))
    output = Path(output)
    output.mkdir()  ## An existing batch is always refused.
    for guest_id, page in pages:
        (output / f"{guest_id}.html").write_text(page, encoding="utf-8")
PYCODE
from rendering import render_guest 使用你的本地渲染函数。第一个循环检查活动字段,接下来的循环校验来宾并准备页面,最后一个循环写入完整批次。校验与渲染循环结束之前,不会创建任何文件。
命令行入口按顺序接收四个位置参数路径:来宾 CSV、活动 JSON、HTML 模板和新的输出目录。用完整名单运行:
python3 generate.py guests.csv event.json invitation.html batches/evening
预期输出:
Created batch: batches/evening
ls 列出目录成员:
ls batches/evening
你应该看到 g101.html、g102.html 和 g103.html。两份 Alex 邀请函现在拥有独立 ID。完成的文件保留每个人自己的留言;第三份还保留逗号、引号、Unicode 和作为文字的尖括号。
复用生成器并保留先前成果
本步骤中,你将用同一个程序处理另一个活动,并练习普通错误恢复。先进入同一个 WebIDE 终端。下方命令彼此独立,因此预期失败不会阻止你继续执行。
首先故意重复使用已经完成的输出路径。它应当失败:mkdir() 拒绝已存在的批次。错误以 Cannot generate invitations: 开头,并包含文件已存在的信息。先前的批次必须保持不变。
python3 generate.py guests.csv event.json invitation.html batches/evening
阅读准备好的重复 ID 示例。第二位来宾使用了第一位来宾的 ID:
cat invalid-duplicate.csv
尝试用它生成新批次。这也应当失败,在创建任何目录前报告 Duplicate guest ID: g101:
python3 generate.py invalid-duplicate.csv event.json invitation.html batches/rejected-duplicate
缺少留言的示例也会按预期失败,报告 Missing guest field: message。即使前面的记录有效,也不应出现半批结果:
python3 generate.py invalid-missing.csv event.json invitation.html batches/rejected-missing
输入路径拼错是另一种情况:操作系统无法打开文件。下一条命令故意使用不存在的 guest.csv。阅读错误,不要重置环境:
python3 generate.py guest.csv daytime.json invitation.html batches/daytime
改用实际的 guests.csv 路径恢复操作。阅读第二份活动资料,然后使用同一个程序与来宾名单生成新批次:
cat daytime.json
python3 generate.py guests.csv daytime.json invitation.html batches/daytime
预期输出:
Created batch: batches/daytime
切到 Web 8080 并刷新。依次打开 evening/g101.html 和 evening/g102.html。它们姓名相同,但各自留言不同。打开 evening/g103.html:逗号、引号、ë、与号和 <Friends> 都必须显示为原样文字。打开 daytime/g103.html,阅读新的标题、时间和地点。关闭每份邀请函的浏览器标签页即可回到列表。对日间活动邀请函使用 Download HTML,并打开下载文件;其中的个性化文字应与预览一致。
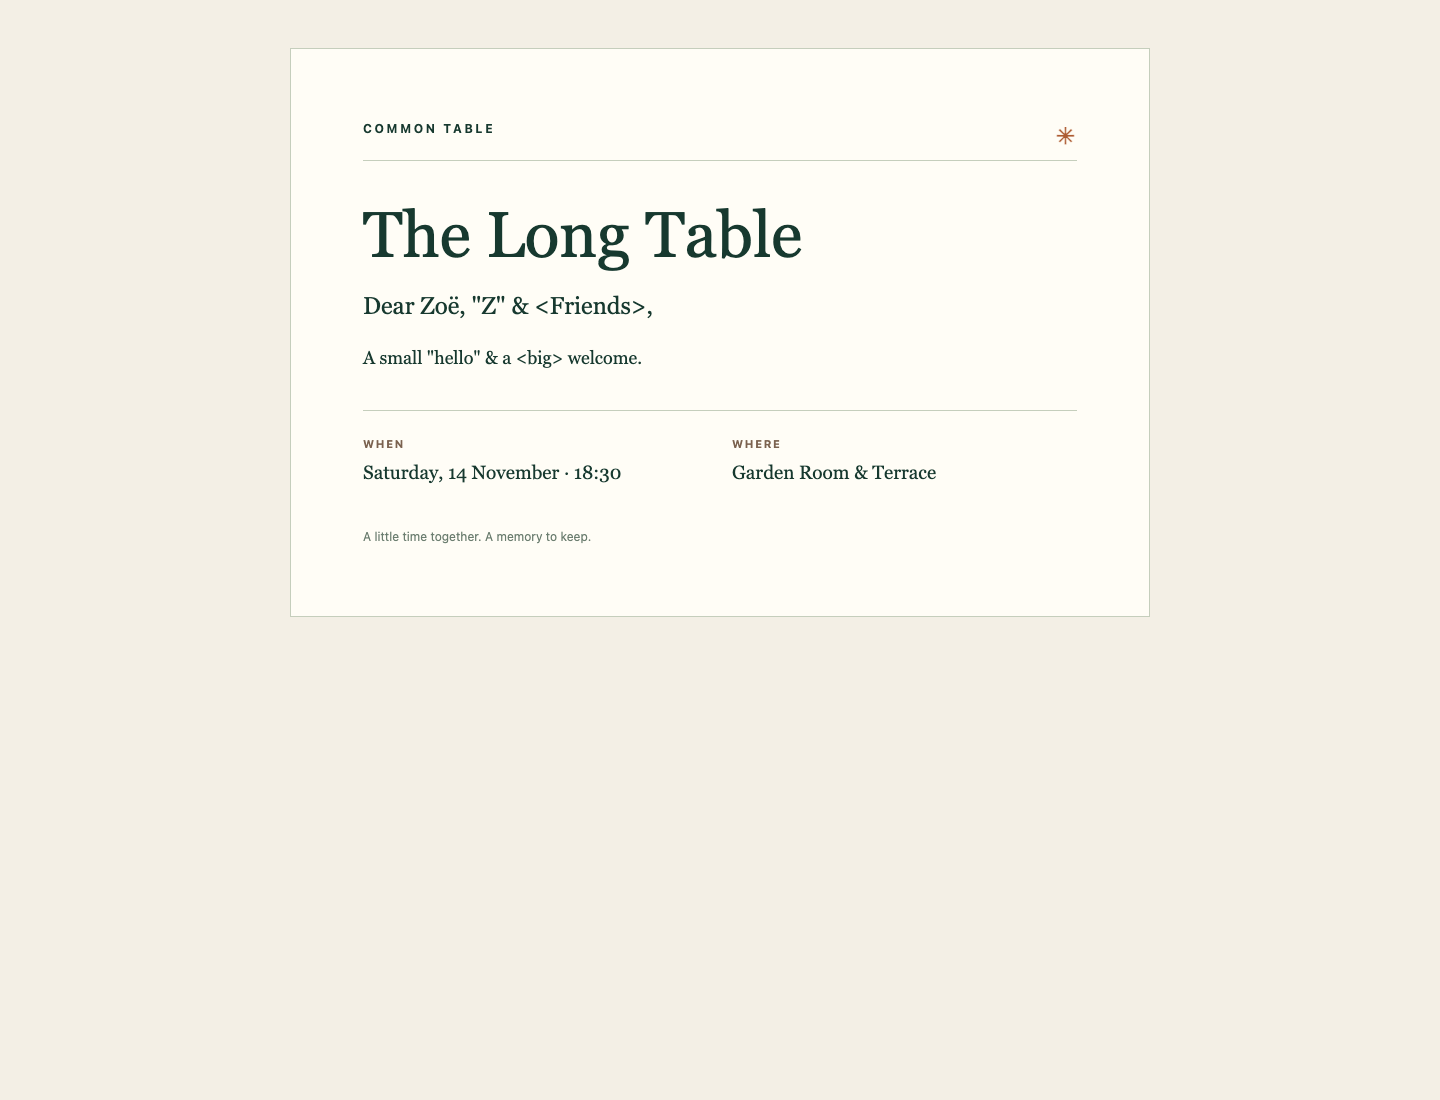
姓名保留了逗号、引号和尖括号。它们都是称呼中可见的文字。
两个活动批次彼此独立。CSV、活动文件和模板没有改变,旧归档仍然存在。无效输入、已存在的批次和缺失的输入路径各有不同含义;你可以逐一修正,而不破坏先前的邀请函。
总结
你从 CSV 记录和 JSON 活动资料生成了真实、可下载的 HTML 邀请函。你区分了稳定 ID 与显示姓名,把字段映射到模板文本位置,使用 UTF-8 和 HTML 转义保留 Unicode 与特殊字符,并在写入前校验整个批次。现在,生成器能够创建新的活动批次,同时保留输入和先前的成果。