介绍
三张卡片的预览适合浏览,但编辑需要全部匹配记录。补全同一个本地演示 API 的客户端,让它沿续页令牌遍历、跨页保持身份,并且只有整个批次成功后才发布 CSV。空页或较短的页面之后仍可能有更多页面。
本单元独立初始化,已经准备了第一个 guided lab 中的请求和筛选函数。你需要完成该实验,或具备等效的 HTTP/JSON/CSV 知识。在 WebIDE 中选择 Terminal → New Terminal;通过 Web 8080 使用来源页面、已保存导出和公开的 Demo controls。只编辑 client.py 和 storage.py,使用标准库和在这两个文件内定义的辅助函数,不添加其他辅助模块或资源。交付 CSV 为工作区内的真实普通文件,而不是符号链接。保持 catalog.py、/opt/commonlight、合成插画与虚构来源记录不变。作者估计阅读和练习需要 55 分钟,并非初学者实测时间。
遵循协议直到结束
本步骤采集所有页面,包括空页和较短的数据页,同时让每个 ID 只保留一次。在 WebIDE 终端中进入独立准备的工作区:
cd /home/labex/project
请求函数已经能够处理 JSON、编码游标,以及三秒的阻塞操作超时。用 cat 查看准备好的规则:
cat client.py
当前 collect 只返回一页。page_size 为 3 表示最多三条记录,并不要求每页都有三条。先预测这个小序列:前三条记录,然后零条记录但还有另一个游标,再然后一条记录并仍有另一个游标。空页没有增加记录,却不能证明已经结束。只使用返回的游标运行这个序列:
python3 - <<'PY'
import client
url = 'http://127.0.0.1:8080/api/harbor'
first = client.request_page(url, 3)
second = client.request_page(url, 3, first['next_cursor'])
third = client.request_page(url, 3, second['next_cursor'])
print('Page 1 items:', len(first['items']))
print('Page 2 items:', len(second['items']))
print('Page 2 finished:', second['next_cursor'] is None)
print('Page 3 items:', len(third['items']))
print('Page 3 finished:', third['next_cursor'] is None)
PY
Page 1 items: 3
Page 2 items: 0
Page 2 finished: False
Page 3 items: 1
Page 3 finished: False
只有 next_cursor is None 才表示一个批次成功结束。不要因为 items 为空、页面较短,或已经经过某个猜测的页数就停止。
跨页时,同一个照片 ID 可以再次出现,字段值完全相同。以 photo_id 为键的字典能保持身份与全部字段之间的关系。setdefault(key, value) 只在键不存在时插入值,这样就保留了一份副本;重复标题不等于重复 ID。存在冲突的修订不在本演示契约范围内。两个都叫 Blue hour 的不同 ID 都必须保留。
集合保存唯一值。set() 创建空集合,cursor in seen_cursors 判断某个令牌是否已经存在,seen_cursors.add(cursor) 记录一个新令牌。这个集合记录已见过的续页令牌。先检查合法的 null 结束,再拒绝重复令牌,不能无限循环,也不能把循环误认为完成。raise ValueError 会在命令保存不完整结果之前停止采集。正常的准备目录是有限的;程序不设置固定页数上限,也不自动重试或断点续传。
用下面的完整模块替换 client.py。与之前一样,> 替换这个文件,带引号的 here-document 保持内容原样。请求和筛选没有变化,collect 是新增部分。
cat > client.py <<'PY'
"""The request and selection functions are completed in the first guided lab."""
import json
from urllib.parse import urlencode
from urllib.request import urlopen

def request_page(endpoint, page_size, cursor=None):
    params = {'page_size': page_size}
    if cursor is not None:
        params['cursor'] = cursor
    with urlopen(endpoint + '?' + urlencode(params), timeout=3) as response:
        return json.load(response)

def select_photos(photos, category, orientation):
    return [photo for photo in photos
            if photo['category'] == category and photo['orientation'] == orientation]
def collect(endpoint, page_size):
    photos = {}
    cursor = None
    seen_cursors = set()
    while True:
        page = request_page(endpoint, page_size, cursor)
        for photo in page['items']:
            photos.setdefault(photo['photo_id'], photo)
        cursor = page['next_cursor']
        if cursor is None:
            return list(photos.values())
        if cursor in seen_cursors:
            raise ValueError('Repeated cursor; catalog did not complete')
        seen_cursors.add(cursor)
PY
执行完整采集。省略 --first-page,因为该选项有意只产生样例。
python3 catalog.py 'http://127.0.0.1:8080/api/harbor' street landscape 3 catalog.csv
Saved 5 photos to catalog.csv
检查保存的身份,而不只相信一个数量:
python3 - <<'PY'
import csv
with open('catalog.csv', encoding='utf-8', newline='') as stream:
    for photo in csv.DictReader(stream):
        print(photo['photo_id'], '|', photo['title'])
PY
p01 | Morning, market
p02 | Blue hour
p04 | The "quiet" lane
p08 | Blue hour
p09 | Last tram — 帰り道
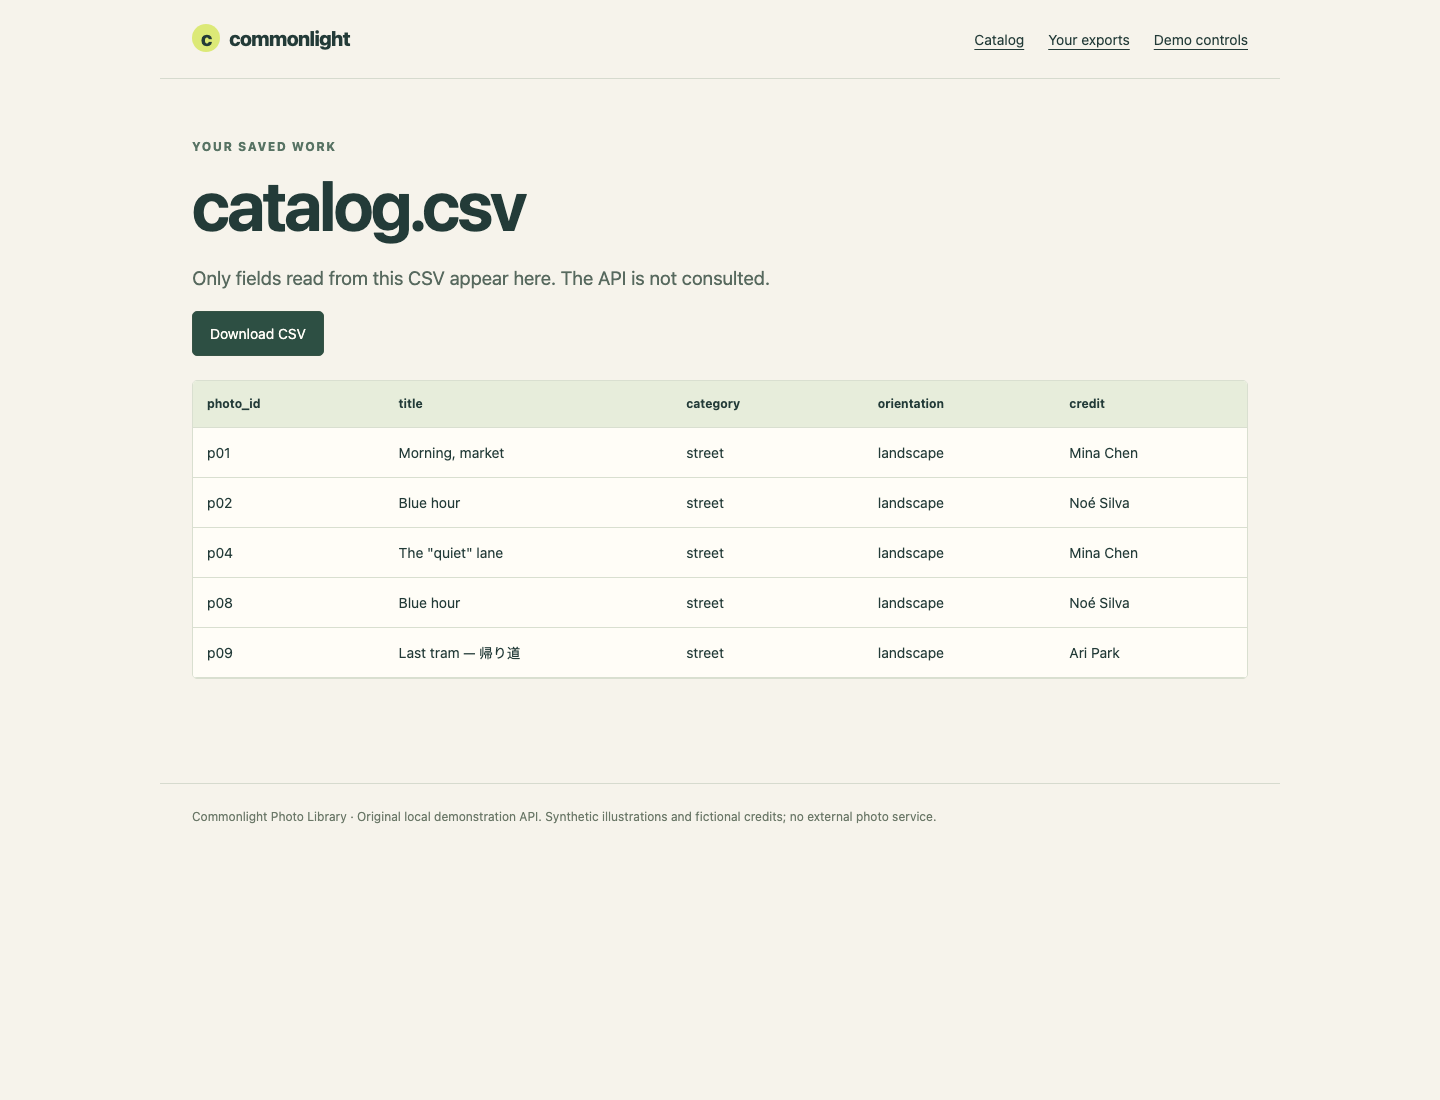
末页记录 p09 已存在,p02 只出现一次,而 p08 保留了相同标题和不同 ID。在 Web 8080 → Your exports → catalog.csv 查看这些相同的值。这个表格只读取你的 CSV,不完整文件在这里仍是不完整的。返回 WebIDE 自检。如果用了错误的文件名或目录,用 pwd、ls 和之前的 cd 恢复后再试。
只发布完整导出
本步骤在后续请求、协议循环或文件写入失败时保护上次成功的导出。采集本来就会在保存开始前完成,但写入器也需要完整成功的边界:以 w 打开最终路径,可能在新内容写入成功之前就截断一个好文件。
Path(output) 将传入的文件名字符串变成路径对象。它的 .parent 是所在目录,.name 是最终文件名。NamedTemporaryFile 创建新的唯一文件名,而不是借用 catalog.csv.tmp 这种可预测的相邻文件。dir=output.parent 将临时文件放在目标目录中,保证替换在同一个文件系统内进行。delete=False 让文件关闭后仍保留,以供替换;stream.name 给出分配的文件名,我们将它保存为 Path。finally 块在成功或异常后都会执行。exists() 检查临时路径是否还存在;如果存在,unlink() 只删除这次新建的临时文件。成功替换后,临时路径已经消失,所以无需删除任何内容。异常仍会传播到命令接口,产生非零退出状态。Path.replace 在 with 块关闭文件后发布完成的文件。成功的 POSIX 替换是原子的,但这不承诺断电持久性、多文件事务或并发写入协调。已有且无关的 .tmp 文件绝不能被覆盖或删除。
在 WebIDE 终端中替换 storage.py。五个 CSV 字段必须分别在表头中恰好出现一次;等效实现可以采用不同的合法引号方式、行顺序和列顺序。
cat > storage.py <<'PY'
import csv
import tempfile
from pathlib import Path

FIELDS = ['photo_id', 'title', 'category', 'orientation', 'credit']

def save_csv(output, photos):
    output = Path(output)
    temporary = None
    try:
        with tempfile.NamedTemporaryFile(
            mode='w', encoding='utf-8', newline='',
            dir=output.parent, prefix='.' + output.name + '.',
            suffix='.tmp', delete=False
        ) as stream:
            temporary = Path(stream.name)
            writer = csv.DictWriter(stream, fieldnames=FIELDS)
            writer.writeheader()
            writer.writerows(photos)
        temporary.replace(output)
    finally:
        if temporary is not None and temporary.exists():
            temporary.unlink()
PY
模拟故障之前,先运行一次正常批次。sha256sum 输出内容指纹及文件名。记住该指纹,或让终端输出保持可见;下一次失败的批次必须保持它不变。写入失败也必须保全上次完整文件;自检会在不改动工作区的隔离测试中验证这一点。
python3 catalog.py 'http://127.0.0.1:8080/api/harbor' street landscape 3 catalog.csv
sha256sum catalog.csv
切换到 Web 8080,选择 Demo controls,再选择 Enable middle-page failure。确认 Middle-page failure ON。
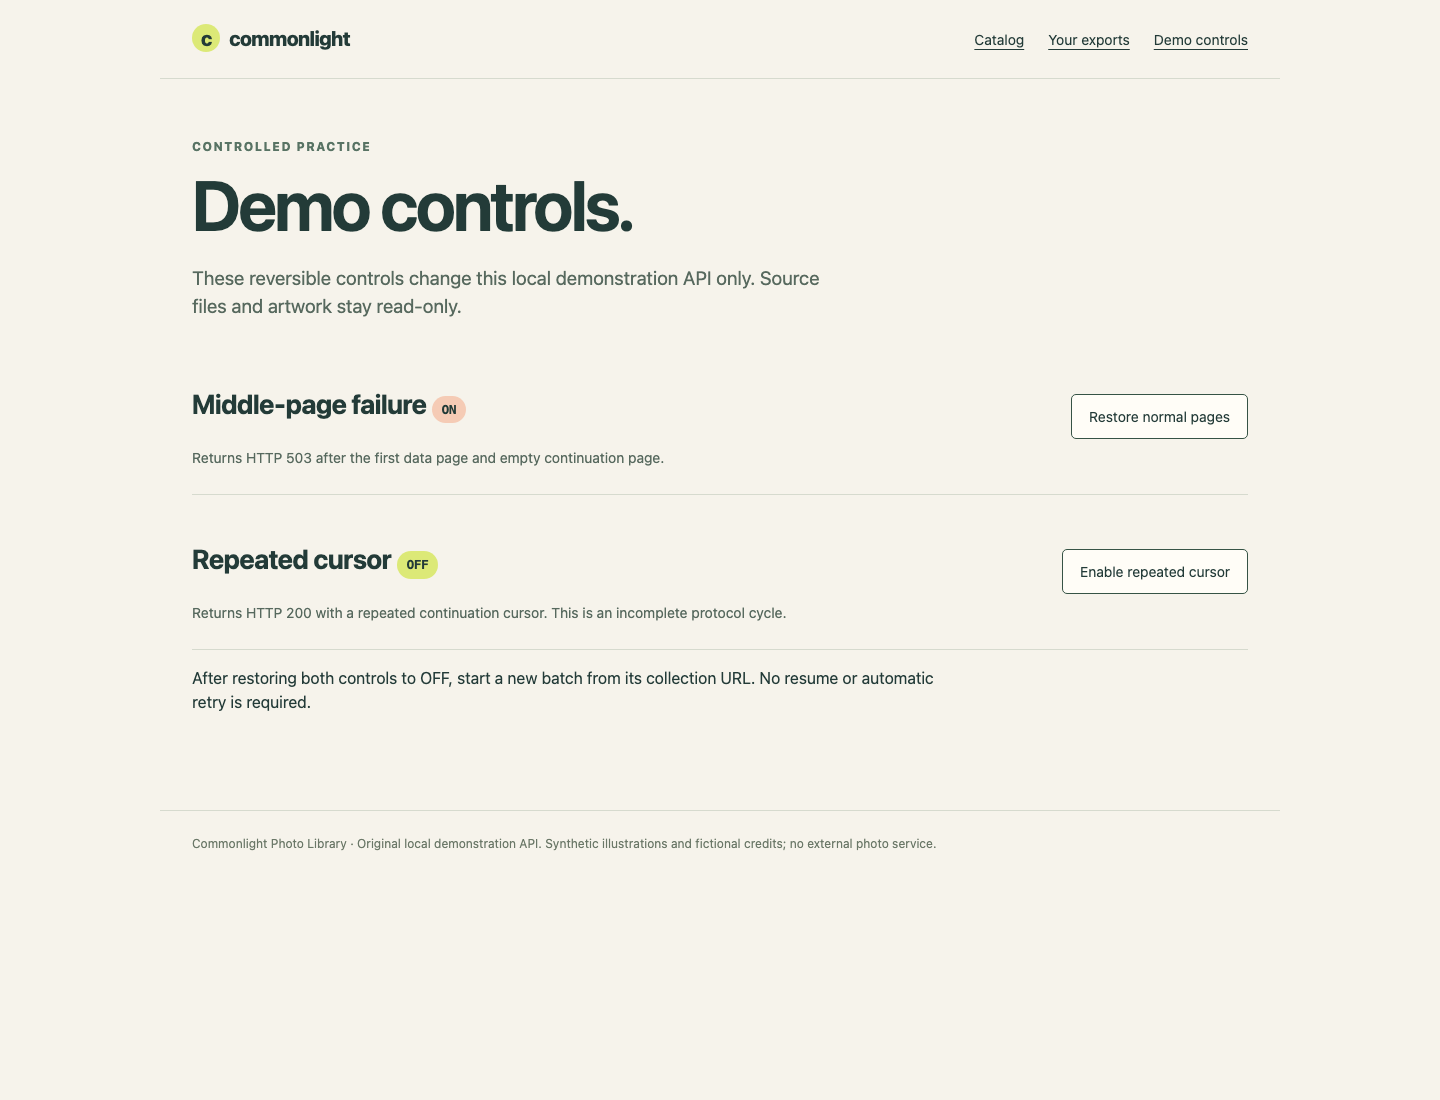
使用与你启用的故障对应的控制卡片。这是明确允许且可逆的操作,只改变演示 API 的内存,来源文件仍为只读。返回 WebIDE,执行这次有意触发的失败。printf 立即捕获 $?:
python3 catalog.py 'http://127.0.0.1:8080/api/harbor' street landscape 3 catalog.csv
printf 'Exit status: %s\n' "$?"
sha256sum catalog.csv
HTTP request refused: 503. No complete export published.
Exit status: 1
...
这里的 HTTP 503 表示演示 API 拒绝了某个中间页请求。它既不是连接失败,也不是成功的空结果。内容指纹必须与之前相同,原来的五行导出仍可查看。如果程序已经损坏文件,仅有一个非零退出状态并不足以证明保护成功。
在 Web 8080 → Demo controls 中,为中间页故障选择 Restore normal pages,并确认状态为 OFF。返回 WebIDE,从集合 URL 开始一个新的有限批次,不要复用旧游标:
python3 catalog.py 'http://127.0.0.1:8080/api/harbor' street landscape 3 catalog.csv
接着切换到 Web 8080 → Demo controls,选择 Enable repeated cursor。确认 Repeated cursor ON,且故障控制为 OFF。返回 WebIDE:
python3 catalog.py 'http://127.0.0.1:8080/api/harbor' street landscape 3 catalog.csv
printf 'Exit status: %s\n' "$?"
Export failed: Repeated cursor; catalog did not complete
Exit status: 1
这些响应的 HTTP 状态为 200,但重复游标表示协议错误,而不是完成。集合防护阻止了无限循环和发布。在 Web 8080 → Demo controls 的 Repeated cursor 卡片内选择 Restore normal pages,确认 OFF;两个控制现在都必须是 OFF。返回 WebIDE,重新执行成功命令,再用一个新输出名尝试合法的零匹配筛选:
python3 catalog.py 'http://127.0.0.1:8080/api/harbor' street landscape 3 catalog.csv
python3 catalog.py 'http://127.0.0.1:8080/api/harbor' missing landscape 2 empty.csv
Saved 5 photos to catalog.csv
Saved 0 photos to empty.csv
第二个结果成功,且只有表头;它与前面的两种错误不同。在 Web 8080 → Your exports 中打开 empty.csv,查看五个表头且没有数据行,再打开 catalog.csv,选择 Download CSV。真实保存的五条记录文件就是交付物。返回 WebIDE 自检。保留程序和准备好的来源文件;自检读取你的实际结果,并在隔离的真实 HTTP 测试环境中运行未经改写的副本,覆盖不同 URL、筛选值、大小及写入失败。
总结
你沿不透明的续页令牌走到了明确的 null 结束,在标题重复的情况下保留了不同身份,并拒绝了协议循环。你通过唯一临时文件发布了完整 UTF-8 CSV,在失败后保全上次成功的结果。同一个程序还可以接受另一个传入的集合与筛选条件。