



介绍
EARLY CRUMB 需要一份周六备货员真正能用的清单。付清的订单仍可能取消,一份有效订单也可能包含多种不同商品。你的工作是保留正确的订单及每项数量,再交付逐单袋签。
这个全新实验提供全部原始记录和已排序的已付款订单 ID 文件,不需要上一台 VM 的文件。只需基本终端操作能力;选择、排序和关联命令会在使用时解释。你无需开发应用或编写通用脚本。
在 Workstation 操作文件,在 Pickup Preview 阅读记录、打开实际清单、查看标签并下载交接文件。预览只读取你的文件,不会排除取消订单或修正数量。
排除已取消订单
本步骤将建立已付款且未取消的订单 ID 集合。从 Pickup Preview 开始。
先明确真实备货判断
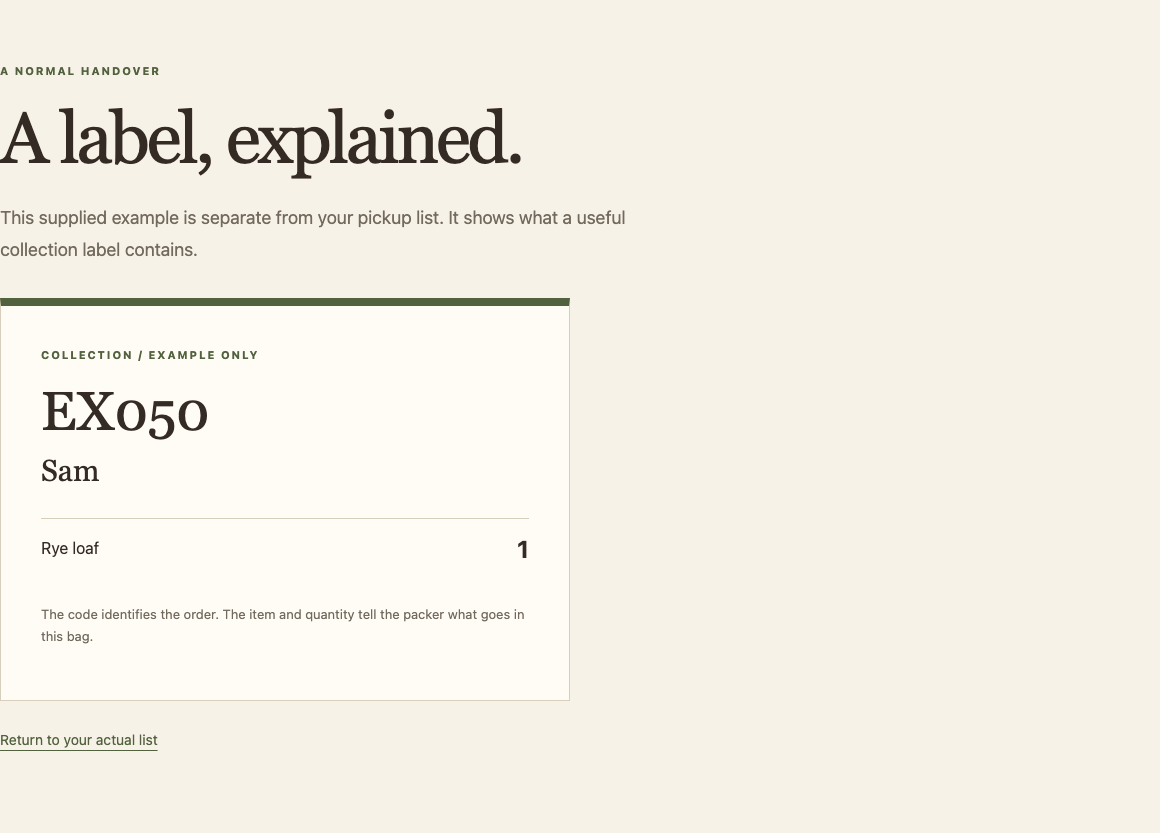
打开 Sample label,观察订单 ID、顾客和商品数量如何组成可用袋签。随后打开 Records。P101 属于 Alex,需要两份 rye loaf 和一份 oat cookie。P102 也属于 Alex,但未付款。P103 已付款,却出现在 cancellations.tsv 中,因此不能为它备袋。
付款与取消回答不同问题。本次取货的有效订单必须同时满足两个条件:完整付款状态为 paid,并且 ID 不在取消集合中。
检查独立工作区
切换到 Workstation。pwd 显示当前目录,cat 显示文件:
pwd
/home/labex/project/pickup
cat paid-order-ids.txt
P101
P103
P104
P105
本实验直接提供这份已排序文件,其中是付款状态完整等于 paid 的 ID,包括 P103。再读取另一份判断输入:
cat source/cancellations.tsv
order_id
P103
source/ 保持不变。你可以重新生成 work/ 内的文件和最终的 pickup-list.tsv。若切换过目录,使用 cd /home/labex/project/pickup 返回这里。
比较两个已排序集合
这里的集合是没有重复 ID 的列表。comm 比较两个已排序文件:第一列是仅在第一个输入中的 ID,第二列是仅在第二个输入中的 ID,第三列是两个输入共有的 ID。-23 隐藏第 2、3 列,仅留下第一个输入中存在、第二个输入中不存在的 ID。这正是“已付款 ID 减去已取消 ID”。
LC_ALL=C 让本终端中的排序与比较使用一致规则。tail -n +2 去掉表头;sort -u 排序并移除完全相同的 ID 行。管道把输出传给下一条命令。> 保存到另一份工作文件,重试时会覆盖该文件;不要把输入路径也当成输出路径。
export LC_ALL=C
sort -u paid-order-ids.txt > work/paid.sorted.txt
tail -n +2 source/cancellations.tsv | sort -u > work/cancelled-order-ids.txt
comm -23 work/paid.sorted.txt work/cancelled-order-ids.txt > work/eligible-order-ids.txt
cat work/eligible-order-ids.txt
P101
P104
P105
P103 已被排除,其余已付款订单保留。如果出现输入未排序的警告,按上面的设置重新生成两个输入集合。不要修改来源来删除订单,也不要把付款记录缺失视为可以备货。
制作商品明细并打开真实袋签
本步骤将为每个有效 ID 保留全部商品和数量,并实际使用交接文件。从 Workstation 开始。
把 ID 关联回全部商品行
一个订单 ID 可以在 orders.tsv 中出现多次。P101 同时需要 rye 和 oat。三个有效 ID 并不意味着三件面包,必须保留每条原始商品明细与数量。
读取表格:
cat source/orders.tsv
四个字段是 order_id、customer、item、quantity,以制表符分隔,首行为表头。tail -n +2 只去掉表头。TAB=$(printf '\t') 将一个制表符保存到 Shell 变量。-t "$TAB" 让 sort 和 join 使用该分隔符,双引号保证它作为一个参数传入。sort -k1,1 -k3,3 先按订单 ID,再按商品代码排序,并保留全部四个字段。不要只对订单 ID 字段使用 sort -u 来替换商品表。
TAB=$(printf '\t')
tail -n +2 source/orders.tsv > work/orders.rows
sort -t "$TAB" -k1,1 -k3,3 work/orders.rows > work/orders.sorted.tsv
join 按已排序输入的第一字段匹配。第一个输入是有效 ID,第二个输入包含全部商品行。此时默认的“仅输出匹配项”正合适:保留有效订单,并输出该订单匹配的每条商品行。ID 只出现一次,后面是顾客姓名、商品和数量。
join -t "$TAB" work/eligible-order-ids.txt work/orders.sorted.tsv > work/pickup.rows
cat work/pickup.rows
P101 Alex oat 1
P101 Alex rye 2
P104 Noor oat 2
P105 Jules oat 1
P105 Jules rye 1
上面的空隙是制表符。三个订单对应五条商品明细。生成交接文件前,先核对 P101 的两种商品及数量。
为接收方提供清晰格式
读取预览需要相同的四字段表头。printf 将 \t 解释为制表符,将 \n 解释为换行。> 创建新的目标内容,>> 追加数据而不擦掉表头。重复执行这两条命令会干净地替换上一次交付,不会不断追加重复行。
printf 'order_id\tcustomer\titem\tquantity\n' > pickup-list.tsv
cat work/pickup.rows >> pickup-list.tsv
cat pickup-list.tsv
使用交接文件,而不只看总数
切换到 Pickup Preview,打开 Pickup list。如果之前已打开,重新加载。应显示 3 collection bags · 5 item lines · 7 pieces。这些总数能帮助发现问题,但不能证明每个人都拿到了正确内容。
打开 Alex 的 P101 标签,应显示 Oat cookie 1 和 Rye loaf 2。通过 All collection bags 返回,打开 P104,确认 Noor 有 Oat cookie 2;P105 则为 Jules 提供 Oat cookie 1 和 Rye loaf 1。P102、P103、P106 都不应有袋签。仅凭顾客姓名无法证明这些关系正确。
如果浏览器支持,使用 Print label 打开打印对话框,预览后取消;无需实体打印机。返回清单,选择 Download the actual list。下载的是你创建的同一份 TSV,而非预先计算好的参考答案。
如果预览解释了格式错误,回到 Workstation 检查表头和制表符,重新生成文件后加载页面。如果数量错误,将 work/pickup.rows 与订单来源比较。读取预览不会悄悄修正你的结果。
加入晚到订单,同时避免原有袋签重复
本步骤将从完整的修订输入快照重新生成交接文件。从 Workstation 开始,使用前面相同的 Shell 设置。
理解新输入
source/ 下的原始文件保持不变。source/late/ 包含三张表的完整后续快照,不是让你追加到结果末尾的少量新行。新增的已付款订单 P107 属于 Aya,需要两份 oat cookie。先前的取消记录仍然适用。
cat source/late/orders.tsv
cat source/late/payments.tsv
提供的 paid-order-ids.txt 描述原始快照。要纳入新订单,需要从后续付款表重新计算已付款集合。grep $'\tpaid$' 选择制表符以及行末完整状态,避免匹配 unpaid;cut -f1 保留订单 ID;sort -u 将 ID 集合准备为可比较形式。沿用前面步骤的 LC_ALL=C 和 TAB;如果重新连接过终端,就在这里恢复。
export LC_ALL=C
TAB=$(printf '\t')
tail -n +2 source/late/payments.tsv | grep $'\tpaid$' | cut -f1 | sort -u > work/paid.sorted.txt
tail -n +2 source/late/cancellations.tsv | sort -u > work/cancelled-order-ids.txt
comm -23 work/paid.sorted.txt work/cancelled-order-ids.txt > work/eligible-order-ids.txt
你已经把相同规则应用于新的完整快照。现在重建用于关联的商品输入与目标文件:
tail -n +2 source/late/orders.tsv > work/orders.rows
sort -t "$TAB" -k1,1 -k3,3 work/orders.rows > work/orders.sorted.tsv
join -t "$TAB" work/eligible-order-ids.txt work/orders.sorted.tsv > work/pickup.rows
printf 'order_id\tcustomer\titem\tquantity\n' > pickup-list.tsv
cat work/pickup.rows >> pickup-list.tsv
cat pickup-list.tsv
现在应有六条商品明细:原来的五条加上 P107/Aya/oat/2。表头只出现一次。基于完整快照重建,意味着无需把所有旧行再次追加进去。
检查真正的新交接结果
切换到 Pickup Preview,打开 Pickup list 并重新加载。应显示 4 collection bags · 6 item lines · 9 pieces。打开 P107,确认 Aya 的两份 oat cookie。再次打开 P101,确认两条商品明细仍正确。已取消的 P103 和未付款的 P102 仍不应有标签。
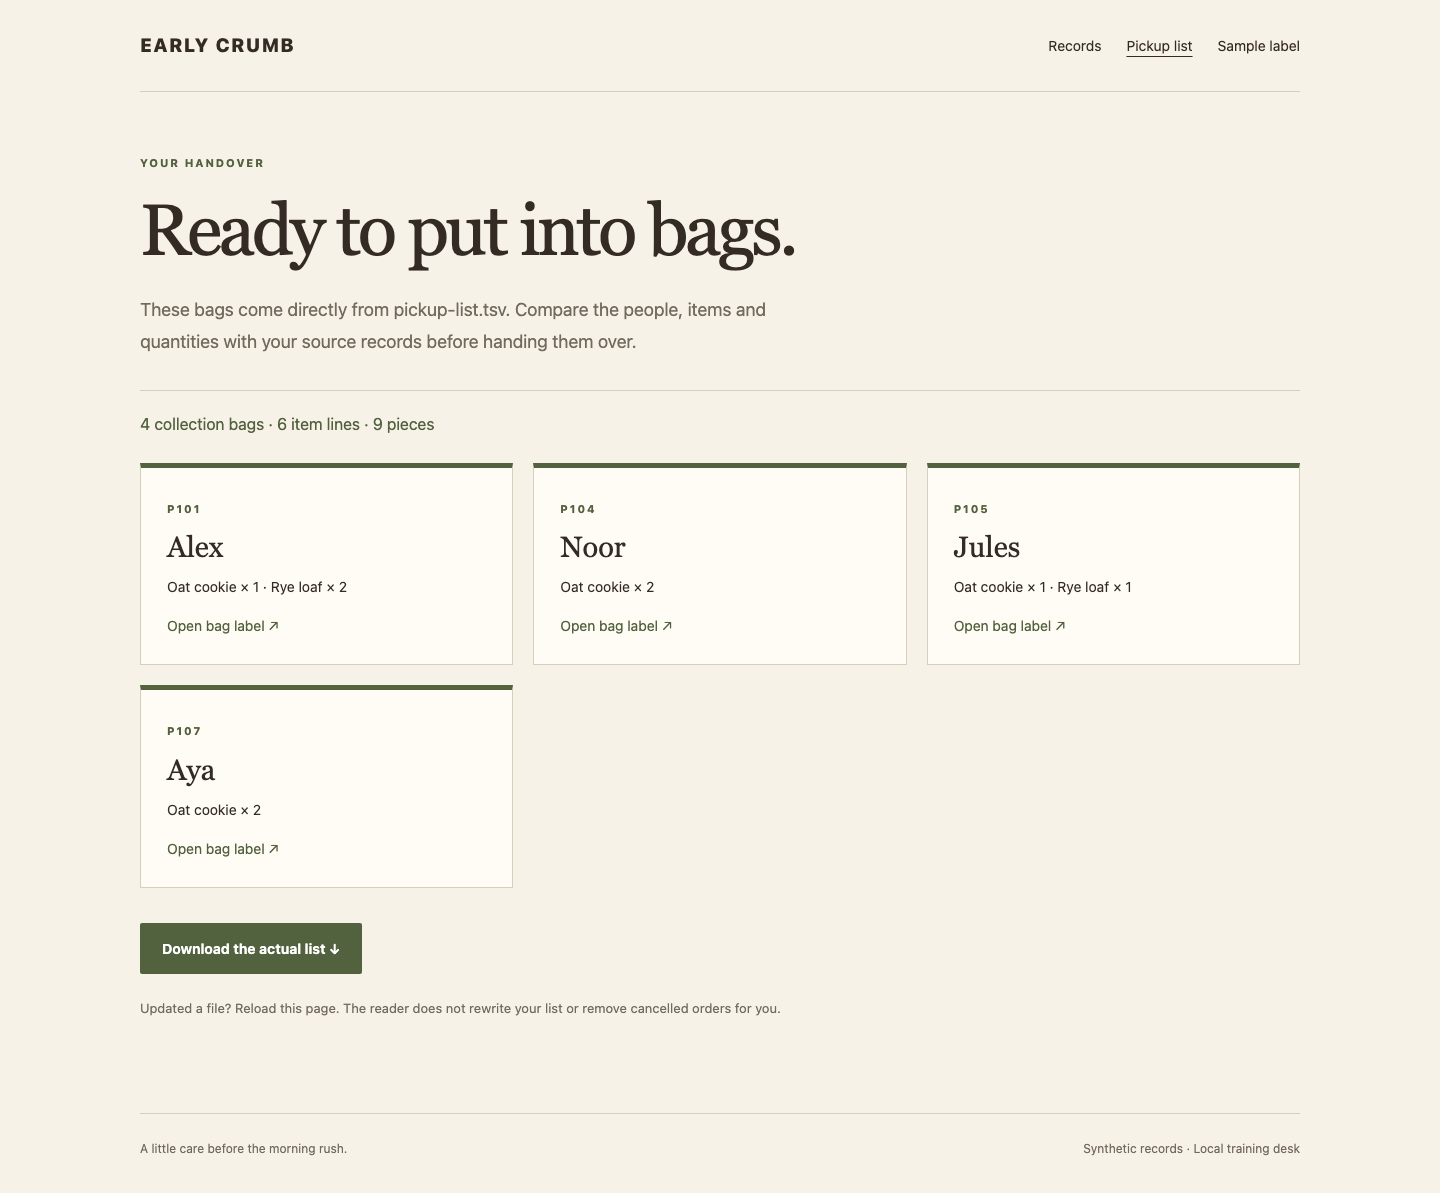
再次下载实际清单,与修订后的交接结果比较。Records 页面有意保留原始快照作为背景;后续输入是你在 source/late/ 下读取的文件。浏览器旧页面不能证明重跑命令失败,比较前先重新加载。
如果总数翻倍,回看两条写入目标的命令:必须先用 > 创建新表头,再用 >> 追加当前明细。如果 P107 缺失,确认付款与商品行都来自 source/late/。修正工作文件并重新生成,不要用手写预期总数代替真正的订单明细。
总结
你比较了已排序的 ID 集合,把有效订单重新关联到全部商品行,并制作了真实取货清单和袋签。你还针对后续完整快照重新执行相同流程,没有重复加入原有袋签。独立的工作坊挑战会在不同的资格关系与材料中使用同样方法。


