



介绍
EARLY CRUMB 正在准备周六的面包取货。订单、付款和取消记录分别保存;两位顾客同名,一份订单也可能有多种商品。可靠的交接首先需要连接正确记录,而非根据姓名猜测。
本实验将准备订单与付款表,将每个订单 ID 关联到付款状态,再生成已付款 ID 列表。取消处理留到下一个独立实验。只需基本终端操作能力;制表符、字段、排序和命令会在使用前解释。人物与记录均为虚构。
在 Workstation 输入命令,在 Pickup Preview 使用准备好的取货服务台。预览展示来源记录与示例标签,不会计算答案或创建你的文件。
准备用于关联的表格
本步骤将准备去掉表头的记录与已排序订单 ID 列表,同时不丢失商品行。从 Pickup Preview 开始。
理解交接用途
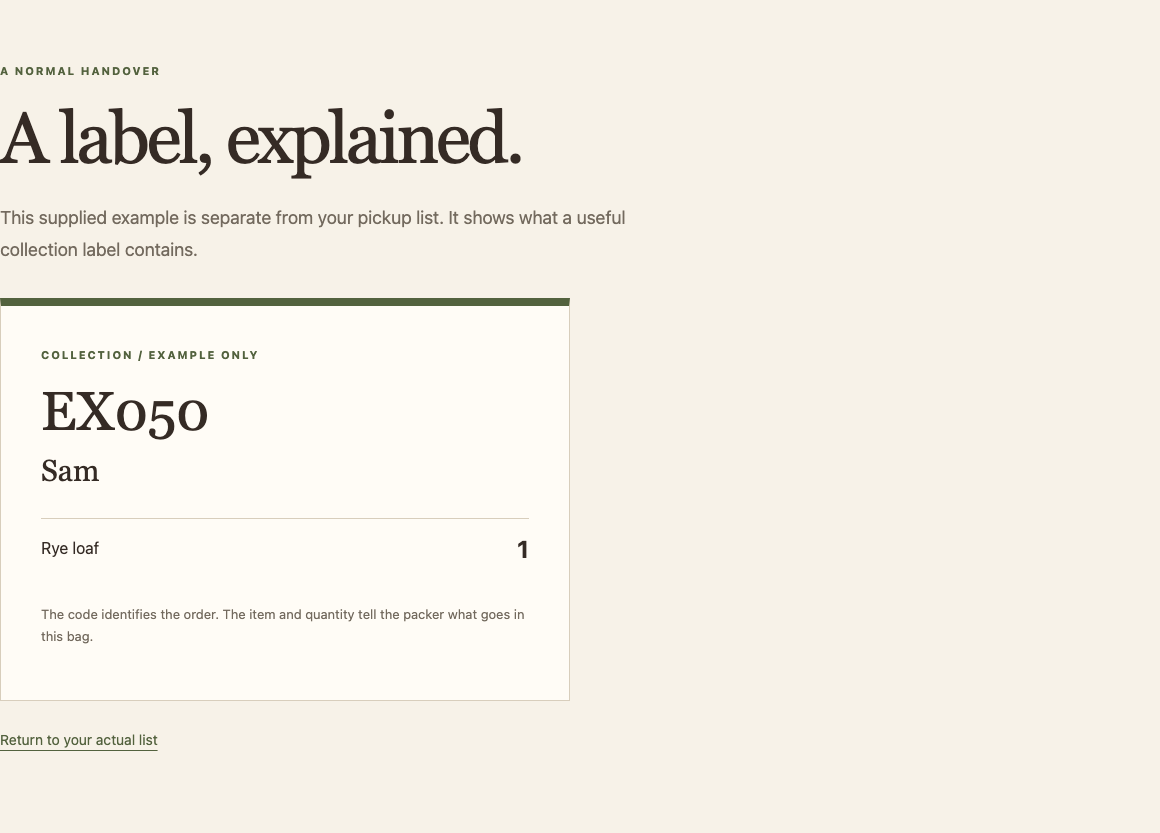
打开 Sample label。EX050 属于 Sam,包含一份 rye loaf。这是独立示例,不是你的最终取货清单。订单编号标识一个袋子,姓名帮助顾客识别,而每项商品及数量告诉备货员袋中应该装什么。
打开 Records。商品说明将 rye 对应到黑麦面包(Rye loaf),将 oat 对应到燕麦饼干(Oat cookie)。在 orders.tsv 中查找 P101:Alex 订购了两份 rye loaf 和一份 oat cookie。P102 也叫 Alex,但这是另一份订单,付款状态为 unpaid。按姓名关联会将错误商品分配给错误订单,应使用 order_id。
阅读准备好的文件
切换到 Workstation。终端从 /home/labex/project/pickup 开始。pwd 显示当前目录,ls 列出目录内条目:
pwd
/home/labex/project/pickup
ls
应看到 source 和 work。来源记录保持不变;work/ 保存可以重新生成的中间文件。source/orders.tsv 这样的路径相对于当前目录。若离开此目录,使用以下命令返回:
cd /home/labex/project/pickup
cat 显示文件内容。读取两张表:
cat source/orders.tsv
cat source/payments.tsv
TSV 意为制表符分隔值。每行是一条记录,字段由制表符分开,第一行是表头。订单表的四个字段依次为订单 ID、顾客、商品和数量。一份订单可有多条商品行。付款表有订单 ID 和完整状态 paid 或 unpaid 两个字段,每单至多一条付款记录。提供的格式不允许字段值内部包含制表符或换行。
P106 出现在订单中,却没有付款行。信息缺失不表示已付款,关联时应让它保持可见。
将表头与记录分开
tail -n +2 从第 2 行开始输出。> 将输出保存到文件,如果目标已存在就覆盖它,不会改变来源。不要让 > 的输入和输出使用同一路径:程序读取前,Shell 就会清空该文件。
tail -n +2 source/orders.tsv > work/orders.rows
tail -n +2 source/payments.tsv > work/payments.rows
检查商品行:
cat work/orders.rows
P101 和 P105 各出现两次,因为各有两种商品。保留这些行;订单 ID 重复并不自动意味着数据重复。
准备关联键
键是连接记录所用的字段。cut -f1 选择第一个制表符分隔字段;管道 | 将输出传给下一条命令。sort -u 排序并让完全相同的行只保留一份。此处只对 ID 列表去重,不对商品表这样处理。
排序与关联必须使用相同顺序。LC_ALL=C 选择可预测的字节排序规则;export 让后续命令使用它。该设置属于当前终端,新开终端时应重新设置。
export LC_ALL=C
cut -f1 work/orders.rows | sort -u > work/order-ids.txt
cat work/order-ids.txt
P101
P102
P103
P104
P105
P106
对于两字段付款表,按第一字段排序,同时保留状态。TAB 是保存一个制表符的 Shell 变量:printf '\t' 输出制表符,$(...) 捕获输出。"$TAB" 中的双引号将它作为一个分隔符参数传入。-t 设置字段分隔符;-k1,1 仅选择第一字段作为排序键。
TAB=$(printf '\t')
sort -t "$TAB" -k1,1 work/payments.rows > work/payments.sorted.tsv
cat work/payments.sorted.tsv
应看到 P101 至 P105 按顺序排列,各自保留原始状态,P106 并未凭空获得付款行。现在六个独立订单 ID 和全部五条付款记录已可关联。若表头或状态有问题,只从来源重建相关工作文件,不要修改来源来凑结果。
将每个订单关联到付款状态
本步骤将关联两份准备好的输入,同时保留付款缺失的订单。从 Workstation 开始,沿用第 1 步的终端。
先明确关联的含义
P101 应对应 paid,P102 对应 unpaid,P106 对应显式的 missing 值。姓名不参与关联。此时已付款订单仍可能取消,仅关联付款还不能决定最终取货清单。
join 默认按已排序输入的第一字段连接。普通内连接会丢掉没有匹配的 ID,这里还需要看见这些缺失记录:
-t "$TAB"使用第 1 步创建的制表符分隔符。-a 1同时保留第一个输入,即完整订单 ID 列表中的未匹配记录。-e missing为缺失的输出字段提供missing一词。-o 1.1,2.2输出输入 1 的字段 1(订单 ID),再输出输入 2 的字段 2(状态)。这里的1、2指输入文件,不是行号。
将完整命令作为一行运行,写出两个字段的结果:
join -t "$TAB" -a 1 -e missing -o 1.1,2.2 work/order-ids.txt work/payments.sorted.tsv > work/payment-match.tsv
cat work/payment-match.tsv
P101 paid
P102 unpaid
P103 paid
P104 paid
P105 paid
P106 missing
上面的空隙表示制表符,不是反斜杠和 t 两个字面字符。应有六行。P106 仍然存在,因为左侧输入包含全部订单 ID,而 -a 1 保留未匹配的 ID。
筛选前先读懂结果
P101 和 P102 在来源中都叫 Alex,但状态不同。P103 也已付款,后续取消处理可能将它排除。P106 没有付款记录,用 missing 可以避免它在比较中悄悄消失。
如果 join 报告输入未排序,返回第 1 步,用相同的 LC_ALL=C 重新生成两份已排序输入。不要忽略警告,也不要删除不便处理的订单。如果终端重新连接过,重试前先按第 1 步恢复目录与两项 Shell 设置。
命令成功退出本身还不够,应将这三条重要记录与来源对照。现在你得到了一份完整付款关联结果,可用于下一步判断。
选择已付款订单,同时保留其身份
本步骤将生成已付款订单 ID 文件,并查看实际保存的结果。从 Workstation 开始。
匹配完整状态
paid 和 unpaid 都包含 paid 这几个字母。宽泛的文本搜索会错误地纳入 P102。我们需要匹配制表符后、直到行末的完整状态。
grep 选择匹配行。在 $'\tpaid$' 表达式中,外层 $'...' 让 \t 成为制表符;表达式内部末尾的 $ 表示行末。因此状态字段必须完整等于 paid,而不能只是 unpaid 的末尾。cut -f1 再保留订单 ID。由于关联表已排序,输出也已经有序。
grep $'\tpaid$' work/payment-match.tsv | cut -f1 > paid-order-ids.txt
cat paid-order-ids.txt
P101
P103
P104
P105
P102 未付款,P106 缺少记录,因此都不在其中。此时保留 P103:该文件表示的是已付款订单,而非最终需要备货的订单集合。尚未考虑取消就将它删除,会把两个判断混为一谈,使中间结果含义不准确。
阅读实际保存的选择
切换到 Pickup Preview,在导航中选择 Payment IDs。页面展示 paid-order-ids.txt,不会替你计算付款答案。应看到刚保存的四个 ID。通过 Compare with source records 返回,并核对对应付款行。
预览的 Pickup list 此时仍可能显示没有可备货清单,这是正常的:你只完成了付款选择,还没有最终商品清单。下一个独立实验将用此结果排除取消,并保留每项有效商品数量。
如果文件为空或包含 P102,检查 work/payment-match.tsv 和完整状态模式,再运行筛选命令。无需更改任何来源记录,就能修正并重新生成结果。
总结
你准备了制表符分隔记录,按共同键排序,关联付款时保留缺失记录,并选择了完整的已付款状态。你还区分了订单身份、顾客姓名和商品行。下一个独立实验会将付款选择结果变成真正可用的取货交接文件。


