介绍
Meridian Museum 帮助访客按材质和故事寻找藏品。首页能够响应时,藏品搜索却不一定可用。每个新的搜索容器都会把提供的十二条记录导入内存中的词语索引。数据源刻意按一定节奏提供记录,便于观察加载过程;替换后的容器必须从头构建自己的索引。
你将阻止仍在加载的 Pod 接收访客 Service 的流量,为启动留出足够时间,并在现有副本继续返回正确搜索结果时更新导入程序。前置条件是基本终端操作,以及对容器镜像和运行中容器的了解。本实验会介绍 Kubernetes 对象、YAML 补丁和探针设置。集群、缓存的博物馆镜像和完整网站均已准备好,无须安装软件、创建外部账号或编写应用程序。
在 Museum 中体验访客流程,在 Workstation 中执行命令。只操作命名空间 meridian 和提供的博物馆工作目录。这是单节点学习集群,不代表高可用,也不保证请求永不失败。每个实验都从独立环境开始。
只让能够搜索的 Pod 接收访客
在这一步中,你将区分运行中的进程与可用的搜索索引,并为真实访客任务添加就绪检查。从 Museum 开始。
体验正常的访客流程
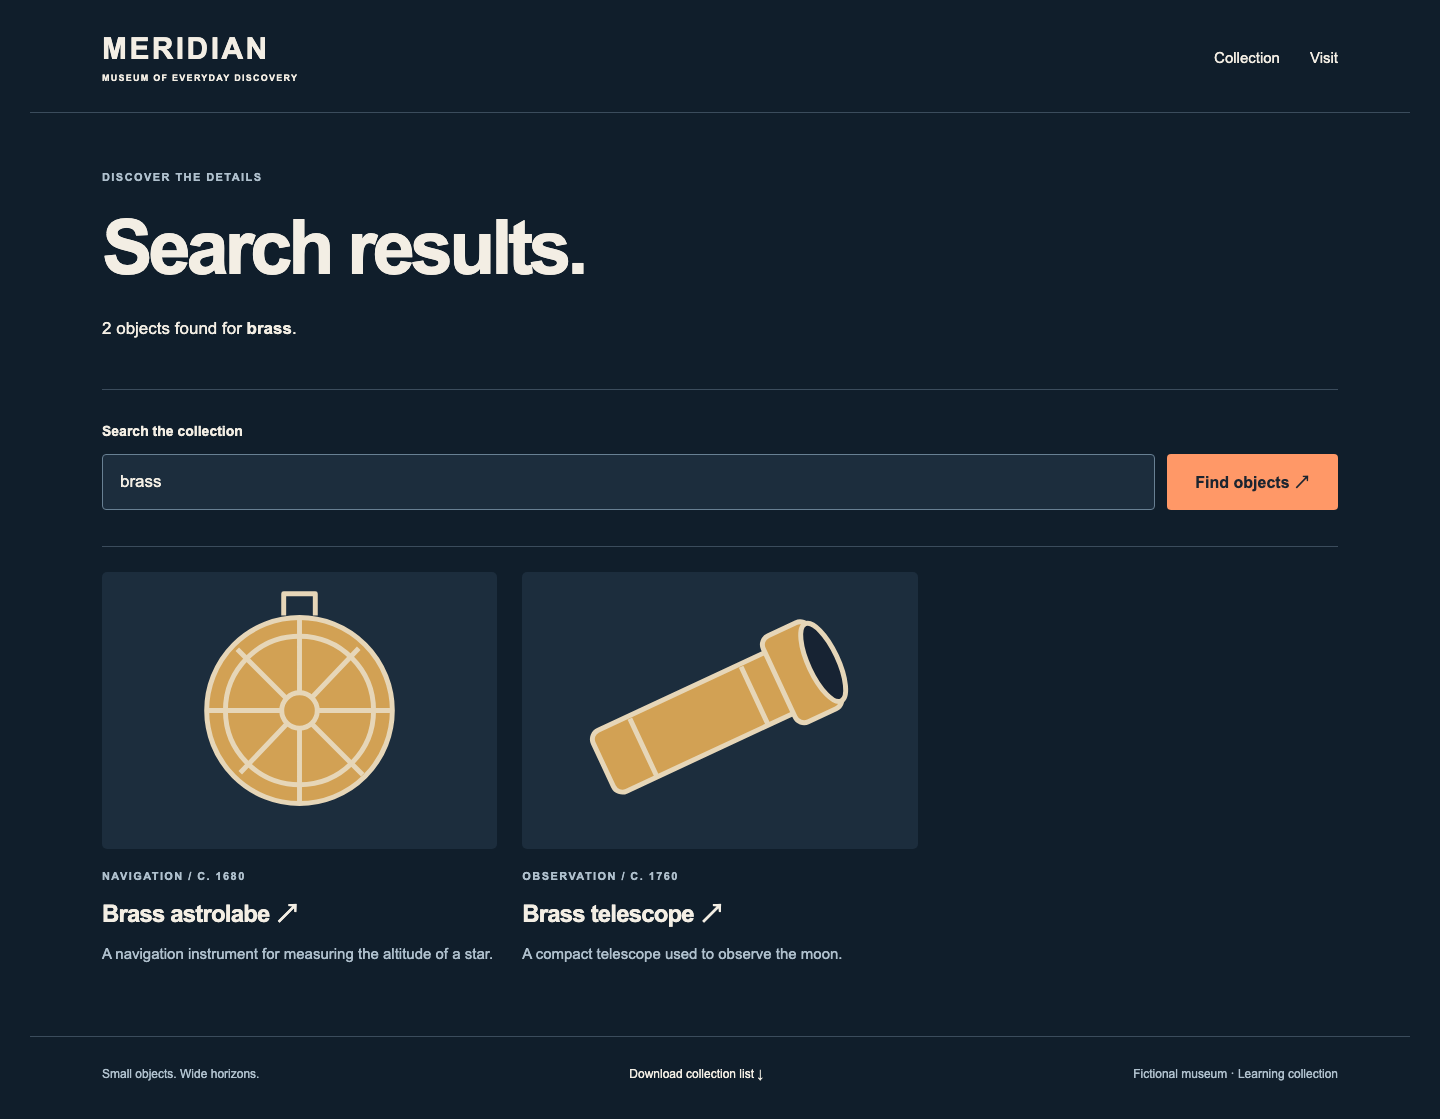
在 Search the collection 中输入 brass,选择 Find objects ↗。结果应包含 Brass astrolabe 和 Brass telescope,并显示 2 objects found。打开 Brass astrolabe,查看它的故事、插图和 Gallery 1 位置。选择 See it at the museum ↗,阅读开放时间及平层入口说明,再选择 Download collection list ↓。打开下载的 CSV:其中应有十二件藏品,包括这两件黄铜仪器。通过 MERIDIAN 返回首页。你的修改必须保留这些功能。
认识三种 Kubernetes 对象
切换到 Workstation。pwd 输出当前目录,ls 列出目录中的文件:
pwd
ls
当前目录是 /home/labex/project/museum。Pod 运行博物馆容器;Deployment 维持两个 Pod 副本,并在容器模板变化时替换它们;Service 为访客提供稳定地址,把请求路由到选中的就绪 Pod。标签把这些对象联系起来:Service 选择带有 app: search 标签的 Pod。命名空间把本课程的对象归为一组;下面的每条命令都明确指定 meridian。
kubectl 请求集群读取或修改对象。get 列出对象,-n 选择命名空间。cat 输出文本文件,便于阅读已准备好的候选配置:
kubectl get deployments,pods,services -n meridian
cat candidate.yaml
YAML 使用 key: value 表示键值对,用空格缩进,用 - 表示列表项。在 spec.template 下,容器使用已缓存的 meridian-museum:1 镜像。imagePullPolicy: Never 要求使用该现成镜像,而不从镜像仓库下载。IMPORT_INTERVAL: "2" 让记录每隔两秒导入一次:十二条记录约需 24 秒。初始访客副本使用较短间隔,让你先体验正常搜索。
预置滚动更新保持 replicas: 2,允许额外创建一个候选副本(maxSurge: 1),并且不允许现有副本变为不可用(maxUnavailable: 0)。这些设置依赖真实的就绪判断:没有探针时,搜索尚未可用,运行中的进程就可能被视为合格。保持这些设置、镜像、标签和 Service 不变。
观察训练服务过早接收流量
浏览器使用 HTTP 请求与响应协议。状态 200 表示响应成功,503 表示服务器暂时无法处理该请求。首页可用并不能证明搜索等其他请求也能成功。
本博物馆没有真实顾客。你将先有意演示不安全的更新,再加以改善。cp 把候选配置复制为可编辑的 search.yaml;apply -f 提交该文件中的 YAML,变化的 Pod 模板会触发更新。python3 运行提供的只读观察程序;--seconds 30 对真实访客 Service 采样 30 秒,检查搜索响应是否包含两件黄铜藏品。一起执行更新和观察:
cp candidate.yaml search.yaml
kubectl apply -f search.yaml
python3 observe.py --seconds 30
未受保护的新容器加载时,预计会出现一些 HTTP=503 correct_search=false 行,具体数量会变化。首页仍然可用;搜索的 503 响应会明确说明藏品正在准备。这是加载中 Pod 的真实响应,不是预设的成功或失败动画。
rollout status 等待此 Deployment 的更新完成,--timeout 限制客户端的等待时间:
kubectl rollout status deployment/search -n meridian --timeout=90s
即使之前的加载阶段没有受到 readiness 探针保护,它仍可能报告成功。等黄铜搜索恢复正常再继续。如果看到连接错误而不是 HTTP 状态,读取 Pod 表格并重试;服务器不存在与服务器返回 503 是不同情况。
添加业务就绪检查
readiness 探针判断这个 Pod 是否应接收 Service 流量。失败会取消流量资格,但不会重启容器。该镜像的 /health/process 始终报告 HTTP 进程状态;只有十二条记录全部建立索引、已知黄铜搜索正常时,/ready/search 才返回 200。导入期间浏览器首页也返回 200,因此首页和进程端点都不适合这里的就绪判断。
patch 修改指定字段。--patch-file 读取你的文件;--type=strategic 按名称合并 search 容器,同时保留其他设置。探针向本 Pod 名为 http 的端口发送 HTTP 请求,每两秒检查一次,一次失败后就标记为未就绪。写入下面的小补丁。cat > readiness.yaml 替换该文件;<<'YAML' 开始按原样写入的 here-document,请粘贴完整内容,包括单独占一行的结束标记 YAML,并保持空格缩进:
cat > readiness.yaml <<'YAML'
spec:
  template:
    spec:
      containers:
        - name: search
          readinessProbe:
            httpGet:
              path: /ready/search
              port: http
            periodSeconds: 2
            failureThreshold: 1
YAML
kubectl patch deployment search -n meridian --type=strategic --patch-file readiness.yaml
python3 observe.py --seconds 30
新副本导入期间,正确搜索应继续由现有副本提供。
EndpointSlice 记录 Service 的实际 Pod 地址和就绪状态。-l 按 service-name 标签筛选,-o jsonpath 只从结构化响应中选取地址和 ready 字段。提供的显示表达式遍历端点记录并输出这些字段,只读取状态。检查 Pod 和 Service 地址:
kubectl get pods -n meridian
kubectl get endpointslices -n meridian -l kubernetes.io/service-name=museum -o jsonpath='{range .items[].endpoints[*]}{.addresses[0]} ready={.conditions.ready}{"\n"}{end}'
kubectl rollout status deployment/search -n meridian --timeout=90s
kubectl get pods -n meridian
导入期间,你可能看到新的 0/1 Running Pod,以及 ready=false 的地址。现有就绪端点仍会提供搜索。加载结束后,候选副本就绪,替换继续进行。如果错过了短暂的中间状态,后续步骤会提供更长的观察窗口。
结束时必须恰有两个 1/1 Running Pod。滚动更新报告成功后,旧 Pod 可能短暂处于 Terminating;等待并重复 get pods,直到它离开。在 Museum 中重新搜索黄铜并查看星盘详情。遇到 YAML 错误时,修正补丁并重新应用;探针路径拼错时,只在同一补丁中替换路径并重新应用。不要删除其他命名空间,也不要通过缩短导入时间来掩盖错误。
为导入程序提供足够的启动时间
在这一步中,你将区分等待就绪与启动失败,并根据实际导入过程设置启动预算。从 Workstation 开始。
startup 探针限制新容器可用于初始化的时间。在它尚未成功时,Kubernetes 暂不执行 readiness 检查。启动失败达到阈值后,kubelet 会重启容器。startup 探针是可选的;预算过小可能导致原本正常的应用始终无法就绪。启动成功后,它也不能替代 readiness。
观察过小的预算
startup-short.yaml 是提供的训练示例。startup 探针失败会请求重启容器,但终止过程可能延迟可见重启计数的增加。下面的客户端等待 60 秒,让你观察这种区别。应用之前先阅读示例:
cat startup-short.yaml
kubectl patch deployment search -n meridian --type=strategic --patch-file startup-short.yaml
kubectl rollout status deployment/search -n meridian --timeout=60s
预期 rollout 命令会失败并显示 error: timed out waiting for the condition,其真实退出状态为非零。继续使用此交互终端。示例每两秒检查一次,仅允许两次失败,启动窗口约为四秒,无法容纳 24 秒的导入。
读取现场证据。logs 显示应用输出,--prefix 标识每个 Pod,--tail=4 把各日志限制为最后四行。选择器请求所有搜索 Pod。get events 读取集群观察记录,--field-selector reason=Unhealthy 将范围缩小到失败的健康检查:
kubectl get pods -n meridian
kubectl logs -n meridian -l app=search --prefix --tail=4
kubectl get events -n meridian --field-selector reason=Unhealthy
新 Pod 保持未就绪,其 RESTARTS 应增加。它可能显示 CrashLoopBackOff,表示 Kubernetes 正在延迟下一次重启。如果已记录启动失败,而表格仍显示零,先等待并重复 get pods,再修改预算:表格只反映某一时刻,终止也需要时间。每次重启都会丢弃该容器的内存索引,因此替代容器需要重新导入记录。
已经启动检查失败的容器,即使稍后输出 index_complete,也不会取消待执行的重启,更不会成为就绪的 Service 后端。结合重启计数与启动失败事件判断。旧 Pod 保持 1/1,继续使用其已完成的索引提供服务。
切换到 Museum 搜索 brass。正确结果仍由现有就绪副本经 Service 返回。停滞的更新没有自动回退:Deployment 仍请求部署有问题的候选。不要把旧服务得以保留误认为更新已经完成。
计算并应用合理预算
切换到 Workstation。十二条记录,每条两秒,约需 24 秒。这里使用 60 秒预算,也能容纳下一步的 36 秒导入,并留出十二秒的教学余量。periodSeconds × failureThreshold 是规划近似值,不是截止时间保证;调度、探针超时和实际负载会造成变化。生产环境应测量启动时间,再有意识地选择余量。
使用同样的补丁文件方法,保留真实业务路径和命名端口:
cat > startup.yaml <<'YAML'
spec:
  template:
    spec:
      containers:
        - name: search
          startupProbe:
            httpGet:
              path: /ready/search
              port: http
            periodSeconds: 2
            failureThreshold: 30
YAML
kubectl patch deployment search -n meridian --type=strategic --patch-file startup.yaml
kubectl rollout status deployment/search -n meridian --timeout=120s
kubectl get pods -n meridian
这会创建采用正确启动设置的替代 Pod。每个 Pod 都应在不重启的情况下完成加载;最终表格必须包含两个 1/1 Running Pod,且均为 RESTARTS 0。等待终止中的旧 Pod 离开,必要时重复读取表格。启动成功后,readiness 继续控制流量资格。
如果更新仍然停滞,读取相同日志和事件,对比文件中的路径与预算,修正后重新应用。删除 Pod 不会修正 Deployment 模板;新 Pod 仍会使用相同的错误设置。注意区分 60 秒探针预算与 --timeout=120s:后者只限制客户端等待 rollout 的时间。
在更慢的更新期间保持搜索可用
在这一步中,你将应用更慢的导入,并结合 Service 响应与就绪端点评估更新。从 Workstation 开始。
kubectl set env 修改 Deployment 模板中的容器环境变量。它会创建替代 Pod,而不会修改已运行容器的环境。把数据源间隔设为三秒。十二条记录现在约需 36 秒,仍在 60 秒启动预算内:
kubectl set env deployment/search -n meridian IMPORT_INTERVAL=3
kubectl get pods -n meridian
kubectl get endpointslices -n meridian -l kubernetes.io/service-name=museum -o jsonpath='{range .items[].endpoints[*]}{.addresses[0]} ready={.conditions.ready}{"\n"}{end}'
python3 observe.py --seconds 45
导入期间,新 Pod 应为 0/1 Running。现有就绪地址继续返回正确的黄铜搜索结果。观察程序使用 Museum 所访问的同一个 NodePort Service,不会专门选中某个正常 Pod。在实测运行中,受保护请求保持正确。有限样本无法保证在所有真实网络、应用和集群条件下都零失败。
等待完整更新并检查最终状态:
kubectl rollout status deployment/search -n meridian --timeout=120s
kubectl get pods -n meridian
kubectl get endpointslices -n meridian -l kubernetes.io/service-name=museum -o jsonpath='{range .items[].endpoints[*]}{.addresses[0]} ready={.conditions.ready}{"\n"}{end}'
旧的 Terminating Pod 离开后,必须恰有两个当前 Pod 就绪,且重启次数为零;它们的两个端点地址均应显示 ready=true。导入期间保留健康旧副本很有用,但最终 rollout 必须真正收敛到新修订版。
检查完整访客服务
切换到 Museum。通过 MERIDIAN 返回首页,再次搜索 brass。两件仪器都必须出现;打开望远镜并跟随其参观链接。搜索 volcano:页面应说明没有找到藏品,而不是失败。打开 Collection,浏览一件非黄铜藏品,再从 Visit 下载藏品列表。确认十二件藏品以及保留的插图和导航。
切换到 Workstation。curl 请求 URL,-sS 隐藏进度但显示连接错误。127.0.0.1 表示当前训练实例,端口 30081 属于真实博物馆 Service。引号把查询 URL 保持为一个 shell 参数:
curl -sS 'http://127.0.0.1:30081/search?q=brass'
读取 HTML 中两个正确的标题,而不是只看 HTTP 成功状态。如果检查时旧 Pod 仍在终止,等待后重试;不要移除探针或缩短导入时间。保持集群、提供的镜像、Service 和十二条源记录不变。最终成果结合了真实业务就绪检查、充足启动余量,以及保留完整博物馆体验的已完成更新。
总结
你把 readiness 与真实藏品索引联系起来,观察了过小 startup 预算如何失败并重启候选,然后计算合理启动余量。你在现有就绪副本继续提供搜索时更新了按节奏运行的导入程序,再检查当前 Pod、Service 端点与完整访客流程。进程运行、后端就绪和更新完成是不同事实;本单节点练习不能证明生产高可用或零失败。