介绍
当 AI 模型准备较长的回答时,等待完整结果会让应用看起来像是卡住了。流式传输可以让应用在内容准备好后立即接收一小段一小段的结果。这类似于发送者还在打字时,你就开始阅读消息:生成完整回答所需的总体工作量基本不变,但有用的文字会更早出现。
本实验使用 Server-Sent Events(SSE)。这是一种通过单个 HTTP 响应发送一系列事件的文本格式。每个 Workers AI 事件都以 data: 开头。文本事件携带生成回答的一部分,最后的 data: [DONE] 事件表示流已正常完成。事件之间出现暂停,只说明模型仍在工作;如果没有完成信号,应用就无法判断这是响应速度较慢,还是连接永远不会结束。
你将构建 POST /help,把 Cloudflare 托管的 Llama 响应流式传输给指定的命令行客户端,并练习两种结束方式:正常完成,以及在收到第一段有用内容后主动取消。取消表示客户端不再需要剩余回答,因此关闭这项工作,而不是让无用连接继续保持打开。你还将使用确定性测试,证明模型启动失败会转换为有界错误,并且被中断的流会终止而不是一直挂起。
这是本课程的第二个实验。本实验假设你已经知道 Cloudflare Worker 是运行在 Cloudflare 网络上的应用代码,并且 AI 绑定会通过 env.AI 暴露 Workers AI。如果你是直接进入本实验,请先完成将 LabEx 连接到 Cloudflare 账户,了解如何使用 VM 终端、授权 Wrangler、确认学习账户并保存账户 ID。
本实验使用 @cf/meta/llama-3.3-70b-instruct-fp8-fast 和少量合成问题。Workers Free 账户目前共享每天 10,000 Neurons 的配额。本地推理同样会访问 Cloudflare,并消耗该配额。如果配额已用尽或模型没有可用容量,请停止操作,不要重复发送请求;应用应报告终止错误,而不是一直挂起。
安装过程会在 /home/labex/project/help-stream 中安装 Node.js 22.22.0 和项目本地的 Wrangler 4.132.0,并提供 SSE 客户端、确定性测试数据和独立检查脚本。安装过程不会登录、调用模型、部署 Worker 或创建云资源。在删除临时 Worker 并确认退出登录之前,请保持此 VM 打开。
授权 VM 并配置流式 Worker
在本步骤中,你将授权这台全新的 VM,并配置临时流式 Worker。你已经登录 Dashboard,并不代表终端命令自动获得了管理学习账户的权限。
进入已准备好的项目目录,并确认固定的 Wrangler 版本:
cd /home/labex/project/help-stream
npx wrangler --version
应显示 4.132.0。只请求本实验所需的权限。Workers Scripts 写入权限用于管理临时 Worker;Workers AI 写入权限允许其绑定调用模型;两个读取权限用于识别所选账户。Wrangler 4.132.0 还会在删除 Worker 时检查 KV 绑定依赖,因此需要范围较小的 KV 写入权限,让清理命令能够完成,即使本实验不会创建 KV 数据。
npx wrangler login --device --browser=false --scopes account:read user:read workers_scripts:write workers_kv:write ai:write
打开显示的链接,输入当前设备代码,检查账户和权限,然后授权学习账户。由于 Wrangler 会在浏览器关闭后继续运行,界面中还可能出现 Background Access。返回终端并等待成功消息,然后检查结构化身份信息:
npx wrangler whoami --json
确认 loggedIn: true,并读取目标账户的 name 和 id。生成一个唯一的临时 Worker 名称:
RUN="labex-c07-a02-$(openssl rand -hex 6)"
printf '%s\n' "$RUN"
将下面配置中的 YOUR_ACCOUNT_ID 替换为该账户的实际 ID:
cat > wrangler.jsonc <<JSON
{
  "\$schema": "./node_modules/wrangler/config-schema.json",
  "name": "$RUN",
  "account_id": "YOUR_ACCOUNT_ID",
  "main": "src/index.js",
  "compatibility_date": "2026-09-16",
  "compatibility_flags": ["enable_request_signal"],
  "workers_dev": true,
  "preview_urls": false,
  "observability": {
    "enabled": true,
    "head_sampling_rate": 1
  },
  "ai": {
    "binding": "AI",
    "remote": true
  }
}
JSON
AI 绑定将通过 env.AI 提供。remote: true 表示本地开发仍会使用真实的云端模型。enable_request_signal 会让 request.signal 在客户端断开连接时发出通知,为 Worker 提供可记录和处理的取消信号。可观测性功能会保存稍后要检查的生命周期事件。此时还没有部署 Worker,也没有执行推理。
检查 AI 绑定和 SSE 客户端
在本步骤中,你将在编写 Worker 之前,把 AI 绑定连接到提供的 SSE 客户端。模型是生产者,Worker 负责转发字节,client.mjs 是消费者。分清这些角色后,就能明确应该由哪个组件关闭这项工作。
生成 Worker 的环境类型:
npx wrangler types
grep -A4 'interface __BaseEnv_Env' worker-configuration.d.ts
查找 AI: Ai。这表示配置好的绑定会以 env.AI 的形式提供给处理函数;它不是存储在源代码中的 API 密钥。
现在检查所提供客户端的终止状态:
grep -nE 'chunk:|complete chunks=|cancelled after|stream_error:' client.mjs
客户端会逐段读取响应。chunk: 行表示新生成的文本。只有在收到 data: [DONE] 后,才会出现 complete。取消模式会在收到第一段非空内容后关闭读取器。stream_error 表示终止失败,包括 45 秒超时;超时是安全边界,并不表示每次模型响应都应当花费这么长时间。
SSE 事件是由空行分隔的纯文本。一次典型的成功流如下:
data: {"response":"First piece"}

data: {"response":" and another piece."}

data: [DONE]
分块边界属于传输细节:一个事件可能包含一个单词、标点符号或更长的片段。应用逻辑应合并 response 字符串并等待 [DONE],不要假设分块的数量或大小固定。
构建带监控的流式端点
在本步骤中,你将构建流式端点及其生命周期监控。Worker 会使用 stream: true 请求模型生成流,然后向客户端提供相同的 SSE 协议。它不会先将完整回答收集到内存中。一个小型包装器会监控流的生命周期:完成时正常关闭,取消时取消上游读取器,发生流错误时终止响应。
创建 Worker 入口文件:
cat > src/index.js <<'JS'
const MODEL = "@cf/meta/llama-3.3-70b-instruct-fp8-fast";
const MAX_QUESTION = 800;

function json(data, status = 200) {
  return Response.json(data, { status });
}

async function readQuestion(request) {
  const contentType = request.headers.get("content-type") || "";
  if (!contentType.toLowerCase().includes("application/json")) {
    return { error: json({ error: "json_required" }, 415) };
  }

  const raw = await request.text();
  if (raw.length > 2048) {
    return { error: json({ error: "question_too_large" }, 413) };
  }

  let body;
  try {
    body = JSON.parse(raw);
  } catch {
    return { error: json({ error: "invalid_json" }, 400) };
  }

  const question = typeof body?.question === "string" ? body.question.trim() : "";
  if (!question) {
    return { error: json({ error: "invalid_question" }, 400) };
  }
  if (question.length > MAX_QUESTION) {
    return { error: json({ error: "question_too_large" }, 413) };
  }
  return { question };
}

function monitor(upstream, details) {
  const reader = upstream.getReader();
  let terminal = false;

  return new ReadableStream({
    async pull(controller) {
      try {
        const { done, value } = await reader.read();
        if (done) {
          terminal = true;
          console.log(JSON.stringify({ event: "help_stream_completed", ...details }));
          controller.close();
          return;
        }
        controller.enqueue(value);
      } catch {
        terminal = true;
        console.error(JSON.stringify({ event: "help_stream_failed", ...details }));
        controller.error(new Error("model stream interrupted"));
      }
    },
    async cancel(reason) {
      if (!terminal) {
        terminal = true;
        console.log(JSON.stringify({ event: "help_stream_cancelled", ...details }));
      }
      await reader.cancel(reason);
    }
  });
}

async function streamHelp(request, env) {
  const parsed = await readQuestion(request);
  if (parsed.error) return parsed.error;

  const requestId = crypto.randomUUID();
  const details = { requestId, model: MODEL };
  request.signal.addEventListener("abort", () => {
    console.log(JSON.stringify({ event: "help_client_disconnected", ...details }));
  }, { once: true });

  try {
    const upstream = await env.AI.run(MODEL, {
      messages: [
        {
          role: "system",
          content: "Answer the support question in at most four short sentences. Give safe, practical steps and do not invent account details."
        },
        { role: "user", content: parsed.question }
      ],
      stream: true,
      max_tokens: 160,
      temperature: 0.2
    });

    if (!(upstream instanceof ReadableStream)) {
      throw new Error("stream unavailable");
    }

    console.log(JSON.stringify({ event: "help_stream_started", ...details }));
    return new Response(monitor(upstream, details), {
      headers: {
        "content-type": "text/event-stream; charset=utf-8",
        "cache-control": "no-store",
        "x-request-id": requestId
      }
    });
  } catch {
    console.error(JSON.stringify({ event: "help_stream_start_failed", ...details }));
    return json({ error: "model_unavailable", requestId }, 502);
  }
}

export default {
  async fetch(request, env) {
    const url = new URL(request.url);
    if (request.method === "GET" && url.pathname === "/health") {
      return json({ status: "ok" });
    }
    if (request.method === "POST" && url.pathname === "/help") {
      return streamHelp(request, env);
    }
    return json({ error: "not_found" }, 404);
  }
};
JS
代码会记录请求 ID 和生命周期事件,但不会记录问题或生成的回答。请求 ID可以把某个客户端响应与一条日志关联起来,而不必将支持内容复制到可观测性数据中。错误响应还会隐藏内部提供商的详细信息;运维人员可以使用生命周期日志,而客户端只会收到稳定的 model_unavailable 契约。
运行确定性测试。测试中的虚假 AI 绑定会发出受控事件、在开始流式传输前失败、支持取消,并在不消耗 Neurons 的情况下中断一次流:
node --test test/worker.test.mjs
应通过 6 个测试。然后在不部署的情况下打包真实 Worker:
npx wrangler deploy --dry-run
测试证明了受控时序下的应用行为。试运行证明源代码和配置可以一起完成打包。两者都不能证明云端模型当前可用;下一步骤会使用一次真实流进行验证。
观察真实的本地流
在本步骤中,你将通过 VM 中运行的 Worker 进程观察一次真实流。「本地」只表示请求处理程序在本地运行;模型推理仍会在所选账户中执行,并计入该账户的每日配额。
在后台启动 Wrangler,并保存其进程 ID:
npx wrangler dev --port 8787 > .labex/dev.log 2>&1 &
echo $! > .labex/dev.pid
等待不调用 AI 的健康检查路由:
for attempt in $(seq 1 30); do
  if curl --silent --fail http://127.0.0.1:8787/health; then
    break
  fi
  sleep 1
done
现在使用提供的客户端发送一个简短的合成问题:
node client.mjs http://127.0.0.1:8787 \
  "How can I safely retry an invoice upload without creating a duplicate ticket?"
你应看到一行或多行 chunk:,随后看到类似下面的终止行:
complete chunks=18 chars=238
文本内容、分块数量和字符数量会有所不同。真正重要的证据是:先收到非空的增量内容,随后收到 [DONE],客户端会将其转换为 complete。如果看到 stream_error,请检查 .labex/dev.log。配额、授权或容量错误表示推理失败,不应因此无限等待。
最后,证明应用验证仍会在推理之前执行:
curl --silent --show-error --write-out '\nHTTP %{http_code}\n' \
  http://127.0.0.1:8787/help \
  --header 'Content-Type: application/json' \
  --data '{"question":""}'
应得到 {"error":"invalid_question"} 和 HTTP 400。只有普通请求通过边界检查后,流式传输才有意义。
部署、完成并取消流
在本步骤中,你将部署 Worker,完成一次流式请求,并在另一次请求收到第一段有用内容后取消它。首先,只停止已保存的开发进程,并等待它退出:
kill "$(cat .labex/dev.pid)"
wait "$(cat .labex/dev.pid)" 2>/dev/null || true
部署相同的 Worker 代码:
npx wrangler deploy
保存 Wrangler 输出的完整 workers.dev URL:
WORKER_URL="https://YOUR_WORKER_URL"
首先观察正常完成:
node client.mjs "$WORKER_URL" \
  "How can I safely retry an invoice upload without creating a duplicate ticket?"
最后的 complete 行表示模型发送了 [DONE];仅仅收到第一段内容,不能证明响应已经完整结束。
现在启动第二次流式请求,并在收到第一段非空内容后主动停止:
node client.mjs "$WORKER_URL" \
  "Explain four checks to make before retrying a failed file upload." \
  --cancel-after-first
应看到一行 chunk:,随后看到 cancelled after 1 chunk。取消不是模型错误:客户端主动决定不再需要剩余内容。关闭读取器会将取消操作传递给上游流,而传入请求的信号会让 Worker 记录客户端断开连接。
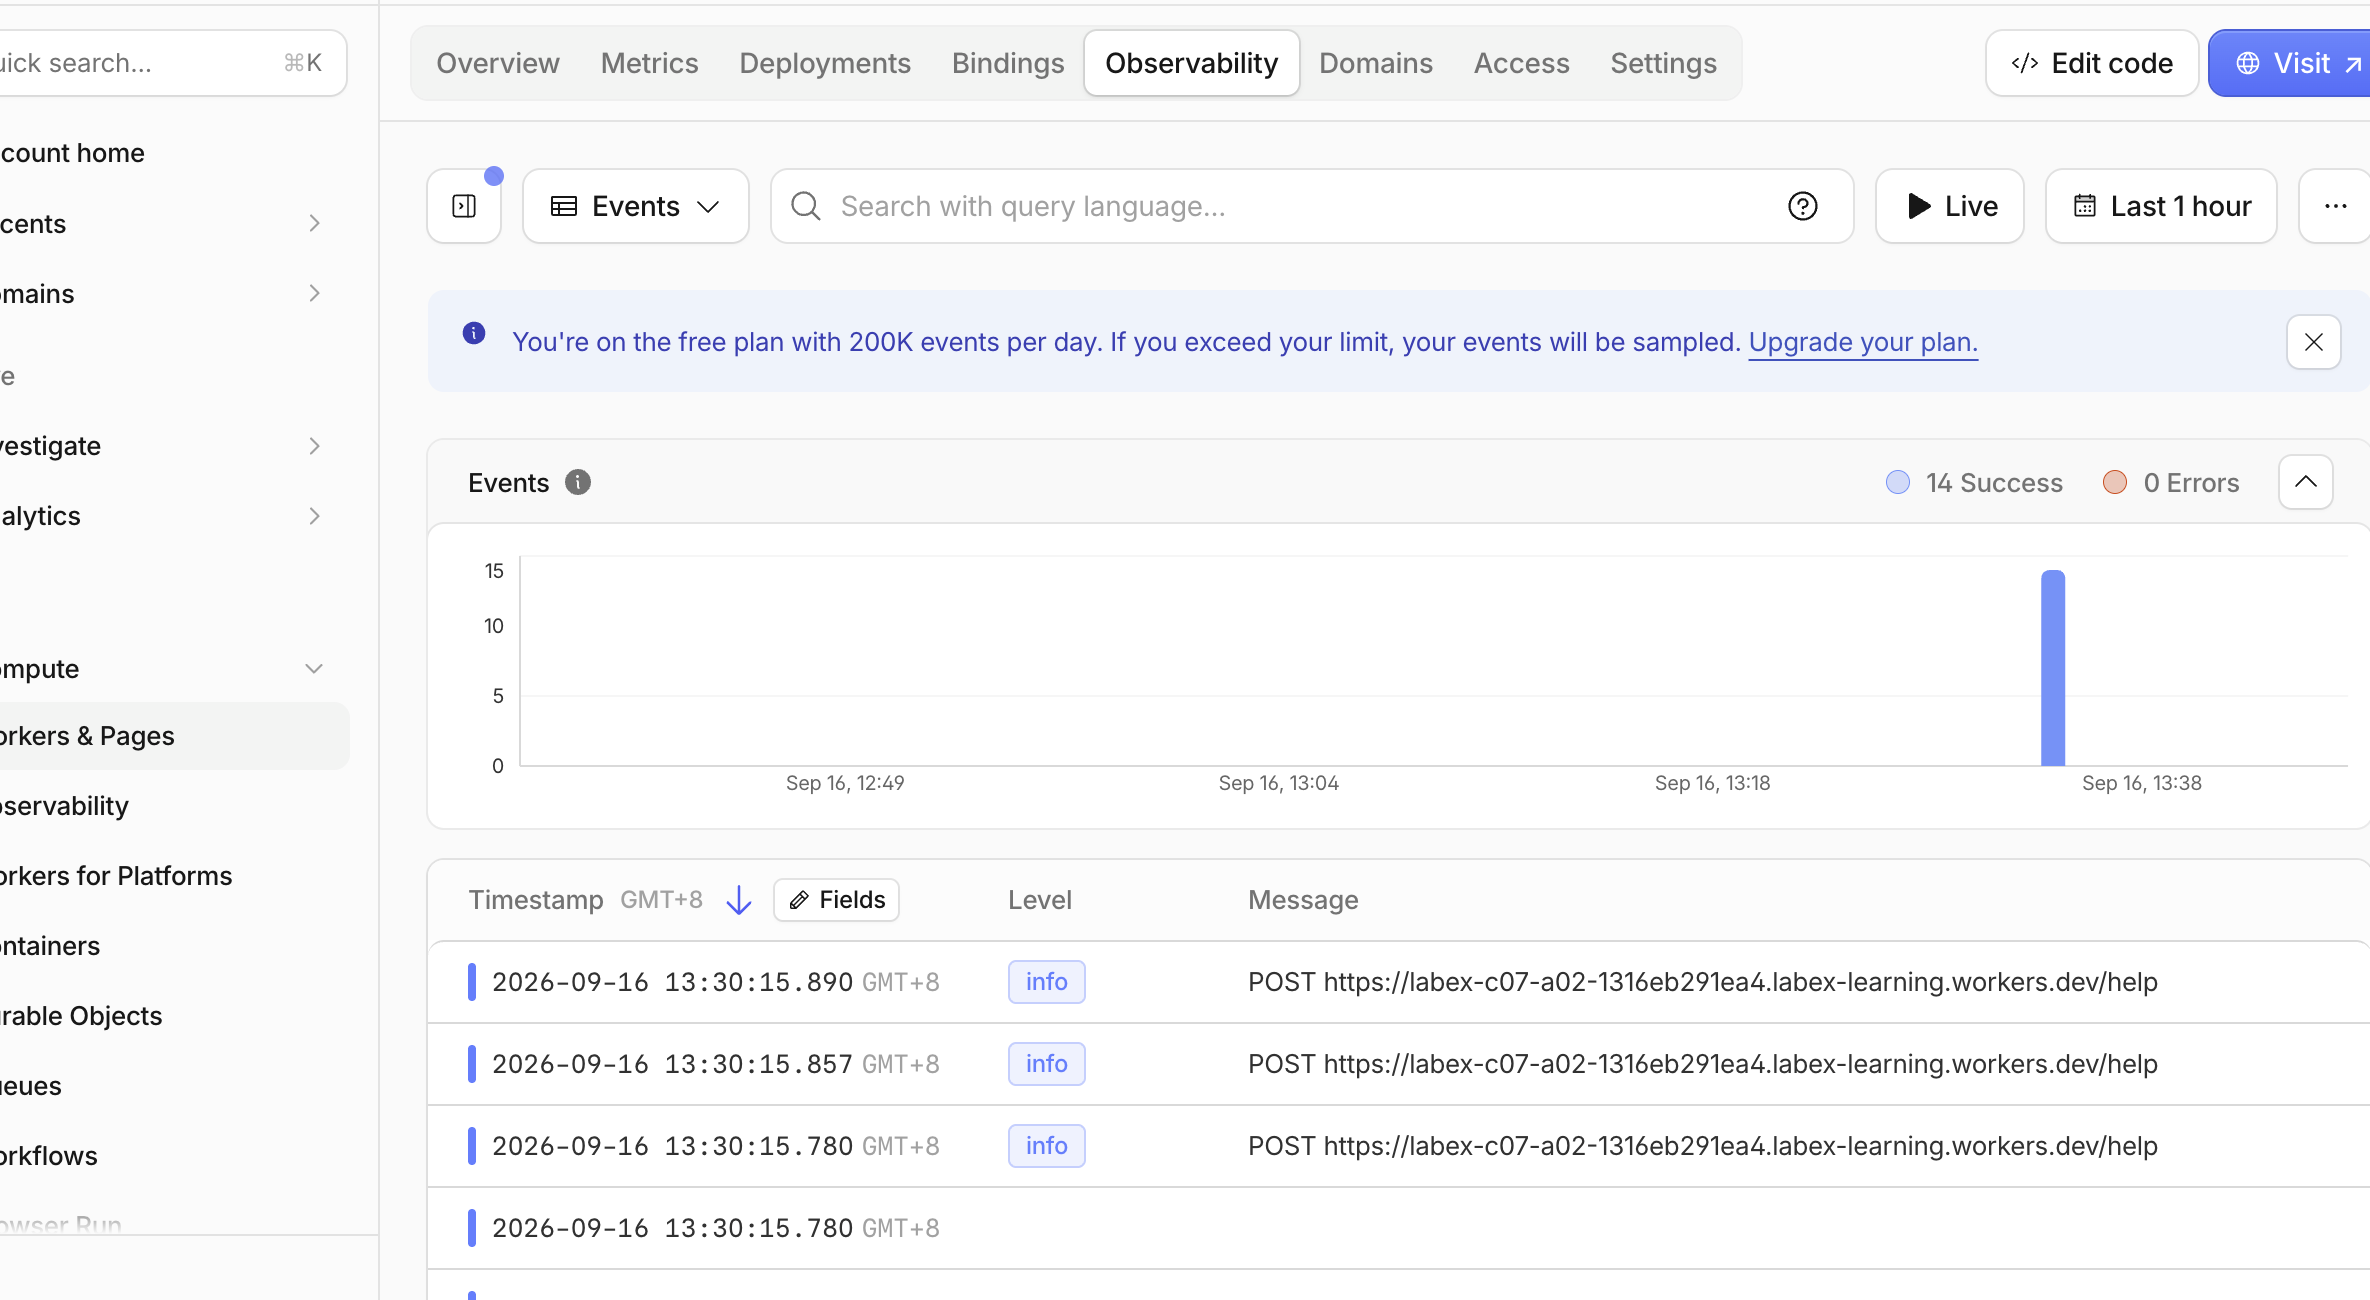
打开 Cloudflare Dashboard,进入 Workers & Pages → Overview → 你的 labex-c07-a02-... Worker → Observability → Logs。查找最近的请求。下面的概览来自一次临时验收运行:14 Success 和 0 Errors 表明 Worker 成功处理了健康检查、完整流和主动断开,没有失败的调用。你的总数和时间戳会有所不同。
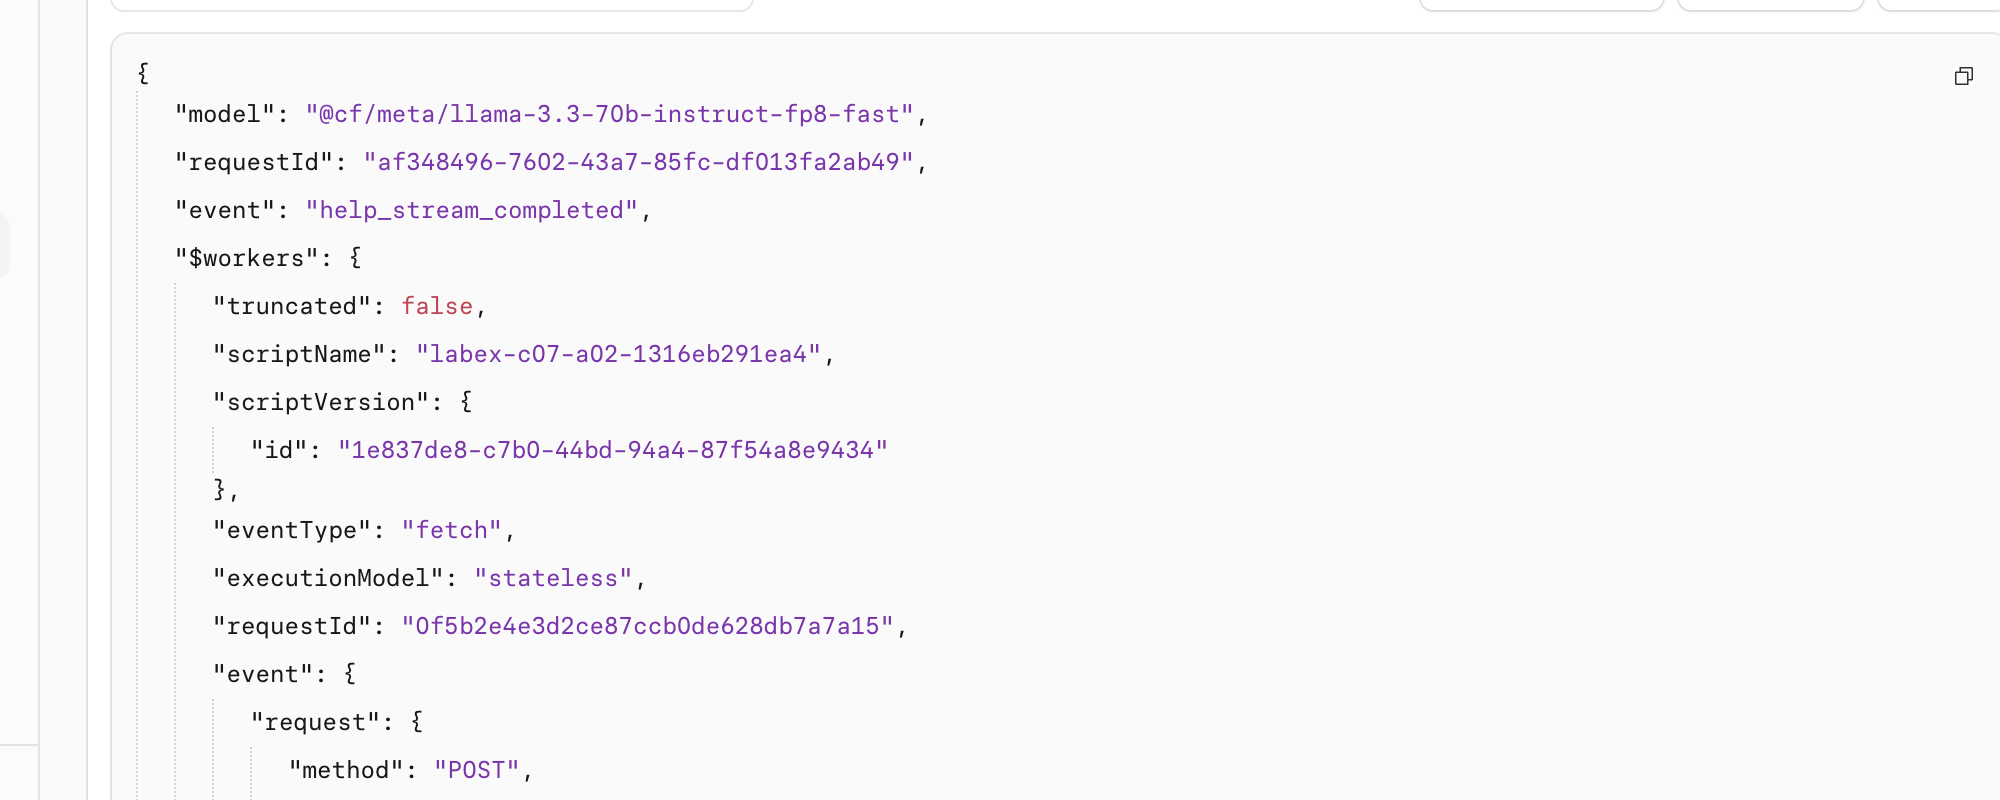
搜索 help_stream_completed,展开一条结果,并确认其中的 model、requestId 和 event。请求 ID 是一种安全的关联值:它可以帮助运维人员关联生命周期记录,而不存储学习者的问题或生成的回答。
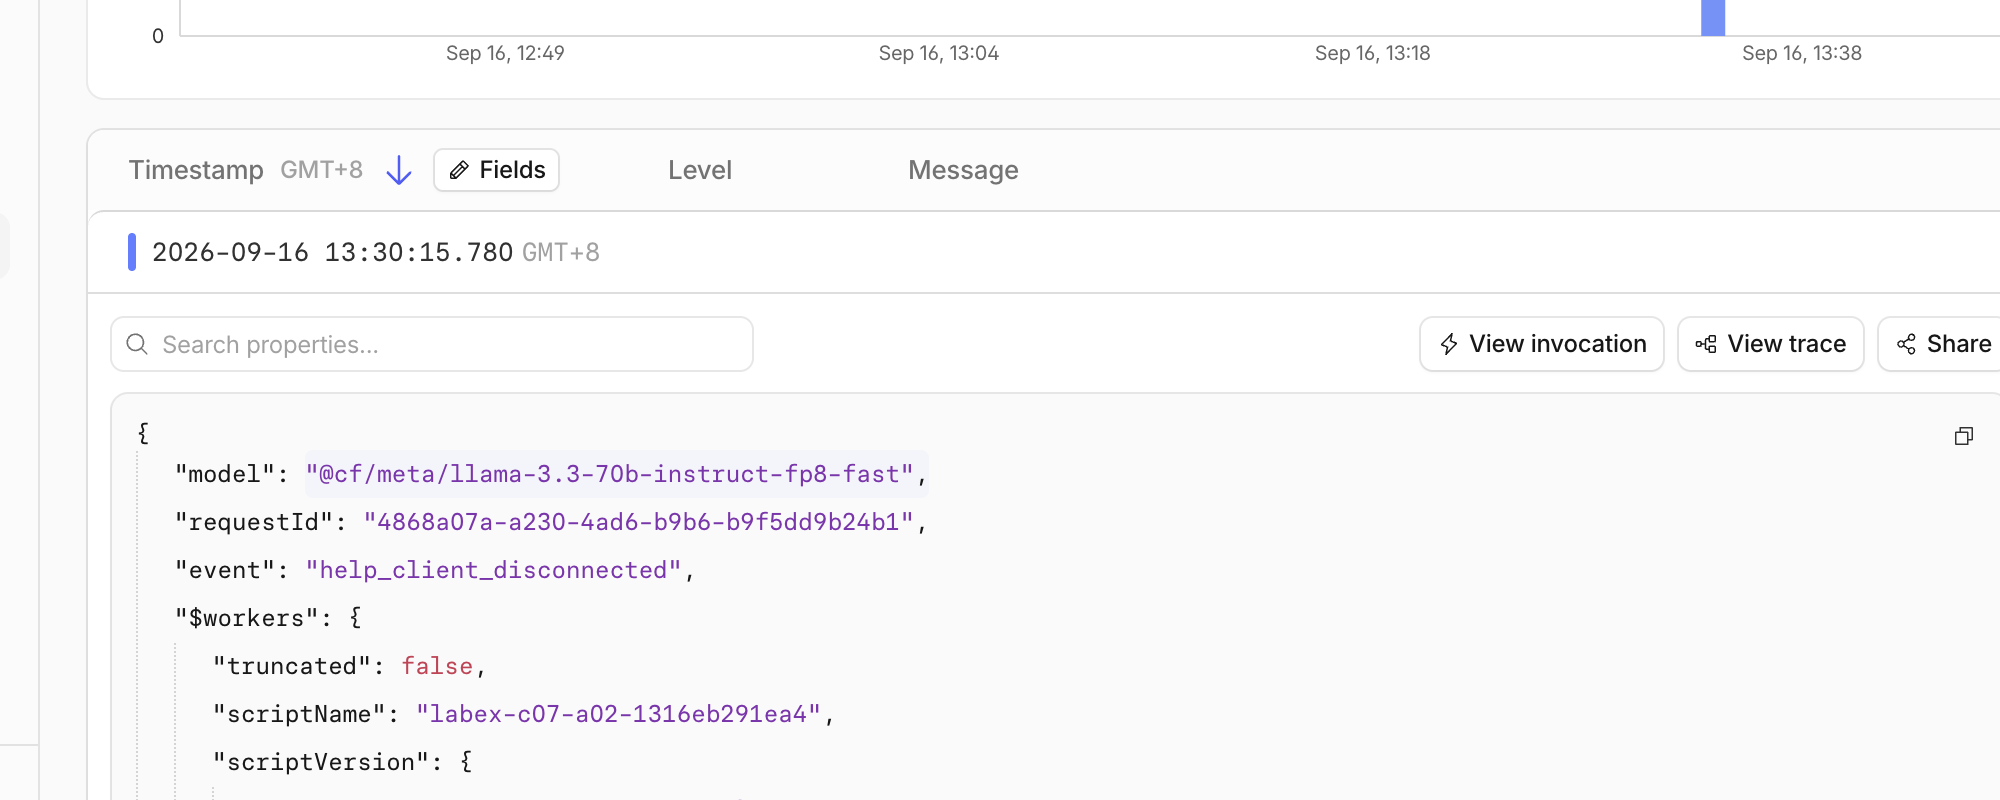
对于主动取消的公开请求,搜索 help_client_disconnected。启用 enable_request_signal 后,该事件可以直接证明传入客户端已经断开。步骤 4 中的确定性测试则单独证明,下游的 cancel() 会到达模型测试固件,并记录 help_stream_cancelled;真实网络时序可能使请求信号事件成为云端可见的记录。保存的日志可能晚于响应到达,因此请短暂等待;如果确有必要,最多再发送一次有界的取消请求。
然后打开 Workers AI,检查今天的模型用量。找到 Llama 3.3 模型,并确认这些小练习仍在 10,000-Neuron Free 配额内。下面的示例中,学习账户的全部工作使用了 158.03/10k Neurons;其中还包括该账户上的其他练习,因此你的数值会有所不同。当账户仍在 Free 配额范围内时,本实验不要求使用 Workers Paid 计划。用量可能会延迟显示,因此不要为了强制图表更新而重复执行推理。
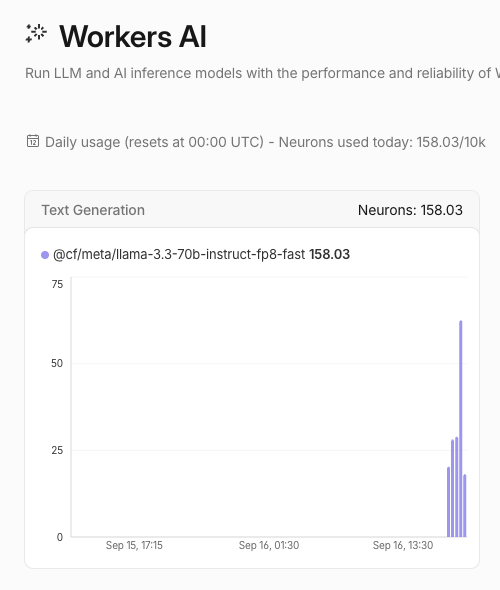
这些截图中的 Worker 名称、请求 ID、时间戳和用量都来自一次临时运行,仅作为示例。学习重点是事件名称及其生命周期关系,而不是具体数值。
删除 Worker 并退出登录
在本步骤中,你将删除临时 Worker,然后让这台 VM 退出登录。Workers AI 用量记录属于账户级历史记录,因此删除 Worker 只会移除其公开端点,不会删除历史记录,也不会更改账户套餐。
删除 wrangler.jsonc 中指定的 Worker:
npx wrangler delete
只有当 Wrangler 显示本实验唯一的 labex-c07-a02-... 名称时,才确认删除。命令最后应显示 Successfully deleted。在 Dashboard 中刷新 Workers & Pages → Overview,确认该名称已经不存在。
在 VM 仍处于授权状态时,运行独立的管理检查:
python3 .labex/verify.py deleted
只有在它报告 PASS: deleted 后,才删除这台 VM 中保存的授权信息:
npx wrangler logout
npx wrangler whoami --json
确认显示 loggedIn: false。本地文件缺失、浏览器标签页关闭或网络错误,都不能证明云端删除或退出登录已经完成。
总结
你构建了一个 Workers AI 端点,它会转发增量 SSE 输出,而不是先缓存完整回答。你了解了客户端为什么需要明确的 [DONE] 信号、超时如何防止无限等待、主动取消与失败的区别,以及流错误如何干净地终止。你验证了真实的本地推理和已部署推理,将生命周期事件与 Dashboard 可观测性关联起来,删除了临时 Worker,并让这台全新的 VM 退出登录。