介绍
Riverside 集合需要为六份 HTML 口述历史文档建立可搜索索引。提供的容器工具会真实解析 HTML 并统计 Unicode 单词,但四 worker 批次超出 160 MiB 内存预算。你将使用与确切容器关联的证据诊断失败,然后在不提高限额、不删除文档的情况下生成完整索引。
你应了解基本 Docker run、终端路径及绑定挂载的用途。本实验会在使用前解释内存选项、实际用户 ID、带引号的路径、命令替换和简短的证据读取管道。无需 Python 编程、HTML 编写或搜索算法实现。Docker、索引镜像及只读 Search Desk 已准备好。
语料明确为合成数据:每份文档包含 10,000 段扩展教学摘录,以便观察真实解析器的内存压力。成果是基于这些字节的真实索引,不是模拟内存分配,也不保证生产容量。包含阅读和普通错误在内,预计约 60 分钟;这是作者估计。
在预算内构建完整索引
本步骤先确认正常搜索结果,再复现内存受限失败、关联原生证据,并使用受控批次完成整个集合。
先使用小型正常索引
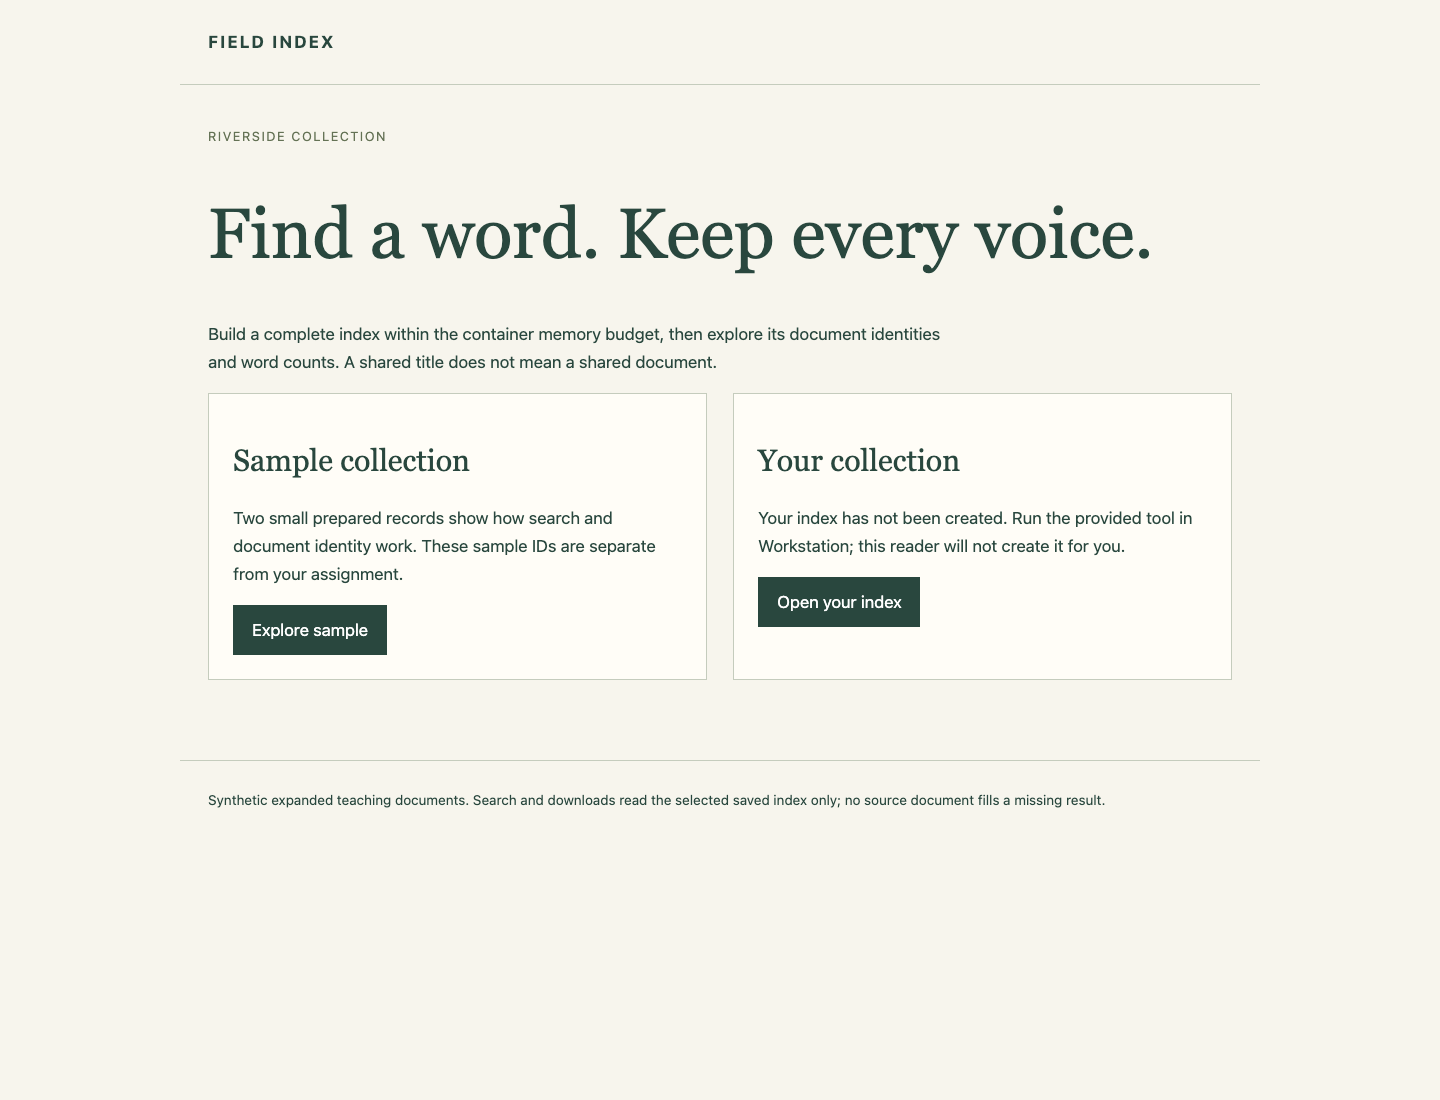
从 Search Desk 开始,选择 Explore sample。这个独立的预制样例包含两份小文档。在 Search one word 中输入 café 并点击 Search。两条记录的标题都是 Riverside memories,但具有以 sample-oral- 开头的不同 ID。分别打开,查看源哈希与所选单词计数,再使用 Back to collection。通过 Download index 检查实际样例 JSON 文件,然后选择 Back to Search Desk。
两个面板将预制样例与你要处理的集合分开。你的索引初始不可用:
倒排索引将单词与文档 ID 和出现次数关联。其 documents 元数据记录每个 ID、标题及源 SHA-256,也就是原始字节的指纹。同名记录不得合并成一个身份。读取界面仅使用所选的已保存索引,绝不会从源 HTML 补齐缺失工作。
选择 Open your index。当前显示 Collection not indexed,HTTP 状态为 503。小样例不是你的六文档成果。
理解路径与内存边界
切换到 Workstation,从 /home/labex/project/collection-index 开始。cd 返回该目录,ls 列出文件:
cd /home/labex/project/collection-index
ls source output
source/ 包含六份原始 HTML 文件。output/ 是可写交付目录。保持原文件、已准备镜像 dk06-indexer:1 及独立样例读取界面完好。你只创建课程容器和索引输出。
镜像 entrypoint 已运行索引程序。镜像名称后的 --source /input、--output /output/attempt.json 和 --workers 4 是程序参数,而不是 Docker 标志。worker 将真实 HTML 解析为文档树。一个批次在提取单词时保留所选文档树,然后释放它们。更多 worker 可能需要更多内存,并不保证更快。
镜像名称前的 Docker 选项设置运行边界:
| 选项 | 此处含义 |
|---|---|
--name |
保留名称明确的容器以供原生检查 |
--memory 160m |
强制执行 160 MiB RAM 预算 |
--memory-swap 160m |
将 RAM 加交换空间总量设为相同数值,不留额外交换空间额度 |
--network none |
文件处理任务不需要网络 |
--user |
以实际普通账号写出输出 |
两个 --mount 选项 |
仅读取原始输入;写入独立输出文件夹 |
id -u 和 id -g 显示实际数字用户 ID 和组 ID;不要假定为 1000。$(...) 将命令输出替换到当前命令中。双引号使组合后的用户/组及每个完整挂载值各自保持为一个参数,同时允许表示当前目录的 $PWD 展开。行末反斜杠将下一物理行连接到同一命令。
宿主输入 source/ 在容器内呈现为 /input;宿主 output/ 呈现为 /output。readonly 通过该挂载保护输入。不要再添加源目录的可写别名。保持两个内存选项不变,不要禁用 OOM killer 或更改平台设置。
复现并归因失败
运行提供的四 worker 尝试。这次刻意预期在索引完成前以原生状态 137 退出:
docker run --name index-attempt \
  --memory 160m --memory-swap 160m --network none \
  --user "$(id -u):$(id -g)" \
  --mount "type=bind,src=$PWD/source,dst=/input,readonly" \
  --mount "type=bind,src=$PWD/output,dst=/output" \
  dk06-indexer:1 --source /input --output /output/attempt.json --workers 4
停止前你可能只看到较早的 Parsing batch 一行。保留已停止容器:这里没有 --rm,因为其身份和生效设置很重要。
docker inspect 读取原生容器字段。单引号保持各个简短格式模板的字面值。先读取退出代码和 Docker 的 OOM 标志,再读取以字节计的两个限额:
docker inspect index-attempt --format '{{.State.ExitCode}} {{.State.OOMKilled}}'
docker inspect index-attempt --format '{{.HostConfig.Memory}} {{.HostConfig.MemorySwap}}'
docker logs index-attempt
配置的限额值均为 167772160,即 160 × 1024 × 1024 字节。仅有退出 137,无法区分此内存故障与强制终止。应记录 Docker 的 OOMKilled 标志,但本实验测试的 Engine 有时即使内核报告真实内存 cgroup 终止,该标志也仍为 false。应交叉检查实际内核证据,而不是只用某一个字段解释原因。
将完整容器 ID 读入 shell 变量。赋值时 = 两侧没有空格;命令替换捕获 inspect 的结果:
container_id=$(docker inspect --format '{{.Id}}' index-attempt)
变量属于此 Workstation shell。切换浏览器标签页不会改变它;打开新 shell 时需要重新赋值。sudo dmesg 读取受保护的内核日志,不会清空它。管道 | 将输出传给 grep;-F 选择包含完整 ID 普通文本的行,引号使其值保持为一个参数:
sudo dmesg | grep -F "$container_id"
找到包含 CONSTRAINT_MEMCG,且 oom_memcg 路径标明此完整 Docker 容器 ID 的行。它标识发生在本容器内存控制组中的内存不足行为,而不是无关进程或全平台内存短缺。将它与已停止尝试及其实际限额对照。不要创建假日志或用手动终止的进程替换此尝试。
减少批次,保留完整工作
预算固定。将批次降为一个 worker,可一次只保留一棵真实解析的文档树,同时保留全部六份文档及相同单词计数算法。这是对此语料可行的选择,不表示一个 worker 总是最优。只要完整任务确实在相同限额下完成,也接受其他可行 worker 数。
创建独立且保留的交付容器。保持两个挂载、已准备的 entrypoint 和内存选项;更改输出文件名和 worker 数:
docker run --name index-delivery \
  --memory 160m --memory-swap 160m --network none \
  --user "$(id -u):$(id -g)" \
  --mount "type=bind,src=$PWD/source,dst=/input,readonly" \
  --mount "type=bind,src=$PWD/output,dst=/output" \
  dk06-indexer:1 --source /input --output /output/index.json --workers 1
预期显示全部批次,随后是 Indexed 6 documents and ... terms,并以正常状态 0 退出。词项总数是一项观察,本身并不能证明成功:
docker inspect index-delivery --format '{{.State.ExitCode}}'
ls -l output/index.json
输出归普通用户/组所有,容器退出后仍可编辑。保留两个已停止容器。如果输入路径拼错,Docker 会在处理前报告绑定源缺失:返回指定工作目录,检查 ls source output,修正带引号的路径后重试。不要创建替代输入来掩盖错误。
使用真实交付索引
切换到 Search Desk,必要时选择 Back to Search Desk,再选 Open your index。它必须显示六份已索引文档,而非两个样例 ID。搜索 café:应显示全部六份文档,每份出现 10,000 次。通过不同的 oral-0 和 oral-1 ID 打开两条 Riverside memories 记录。源哈希和单词关系必须各自保持独立。
交付集合包含全部六个原始 ID,包括两条标题相同的记录:
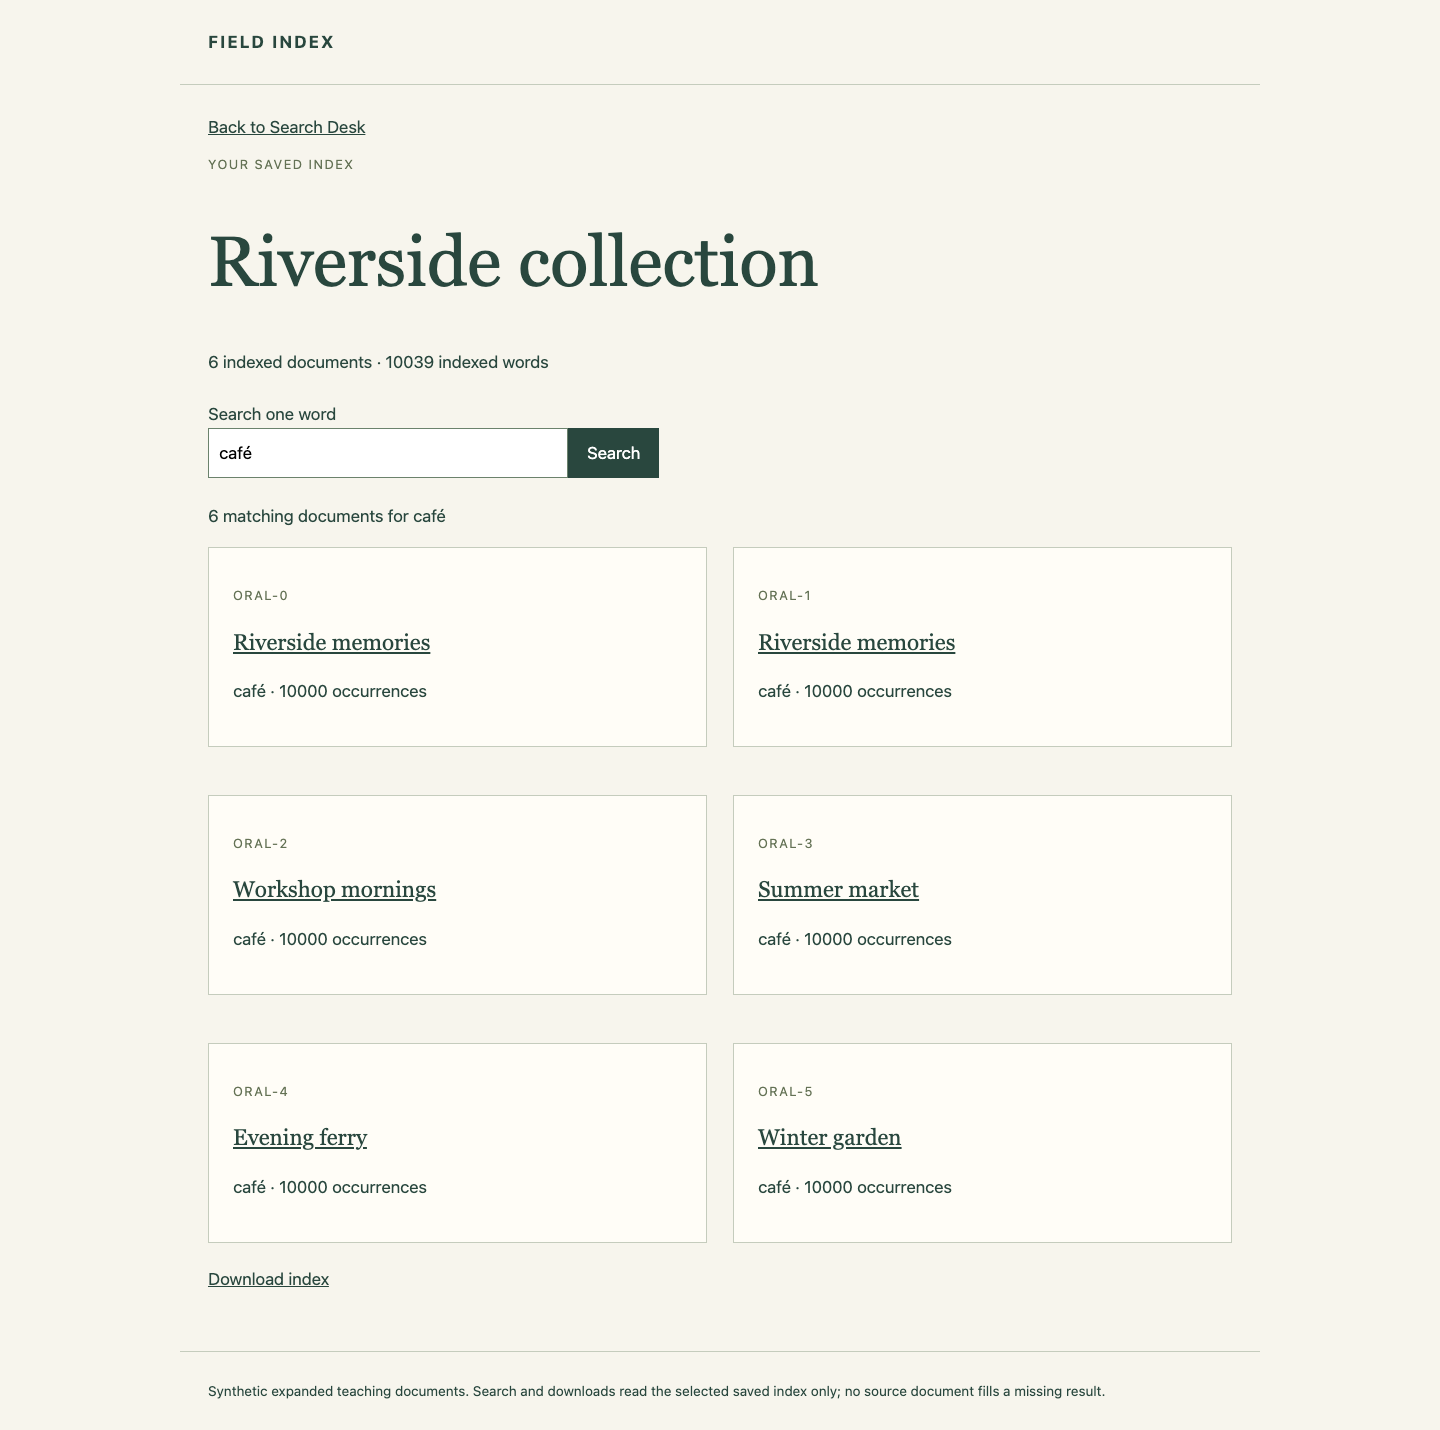
通过 Back to collection 返回,先搜索 résumé,再搜索 naïve,确认全部六条记录仍可按真实计数检索。搜索 notawordinthiscollection:不应匹配任何文档。使用 Download index 检查真实交付 JSON;其中的文档、源哈希和倒排记录应属于全部原始输入。读取界面不会重新生成缺失结果。
检查将本次运行的确切内存 cgroup 事件与容器关联,检查成功交付的生效预算和挂载,并独立流式读取每一个原始 HTML 字节,验证全部 Unicode 单词/文档计数。它们不会重新运行实时任务,也不会替你写索引。
仅恢复失败交付
如果交付尝试也内存不足,检查其停止状态和日志,选择可行批次,并用 docker rm index-delivery 仅删除这次失败的 index-delivery 容器,再重试所示交付命令。保留 index-attempt 和全部原始 HTML 文件作为证据。成功重跑会用完整索引覆盖自己的输出;不要手改计数或将小样例复制成正式交付。
总结
你将真实内存 cgroup OOM 行为与其确切容器及生效限额关联,再减少实际 HTML 批次并发,在相同 160 MiB 预算下完成整个索引。保存的索引保留全部六个身份、重复标题、原始源哈希和 Unicode 单词计数,容器退出后仍可使用。