介绍
你的工单服务需要增加紧急程度,同时不能丢失现有请求。如果旧行无法满足新规则,架构发布可能会失败。你将创建一个有序迁移,在本地测试它,然后在远程数据库中应用同一个迁移文件,同时保留工单的标识和主题。
本实验使用提供的初始迁移独立开始。它基于 D01 中的数据库创建和基础 SQL 知识,但不会使用之前的 VM 或数据库。
使用你自己的学习账号和一个全新的 VM。安装阶段会先准备 Node.js 22.22.0,然后在 /home/labex/project/ticket-database 下运行 npm install,安装项目本地的 Wrangler 4.131.1 以及评测所需的依赖。直接依赖的版本已经固定;安装过程会创建自己的 lockfile。安装阶段不会登录云端,也不会执行评测数据库操作。在个人计算机上,请在项目中使用 npm install --save-dev wrangler@4.131.1 安装相同版本的 Wrangler。
本实验使用 D1 免费额度内的小型合成记录。现有账号的用量也会计入这些额度。不需要购买域名。在确认资源已删除并完成退出登录之前,请保留此 VM。
授权此 VM 并选择账号
在此步骤中,你会将这个全新的终端连接到自己的学习账号。仅登录 Dashboard 不会授权此 VM。D1 权限允许你创建数据库、修改 SQL 和删除数据库。在授权前,请查看实际的授权页面,包括 Background Access。
打开准备好的项目并检查已固定版本的 CLI:
cd /home/labex/project/ticket-database
npx wrangler --version
预期输出为 4.131.1。启动设备授权;--device 会显示浏览器验证码,--browser=false 会让你自行选择是否打开浏览器:
npx wrangler login --device --browser=false --scopes account:read user:read d1:write
在浏览器中打开显示的 URL,输入当前验证码,确认使用你的学习账号和显示的权限,然后完成授权。等待终端确认成功。不要将密码或令牌粘贴到项目文件中。
npx wrangler whoami --json
检查 loggedIn: true,然后读取账号的 name 和 id,即使列表中只有一个账号也要读取。将目标账号的 ID 复制到下面的配置中。下面的 Shell 变量使用 6 个随机字节(12 个十六进制字符),以避免与其他学习者发生冲突。here-document 会将 JSON 标记之间的内容写入文件;其中的 $RUN 会展开。
$schema 前的反斜杠会保留这个 JSON 键的原样;$RUN 仍会展开为本次运行的唯一名称。
RUN=labex-c04-d03-$(openssl rand -hex 6)
cat > wrangler.jsonc <<JSON
{
  "\$schema": "./node_modules/wrangler/config-schema.json",
  "name": "$RUN",
  "account_id": "YOUR_ACCOUNT_ID",
  "main": "src/index.js",
  "compatibility_date": "2026-09-15",
  "workers_dev": true,
  "preview_urls": false
}
JSON
运行这段命令前,将 YOUR_ACCOUNT_ID 替换为实际账号 ID。保持此终端打开,以便 RUN 变量继续可用。name 用于标识本次运行;account_id 用于选择执行云端操作的账号。该文件是普通 JSON,同时也是有效的 JSONC。写入此文件不会部署 Worker。
建立现有工单数据库
在此步骤中,你会准备应用数据库的现有版本。迁移是描述架构变更的编号 SQL 文件。Wrangler 会在 d1_migrations 中记录已应用的文件名,因此后续运行可以区分已完成和待处理的变更。安装阶段提供了旧版应用的 0001_initial.sql;你将自行创建升级迁移。
创建一个临时云端数据库。--binding DB 为应用代码提供简短名称,--update-config 会将数据库的实际名称和 UUID 写入 wrangler.jsonc,--use-remote=false 则保持开发环境使用本地数据库:
npx wrangler d1 create "$RUN-db" --binding DB --update-config --use-remote=false
读取创建结果中的名称和 ID,然后检查已保存的绑定配置:
cat wrangler.jsonc
DB 条目必须指向本次运行的数据库。绑定是代码与资源之间配置好的连接。它的 UUID 用于标识云端数据库,而 --local 使用此 VM 中独立的 SQLite 数据库。执行 SQL 命令时,必须始终明确指定 --local 或 --remote。
应用旧架构前,先读取它:
cat migrations/0001_initial.sql
其中包含两个现有工单,但没有 priority 列。分别将它应用到本地和远程目标;出现提示时,确认使用本实验的数据库:
npx wrangler d1 migrations apply DB --local
npx wrangler d1 migrations apply DB --remote
检查数据行和已应用的迁移状态:
npx wrangler d1 execute DB --remote --command "SELECT id, subject, status, source FROM tickets ORDER BY id; SELECT name FROM d1_migrations ORDER BY id;"
两个原有工单都必须存在;已应用的迁移应为 0001_initial.sql。已应用的迁移属于历史记录:后续变更应创建新文件,不要修改这段历史。
在本地添加受约束的优先级
在此步骤中,为现有工单设置默认优先级,同时不删除表。ALTER TABLE ... ADD COLUMN 会直接修改现有表。新增的非空列必须为旧行提供有用的默认值。CHECK 将优先级限制为 normal 或 urgent。
创建下一个编号的迁移:
npx wrangler d1 migrations create DB add_priority
在这个全新的项目中,它会创建 migrations/0002_add_priority.sql。检查输出中的文件名是否正确。将变更写入这个新文件:
cat > migrations/0002_add_priority.sql <<'SQL'
ALTER TABLE tickets ADD COLUMN priority TEXT NOT NULL DEFAULT 'normal' CHECK(priority IN ('normal','urgent'));
SQL
列出待处理迁移,然后只在本地应用:
npx wrangler d1 migrations list DB --local
npx wrangler d1 migrations apply DB --local
两个现有工单都应获得 normal 优先级。添加一个紧急工单并查询它:
npx wrangler d1 execute DB --local --command "INSERT INTO tickets (id, subject, source, priority) VALUES (3, 'Service unavailable', 'local', 'urgent'); SELECT id, subject, priority FROM tickets ORDER BY id;"
超出允许范围的优先级必须失败,不能静默写入表中:
npx wrangler d1 execute DB --local --command "UPDATE tickets SET priority = 'critical' WHERE id = 3;"
预期出现 CHECK constraint failed;这个有意触发的错误不会改变工单 3 的 urgent 优先级。读取远程数据库中的 PRAGMA table_info(tickets),查看云端架构仍然是旧版本:
npx wrangler d1 execute DB --remote --command "PRAGMA table_info(tickets);"
远程数据库中还没有 priority 列。本地迁移成功不会更新云端数据库。
将经过测试的迁移应用到远程数据库
在此步骤中,将同一个经过检查的文件发布到远程数据库。确认之前先检查待处理的变更:
npx wrangler d1 migrations list DB --remote
npx wrangler d1 migrations apply DB --remote
预期只有 0002_add_priority.sql 处于待处理状态。现有数据行会保留。添加一个远程紧急工单,然后同时检查数据和迁移历史:
npx wrangler d1 execute DB --remote --command "INSERT INTO tickets (id, subject, source, priority) VALUES (3, 'Service unavailable', 'remote', 'urgent'); SELECT id, subject, priority FROM tickets ORDER BY id; SELECT name FROM d1_migrations ORDER BY id;"
工单 1 和 2 应保留原主题,且优先级为 normal;工单 3 的优先级为 urgent。两个编号迁移文件都应已记录。再次运行应用命令:
npx wrangler d1 migrations apply DB --remote
命令应报告没有待处理的迁移,并保持数据行不变。这正是历史记录表的作用:重新发布时不会再次执行已完成的文件。在 Dashboard 中打开本次运行的 D1 数据库,查看其架构或表视图,将新增列与 CLI 的结果对应起来。不要在那里编辑架构。
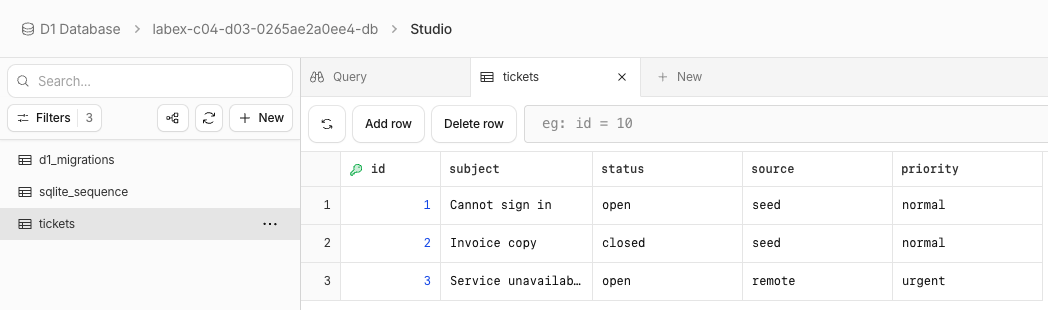
此示例显示原有两张工单的默认优先级为 normal,新增远程工单的优先级为 urgent。生成的数据库名称标识本次示例运行,你的名称会不同。上面的 SQL 查询、迁移历史和约束检查用于确认结果;截图仅供直观参考。
删除临时资源
在此步骤中,在 VM 仍处于授权状态时,只删除本实验创建的资源。先完成所有功能检查。在确认删除完成前,保留配置文件。
npx wrangler d1 delete DB
查看提示内容,确认其中只有本次运行的数据库。然后列出数据库:
npx wrangler d1 list --json
在成功响应中,之前记录的数据库名称和 UUID 都必须不存在。其他资源可以保留。身份验证或网络错误无法证明删除成功:解决访问问题后,先重新读取并确认,再继续。执行本步骤的验证时,必须保持登录状态。
结束此 VM 的授权
在独立的删除检查通过后,才执行此步骤结束授权。退出登录会删除此 VM 中保存的 Wrangler 授权信息;仅关闭 VM 并不能完成云端清理。
npx wrangler logout
npx wrangler whoami --json
预期输出为 loggedIn: false。未认证的查询可能以非零状态码退出;只有当结构化响应明确表示你已退出登录时,这种结果才符合预期。完成验证后,关闭实验环境。
总结
你练习了迁移工单架构。你检查了可观察的数据库结果,明确保留了所选账号和本地状态,并在退出登录前删除了临时资源。