简介
文档网站迁移页面后,旧链接仍应将访问者带到正确位置。重定向是一种 HTTP 响应,它会告知浏览器请求另一个 URL。在本实验中,KV 将保存一个小型目录,用于将旧路径映射到新的文档路径。
你将先检查并验证提供的 JSON 数据集,然后导入它,再分多个页面读取目录。分页是指请求数量受限的一批结果,并使用连续标记获取下一批结果。最后,你将修改一个目标并停用两个条目,同时保留同一命名空间中的一条无关记录。当你需要维护一组设置,而不是逐个编辑键时,这种方法很有用。
请先完成之前的 KV 引导实验。本实验使用的新 VM 已安装 Node.js 22.22.0,并在 /home/labex/project/redirect-catalog 中提供项目本地的 Wrangler 4.131.1。初始化过程会提供五条模拟重定向,但不会导入它们,也不会创建云资源。请使用具有相同账户读取、Worker 写入和 KV 写入权限的学习账户。一个临时 Worker 和一个命名空间就足够了;这个小型数据集不需要付费升级或购买域名。公开目录中只有示例路径。
连接重定向命名空间
在本步骤中,你将连接一个独立的命名空间,用于保存小型重定向目录。ROUTES 绑定会在命令行操作和 Worker 中标识此命名空间。每个实验都会使用自己的资源,因此该目录不会影响之前的任何命名空间。
进入准备好的项目目录:
cd /home/labex/project/redirect-catalog
生成一次唯一名称。openssl rand -hex 6 会输出随机后缀;$(...) 会将该后缀插入名称中。Shell 变量会在当前终端中保存这个名称,供后续命令使用。
WORKER_NAME="labex-routes-$(openssl rand -hex 6)"
printf '%s\n' "$WORKER_NAME"
为此 VM 授权。除了读取账户身份之外,Workers Scripts Write 权限允许部署和删除 Worker,Workers KV Write 权限允许管理本实验的命名空间和键。
npx wrangler login --device --browser=false --scopes account:read user:read workers_scripts:write workers_kv:write
在浏览器中打开显示的设备链接,输入当前代码,检查请求的权限和学习账户,然后授权 Wrangler。许可页面中也可能显示后台访问权限。返回终端,等待登录完成。
查看 Create a Feature Flag Store 中介绍的相同 Worker 和 KV 写入权限。确认学习账户后再授权。
npx wrangler whoami --json
确认输出中的 loggedIn: true 和学习账户的 name,即使列表中只有一个账户也要确认。复制该账户的 id。将它保存到下面的配置中,并在运行命令前替换 YOUR_ACCOUNT_ID。这里的 cat heredoc 会将两个 JSON 行之间的所有内容写入文件;> 会替换文件。未加引号的分隔符允许 Shell 插入 $WORKER_NAME。
cat > wrangler.jsonc <<JSON
{
  "name": "$WORKER_NAME",
  "main": "src/index.js",
  "compatibility_date": "2026-07-30",
  "account_id": "YOUR_ACCOUNT_ID",
  "workers_dev": true
}
JSON
在该账户中创建命名空间。命名空间标题会使用 Worker 的唯一名称,方便你之后识别这两个资源。--update-config=false 会让绑定编辑内容显示给你,而不会自动修改文件。
npx wrangler kv namespace create "$WORKER_NAME-routes" --update-config=false
输出中会包含新命名空间的 ID。复制该 ID,然后在下面这份完整配置中替换 YOUR_ACCOUNT_ID 和 YOUR_NAMESPACE_ID。ROUTES 绑定名称由你的代码使用;ID 则用于标识真实的 Cloudflare 资源。
cat > wrangler.jsonc <<JSON
{
  "name": "$WORKER_NAME",
  "main": "src/index.js",
  "compatibility_date": "2026-07-30",
  "account_id": "YOUR_ACCOUNT_ID",
  "workers_dev": true,
  "kv_namespaces": [
    { "binding": "ROUTES", "id": "YOUR_NAMESPACE_ID" }
  ]
}
JSON
npx wrangler kv namespace list
找到本实验的命名空间标题,并将其 ID 与文件中的 ID 进行比较。其他命名空间可能也会列出;不要修改它们。此配置记录后续命令应使用的账户和资源。绑定是对命名空间的引用,不是命名空间数据的副本。
验证并导入小型目录
在本步骤中,你将先检查数据集,再使用一条命令写入所有条目。批量操作可以减少重复工作,但也会将同一个错误重复应用到提供的数据中。先读取准备好的文件:
cat redirects.json
每个对象都有一个类似 route:/old-start 的 key,以及一个类似 /docs/start 的 value。route: 前缀用于对目录记录分组;它是键的一部分,不是目录。目标地址是同一网站上的路径,而不是任意外部 URL。
编写一个普通的 Node.js 验证脚本。该脚本读取文件名,检查数组和字段,拒绝重复键,并且只有在所有条目都通过验证后才输出计数。Set 用于记录已经出现过的键。正则表达式将这个教学数据集限制为简单的旧路径和文档目标;这些是本应用的规则,不是 KV 强制要求的限制。
cat > validate-redirects.mjs <<'JS'
import { readFile } from "node:fs/promises";

const filename = process.argv[2] ?? "redirects.json";
const entries = JSON.parse(await readFile(filename, "utf8"));
if (!Array.isArray(entries) || entries.length === 0 || entries.length > 20) {
  throw new Error("Use a non-empty teaching dataset of at most 20 entries.");
}
const seen = new Set();
for (const entry of entries) {
  if (!entry || typeof entry.key !== "string" || !/^route:\/old-[a-z-]+$/.test(entry.key)) {
    throw new Error("Every key must name an old route, such as route:/old-start.");
  }
  if (typeof entry.value !== "string" || !/^\/docs\/[a-z-]+$/.test(entry.value)) {
    throw new Error("Every destination must be a /docs/ path on this site.");
  }
  if (Object.keys(entry).some(key => !["key", "value"].includes(key))) {
    throw new Error("This dataset accepts only key and value fields.");
  }
  if (seen.has(entry.key)) throw new Error(`Duplicate key: ${entry.key}`);
  seen.add(entry.key);
}
console.log(`Validated ${entries.length} unique redirect entries.`);
JS
node validate-redirects.mjs redirects.json
预期输出为 Validated 5 unique redirect entries.。如果验证失败,请先修正文件,再执行导入。拒绝重复键很重要,因为再次写入同一个键会替换它的值。
先在本地创建一条非路由测试记录,然后导入目录。这个测试记录可以帮助你检查后续目录维护是否保留了其他数据。
npx wrangler kv key put system:owner labex-redirect-demo --binding ROUTES --local
npx wrangler kv bulk put redirects.json --binding ROUTES --local
npx wrangler kv key list --binding ROUTES --local
预期会看到五条 route: 记录和 system:owner。批量写入会写入文件中的条目;它不会替换整个命名空间,也不会删除文件中没有出现的键。它也不保证所有位置会同时看到原子性的变更。
现在将同一个已检查的数据集导入本实验的云端命名空间:
npx wrangler kv key put system:owner labex-redirect-demo --binding ROUTES --remote
npx wrangler kv bulk put redirects.json --binding ROUTES --remote
npx wrangler kv key list --binding ROUTES --remote
确认共有六个键。明确指定目标的选项可以将本地练习与云端写入分开。在修改任何条目之前,先完成本步骤的检查。
读取所有页面并提供重定向
在本步骤中,你将构建一个 Worker,列出所有路由键并提供重定向服务。一次 KV list() 调用可能只能返回集合的一部分。cursor 是 KV 提供的连续标记;将它原样传回即可请求下一部分结果。
编写以下处理程序。刻意设置的 limit: 2 会让五条记录的分页过程清晰可见。生产代码通常会使用更大的页面大小;本实验将数据限制为 20 条,因此循环规模较小。
cat > src/index.js <<'JS'
export default {
  async fetch(request, env) {
    const url = new URL(request.url);
    try {
      if (url.pathname === "/catalog") {
        const names = [];
        let cursor;
        let complete = false;
        let pages = 0;
        do {
          const page = await env.ROUTES.list({ prefix: "route:", limit: 2, cursor });
          names.push(...page.keys.map(key => key.name));
          pages += 1;
          complete = page.list_complete;
          cursor = complete ? undefined : page.cursor;
          if ((!complete && !cursor) || pages > 20) {
            return Response.json({ error: "Catalog could not be completed" }, { status: 503 });
          }
        } while (!complete);
        return Response.json({ keys: names, pages });
      }
      if (url.pathname.startsWith("/docs/")) {
        return new Response(`Example destination: ${url.pathname}`);
      }
      const target = await env.ROUTES.get(`route:${url.pathname}`);
      if (target === null) return new Response("Not found", { status: 404 });
      if (!/^\/docs\/[a-z-]+$/.test(target)) {
        return Response.json({ error: "Invalid redirect destination" }, { status: 500 });
      }
      return Response.redirect(new URL(target, url.origin).href, 302);
    } catch {
      return Response.json({ error: "Redirect storage unavailable" }, { status: 503 });
    }
  }
};
JS
do...while 循环至少会请求一个页面,并持续执行,直到 list_complete 为 true。它会在每次请求中保留 prefix: "route:",避免所有者测试记录进入目录。names.push(...) 会将每个页面中的键名称追加到结果中。
空的 keys 数组不一定表示列表已经完成:删除或过期的条目可能导致某个页面没有返回键,但后面仍有更多页面。因此,循环使用 list_complete,而不是根据数组长度判断。页面数量上限和缺少 cursor 的检查,可以在这个小型演示无法完成列表时返回受控错误。请参阅 KV 列表和分页。
对于其他路径,Worker 会读取匹配的路由键。缺少路由时返回 404;有效的目标地址会生成带有 Location 标头的 302 响应。运行时会再次检查目标地址,避免错误编辑的 KV 值将访问者重定向到其他网站。/docs/ 响应只是显示目标路径的简单占位内容,并不是完整的文档网站。
npx wrangler dev --local --ip 0.0.0.0 --port 8080 > local.log 2>&1 &
DEV_PID=$!
cat local.log
等待出现就绪消息,然后检查完整目录:
curl -i http://127.0.0.1:8080/catalog
预期会看到五个已排序的路由键,并且至少有三页。也可能出现额外的空页面;重要的是结果应包含完整的键集合,并且不能包含 system:owner。
curl -i http://127.0.0.1:8080/old-start
预期 HTTP 状态为 302,并且响应头包含 Location: http://127.0.0.1:8080/docs/start。默认情况下,curl 会显示重定向响应,但不会继续跟随重定向。保持本地数据集不变,以便稍后进行比较。
更新选定路由并保留其他数据
在本步骤中,你将修改云端目录,而不会替换其命名空间。新的起始页面是 /docs/getting-started,另外两个临时页面不应再执行重定向。
npx wrangler kv key put route:/old-start /docs/getting-started --binding ROUTES --remote
写入选定的键不会影响其他路由。删除多个键时,Wrangler 接受一个包含完整键名称的 JSON 数组。运行删除命令前,先读取这个小型停用列表:
cat > retired-keys.json <<'JSON'
["route:/old-contact", "route:/old-event"]
JSON
cat retired-keys.json
npx wrangler kv bulk delete retired-keys.json --binding ROUTES --remote
如果出现提示,请确认绑定和列出的操作针对的是本实验的临时命名空间。该列表只包含两个路由键,不包含 system:owner。
npx wrangler kv key list --binding ROUTES --remote
npx wrangler kv key get system:owner --binding ROUTES --remote --text
预期还剩三条路由,并且值 labex-redirect-demo 保持不变。现在不要重新运行原始批量导入:其中的旧值会撤销本次更新,并恢复已停用的键。
部署 Worker,确认 ROUTES 绑定,然后复制它实际的公开地址:
npx wrangler deploy
WORKER_URL="https://YOUR_WORKER.YOUR_SUBDOMAIN.workers.dev"
curl -i "$WORKER_URL/catalog"
先确认 /catalog 返回 HTTP 200 和预期的 JSON 键列表。如果请求返回 Cloudflare 错误页,请稍等后重复这些只读请求。退役路由只有返回 HTTP 404 且正文为应用的 Not found 时才算正确,不能只看状态码。
目录中应只包含 route:/old-pricing、route:/old-start 和 route:/old-support。测试已修改和已停用的路径:
curl -i "$WORKER_URL/old-start"
curl -i "$WORKER_URL/old-contact"
curl -i "$WORKER_URL/old-event"
预期起始路径会重定向到 /docs/getting-started;两个已停用的路径都应返回 404。如果新的云端数据暂时不可见,请等待 KV 传播后再重试只读检查。连接失败不能证明停用操作成功。
curl -i http://127.0.0.1:8080/catalog
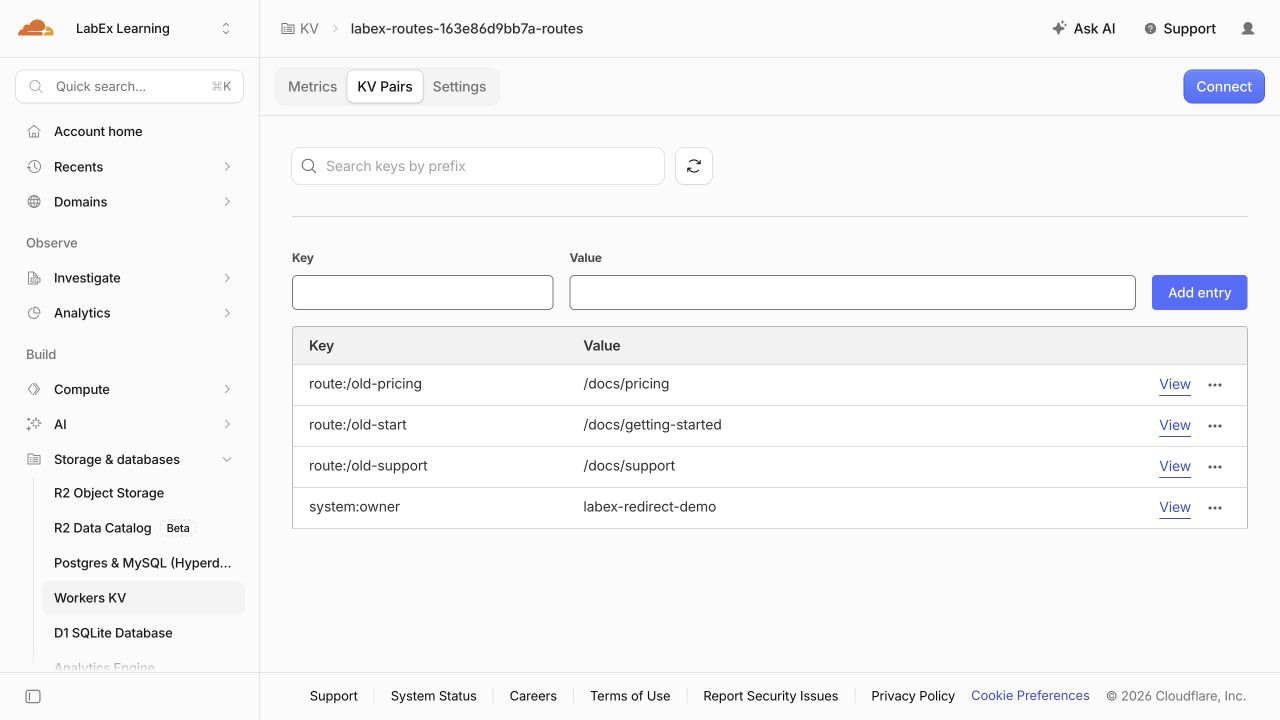
本地开发环境仍会列出原来的五条路由。这个差异确认维护命令的目标是云端存储。在 Dashboard 中选择同一个账户,打开 Storage & databases → Workers KV,然后查看本实验的命名空间。将其中的三条路由记录和保留的所有者测试记录与命令输出进行比较。此检查点为只读操作;生成的命名空间名称和 ID 对本次运行是唯一的。
选择 KV Pairs 查看下面的记录。如果你在维护命令完成前就打开了命名空间,请点击 Refresh 刷新。
删除临时云资源
在本步骤中,你将在 Wrangler 仍处于授权状态时删除两个资源。命名空间可以在 Worker 删除后继续存在,因此只删除应用并不会清理其中的数据。
停止在此终端中启动的本地开发进程:
kill "$DEV_PID"
删除任何资源前,先检查保存的资源引用:
cat wrangler.jsonc
确认 labex-routes-... Worker 名称和 ROUTES 命名空间 ID。删除此配置所选中的 Worker:
npx wrangler delete
如果出现提示,请确认显示的名称与本实验匹配,然后输入 y 确认。接着只删除 ROUTES 所引用的命名空间:
npx wrangler kv namespace delete --binding ROUTES
接受任何确认提示前,先检查其中显示的命名空间。保留 wrangler.jsonc 不变,以便独立检查能够识别应当已经不存在的资源。
npx wrangler kv namespace list
本实验的命名空间应不再出现;无关命名空间应继续保留。刷新 Dashboard 中的列表,确认本实验的 Worker 和命名空间已经消失。请求失败或登录过期都不能证明删除成功。在退出登录前运行本步骤的检查,以便它能够检查已授权的资源清单。
结束 VM 授权
在本步骤中,确认清理检查通过后,断开 Wrangler 的授权。退出登录会结束此 VM 保存的 Wrangler 授权,但不会删除云资源,也不会让你在普通 Dashboard 浏览器会话中退出登录。
npx wrangler logout
npx wrangler whoami --json
确认结构化结果报告 "loggedIn": false。此未认证命令可能以非零退出状态结束,这在本步骤中是预期现象。如果只看到连接错误,而没有明确的认证状态,请在连接恢复后重试。
剩余的本地文件和本地 KV 状态属于这个临时 VM,与已经删除的云资源相互独立。现在可以结束本实验。
总结
你在批量写入前验证了一个小型重定向数据集,明确区分了本地和云端目标,并遍历了带前缀的 KV 列表中的所有页面。你修改了一条路由,停用了两个指定键,同时保留了无关的所有者记录。部署后的响应确认了新的目标地址和已停用路由的缺失状态,而本地目录仍保留原始数据。
最后,你删除了临时 Worker 和命名空间,并退出了登录。接下来,你将处理可能暂时返回较早版本的配置读取操作。